
深入解析在 JavaScript 算法题中利用 Map 与 Set 优化时间复杂度的实战技巧。系统阐述数组线性扫描与哈希定址的底层差异,通过交集计算、滑动窗口、两数之和等经典场景展示从 O(N²) 到 O(N) 的降维过程,并深度辨析普通对象与 Map 的性能差异与避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS算法题中利用Map和Set优化时间复杂度的技巧
作者:异步漫步
时间:2026-11-19
浏览:427
文章目录
算法复杂度优化
哈希表实战
ES6 Map & Set
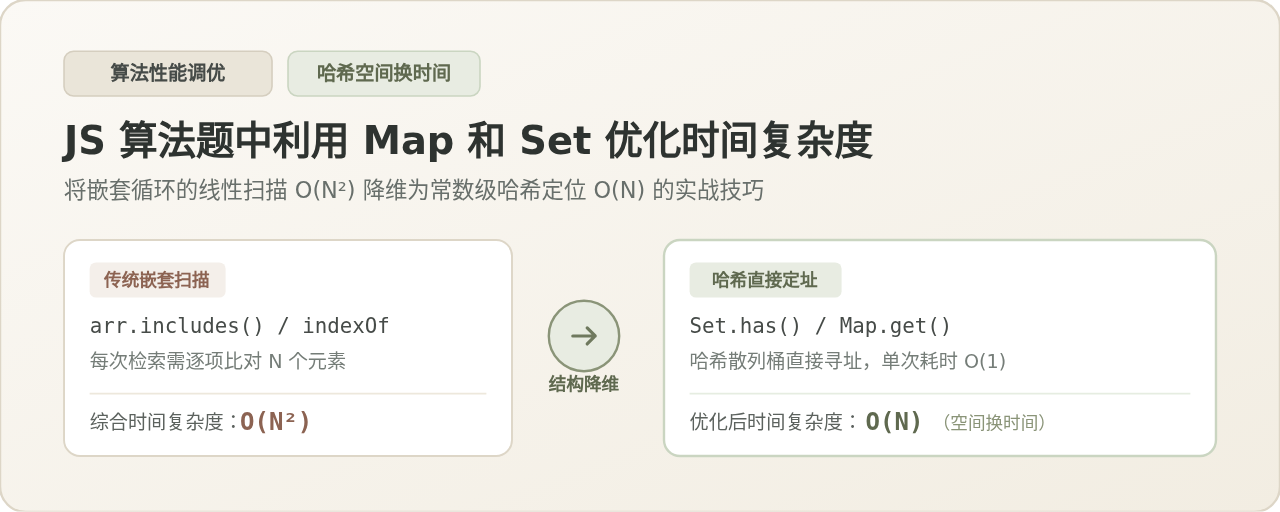
在 JavaScript 算法题与前端面试中,绝大多数执行超时(Time Limit Exceeded)或执行卡顿的根源,都是在循环体内部嵌套了线性扫描(例如
Array.prototype.indexOf、includes 或双层 for 循环),导致时间复杂度劣化为 \(O(n^2)\) 或 \(O(n imes m)\)。解决这类性能瓶颈的核心思路,是利用 ES6 提供的 Set 与 Map 在底层哈希结构上接近 \(O(1)\) 的读取特性,以线性的辅助空间换取查找时间的直接降维,将嵌套检索解耦为单次线性遍历与常数级哈希检索。本文将系统拆解这种降维技巧的底层机制、具体题型场景、代码实现与易错边界。
一、复杂度瓶颈的根源:数组线性扫描与哈希寻址的区别
很多初学者在编写代码时容易忽略原生数组方法的时间成本。像 arr.includes(val)、arr.indexOf(val) 以及 arr.find(...) 等方法,虽然在语法形式上只有简洁的一行,但其底层执行逻辑必须从数组的第 0 个下标开始,逐项向前对比直到找到目标或遍历至数组末尾。
这意味着单次调用的最坏与平均时间复杂度均为 \(O(n)\)。如果将这样的检索放入一个长度为 \(n\) 的循环中,整体的执行步数就会呈二次方爆炸增长至 \(n imes n = n^2\) 次。当输入规模达到 \(10^4\) 时,\(10^8\) 次操作将直接触发运行超时。
而 ES6 的 Set 和 Map 基于哈希表(Hash Table)结构实现。其核心优势在于:传入的键(Key)或元素通过哈希函数计算后,可以直接映射为内存桶(Bucket)的散列地址。在无极端哈希碰撞的常规情况下,无论是调用 set.has(val) 还是 map.get(key),定位过程均可在常数时间 \(O(1)\) 内完成。
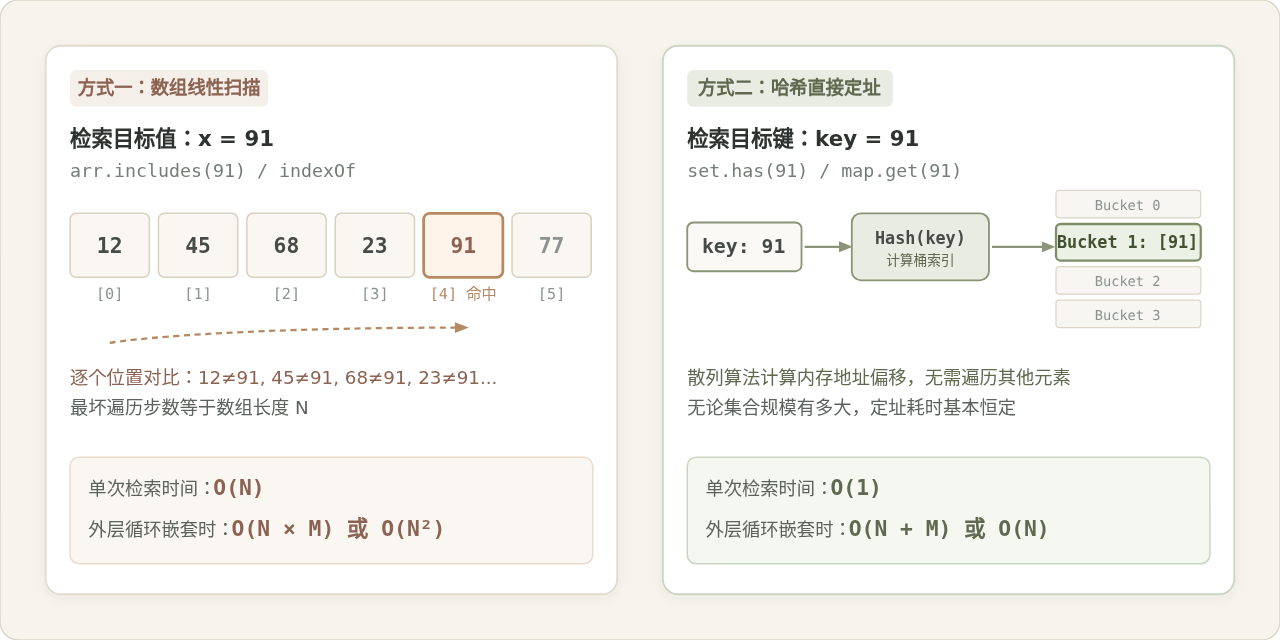
正如上图所示,当外层循环需要处理 \(n\) 个元素时,若内部使用数组检索,总操作量为 \(O(n imes n) = O(n^2)\);若先将数据组织为哈希结构,内部检索降为 \(O(1)\),总操作量骤降为 \(O(n imes 1) = O(n)\)。这种以 \(O(n)\) 辅助空间换取时间大幅节约的策略,是算法优化中最经典、最普适的手段。
二、利用 Set 优化集合存在性判断与去重
Set 是由唯一元素构成的集合。凡是算法题中出现“判断某个值是否出现过”、“查找两个数组的交集”、“判定字符串字符是否全部唯一”或“动态排除重复状态”的场景,都是 Set 大显身手的典型场景。
常见认知辨析:filter + includes 为什么看似合理却暗藏性能陷阱?
看似合理的写法:在求解两数组交集时,许多开发者习惯写下极简的一行代码:
const intersection = arr1.filter(item => arr2.includes(item));为什么看似合理:代码语法极其精练,函数式语义明确,在数组长度只有数十或数百时运行迅速,完全看不出缺陷。
为什么需要修正:arr2.includes(item) 在每一次 filter 迭代中都会全量线性扫描 arr2。若 arr1 长度为 \(n\),arr2 长度为 \(m\),总时间复杂度为 \(O(n imes m)\)。当两数组长度均为 \(2 imes 10^4\) 时,需要执行 4 亿次比对,必然超出时间限制。
正确的优化做法:先用 arr2 初始化一个 Set(构建耗时 \(O(m)\)),之后在 filter 中通过 set.has(item) 进行 \(O(1)\) 判定,总耗时降为 \(O(n + m)\)。
优化示例 1:求解两数组交集
// 优化前:O(n * m) 极易超时
function intersectionSlow(arr1, arr2) {
  return [...new Set(arr1.filter(x => arr2.includes(x)))];
}

// 优化后:O(n + m) 线性高效完成
function intersectionFast(arr1, arr2) {
  // 针对较短的数组建 Set 可以进一步降低空间与建表耗时
  const [smaller, larger] = arr1.length < arr2.length ? [arr1, arr2] : [arr2, arr1];
  const set = new Set(smaller);
  const result = new Set();

  for (const item of larger) {
    if (set.has(item)) {
      result.add(item);
    }
  }
  return Array.from(result);
}
进阶场景:滑动窗口结合 Set 维护无重复子串
在 LeetCode 经典题“无重复字符的最长子串”中,如果采用暴力枚举所有子串并检验唯一性,时间复杂度高达 \(O(n^3)\)。而利用双指针构成滑动窗口,并配合一个 Set 动态记录当前窗口内包含的字符,能将复杂度直接压制在 \(O(n)\)。
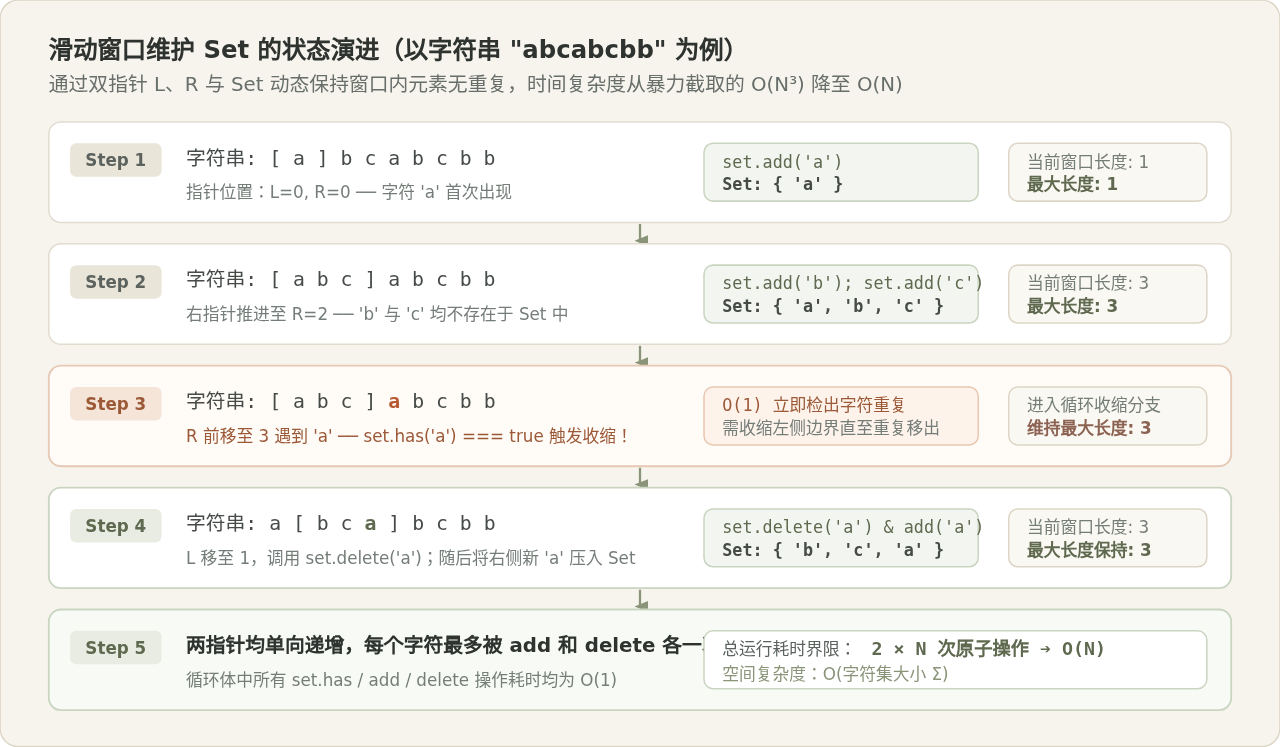
/**
 * 无重复字符的最长子串
 * 时间复杂度:O(n),左右指针各最多遍历字符串一次
 * 空间复杂度:O(min(m, n)),m 为字符集大小
 */
function lengthOfLongestSubstring(s) {
  const occ = new Set();
  const n = s.length;
  let right = 0;
  let maxLen = 0;

  for (let left = 0; left < n; left++) {
    // 窗口左侧收缩时,从 Set 中移除移出的字符
    if (left > 0) {
      occ.delete(s[left - 1]);
    }
    // 右指针持续前移,遇到重复字符前不断加入 Set
    while (right < n && !occ.has(s[right])) {
      occ.add(s[right]);
      right++;
    }
    maxLen = Math.max(maxLen, right - left);
  }

  return maxLen;
}
三、利用 Map 实现键值配对缓存与高频统计
当算法不仅需要判定元素“是否存在”,还需要获知“它在什么位置”、“它出现了多少次”或“它对应的关联计算结果”时,必须使用键值对结构。Map 是处理这类配对关系的核心利器。
深度辨析:普通对象 {} 与 Map 在算法题中的选择考量
常见说法:“在 JavaScript 算法题里,用普通字面量对象 {} 和 Map 是一样的,习惯用哪个就用哪个。”
为什么看似合理:在很多刷题代码中,经常能看到 const count = {} 记录频次。对于 key 是纯短英文字符串(如统计小写字母)的简单场景,两者的差异确实微乎其微。
为什么必须修正:在面对更复杂的算法题时,普通对象存在三个致命短板:
- 键的类型强制转换:普通对象的键只能是
String或Symbol。如果你的 key 是整型数字、DOM 节点、二叉树 TreeNode 或区间数组,传入普通对象都会被强制执行toString(),导致1与"1"发生混淆,或者不同对象全部被转成"[object Object]"互相覆盖。而Map允许任何 JavaScript 类型作为 key。 - 原型链污染风险:普通对象默认继承自
Object.prototype,自带toString、valueOf、constructor等属性。如果题目测试用例中恰好包含字符串"constructor",执行if (obj[key])会直接产生逻辑误判。若必须用对象,需写为Object.create(null)。 - 高频增删的引擎优化:V8 等现代 JS 引擎为
Map实现了专门的紧凑哈希表结构。在算法题需要频繁set和delete大量键值对时,普通对象会频繁触发 Hidden Class(隐藏类)重构,性能显著逊色于Map。
经典实战:两数之和(Two Sum)的“边查边存”技巧
两数之和是哈希优化的教科书级案例。暴力解法使用双层循环枚举所有数字对,时间复杂度为 \(O(n^2)\)。通过引入 Map,我们可以在单次遍历中解决问题。更重要的是,采用“边查询历史数据、边存入当前数据”的流水线设计,能够天然避免自身与自身配对,并解决数组中存在相同数值时的下标覆盖问题。
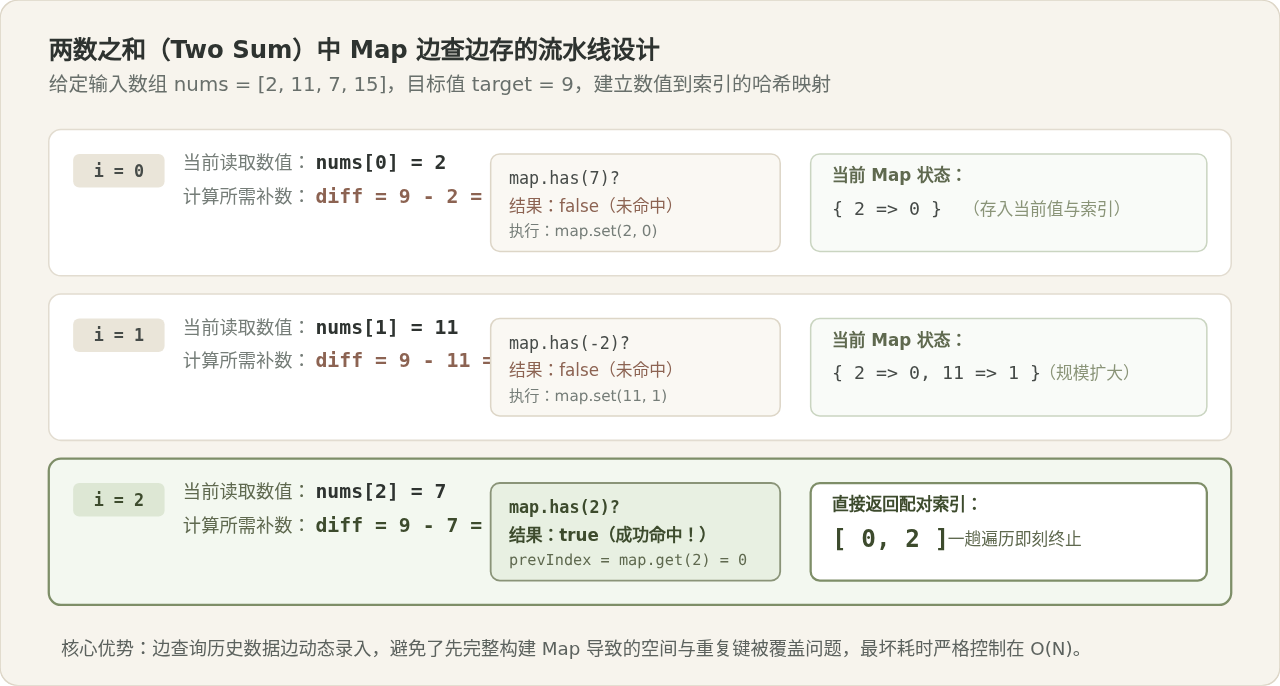
/**
 * 两数之和:边遍历边配对
 * 时间复杂度:O(n),单次遍历
 * 空间复杂度:O(n),Map 存储已访问元素
 */
function twoSum(nums, target) {
  const prevMap = new Map(); // key: 数值, value: 对应下标

  for (let i = 0; i < nums.length; i++) {
    const current = nums[i];
    const complement = target - current;

    // O(1) 检查补数是否在此前的遍历中出现过
    if (prevMap.has(complement)) {
      return [prevMap.get(complement), i];
    }

    // 未找到则将当前元素记入 Map
    prevMap.set(current, i);
  }

  return [];
}
四、利用 Map 优化记忆化搜索(Memoization)与复杂键处理
在动态规划、递归回溯或图遍历问题中,存在大量重叠子问题。如果直接暴力递归,调用栈会呈现指数级增长(例如普通递归斐波那契数列复杂度为 \(O(2^n)\))。此时利用 Map 缓存已经求解过的状态,就是记忆化搜索的精髓。
实战示例:利用 Map 进行递归剪枝
/**
 * 记忆化递归:将 O(2^n) 指数级复杂度裁剪为 O(n) 线性复杂度
 */
function climbStairsMemo(n) {
  const memo = new Map();

  function helper(steps) {
    if (steps <= 2) return steps;
    // O(1) 查看子状态是否已计算
    if (memo.has(steps)) {
      return memo.get(steps);
    }
    const ans = helper(steps - 1) + helper(steps - 2);
    memo.set(steps, ans);
    return ans;
  }

  return helper(n);
}
此外,当算法题涉及“图的深拷贝”(如 LeetCode 133 克隆图)或“随机链表的复制”(如 LeetCode 138)时,我们需要建立原节点对象到新节点对象的直接映射。普通对象完全无法做到将对象引用作为 key,而 Map 原生支持任何引用对象作为键:
// 以节点对象自身为 Key,建立原节点与克隆节点的哈希对照表
const visited = new Map();
function cloneGraph(node) {
  if (!node) return null;
  if (visited.has(node)) return visited.get(node);

  const cloneNode = new Node(node.val);
  visited.set(node, cloneNode);

  for (const neighbor of node.neighbors) {
    cloneNode.neighbors.push(cloneGraph(neighbor));
  }
  return cloneNode;
}
五、算法题中使用 Map 和 Set 的关键注意事项
1. 键的比对判定规则:SameValueZero
Map 和 Set 内部判定两个键是否相同的规则是 SameValueZero,它与严格全等(===)非常接近,但有一个极为重要的特性:NaN 被认为等于自身(而 NaN === NaN 为 false),并且 +0 与 -0 被判定为相等。因此在处理包含 NaN 的测试用例时无需担心重复插入。
2. 复合引用类型键的地址陷阱
当使用数组或对象作为 Set 的元素或 Map 的键时,哈希判定比较的是内存引用地址,而不是内容值。例如:
const set = new Set();
set.add([1, 2]);
console.log(set.has([1, 2])); // false!因为传入的是不同的数组实例
在处理坐标对 [x, y] 或二维状态网格题时,若要将坐标放入 Set 判重,应当将其序列化为基础类型字符串,例如 set.add(`${x},${y}`) 或利用数学公式压缩为唯一整数 x * 100000 + y。
3. 空间复杂度的权衡边界
哈希优化本质上是“空间换时间”。虽然时间复杂度降到了 \(O(n)\),但空间复杂度也随之从 \(O(1)\) 提升至 \(O(n)\)。如果算法题明确规定“必须使用 \(O(1)\) 额外空间”(如“在原数组上删除重复项”、“寻找旋转排序数组中的最小值”),就不能使用 Set 或 Map,而必须改用双指针(快慢指针、对撞指针)或位运算技巧。
六、总结与选型决策指南
在 JavaScript 算法题的实际解题过程中,建立直觉性的数据结构选型习惯是快速通过测试的关键。遇到瓶颈时,按照下述全景决策图进行比对排查,可以精准选出最优的数据组织方式:
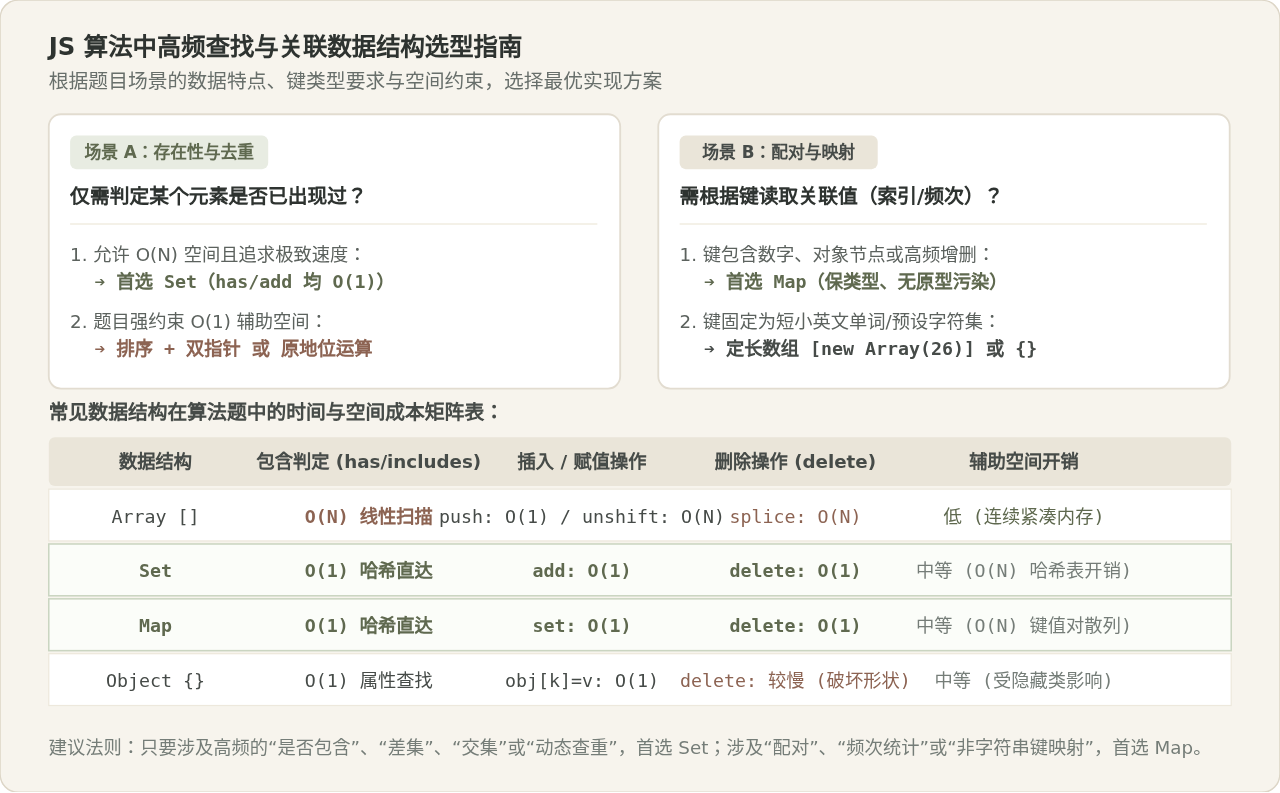
归纳起来,利用 Map 和 Set 优化时间复杂度的黄金法则可以概括为三点:
- 凡是涉及嵌套查询,立刻警惕线性扫描:只要在循环体内部看到了
includes、indexOf或第二层循环查找同一数组,应第一时间考虑将目标集合提前转换为Set或Map。 - 区分单纯存在性与键值关联:仅需判断“在不在”、“重不重复”,果断选用
Set;需要记录“出现次数”、“对应索引”、“前置计算结果”,坚决选用Map。 - 复杂键与高频增删不乱用普通对象:避免将数字或对象作为
{}的 key,利用Map保持类型的绝对纯净与极速的增删哈希性能。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章