
深入汇总前端面试高频JavaScript算法题,覆盖滑动窗口、树结构与扁平数组互转、LRU缓存淘汰、Vue3最长递增子序列等核心题目的最优解法推导与无多余依赖的实现代码。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
前端面试高频JS算法题汇总及最优解法
作者:异步漫步
时间:2026-11-19
浏览:201
文章目录
面试核心必考
适用场景:大厂前端一面/二面、白板编程、架构底层原理
涉及考点:双指针、哈希字典、树与扁平化、Vue3 Diff 核心、LRU 缓存机制
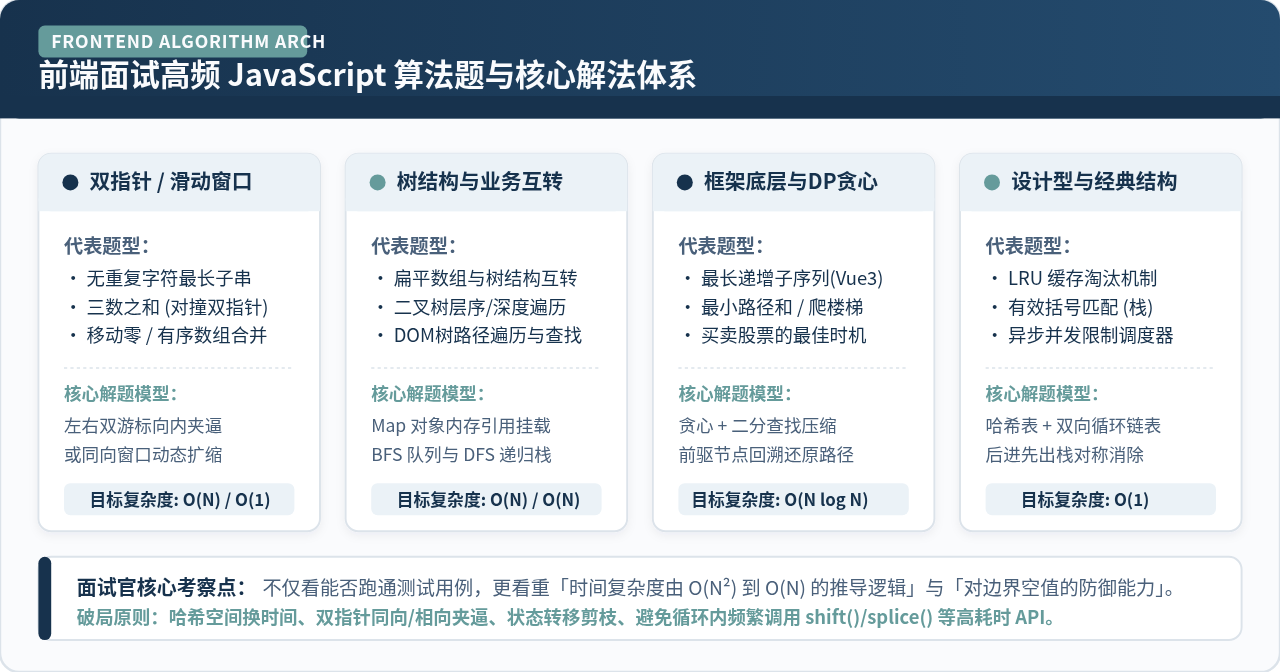
在前端工程化日益深化的当下,前端技术面试中的算法考核不再局限于抽象纯数论推导,而是更加聚焦于两类核心场景:一类是直接支撑框架底层的高性能调度逻辑(例如 Vue 3 Virtual DOM diff 中求最长递增子序列);另一类是处理实际前端业务数据时高频遭遇的结构组织与性能优化(例如多级联动菜单与扁平列表互转、LRU 客户端缓存、高并发请求控制与长文本窗口处理)。
本文系统梳理前端面试中考察频次最高、区分度最鲜明的 6 道经典 JavaScript 算法题。针对每一道题目,我们不仅提供能够直接在 Node.js 或浏览器环境中运行的原生实现,更聚焦于“由暴力解法向最优解法演进的思维过程”,讲透时空复杂度边界与面试中容易遗漏的代码防御细节。
一、无重复字符的最长子串(滑动窗口最优解)
题目描述:给定一个字符串 s,请你找出其中不含有重复字符的最长连续子串的长度。
面试场景与常规瓶颈:初学者往往容易想到使用双重或三重循环暴力枚举所有可能的子串(时间复杂度为 \(O(N^3)\) 或 \(O(N^2)\)),在面试中这种解法通常只能拿到保底分数。该题考察的核心是如何借助动态滑动窗口配合哈希表将时间复杂度严格压缩到单次遍历的 \(O(N)\)。
最优解推导逻辑
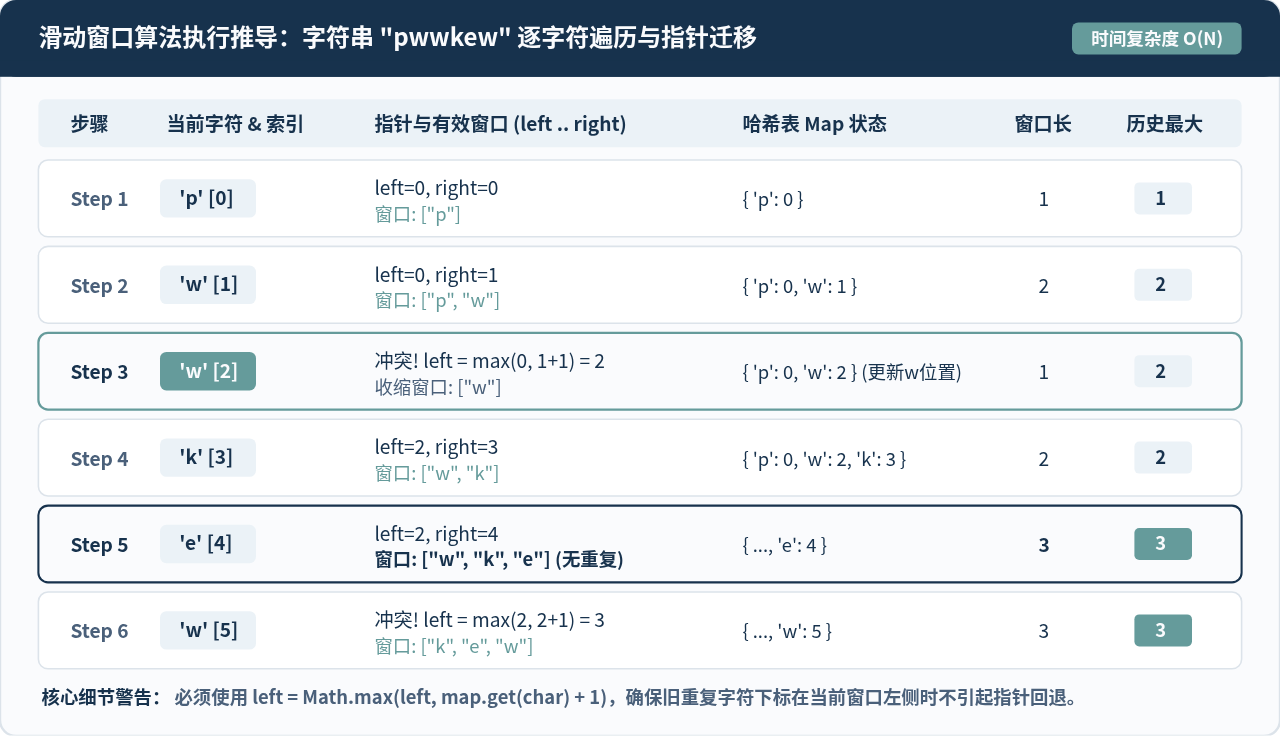
我们维护两个指针 left 和 right,共同定义一个无重复字符的动态窗口:
- 指针
right负责在每次循环中向右探查新字符; - 利用
Map记录每个遇到字符的“最新出现下标”; - 如果当前探查的字符已经在
Map中存在,说明遇到了重复字符。此时左指针left必须跳过上一次重复字符的位置,但注意:左指针只能向右移动,不能向左倒退。因此我们使用left = Math.max(left, map.get(char) + 1); - 每次移动右指针后,动态更新最大长度
maxLen = Math.max(maxLen, right - left + 1)。
最优解完整代码实现
/**
 * 求解无重复字符的最长子串长度
 * @param {string} s
 * @return {number}
 * 时间复杂度: O(N) - 字符串仅被右指针单次扫描,哈希读写为 O(1)
 * 空间复杂度: O(min(N, M)) - M 为字符集大小(ASCII/Unicode字符种类)
 */
function lengthOfLongestSubstring(s) {
  if (!s || s.length === 0) return 0;

  const map = new Map(); // 存储字符 -> 该字符最新出现的下标
  let left = 0;
  let maxLen = 0;

  for (let right = 0; right < s.length; right++) {
    const char = s[right];

    // 如果字符存在于哈希表中,更新左边界(注意 Math.max 避免指针回退)
    if (map.has(char)) {
      left = Math.max(left, map.get(char) + 1);
    }

    map.set(char, right);
    maxLen = Math.max(maxLen, right - left + 1);
  }

  return maxLen;
}

// 测试用例
console.log(lengthOfLongestSubstring("abcabcbb")); // 输出: 3 (对应 "abc")
console.log(lengthOfLongestSubstring("pwwkew"));   // 输出: 3 (对应 "wke")
console.log(lengthOfLongestSubstring("abba"));     // 输出: 2 (检验 left 防倒退机制)
⚠️ 面试常踩陷阱提醒
很多候选人直接写成 left = map.get(char) + 1。当输入为 "abba" 时,遍历到第二个 'a',若不加 Math.max(left, ...),left 就会从已经到达的下标 2 倒退回 1,导致窗口误算,这一点是白板面试的核心踩分点。
二、扁平数组与树形结构的高性能互转(前端特高频业务算法)
题目描述:前端开发中经常需要把后台返回的扁平节点列表(形如包含 id 和 parentId 的对象数组)转换成 UI 组件(如 Element Plus 或 Ant Design 的 Tree、Cascader 级联选择器)所需要的树形层级结构;同时在全量搜索或路径提取时,又需要将嵌套 Tree 反向扁平化。
最优解推导逻辑
常规的递归遍历方法对每个父节点反复过滤整个数组(arr.filter(item => item.parentId === parent.id)),会导致高达 \(O(N^2)\) 的时间复杂度。当节点量达到数千条时会造成主线程明显卡顿。
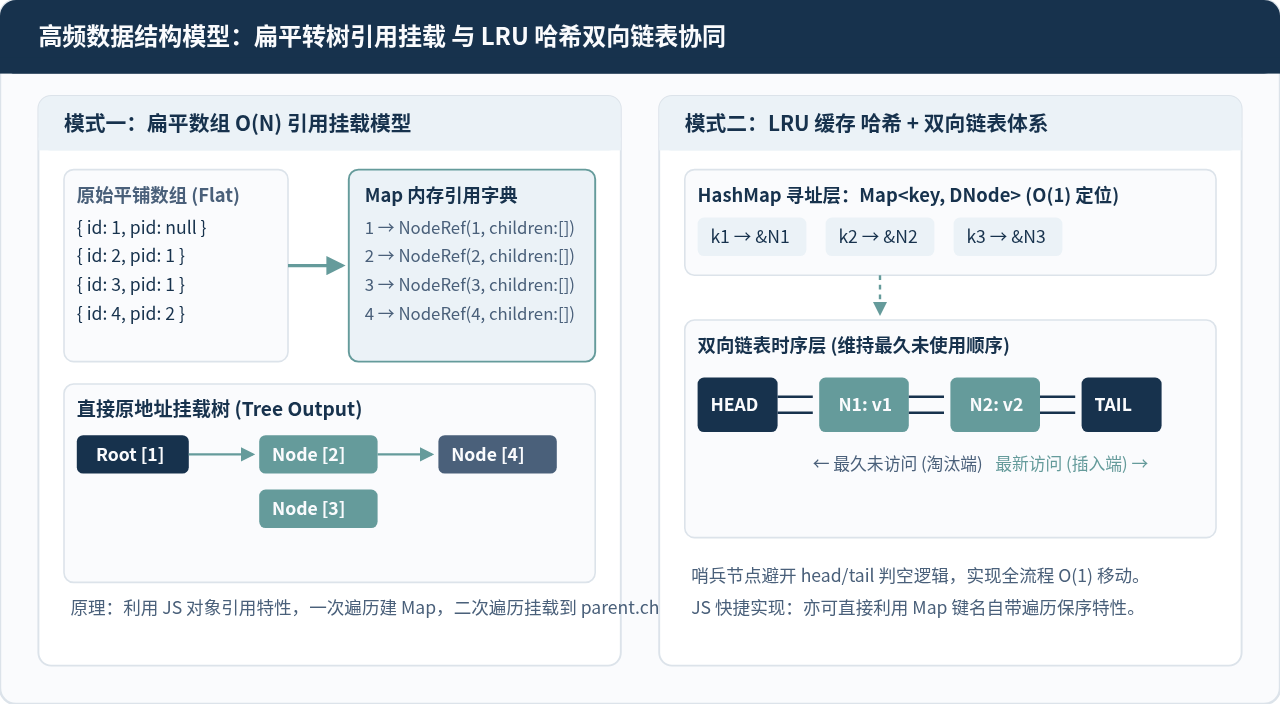
最优解法采用哈希引用映射(Hash Map Reference):JavaScript 的对象是按引用传递的。只要通过一次循环把所有节点保存在以 id 为键的 Map 映射中并预留 children: [] 容器;第二次遍历时,子节点就可以在 \(O(1)\) 时间内直接通过 map.get(parentId) 找到父节点,并 push 进其 children 数组中。整个过程只经历两次线性扫描,时间复杂度为 \(O(N)\)。
最优解完整代码实现
/**
 * 扁平数组转换为树形结构(高性能 O(N) 映射法)
 * @param {Array} items - 平铺节点列表
 * @param {string} idKey - 主键字段名,默认为 'id'
 * @param {string} parentKey - 父节点字段名,默认为 'parentId'
 * @return {Array} 根节点构成的树形数组
 * 时间复杂度: O(N)
 * 空间复杂度: O(N)
 */
function arrayToTree(items, idKey = 'id', parentKey = 'parentId') {
  if (!Array.isArray(items) || items.length === 0) return [];

  const result = [];
  const map = new Map();

  // 第一步:浅拷贝各节点,初始化 children 属性,并在 Map 中建立索引
  for (const item of items) {
    map.set(item[idKey], { ...item, children: [] });
  }

  // 第二步:通过 parentId 直接在 Map 中查找父级并挂载
  for (const item of items) {
    const currentNode = map.get(item[idKey]);
    const parentId = item[parentKey];

    // 如果 parentId 为空或为 0/null,视作顶层根节点
    if (parentId === null || parentId === undefined || parentId === 0 || !map.has(parentId)) {
      result.push(currentNode);
    } else {
      const parentNode = map.get(parentId);
      parentNode.children.push(currentNode);
    }
  }

  return result;
}

/**
 * 树形结构反向扁平化(深度优先迭代实现,避免大深度导致栈溢出)
 * @param {Array} tree
 * @return {Array}
 */
function treeToArray(tree) {
  if (!Array.isArray(tree) || tree.length === 0) return [];
  const result = [];
  const stack = [...tree];

  while (stack.length > 0) {
    const node = stack.pop();
    const { children, ...rest } = node;
    result.push(rest);

    if (children && children.length > 0) {
      // 逆序压栈以保证遍历顺序正序
      for (let i = children.length - 1; i >= 0; i--) {
        stack.push(children[i]);
      }
    }
  }

  return result;
}

// 验证
const flatData = [
  { id: 1, name: '部门A', parentId: null },
  { id: 2, name: '研发组', parentId: 1 },
  { id: 3, name: '前端小组', parentId: 2 },
  { id: 4, name: '运营组', parentId: 1 }
];
const tree = arrayToTree(flatData);
console.log(JSON.stringify(tree, null, 2));
三、LRU 缓存淘汰算法(LeetCode 146 / 前端缓存设计)
题目描述:请你设计并实现一个满足 LRU (最近最少使用) 缓存约束的数据结构。实现 LRUCache 类:包含 get(key) 和 put(key, value) 两个方法,且两者的时间复杂度必须均为 \(O(1)\)。
解法选型对比
在 JavaScript 中实现 LRU 缓存通常有两种写法:
- 写法一:利用 ES6
Map键名的保序特性。ES6 标准规定Map会严格按照键值对的插入顺序进行迭代。当我们读取某个 key 时,只需将其delete(key)再重新set(key, val),即可在 \(O(1)\) 时间内把该项刷新至末尾。超出容量时,利用map.keys().next().value就能以 \(O(1)\) 取得最久未使用的头部键并删除。 - 写法二:原生双向链表 + 哈希表(底层经典结构)。如果面试官明确要求考察底层数据结构实现能力,需要手写双向链表节点
DoublyLinkedList,配备虚拟伪头尾节点head和tail。
工业级与面试高赞实现(双向链表 + 哈希表完整版)
class DNode {
  constructor(key = 0, val = 0) {
    this.key = key;
    this.val = val;
    this.prev = null;
    this.next = null;
  }
}

class LRUCache {
  /**
   * @param {number} capacity
   */
  constructor(capacity) {
    this.capacity = capacity;
    this.map = new Map(); // key -> DNode
    // 伪头尾哨兵节点,省去边界判空
    this.head = new DNode();
    this.tail = new DNode();
    this.head.next = this.tail;
    this.tail.prev = this.head;
  }

  // 将某个节点移动到链表末尾(表示最近使用)
  _moveToTail(node) {
    this._removeNode(node);
    this._addToTail(node);
  }

  // 从双向链表中移除特定节点
  _removeNode(node) {
    node.prev.next = node.next;
    node.next.prev = node.prev;
  }

  // 将节点插入到伪尾节点之前
  _addToTail(node) {
    node.prev = this.tail.prev;
    node.next = this.tail;
    this.tail.prev.next = node;
    this.tail.prev = node;
  }

  /**
   * @param {number} key
   * @return {number}
   */
  get(key) {
    if (!this.map.has(key)) return -1;
    const node = this.map.get(key);
    this._moveToTail(node); // 命中后刷新到尾部
    return node.val;
  }

  /**
   * @param {number} key
   * @param {number} value
   */
  put(key, value) {
    if (this.map.has(key)) {
      const node = this.map.get(key);
      node.val = value;
      this._moveToTail(node);
    } else {
      const newNode = new DNode(key, value);
      this.map.set(key, newNode);
      this._addToTail(newNode);

      // 容量超出时淘汰最久未使用的节点(即 head.next)
      if (this.map.size > this.capacity) {
        const leastUsed = this.head.next;
        this._removeNode(leastUsed);
        this.map.delete(leastUsed.key);
      }
    }
  }
}

// 简单使用示例
const lru = new LRUCache(2);
lru.put(1, 1);
lru.put(2, 2);
console.log(lru.get(1));    // 返回 1 (此时 key 1 变更为最新)
lru.put(3, 3);              // 淘汰 key 2
console.log(lru.get(2));    // 返回 -1 (未找到)
四、最长递增子序列(Vue 3 Diff 核心算法最优解)
题目描述:给你一个整数数组 nums,找到其中最长严格递增子序列的长度及其对应的下标序列。
技术背景:在 Vue 3 的 Virtual DOM 核心 diff 算法中,当遇到新旧子节点无法通过头尾比对命中时,Vue 3 会构建新旧节点的相对索引映射,并通过求取该映射的最长递增子序列 (Longest Increasing Subsequence, LIS),来找出在 DOM 更新中可以保持原地不动、不需要移动 DOM 的节点集合,从而把 DOM 节点位移操作降到最低限度。
最优解推导逻辑(贪心 + 二分查找 + 前驱指针回溯)
- 常规动态规划算法时间复杂度为 \(O(N^2)\),对于长列表 diff 性能不足;
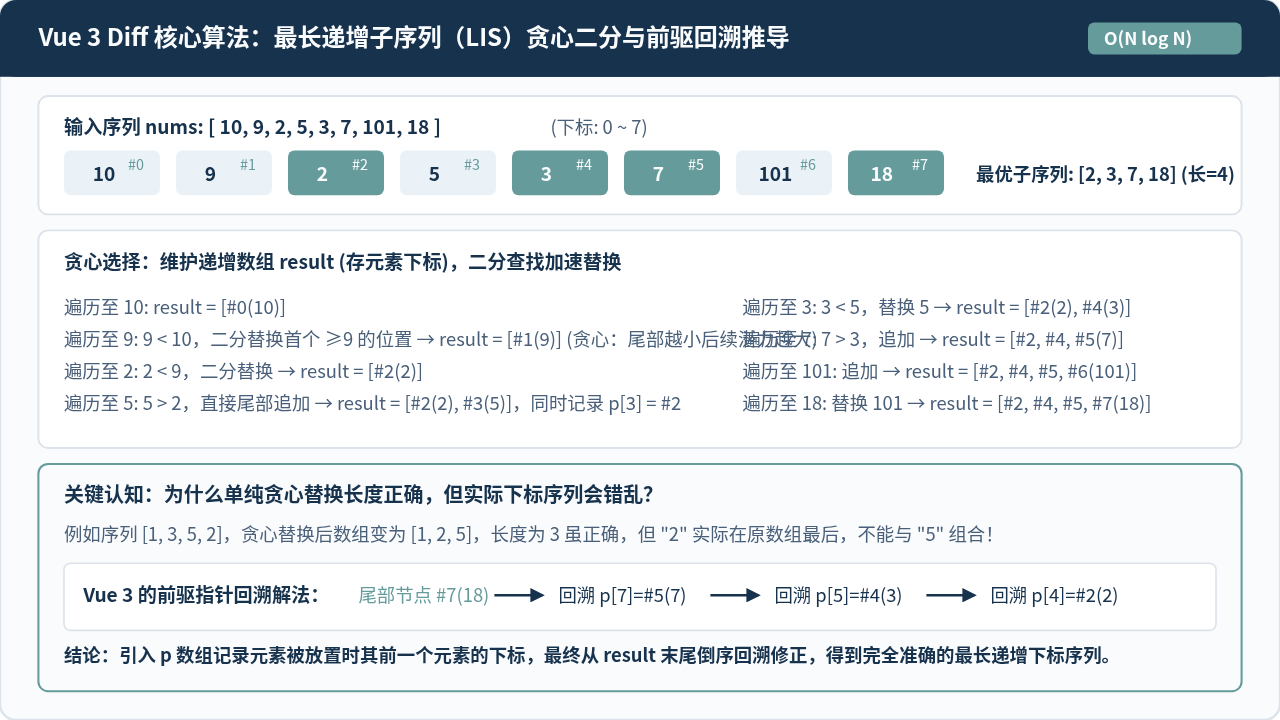
- 贪心策略:如果一个递增子序列的末尾数值越小,它后续能够接纳更大数字的可能性就越高。我们维护一个结果数组
result(存储递增子序列在原数组中的下标); - 遍历原数组。当遇到比
result末尾数字更大的元素时,直接追加;若小于或等于,则通过二分查找 (Binary Search) 找到首个大于等于它的位置并将其覆盖替换; - 核心难点——前驱回溯:单纯的贪心替换虽然能得到正确的长度,但
result中的具体元素会被新元素“错误替换”,破坏原有序列的先后关系。为了还原真实序列,Vue 3 维护了一个p数组记录每个元素加入时其前驱节点的下标,最后从末尾倒序逐级回溯,修正出完全正确的序列下标。
Vue 3 源码级完整实现
/**
 * 求解最长递增子序列的下标集合(Vue 3 核心 diff 算法同款实现)
 * @param {number[]} arr
 * @return {number[]} 严格递增子序列对应的下标数组
 * 时间复杂度: O(N log N)
 * 空间复杂度: O(N)
 */
function getSequence(arr) {
  const p = arr.slice(); // 存储前驱节点的下标索引
  const result = [0];    // 存储当前递增序列的下标,预置首个元素
  let i, j, u, v, c;
  const len = arr.length;

  for (i = 0; i < len; i++) {
    const arrI = arr[i];
    // Vue3 diff 中会用 0 或负数标记新增节点,在此按题目常规忽略 0
    if (arrI !== 0) {
      j = result[result.length - 1];
      // 1. 如果当前元素大于已记录的最长子序列末尾元素,直接追加
      if (arr[j] < arrI) {
        p[i] = j;           // 记录当前元素的前驱为原末尾元素
        result.push(i);
        continue;
      }

      // 2. 二分查找:在已有的 result 中寻找第一个大于等于 arrI 的位置
      u = 0;
      v = result.length - 1;
      while (u < v) {
        c = (u + v) >> 1;
        if (arr[result[c]] < arrI) {
          u = c + 1;
        } else {
          v = c;
        }
      }

      // 3. 贪心替换更小的值以获得更大的后续延展空间
      if (arrI < arr[result[u]]) {
        if (u > 0) {
          p[i] = result[u - 1]; // 记录前驱
        }
        result[u] = i;          // 替换下标
      }
    }
  }

  // 4. 从末尾向前回溯,纠正贪心替换导致的序列节点错位
  u = result.length;
  v = result[u - 1];
  while (u-- > 0) {
    result[u] = v;
    v = p[v];
  }

  return result;
}

// 测试
const testArr = [10, 9, 2, 5, 3, 7, 101, 18];
const indices = getSequence(testArr);
console.log('最长递增子序列下标:', indices); // [2, 4, 5, 7]
console.log('对应元素值:', indices.map(idx => testArr[idx])); // [2, 3, 7, 18]
五、三数之和(双指针与去重艺术)
题目描述:给你一个整数数组 nums,判断是否存在三元组 [nums[i], nums[j], nums[k]] 满足 i != j、i != k 且 j != k ,同时满足 nums[i] + nums[j] + nums[k] === 0。请你返回所有和为 0 且不重复的三元组。
最优解推导逻辑
暴力三重循环复杂度为 \(O(N^3)\),且极难规避重复解问题。最优解法采用排序 + 双指针左右对撞:
- 首先对数组执行升序排序(时间复杂度 \(O(N \log N)\));
- 固定第一层遍历指针
i。如果nums[i] > 0,由于数组已升序,后续两数之和必大于 0,可直接提前break; - 在
i + 1到nums.length - 1之间设立左右指针left和right,计算三数之和sum = nums[i] + nums[left] + nums[right]:- 若
sum < 0,说明负数过大,left++; - 若
sum > 0,说明正数过大,right--; - 若
sum === 0,存入结果数组,同时跳过所有相邻相等的重复数值。
- 若
最优解完整代码实现
/**
 * 求解三数之和为 0 的所有不重复三元组
 * @param {number[]} nums
 * @return {number[][]}
 * 时间复杂度: O(N²) - 排序 O(N log N) + 外层循环乘以内层双指针夹逼 O(N²)
 * 空间复杂度: O(1) - 仅需常量辅助指针(忽略排序内部栈开销)
 */
function threeSum(nums) {
  const result = [];
  if (!nums || nums.length < 3) return result;

  // 1. 升序排序
  nums.sort((a, b) => a - b);

  for (let i = 0; i < nums.length - 2; i++) {
    // 剪枝优化:如果当前最小数已经大于0,三数和绝不可能为0
    if (nums[i] > 0) break;

    // 外层去重:如果和前一个数值相同,跳过
    if (i > 0 && nums[i] === nums[i - 1]) continue;

    let left = i + 1;
    let right = nums.length - 1;

    while (left < right) {
      const sum = nums[i] + nums[left] + nums[right];

      if (sum === 0) {
        result.push([nums[i], nums[left], nums[right]]);

        // 内层双指针去重
        while (left < right && nums[left] === nums[left + 1]) left++;
        while (left < right && nums[right] === nums[right - 1]) right--;

        left++;
        right--;
      } else if (sum < 0) {
        left++;
      } else {
        right--;
      }
    }
  }

  return result;
}

// 测试用例
console.log(threeSum([-1, 0, 1, 2, -1, -4]));
// 输出: [[-1, -1, 2], [-1, 0, 1]]
六、有效括号与栈模拟(模板解析与边界防御)
题目描述:给定一个只包括 '(',')',',','[',']' 的字符串 s,判断字符串是否有效。括号必须以正确的顺序闭合且相同类型的左括号必须用相同类型的右括号闭合。
最优解推导逻辑
括号匹配是浏览器 HTML 解析器、Babel AST 词法分析、JSX 解析器的微缩模型。最优解法使用后进先出栈 (LIFO)。一个非常优雅的工程技巧是:遇到左括号时,直接将期望匹配的对应右括号字符压入栈中。这样在遇到右括号时,只需要直接对比 char === stack.pop(),省去复杂的条件分支判断。
最优解完整代码实现
/**
 * 判断括号闭合有效性
 * @param {string} s
 * @return {boolean}
 * 时间复杂度: O(N)
 * 空间复杂度: O(N)
 */
function isValid(s) {
  if (!s || s.length % 2 !== 0) return false; // 奇数长度不可能完全匹配

  const stack = [];
  const map = {
    '(': ')',
    '[': ']',
    '{': '}'
  };

  for (let i = 0; i < s.length; i++) {
    const char = s[i];
    if (map[char]) {
      // 遇到左括号,将其期望匹配的右括号压栈
      stack.push(map[char]);
    } else {
      // 遇到右括号,出栈对比;若不匹配或栈已空则非法
      if (stack.length === 0 || stack.pop() !== char) {
        return false;
      }
    }
  }

  // 遍历完毕后栈必须刚好清空
  return stack.length === 0;
}

// 测试
console.log(isValid("()[]{}")); // true
console.log(isValid("([)]"));     // false
console.log(isValid("{[]}"));     // true
七、前端面试算法答题决策与面试现场规范
在前端现场面试或在线白板编码过程中,面试官不仅评判最终提交代码是否通过单元测试,更关注候选人在面对问题时的思考路径与工程严谨性。以下梳理的答题决策流与高频模型汇总,可作为临场答题的标准化指引。
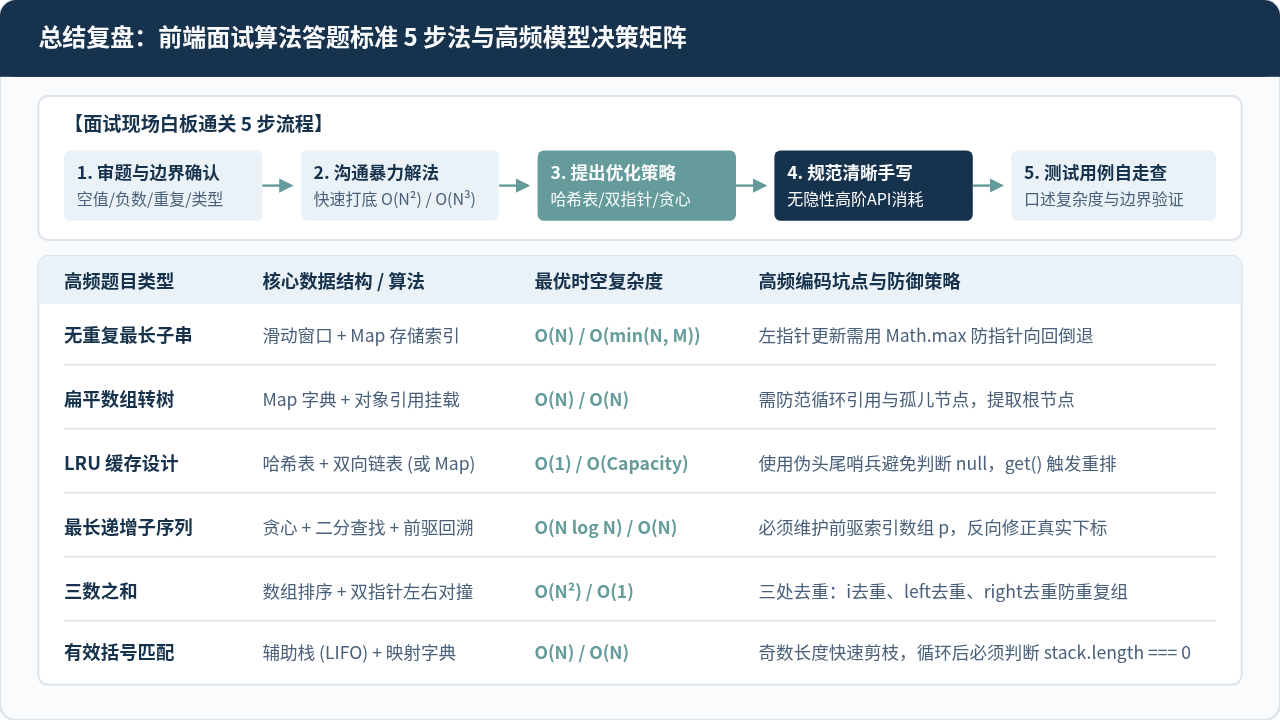
前端算法手写核心避坑清单
- 严禁在循环内频繁调用高耗时原生数组 API:在
for循环中随手调用arr.shift()、arr.splice()或arr.indexOf()。这些操作的底层时间复杂度本身是 \(O(N)\),会使原本的单层循环不知不觉退化为 \(O(N^2)\)。如果需要从头部出队,应使用双指针维护游标或自建环形队列。 - 注意大整数运算精度:JavaScript 的
Number遵循 IEEE 754 双精度浮点标准,安全整数范围为Number.MIN_SAFE_INTEGER至Number.MAX_SAFE_INTEGER(即 \(\pm (2^53 - 1)\))。当题目涉及长数字字符串累加或链表大数加法时,应按位模拟加法或使用BigInt,杜绝直接parseInt导致精度丢失。 - 避免无边界递归导致调用栈溢出(Call Stack Overflow):递归深度超过数千层时浏览器引擎会直接抛出
Maximum call stack size exceeded。在处理复杂深度树(如扁平化、深度克隆)时,优先采用“数组显式维护栈/队列”的迭代方式实现。 - 保持函数纯粹,杜绝入参副作用:在面试手写代码中,除非题目明确要求原地修改(In-Place),否则尽量避免直接修改传入的入参数组或对象引用,这体现了良好的前端工程素养与不可变数据理念。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章