
系统解析 JavaScript 中 JSON.parse 与 JSON.stringify 的核心概念、基础用法与参数机制(replacer、space、reviver),深度对比二者的遍历顺序差异,并提供循环引用、BigInt、时间还原等典型陷阱与排查方案。

当前位置:首页 > JavaScript 基础 > 正文
JS中JSON.parse与JSON.stringify的基础用法及参数详解
作者:异步漫步
时间:2026-11-19
浏览:86
文章目录
在 JavaScript 开发中,对象(内存中的结构化数据)与 JSON 文本(网络传输与持久化存储的标准字符串)之间的互相转换是最高频的基础操作。全局内置对象
JSON 提供了两个核心方法:JSON.stringify 负责将数据序列化为符合 JSON 规范的字符串,而 JSON.parse 则负责将字符串逆向解析为 JavaScript 原始值或结构体。除了基础的数据传入,二者均配备了关键的高阶参数(replacer、space、reviver),用于在流转过程中实现精细化的字段筛选、数据格式化与类型还原。本文将系统拆解两个方法的核心语法、参数底层机制与执行逻辑,并结合实际场景梳理常见陷阱与解决方案。
一、JSON 序列化与反序列化的核心概念与基础语法
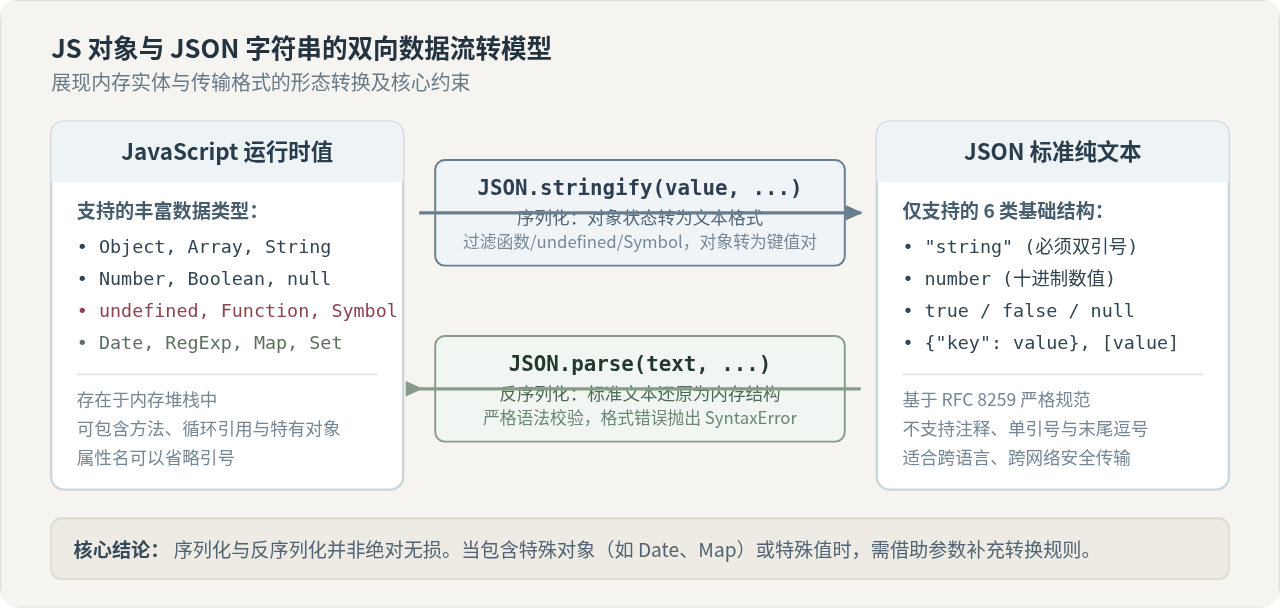
JSON(JavaScript Object Notation)是一种轻量级的数据交换格式,其语法源于 JavaScript 对象的字面量表示法,但它本质上是一种与语言无关的严格文本格式。理解 JSON.stringify 与 JSON.parse 的前提,是明确 JavaScript 运行时对象与 JSON 文本之间的边界差异。
在 JavaScript 代码中,对象属性名可以不加引号,属性值可以是函数、undefined、Symbol 或 Date 等复杂对象;但在标准 JSON 格式中,所有属性名与字符串值都必须使用双引号包裹,且只支持六种基本结构:字符串(String)、数值(Number)、布尔值(Boolean)、空值(null)、对象(Object)以及数组(Array)。
1. JSON.stringify 的基础调用
基础调用仅需传入一个待序列化的 JavaScript 值。JSON.stringify 会遍历该值并返回其紧凑排版的 JSON 字符串:
// 基础序列化示例
const user = {
    name: "Alex",
    age: 28,
    isAdmin: false,
    tags: ["developer", "javascript"]
};

const jsonString = JSON.stringify(user);
console.log(jsonString);
// 输出结果 (示例):
// '{"name":"Alex","age":28,"isAdmin":false,"tags":["developer","javascript"]}'
2. JSON.parse 的基础调用
JSON.parse 接受一个符合 JSON 语法的字符串,解析并构造成对应的 JavaScript 对象或基本类型:
// 基础反序列化示例
const rawResponse = '{"id":1001,"status":"success","data":{"count":42}}';
const parsedData = JSON.parse(rawResponse);

console.log(parsedData.id);            // 1001
console.log(parsedData.data.count);    // 42
注意语法严格性
JSON.parse 对文本格式的要求极其严苛。如果字符串中存在单引号(如 {'name':'Alex'})、属性名未加双引号、结尾存在多余的逗号(trailing comma)或者传入了 undefined,都会直接抛出 SyntaxError 运行时异常。
二、JSON.stringify 的参数详解与执行链路
JSON.stringify 的完整语法签名包含三个参数:
JSON.stringify(value[, replacer[, space]])
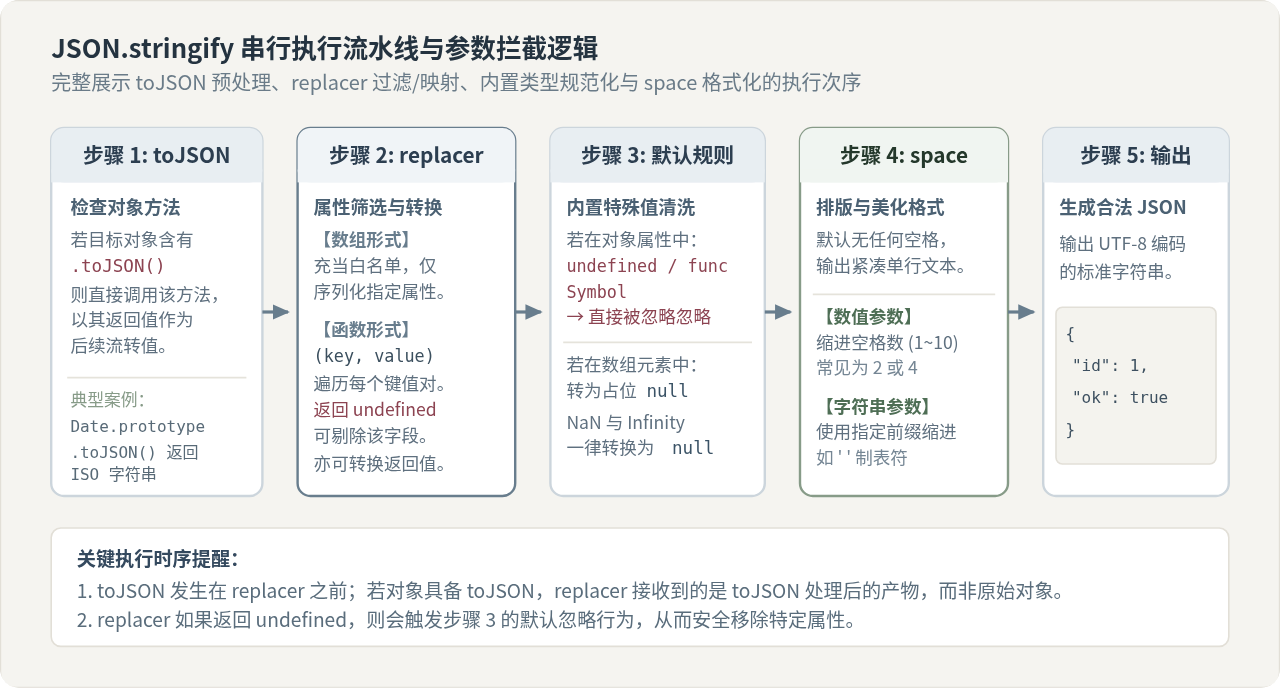
其中 value 为必选参数,replacer 和 space 为可选参数。序列化并非简单的“直接拼接字符串”,而是遵循一套结构清晰的处理流程。
1. 参数一:value 与 toJSON() 方法机制
当传入 value 时,序列化引擎会优先检测当前对象(或其原型链)上是否声明了 toJSON() 方法。若存在该方法,JSON.stringify 会直接调用它,并使用其返回值继续后续的序列化操作,而忽略对象内部的其他原始属性。
const book = {
    title: "深入理解JavaScript",
    isbn: "978-7-121-00000-0",
    internalPrice: 8900,
    toJSON() {
        // 自定义序列化产物:仅暴露公开字段,并将价格换算为元
        return {
            title: this.title,
            price: (this.internalPrice / 100).toFixed(2) + "元"
        };
    }
};

console.log(JSON.stringify(book));
// 输出结果 (示例):
// '{"title":"深入理解JavaScript","price":"89.00元"}'
JavaScript 原生内置的 Date.prototype.toJSON 就是该机制的典型应用:当序列化 new Date() 实例时,会自动调用其 toJSON() 返回 ISO 格式的日期字符串(如 "2026-11-18T04:15:00.000Z")。
2. 参数二:replacer 替换器(数组白名单 vs 转换函数)
replacer 参数提供了对对象属性的精细控制能力,支持传入数组或函数两种形态:
-
数组形式(属性白名单):
当replacer是一个由字符串或数字组成的数组时,只有包含在该数组中的键名才会被序列化到结果中,未包含的属性会被静默剔除。该规则只对普通对象生效,不影响数组元素的输出。
const article = {
    id: 101,
    title: "JSON参数详解",
    author: "张工",
    draft: true,
    views: 3200
};

// 仅保留 id、title 与 author 三个字段
const whiteList = ["id", "title", "author"];
console.log(JSON.stringify(article, whiteList));
// 输出结果 (示例):
// '{"id":101,"title":"JSON参数详解","author":"张工"}'-
函数形式(映射与过滤器):
当replacer为函数时,签名格式为(key, value) => any。在序列化过程中,每个键值对都会传入该函数。- 如果返回一个新值,该值将替换原属性值进行序列化;
- 如果返回
undefined,该属性将被直接忽略并剔除; - 特别注意:第一次调用时,传入的
key为空字符串"",而value是整个被序列化的原始根对象。
const account = {
    username: "john_doe",
    passwordHash: "a8f5f167f44f4964e6c998dee827110c",
    balance: 500,
    role: "editor"
};

const sanitized = JSON.stringify(account, (key, value) => {
    // 隐藏敏感字段
    if (key === "passwordHash") {
        return undefined; // 移除该属性
    }
    // 对数值类型统一加上货币标识
    if (typeof value === "number") {
        return `$${value}`;
    }
    return value; // 其余字段保持原样
});

console.log(sanitized);
// 输出结果 (示例):
// '{"username":"john_doe","balance":"$500","role":"editor"}'
3. 参数三:space 缩进格式化
默认情况下,JSON.stringify 输出的是无空格、无换行的紧凑字符串,适合网络传输与存储。但在本地调试、生成配置文件或日志记录时,可借助 space 参数输出格式化后的可读文本。
- 数值类型:指定缩进的空格数(范围为 1 至 10,超过 10 会自动截断为 10)。
- 字符串类型:使用指定的字符前缀进行缩进(最长截取前 10 个字符,例如
' ')。
const config = { host: "localhost", port: 8080 };

// 缩进 2 个空格
console.log(JSON.stringify(config, null, 2));
// 输出 (示例):
// {
//   "host": "localhost",
//   "port": 8080
// }

// 使用制表符 '	' 缩进
console.log(JSON.stringify(config, null, "\t"));
4. 默认内置类型过滤规则
在不配置 replacer 的情况下,序列化引擎会对非标准 JSON 类型执行内置规整:
- 对象属性:若值为
undefined、Function(函数)或Symbol,在序列化时该属性会被直接跳过。 - 数组元素:若数组项为
undefined、Function或Symbol,为了保证索引顺序不变,会被转换为null占位。 - 数值异常:
NaN、Infinity以及-Infinity会被自动转为null。
三、JSON.parse 的参数详解与对象还原
JSON.parse 的完整语法签名如下:
JSON.parse(text[, reviver])
除了必选的待解析字符串 text 之外,第二个可选参数 reviver(还原函数 / 转换器)允许开发者在最终对象返回之前,对每个解析出的键值对进行深度拦截与定制恢复。
1. reviver 函数的签名与执行机制
reviver 函数接收两个参数 (key, value),当前被遍历属性的上下文 this 指向该属性所属的父对象:
- 如果
reviver返回一个值,解析树中该属性的值会被替换为该返回值; - 如果
reviver返回undefined,该属性将从最终生成的对象中删除; - 与
replacer类似,reviver在最后一次执行时,key同样为空字符串"",value为此时已经经过全部子节点处理的顶层对象。
2. 典型实战场景:自动还原 Date 日期对象
由于 JSON 规范中不存在原生的“日期类型”,通过 JSON.stringify 序列化后的日期会退化为 ISO 格式的纯字符串。在反序列化时,如果不做特殊处理,解析出来的依然只是普通字符串。利用 reviver 可以无缝将其恢复为真实的 Date 实例:
const logEntryJson = '{"id":"log_01","timestamp":"2026-11-18T04:15:00.000Z","level":"INFO"}';

// ISO 8601 日期正则检测
const ISO_DATE_REGEX = /^\d{4}-\d{2}-\d{2}T\d{2}:\d{2}:\d{2}(?:\.\d+)?Z$/;

const logEntry = JSON.parse(logEntryJson, (key, value) => {
    // 识别符合 ISO 日期格式的字符串并还原为 Date 实例
    if (typeof value === "string" && ISO_DATE_REGEX.test(value)) {
        return new Date(value);
    }
    return value;
});

console.log(logEntry.timestamp instanceof Date); // true
console.log(logEntry.timestamp.getFullYear());     // 2026
3. 典型实战场景:字段安全过滤与重命名
当接收不可信的外部输入或旧版本接口数据时,可以借助 reviver 在解析阶段直接剔除废弃字段或过滤危险键名:
const payload = '{"title":"API文档","deprecatedField":"temp","__proto__":{"polluted":true}}';

const cleanObject = JSON.parse(payload, (key, value) => {
    // 拦截原型污染键或废弃字段
    if (key === "__proto__" || key === "deprecatedField") {
        return undefined; // 移除该属性
    }
    return value;
});

console.log(cleanObject.deprecatedField); // undefined
console.log(Object.prototype.polluted);   // undefined (安全防护生效)
四、机制深度对比:replacer 与 reviver 的执行逻辑与遍历差异
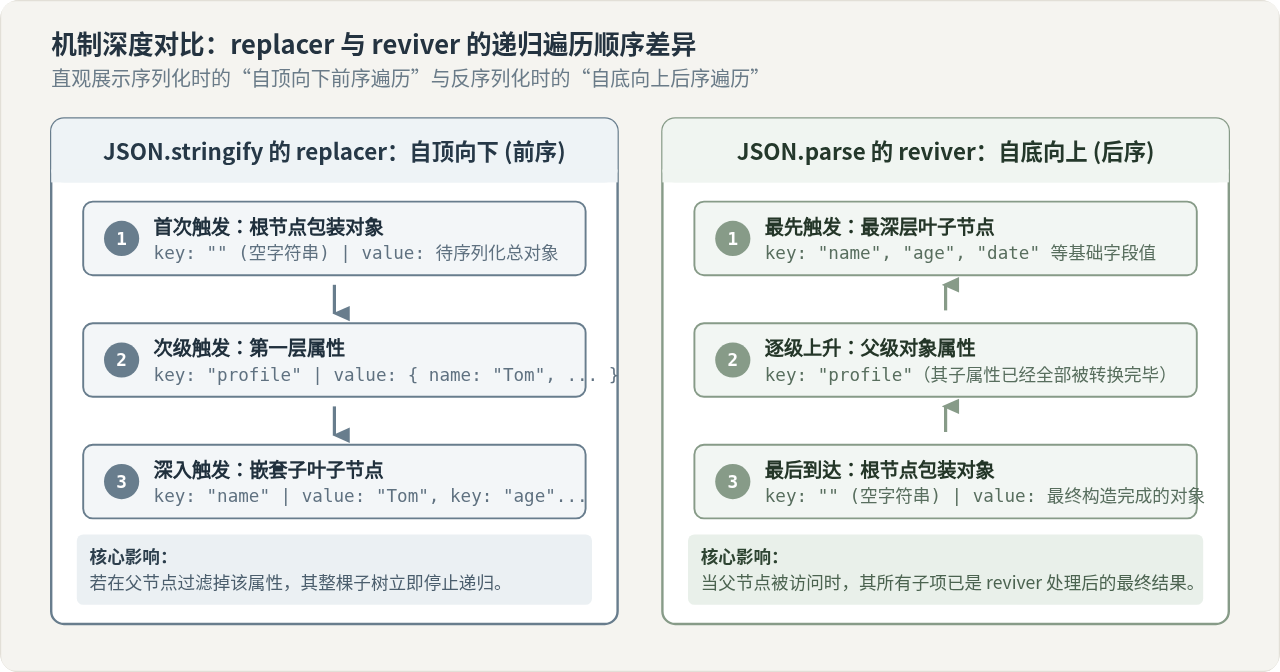
很多初学者容易将 replacer 和 reviver 视为对称的“前置过滤器”和“后置过滤器”,但在底层实现中,两者的遍历顺序和作用方式存在根本性差异。
关键差异点
JSON.stringify 的 replacer 采用自顶向下(Top-down / 前序遍历)方式执行;
JSON.parse 的 reviver 采用自底向上(Bottom-up / 后序遍历)方式执行。
1. 遍历时序的代码验证
我们通过一段打印代码,直观观察二者在处理同一嵌套对象时的执行轨迹:
const treeData = {
    level: 1,
    child: {
        level: 2,
        leaf: "target"
    }
};

console.log("--- replacer 执行顺序 ---");
JSON.stringify(treeData, (key, value) => {
    console.log(`key: "${key}"`);
    return value;
});
// 打印轨迹:
// key: ""          (根对象包装)
// key: "level"     (顶层属性 1)
// key: "child"     (顶层属性 child 对象)
// key: "level"     (嵌套属性 2)
// key: "leaf"      (叶子属性 target)

console.log("--- reviver 执行顺序 ---");
const jsonStr = '{"level":1,"child":{"level":2,"leaf":"target"}}';
JSON.parse(jsonStr, (key, value) => {
    console.log(`key: "${key}"`);
    return value;
});
// 打印轨迹:
// key: "level"     (顶层属性 1)
// key: "level"     (嵌套属性 2)
// key: "leaf"      (叶子属性 target)
// key: "child"     (嵌套完成后的 child 对象)
// key: ""          (全部解析完毕后的根对象)
2. 差异对业务逻辑的关键影响
-
自顶向下的截断效应(replacer):
当replacer遍历到父节点并返回undefined或替换为一个简单值时,底层的子属性将直接不再被遍历。这种机制使得开发者可以在树的高层快速砍掉整条分支,执行效率高。 -
自底向上的数据完备性(reviver):
reviver必须先处理所有的子叶子节点,将转换好的子属性赋值给父节点后,才轮到父节点触发reviver。因此,当父节点的reviver函数执行时,其内部包含的所有子属性已经是完全转换完毕的最新状态,开发者可以在父节点中根据已处理好的子属性计算派生值。
五、进阶实战:特殊类型处理与常见陷阱排查
在工程实践中,数据结构往往复杂多变。以下梳理四个最容易导致程序崩溃或数据失真的典型陷阱,并给出标准解决代码。
1. 陷阱一:循环引用(Circular Structure)导致崩溃
当对象属性直接或间接引用了自身时,直接调用 JSON.stringify 会抛出 TypeError: Converting circular structure to JSON。
// 构造循环引用
const nodeA = { name: "Node A" };
const nodeB = { name: "Node B" };
nodeA.next = nodeB;
nodeB.prev = nodeA; // 形成回路

// 错误调用:JSON.stringify(nodeA) -> 抛出 TypeError

// 解决方案:使用 WeakSet 跟踪引用过的对象
function safeStringify(obj, space = 2) {
    const seen = new WeakSet();
    return JSON.stringify(obj, (key, value) => {
        if (typeof value === "object" && value !== null) {
            if (seen.has(value)) {
                return "[Circular]"; // 替换循环引用标记
            }
            seen.add(value);
        }
        return value;
    }, space);
}

console.log(safeStringify(nodeA));
// 输出 (示例):
// {
//   "name": "Node A",
//   "next": {
//     "name": "Node B",
//     "prev": "[Circular]"
//   }
// }
2. 陷阱二:BigInt 序列化直接报错
ES2020 引入的 BigInt 原始类型没有定义内置的 JSON 序列化方法。直接对包含 BigInt 的对象执行 JSON.stringify 会抛出 TypeError: Do not know how to serialize a BigInt。
// 解决方案 A:针对原型拓展 toJSON
BigInt.prototype.toJSON = function () {
    return this.toString();
};

const transaction = { id: 987654321987654321n, amount: 100n };
console.log(JSON.stringify(transaction));
// 输出 (示例):'{"id":"987654321987654321","amount":"100"}'

// 解决方案 B:通过 replacer 动态转换(避免污染原型)
const safeJson = JSON.stringify(transaction, (key, value) => {
    return typeof value === "bigint" ? value.toString() : value;
});
3. 陷阱三:超长整型(Snowflake ID)解析精度丢失
JavaScript 中的 Number 遵循 IEEE 754 双精度浮点数标准,安全整数范围为 -(2^53 - 1) 到 2^53 - 1(即 Number.MIN_SAFE_INTEGER 至 Number.MAX_SAFE_INTEGER,上限为 9007199254740991)。
当后端接口返回 64 位长整数(如分布式雪花算法 ID 9007199254740993)且未转为字符串时,前端原生 JSON.parse 解析后会自动舍入为 9007199254740992,造成毁灭性的业务数据错乱。
工程解决建议
1. 接口规范治理:推动服务端在输出 JSON 响应时,将所有 64 位大整数统一序列化为 String 字符串;
2. 客户端解析兜底:若数据源不可控,需采用支持 BigInt 的第三方解析库(如 json-bigint)代替原生 JSON.parse。
4. 陷阱四:不可靠文本的解析异常防御
生产环境中,任何从 LocalStorage、网络请求或文件读取中获取的 JSON 文本都应视为不可信源。直接使用 JSON.parse 容易因格式微瑕导致整页代码中断。
// 健壮的反序列化包装函数
function tryParseJSON(text, fallback = null) {
    if (typeof text !== "string") {
        return fallback;
    }
    try {
        return JSON.parse(text);
    } catch (err) {
        console.warn("JSON解析失败,返回默认值:", err.message);
        return fallback;
    }
}

const invalidText = "{ user: 'Alex', }"; // 非法JSON(键无双引号,末尾有逗号)
const result = tryParseJSON(invalidText, { user: "Guest" });
console.log(result.user); // "Guest"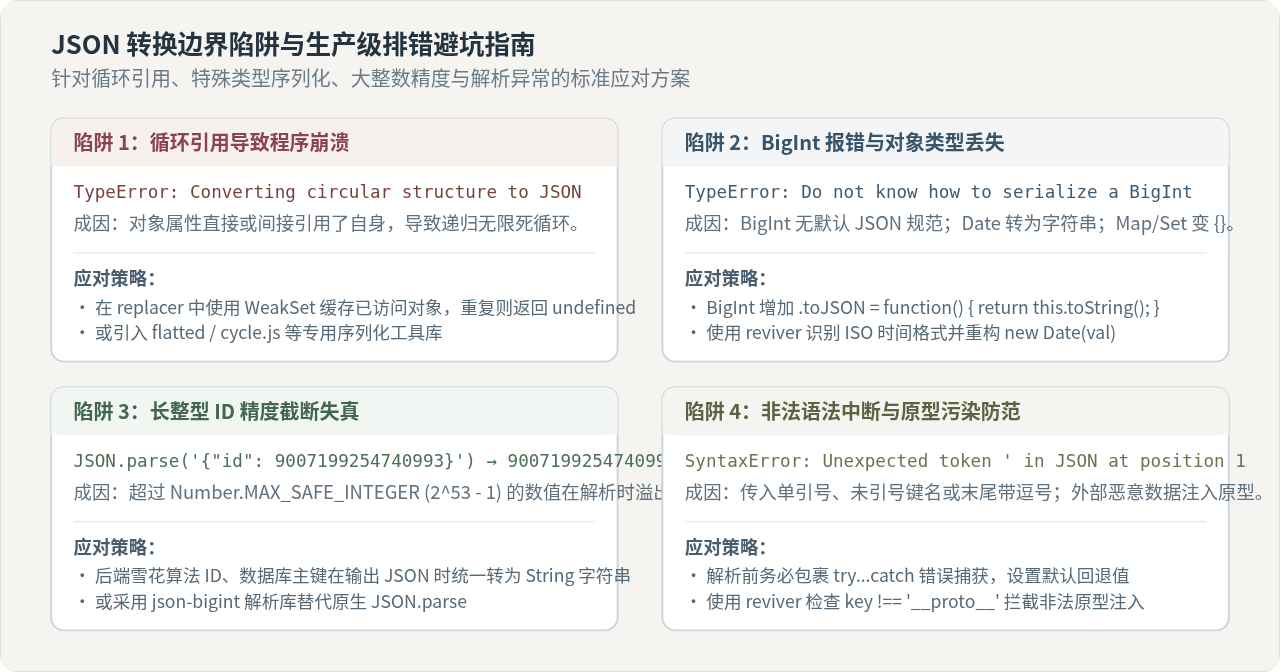
六、核心参数与行为速查表
为了方便日常开发查阅,下表总结了 JSON.stringify 与 JSON.parse 的全部参数、调用形式与核心要点:
| 方法 | 参数名称 | 参数形态 / 类型 | 核心功能与注意事项 |
|---|---|---|---|
| JSON.stringify | value |
任何 JavaScript 值 | 待序列化的数据。若包含 toJSON() 则优先使用该方法返回值。 |
replacer (可选) |
Array<string|number>或 Function(key, val) |
• 数组:属性白名单; • 函数:逐项自顶向下映射,返回 undefined 剔除该属性。
|
|
space (可选) |
number (1~10)或 string (前10字) |
控制输出的缩进排版。传数字代表缩进空格数,传字符串(如 "\t")作为缩进前缀。 |
|
| JSON.parse | text |
string |
必须是严格符合 RFC 8259 规范的 JSON 文本,否则抛出 SyntaxError。 |
reviver (可选) |
Function(key, val) |
自底向上深度优先遍历。常用于将 ISO 日期字符串恢复为 Date 实例或防范原型污染。 |
综上所述,JSON.stringify 与 JSON.parse 构成了 JavaScript 数据流转的基础桥梁。在日常业务中,掌握 replacer 的字段过滤能力、space 的格式化选项以及 reviver 的深度还原机制,能够帮助开发者在处理数据持久化、跨端通讯和数据清洗时写出更健壮、安全且高效的代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章