
在 JavaScript 中实现每个单词首字母大写(Title Case),常见且实用的方案主要有两种:一是利用 split 将字符串切分为数组,配合 map 对每个单词的首字符提取大写后重新 join 拼接;二是利用正则表达式 \b 词界断言配合 replace 函数就地替换。本文详细讲解这两种主流解法的代码实现、运行原理、边界防御及技术选型。

当前位置:首页 > JavaScript 基础 > 正文
JS怎么实现每个单词首字母大写
作者:小括号
时间:2026-11-20
浏览:256
文章目录
JavaScript 核心基础
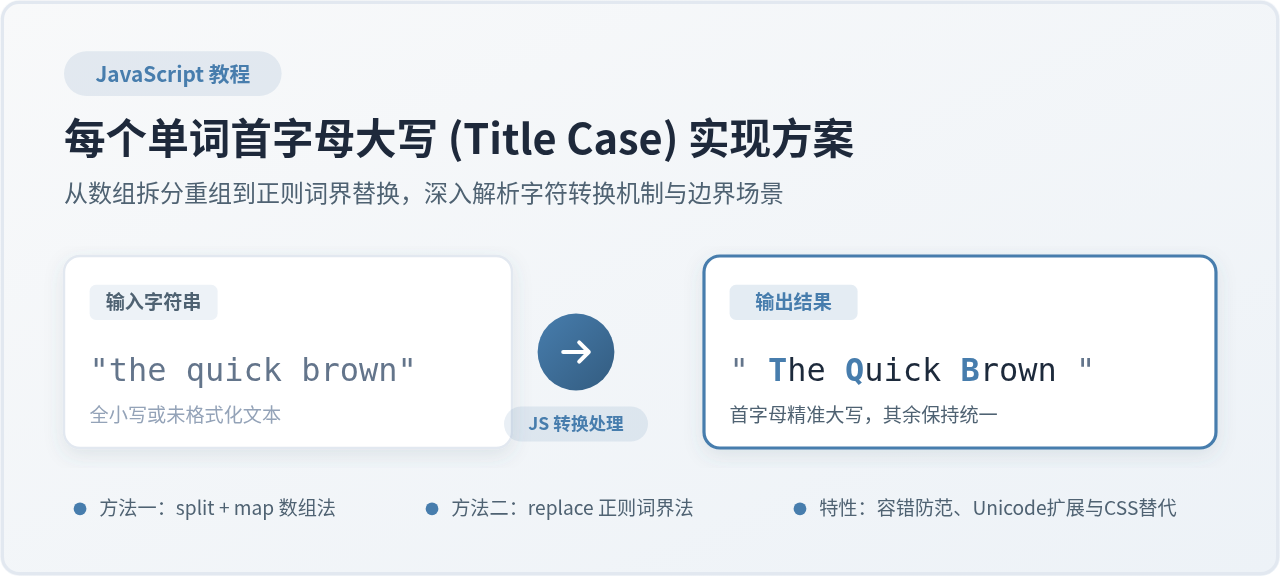
图示:JavaScript 每个单词首字母大写的数据流转与转换模型
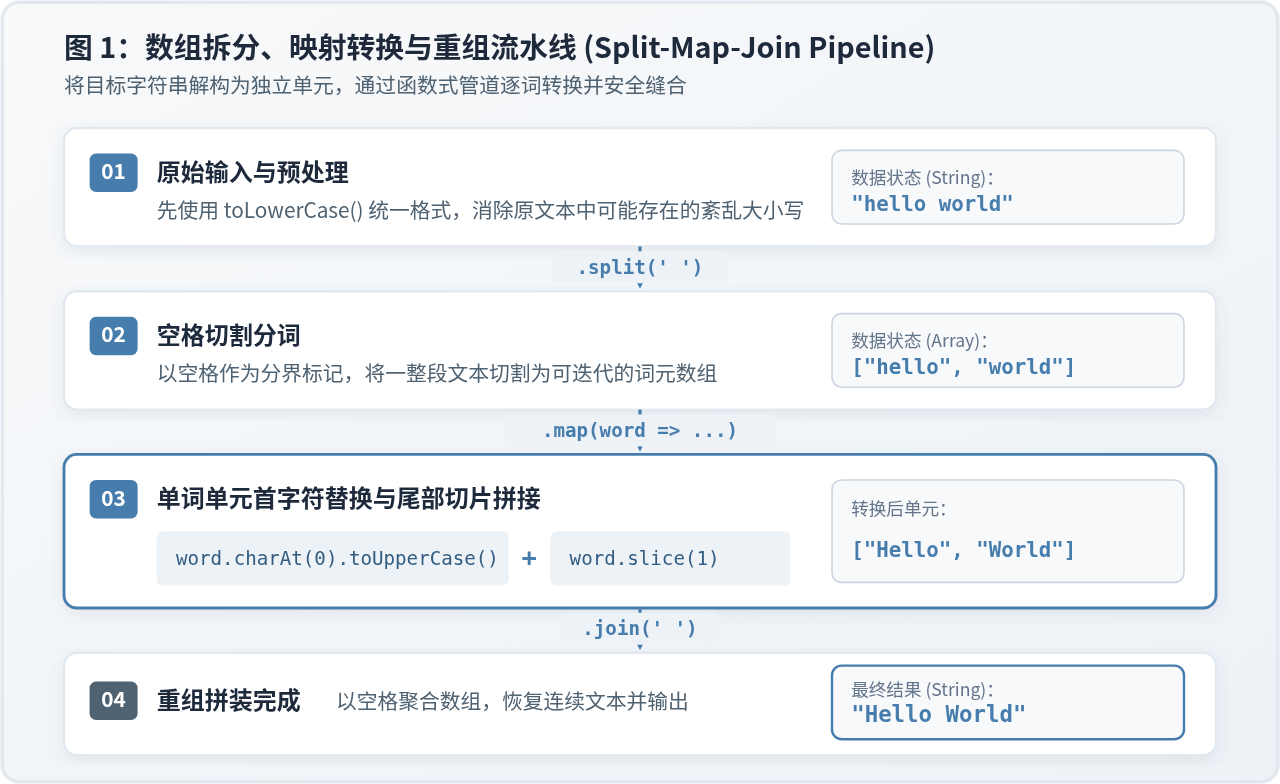
图 1:数组拆分、映射转换与重组流水线 (Split-Map-Join Pipeline)
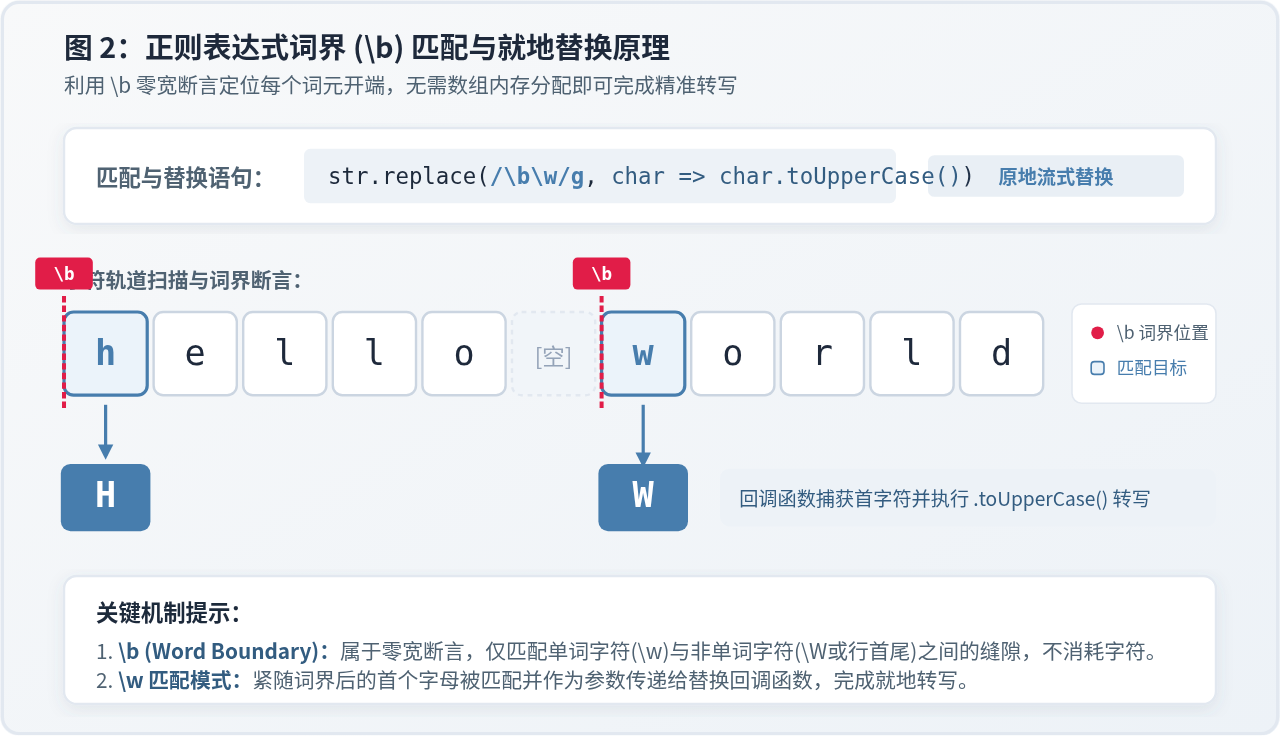
图 2:正则表达式词界 () 匹配与就地替换原理
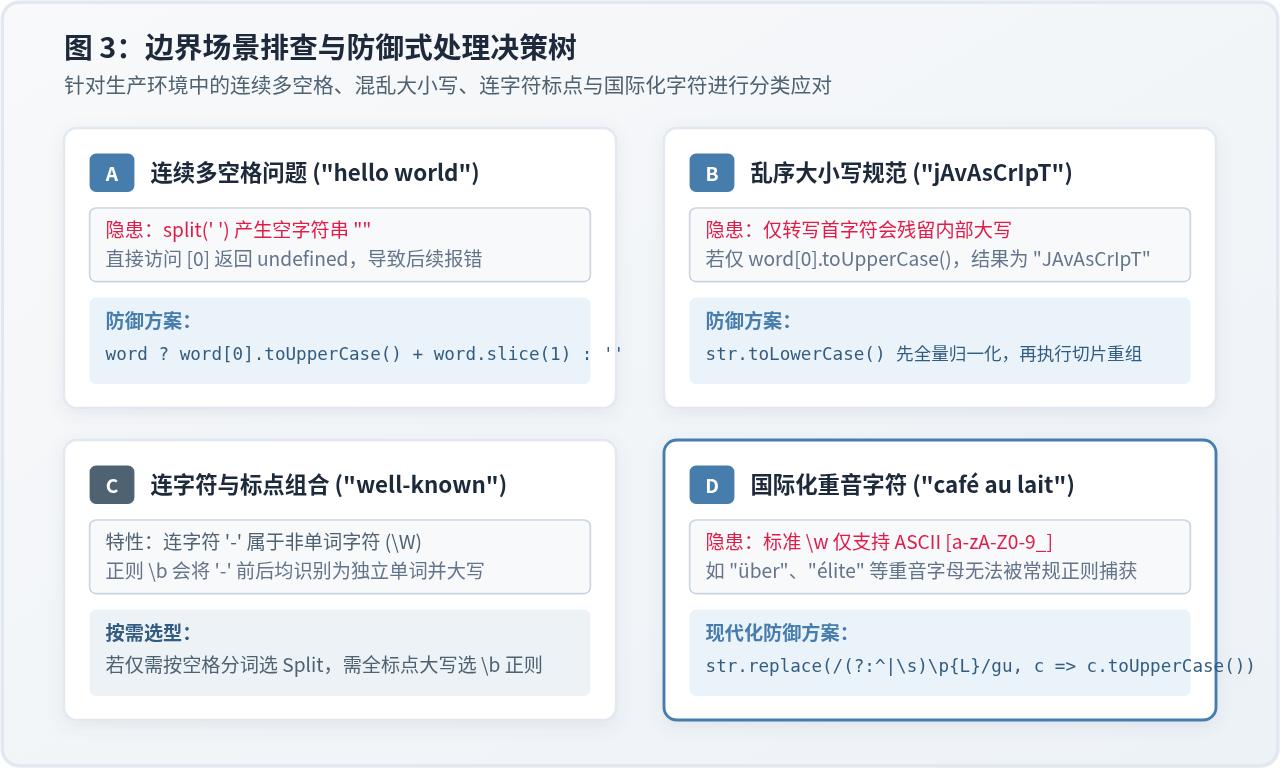
图 3:边界场景排查与防御式处理决策树
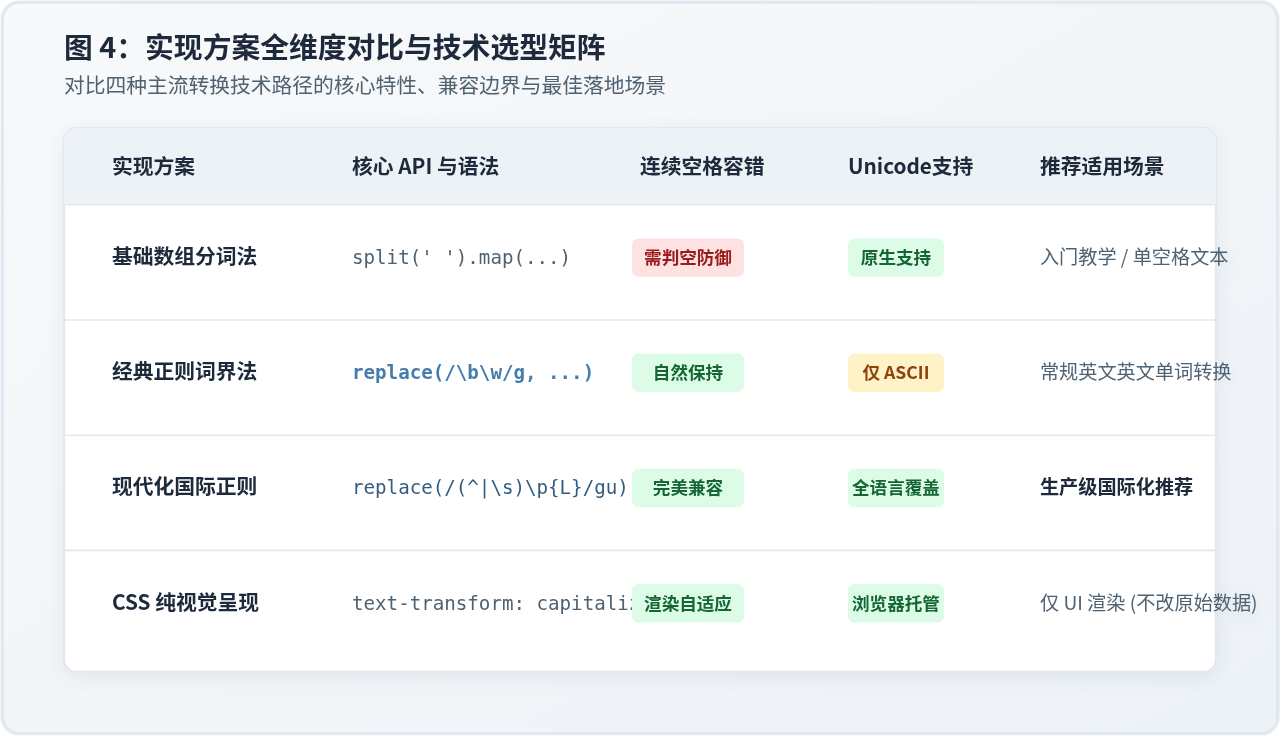
图 4:实现方案全维度对比与技术选型矩阵
在 JavaScript 开发中,将一段文本中每个英文单词的首字母转换成大写(英文通常称为 Title Case 或 Capitalize Words)是一项高频需求。实现该功能的核心路径主要有两条:一是基于数组的“切分—映射—拼接”管道法,二是基于正则表达式的“词界断言与就地替换”法。本文将从具体代码实现、底层工作机制、常见边界隐患及工程选型四个维度展开详细讲解。
一、基于数组的经典实现:split + map + join
对于绝大多数初学者和日常业务场景,利用 JavaScript 字符串与数组之间的内置方法进行组合转换是最直观、可读性最好的方式。
这种方法的核心思想非常明确:先用空格将长文本拆分为单词数组,再遍历数组对每个单词的首字符调用 toUpperCase(),最后与该单词截取后的其余部分拼接,重新组合成完整字符串。
// 方法一:基础数组拆分与组合
function titleCaseWithArray(str) {
  if (!str) return "";
  return str
    .toLowerCase()
    .split(" ")
    .map(word => word.charAt(0).toUpperCase() + word.slice(1))
    .join(" ");
}

// 示例验证
const rawText = "hello world from javascript";
console.log(titleCaseWithArray(rawText));
// 示例输出: "Hello World From Javascript"
代码执行步骤拆解
- 全量小写归一化(
.toLowerCase()):在提取首字母前,先将整个字符串转为小写。如果不做这一步,遇到类似"jAvAsCrIpT"的混乱输入时,只大写首字母会保留内部的异常大写,导致输出为"JAvAsCrIpT"。 - 按空格分词(
.split(" ")):将字符串切分为单词单元组成的数组,例如["hello", "world"]。 - 单词单元切片重组(
.map(...)):word.charAt(0).toUpperCase():提取索引为 0 的第一个字符并大写;word.slice(1):截取从索引 1 开始直到末尾的剩余字符;- 通过加号运算符将两部分缝合。
- 数组重新组合(
.join(" ")):以单个空格为分隔符,将处理完成的数组重新连接成连续文本。
二、基于正则表达式的高效替换:replace +
如果追求代码极简,或者希望在面对复杂空白符、换行符时依然保持原有排版格式,使用正则表达式的 replace 方法是更高效的方案。
JavaScript 的正则引擎支持词界断言 。利用 \w 可以在不把字符串打散存入临时数组的情况下,直接在字符轨道上定位每个词的首个字母并就地替换。
// 方法二:正则表达式词界替换
function titleCaseWithRegex(str) {
  if (!str) return "";
  return str
    .toLowerCase()
    .replace(/\w/g, char => char.toUpperCase());
}

// 示例验证
const sentence = "the quick brown fox jumps";
console.log(titleCaseWithRegex(sentence));
// 示例输出: "The Quick Brown Fox Jumps"
底层原理与词界机制解析
这行正则之所以能生效,关键在于两个核心元字符的配合:
- 零宽词界断言
:并不匹配具体的字符实体,而是匹配一个“位置”。当某个位置的一侧是单词字符(\w,即字母、数字或下划线),另一侧是非单词字符(如空格、标点、换行或字符串边界)时,该位置即触发词界匹配。 - 单词字符
\w与全局标记g:紧随词界后面的第一个字母被捕获,并作为参数传入回调函数char => char.toUpperCase()中,完成就地转写。
内存与性能优势:相比于数组法,正则表达式方法无需开辟数组存储分词碎片,在处理数万字级别的长文本时具有显著更低的垃圾回收(GC)压力和内存开销。
三、实战边界场景排查与防御式处理
在实际生产环境中,用户输入的文本往往并不像示例代码那样规整。如果直接套用简易版本,容易在特定场景下遭遇异常甚至报错。以下是必须重点排查的四个边界问题:
1. 连续多个空格(Multiple Spaces)
如果原始字符串中包含多个连续空格,例如 "hello world":
- 基础数组法的
split(" ")会切出多个空字符串""。 - 如果代码中直接使用
word[0].toUpperCase(),空字符串的word[0]将返回undefined,调用undefined.toUpperCase()会直接抛出运行时错误TypeError。 - 使用
word.charAt(0)虽然不会报错(返回空串""),但仍需确保切片拼接逻辑不会产生额外冗余。
2. 乱序大小写混杂(Mixed Casing)
遇到首字母已经大写、但后续字母夹杂大写的情况(如 "mAcBoOk" 或 "HTML"),开发者需要明确业务预期:
- 规范化预期:如果要求强行规范为标头格式,必须在处理前调用
toLowerCase(),得到"Macbook"。 - 专有名词保留:如果希望保留某些缩写词的现有大写,则不能全量小写,需结合专用词典或放宽后续字符转换。
3. 带有连字符和特殊标点的复合词(Hyphenated Words)
对于 "well-known" 或 "state-of-the-art" 这类复合词:
- 数组法按空格
split(" ")处理时,会把well-known视为一个整体,结果为"Well-known"。 - 正则
\w则会将连字符-识别为非单词字符,从而使known的k前面也产生词界,转换结果为"Well-Known"。
4. 国际化与重音拉丁字符(Unicode & Accents)
在法语、西班牙语、德语等多语言文本中,常见诸如 "café"、"résumé"、"über" 等单词。ASCII 范围内的 \w 无法匹配重音字符开头的单词(例如 "élite" 开头的 é)。此时应借助 ES2018 引入的 Unicode 属性转义 \p{L} 与 u 标记。
工业级防御式实现封装
综合以上边界隐患,以下是一份兼具连续空白容错、Unicode 国际化支持与大小写归一化控制的健壮函数封装:
/**
 * 工业级首字母大写转换函数
 * @param {string} str - 输入原始文本
 * @param {boolean} [normalizeLower=true] - 是否先归一化为全小写
 * @returns {string} 转换后的文本
 */
function toTitleCaseRobust(str, normalizeLower = true) {
  if (typeof str !== "string" || str.length === 0) return "";

  // 步骤 1:按需做小写归一化
  const base = normalizeLower ? str.toLowerCase() : str;

  // 步骤 2:利用 Unicode 属性 \p{L} 匹配任意语言字母,支持连续空格原样保留
  return base.replace(
    /(?:^|[\s\-_])(\p{L})/gu,
    (match, char) => match.slice(0, -1) + char.toUpperCase()
  );
}

// 边界情况测试
console.log(toTitleCaseRobust("hello   world"));          // 保持多空格: "Hello   World"
console.log(toTitleCaseRobust("well-known author"));      // 连字符处理: "Well-Known Author"
console.log(toTitleCaseRobust("café au lait"));          // 国际化重音: "Café Au Lait"
四、仅用于展示时的极简替代:CSS text-transform
如果进行首字母大写的目的仅仅是为了在网页界面中展示(例如文章标题卡片、商品列表标签),且无需将修改后的数据存入数据库或发送给后端接口,那么优先推荐使用 CSS 处理:
/* 仅在视觉渲染层面实现首字母大写,无需运行 JS 脚本 */
.title-capitalize {
  text-transform: capitalize;
}
何时选 CSS,何时选 JS?
- 使用 CSS 的场景:纯展示组件、UI 按钮标题、卡片分类。CSS 在浏览器合成层执行,完全不消耗主线程 JS 执行时间,性能最佳。
- 使用 JS 的场景:表单数据清洗、导出 CSV/Excel 文件、向服务端提交数据前规范格式、生成 URL Slug、或在 Node.js 服务端进行批量批处理。
五、各实现方案对比与技术选型
面对不同的业务体量和场景复杂度,开发者应根据以下对比矩阵合理选用:
| 方案分类 | 核心优势 | 潜在短板 | 适用环境 |
|---|---|---|---|
| 基础数组分词 (split + map) | 逻辑直观,无正则上手门槛,易于自定义中间处理。 | 连续空格会产生空项,需做长度防御;长文本下有数组内存分配开销。 | 日常前端小型数据处理、教学演练。 |
| 经典正则词界 (replace + ) | 代码短小精炼,保留原有空白排版,就地匹配内存消耗低。 | \w 仅限 ASCII 字符,非英语语言字符无法匹配。 |
常规英文字符串、快速工具函数。 |
| Unicode 健壮正则 (\p{L}) | 完整覆盖全球语言字母,容错率高,边界鲁棒性最强。 | 正则构造复杂度稍高,需要运行时支持 ES2018+。 | 多语言国际化网站、核心业务公共工具库。 |
| CSS text-transform | 零 JS 运算,不阻塞渲染,样式与数据天然解耦。 | 不改变实际 DOM 文本或底层数据,复制或接口传输时仍为原样。 | 纯前端视觉排版、界面展示。 |
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章