
详解在JavaScript中对包含字符串属性的对象数组进行高效、准确排序的方法。深入解析sort()与localeCompare()的协作机制,对比Unicode码点与本地化语言规则的本质差异,并提供中文拼音排序、自然数混合排序及空值容错处理的完整实战方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS怎么对对象数组中的字符串属性进行排序?
作者:半夏
时间:2026-11-20
浏览:236
文章目录
在 JavaScript 中对对象数组的字符串属性进行排序,核心做法是向 Array.prototype.sort()(或不改动原数组的 toSorted())传入一个自定义比较函数,在函数内部使用 a.prop.localeCompare(b.prop) 计算两个对象该属性的相对顺序。本文将从核心标准用法出发,解析本地化规则与普通大小比较符的根本区别,并针对中文拼音排序、自然数混合排序以及空值容错等实际需求提供完整示例。
一、核心标准写法:sort 与 localeCompare
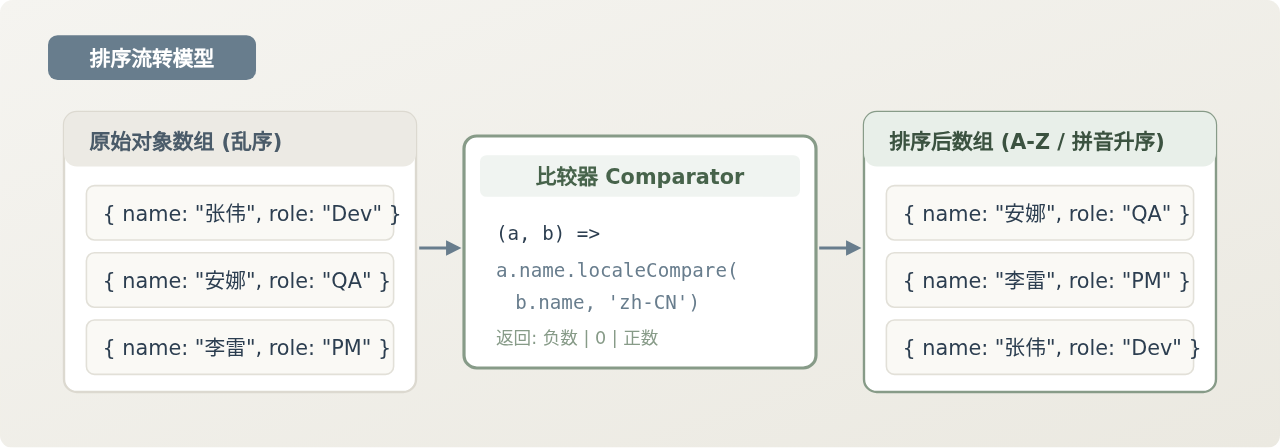
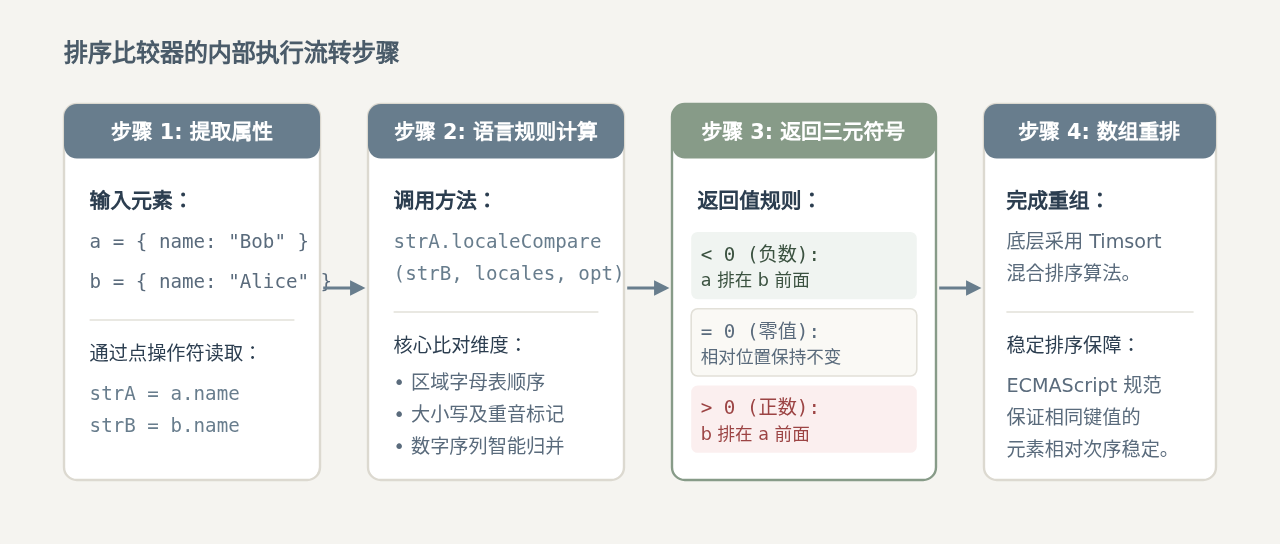
JavaScript 数组自带的 sort() 方法默认将元素转为字符串后按 UTF-16 码点顺序排布。当数组中的元素是对象时,必须向 sort() 传递一个接受两个参数 (a, b) 的比较函数。在比较函数中获取需要比对的字符串属性,并调用字符串的原型方法 localeCompare()。
// 示例:待排序的用户列表
const users = [
  { id: 1, name: "Charlie", department: "Sales" },
  { id: 2, name: "Alice", department: "Engineering" },
  { id: 3, name: "Bob", department: "Design" }
];

// 1. 按 name 属性升序排列 (A -> Z)
users.sort((a, b) => a.name.localeCompare(b.name));

// 2. 如果需要降序排列 (Z -> A),只需对调比较主体
// users.sort((a, b) => b.name.localeCompare(a.name));
不可变排序提示(ES2023+)
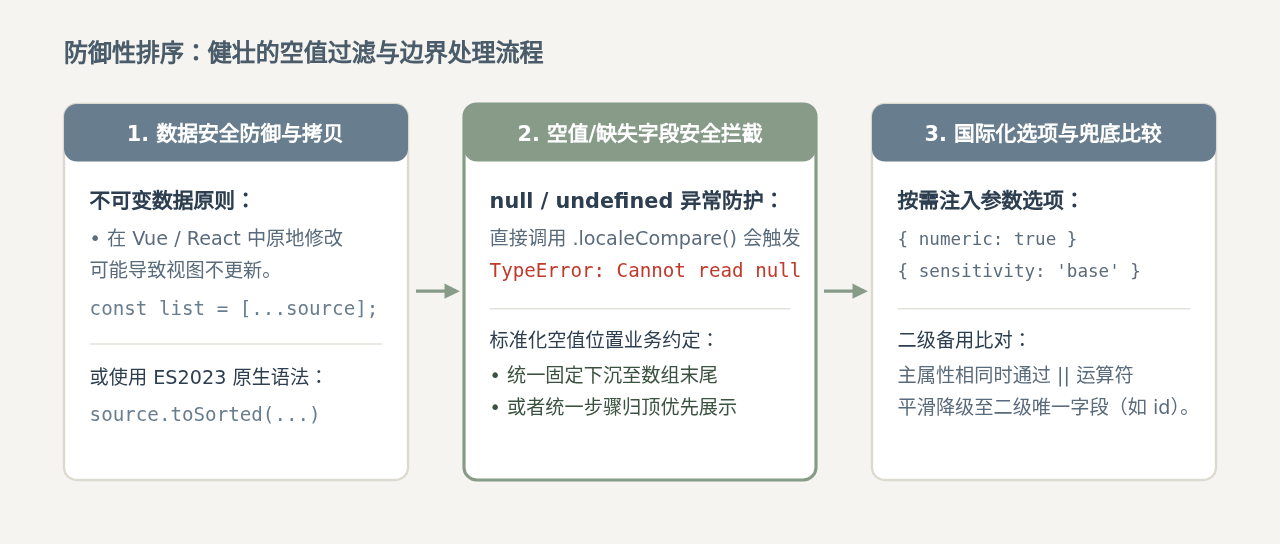
传统的 Array.prototype.sort() 会在原地(in-place)修改原数组。如果不希望污染原始数据,推荐使用 ES2023 标准引入的 toSorted() 方法:const sorted = users.toSorted((a, b) => a.name.localeCompare(b.name));,或者在调用 sort() 前先进行浅拷贝:const sorted = [...users].sort(...)。
二、关键机制对比:localeCompare 与 比较运算符
部分开发者习惯使用三元运算符搭配 > 或 <(例如 a.name > b.name ? 1 : -1)来排序字符串。虽然在纯粹的 ASCII 大写或小写英文字符下这两种写法看似一致,但在涉及非纯粹英文、大小写混合、数字编号或中文字符时,两者的底层逻辑和实际输出存在本质分歧。
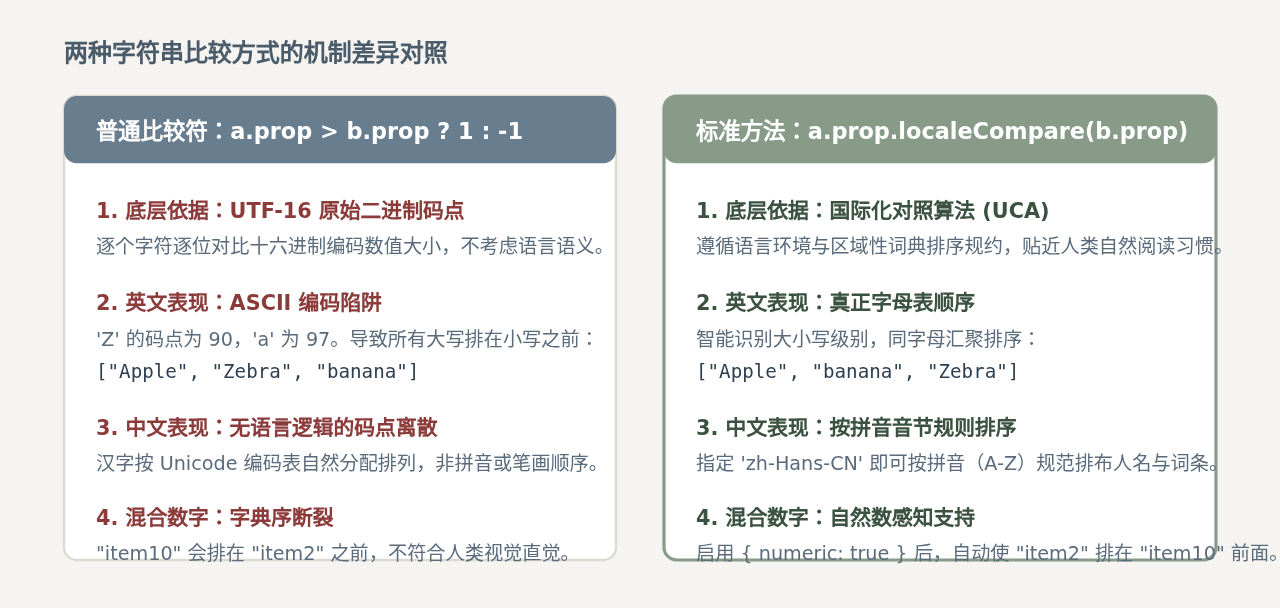
为了更清晰地理解这一差异带来的业务影响,下表列出了常见场景下的排序表现对比:
| 场景与输入数据 | a > b ? 1 : -1 (码点排序) |
a.localeCompare(b, 'zh-CN') (本地化排序) |
实际业务诉求 |
|---|---|---|---|
大小写混合英文["apple", "Banana", "cat"] |
["Banana", "apple", "cat"]大写全跑最前面 |
["apple", "Banana", "cat"]按字母表自然排 |
用户检索时通常期望忽略大小写或按字母聚类。 |
中文人名["张三", "安娜", "李四"] |
["安娜", "张三", "李四"]编码乱序(张: 24352, 李: 26446) |
["安娜", "李四", "张三"]按拼音 A(Ān)-L(Lǐ)-Z(Zhāng) |
中文系统的人名、省份、分类列表必须符合拼音规范。 |
版本号/文件序号["doc1", "doc10", "doc2"] |
["doc1", "doc10", "doc2"]10 排在 2 前面 |
可配置 { numeric: true }["doc1", "doc2", "doc10"] |
文件名或阶梯级别应按数值大小认知呈现。 |
三、常见应用场景与进阶代码
1. 中文属性按汉语拼音排序
默认调用 localeCompare() 时会采用浏览器当前的语言设置。在需要明确按照拼音对中文属性进行排序时,应显式传入 'zh-Hans-CN' 或 'zh-CN' 语言标签,确保各端执行结果一致:
const students = [
  { id: 101, name: "张伟" },   // Z
  { id: 102, name: "白敬亭" }, // B
  { id: 103, name: "陈赫" },   // C
  { id: 104, name: "安迪" }    // A
];

// 显式指定中文环境进行拼音升序排序
students.sort((a, b) => a.name.localeCompare(b.name, 'zh-Hans-CN'));

// 排序后顺序: 安迪 (A) -> 白敬亭 (B) -> 陈赫 (C) -> 张伟 (Z)
2. 包含数字的字符串自然排序 (Natural Sort)
当字符串中夹带数字编码时(如章节 "Chapter 2" 与 "Chapter 10"),常规字典序会使 10 排在 2 前面。只需向 localeCompare 的第三个参数传入 { numeric: true },即可开启自然数感应排序:
const files = [
  { filename: "part-10.png" },
  { filename: "part-1.png" },
  { filename: "part-2.png" }
];

// 启用 numeric: true 自然排序
files.sort((a, b) =>
  a.filename.localeCompare(b.filename, undefined, { numeric: true })
);

// 排序后: part-1.png -> part-2.png -> part-10.png
3. 多属性复合排序(主属性相同按次属性排序)
在实际业务列表中,经常需要先按部门(字符串)升序排列,部门相同的再按姓名(字符串)排序。由于 localeCompare 相等时返回 0,可以利用逻辑或运算符 || 极其简洁地链式表达多级排序:
const employees = [
  { dept: "技术部", name: "王五" },
  { dept: "产品部", name: "李四" },
  { dept: "技术部", name: "赵六" }
];

employees.sort((a, b) => {
  // 第一关键字:按部门拼音排序;部门相同时返回 0,触发第二关键字判断
  return a.dept.localeCompare(b.dept, 'zh-CN') ||
         a.name.localeCompare(b.name, 'zh-CN');
});
四、生产级边界处理:空值安全与高性能排序
在实际生产环境中,后端返回的对象数组往往存在属性为 null、undefined 或空字符串的情况。如果直接调用 a.name.localeCompare(...),只要遇到一个空对象就会引发运行时报错 TypeError: Cannot read properties of null。
解决该问题的标准策略是:在调用字符串方法前,先对空值进行显式拦截,通常将空值排在最末尾(或最前面):
/**
 * 健壮的对象数组字符串排序工具函数(默认空值沉底)
 * @param {Array<Object>} array 原始对象数组
 * @param {string} key 需要排序的字符串属性键名
 * @param {boolean} [ascending=true] 是否升序
 * @param {string} [locale='zh-CN'] 区域语言
 * @returns {Array<Object>} 返回全新排序后的数组
 */
function safeSortByString(array, key, ascending = true, locale = 'zh-CN') {
  // 浅拷贝数组,确保纯函数不修改输入原数组
  return [...array].sort((itemA, itemB) => {
    const valA = itemA?.[key];
    const valB = itemB?.[key];

    const isEmptyA = valA === null || valA === undefined;
    const isEmptyB = valB === null || valB === undefined;

    // 双方均为空值时相对顺序保持一致
    if (isEmptyA && isEmptyB) return 0;
    // 空值统一固定沉底
    if (isEmptyA) return 1;
    if (isEmptyB) return -1;

    const strA = String(valA);
    const strB = String(valB);

    const res = strA.localeCompare(strB, locale, { numeric: true });
    return ascending ? res : -res;
  });
}
海量数据(>10000条)性能优化:Intl.Collator
如果在需要频繁排序的大型数据集中多次执行 str.localeCompare(),浏览器会反复初始化语言规则对照表。若遇到性能瓶颈,可先在外部预先创建一个 const collator = new Intl.Collator('zh-CN', { numeric: true }) 实例,随后在排序循环中使用 collator.compare(a[key], b[key]),能显著减少语言上下文解析开销。
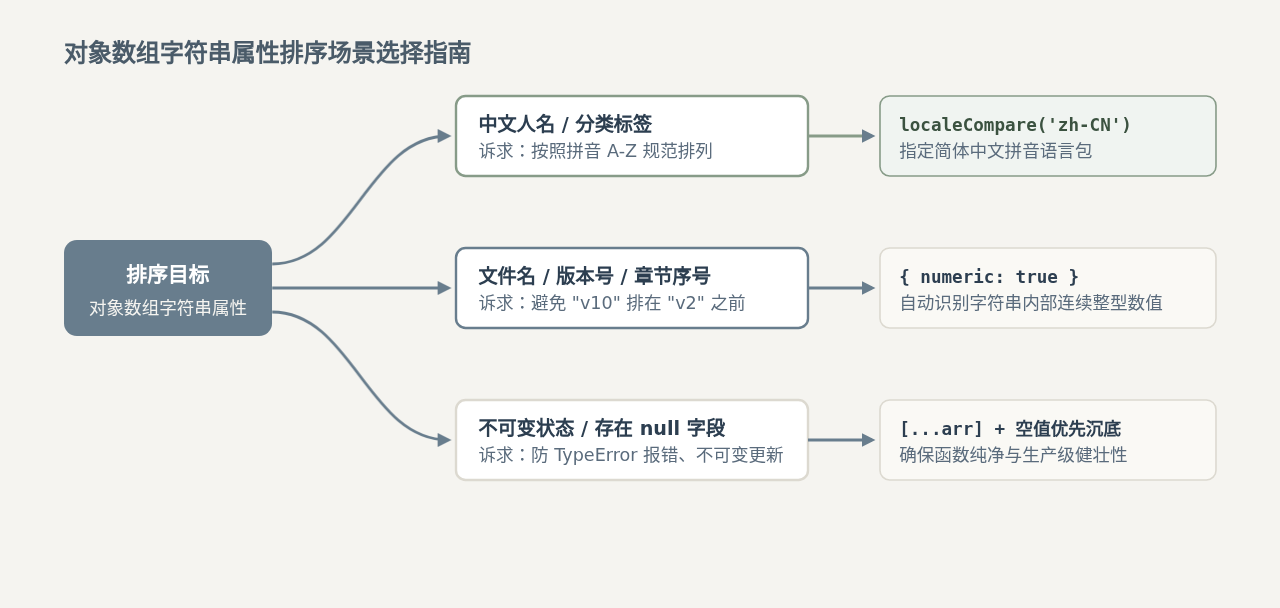
五、总结
在 JavaScript 中对对象数组的字符串属性进行排序,牢记以下三条核心实践:
- 比较器标准写法:调用
array.sort((a, b) => a.prop.localeCompare(b.prop))升序,b.prop.localeCompare(a.prop)降序。 - 拒绝比较符陷阱:避免对非纯大写/小写英文使用
>或<。涉及中文时指定'zh-CN'实现拼音排序;涉及编号文件时开启{ numeric: true }实现自然数感知排序。 - 生产级防御:使用
[...array]或toSorted()保护原数组不被直接篡改,并在比较前拦截null或undefined属性,避免运行时崩溃。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章