
在JavaScript中生成指定范围内的不重复随机数数组,核心在于根据取值范围大小和抽取数量比例,选择Set集合收集、部分Fisher-Yates洗牌算法或Map稀疏映射。本文提供完整的实现代码、原理剖析、性能分析与选型参考。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS生成指定范围的不重复随机数数组
作者:半夏
时间:2026-11-19
浏览:220
文章目录
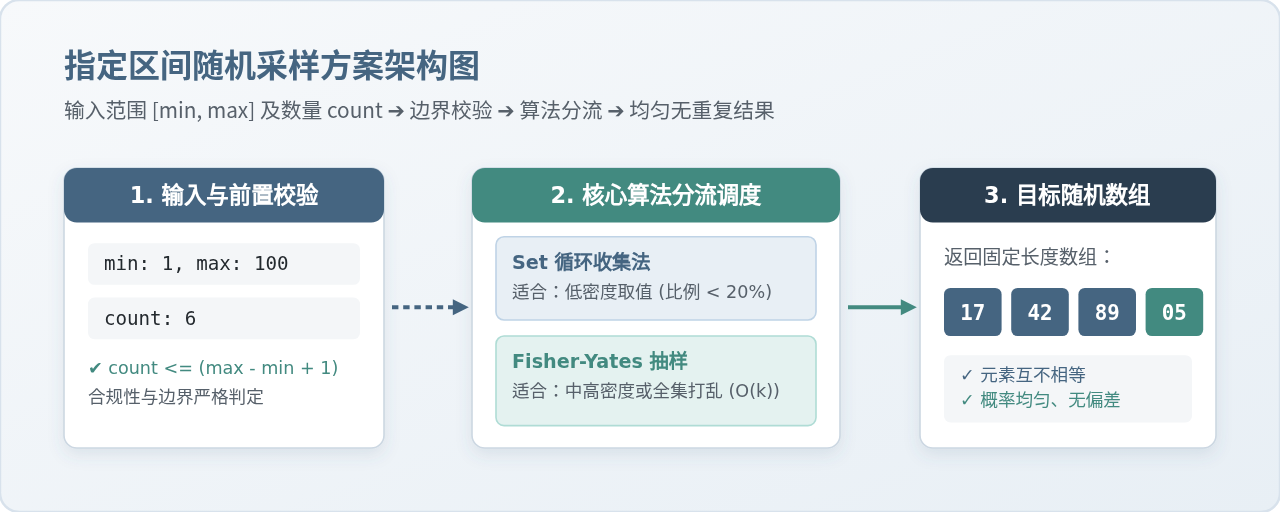
在JavaScript开发中,生成指定区间 [min, max] 内包含 count 个不重复随机整数的数组,核心关键在于根据抽取数量与范围大小的比值选择正确的算法实现:在范围大而抽取数量少时使用 Set 循环收集最为轻便;在抽取数量多或接近全集时,必须采用 Fisher-Yates 部分洗牌算法或 Map 虚拟抽样,以杜绝随机碰撞带来的性能断崖和死循环风险。
一、前置约束与边界规则
在编写任何随机算法前,必须先确立数学约束与参数边界。对于闭区间 [min, max],该区间内包含的整数总个数为:
区间容量 capacity = max - min + 1根据鸽巢原理(抽屉原理),当需求抽取的个数 count 大于 capacity 时,数学上绝不可能生成完全不重复的数组。如果不作校验,程序将陷入无限等待或抛出异常。因此,一个健壮的函数必须在第一步执行严格的参数断言:
min和max必须是合法的整数,且保证min <= max。count必须是非负整数,且满足0 <= count <= (max - min + 1)。- 当
count === 0时,应直接返回空数组[]。
二、方案一:Set 循环去重法(适用于小比例采样)
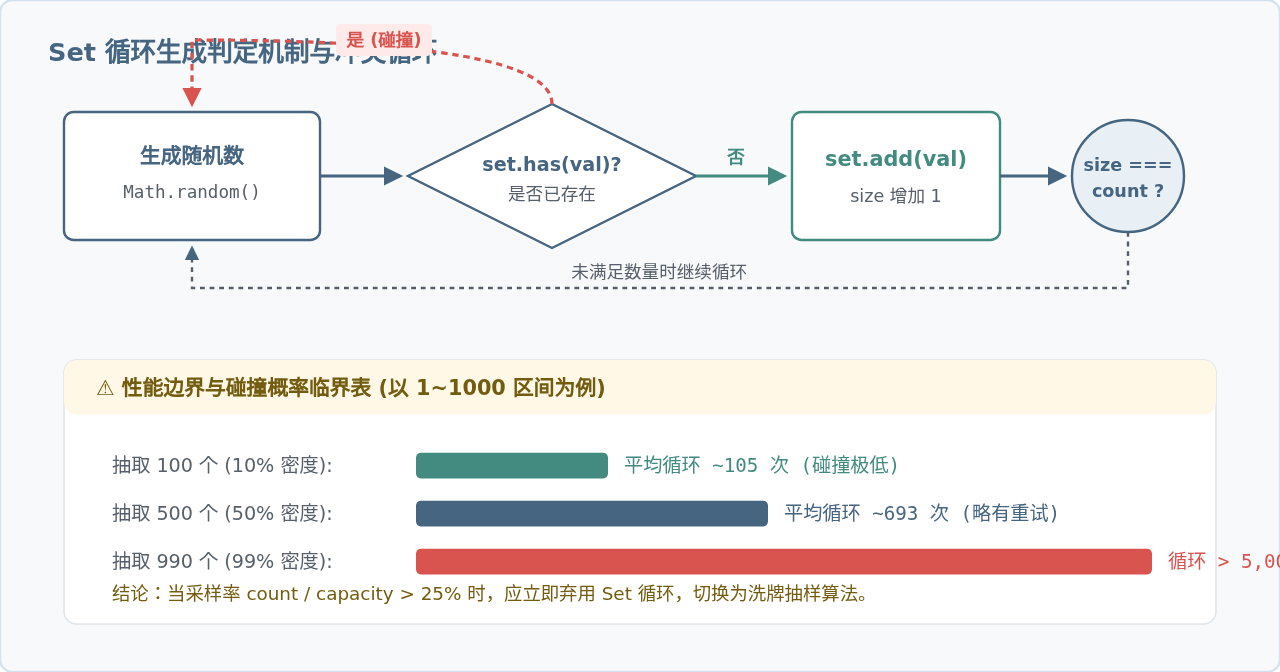
利用 ES6 引入的原生数据结构 Set 具备元素唯一性的特点,每次生成 [min, max] 区间内的随机整数并执行 set.add(),直到集合大小达到目标 count,最后通过 Array.from() 展开为数组。
1. 完整实现代码
/**
 * 使用 Set 集合生成指定区间内不重复随机整数数组
 * @param {number} min 最小值(包含)
 * @param {number} max 最大值(包含)
 * @param {number} count 抽取数量
 * @returns {number[]} 不重复随机整数数组
 */
function getRandomDistinctBySet(min, max, count) {
  // 基础边界校验
  if (!Number.isInteger(min) || !Number.isInteger(max) || !Number.isInteger(count)) {
    throw new TypeError("参数 min, max, count 必须均为整数");
  }
  if (min > max) {
    throw new RangeError("参数 min 不能大于 max");
  }
  const capacity = max - min + 1;
  if (count < 0 || count > capacity) {
    throw new RangeError(`抽取数量 count (${count}) 超出区间容量 (${capacity})`);
  }
  if (count === 0) return [];

  const resultSet = new Set();
  while (resultSet.size < count) {
    // 生成闭区间 [min, max] 内的随机整数
    const randVal = Math.floor(Math.random() * capacity) + min;
    resultSet.add(randVal);
  }

  return Array.from(resultSet);
}

// 运行示例:在 [10, 50] 中抽取 5 个不重复数字
const result = getRandomDistinctBySet(10, 50, 5);
console.log(result); // 示例输出: [ 23, 41, 12, 35, 48 ]
2. 为什么不能在所有场景下使用 Set?
虽然 Set 方法直观易读,但它暗含了“掷骰子碰撞”模型。当需要抽取的数量 count 接近区间总数 capacity 时,未被抽取的数字越来越少。例如在 [1, 100] 中抽取 99 个数,抽取最后几个数字时,生成的新随机数绝大多数都会与已有数字重复被丢弃,循环执行次数将呈现指数级爆炸,甚至引发浏览器页面卡死。
三、方案二:部分 Fisher-Yates 洗牌抽样(中高密度推荐)
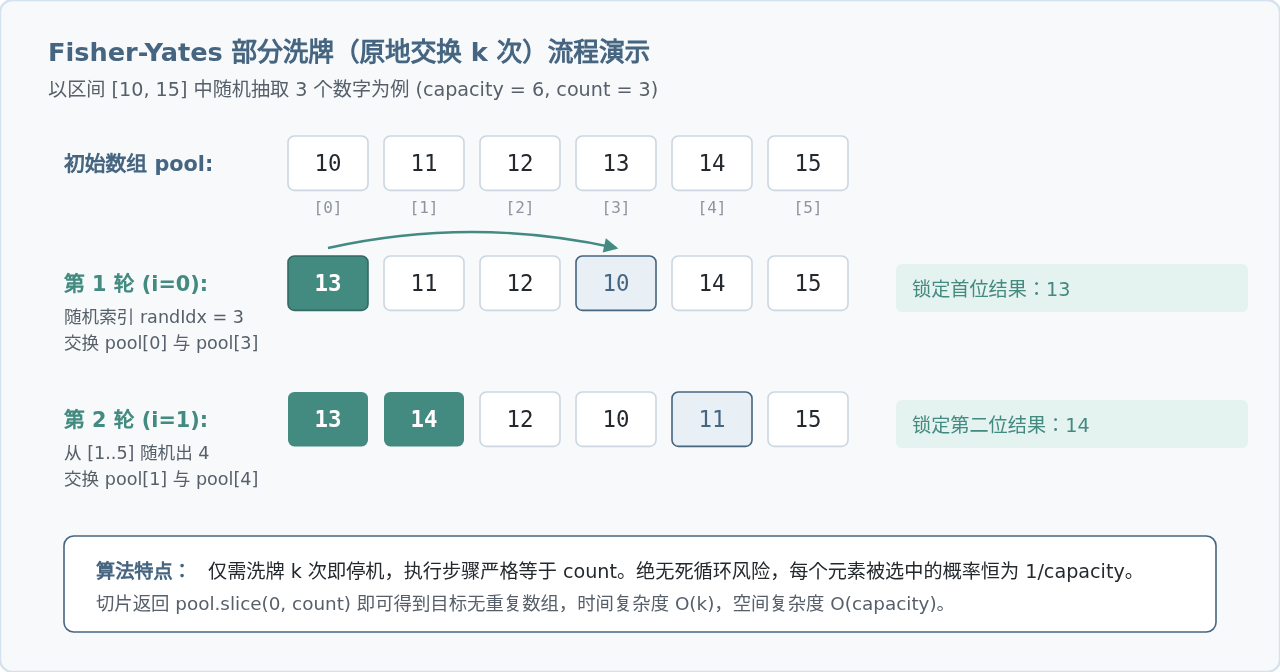
为了解决碰撞问题,数学上最优且均匀的算法是 Fisher-Yates 现代洗牌算法(Knuth Shuffle)。如果我们需要抽取 count 个数,并不需要对整个候选池全部洗牌,只需要进行 前 count 次交换 即可提前退出,时间复杂度是严格确定的 O(count)。
1. 算法执行步骤
- 初始化一个长度为
capacity的候选数组pool,填入[min, max]范围内的所有整数。 - 从索引
i = 0循环到count - 1。 - 在未抽取的区间
[i, capacity - 1]中随机挑选一个索引randIdx。 - 将
pool[i]与pool[randIdx]进行交换。 - 循环结束后,
pool的前count个元素即为均匀无重复的随机结果。
2. 完整实现代码
/**
 * 使用部分 Fisher-Yates 洗牌算法生成不重复随机数数组
 * 适用于中等容量池 (例如 capacity <= 500,000) 且抽取比例较高的场景
 */
function getRandomDistinctByShuffle(min, max, count) {
  if (!Number.isInteger(min) || !Number.isInteger(max) || !Number.isInteger(count)) {
    throw new TypeError("参数必须均为整数");
  }
  if (min > max) {
    throw new RangeError("min 不能大于 max");
  }
  const capacity = max - min + 1;
  if (count < 0 || count > capacity) {
    throw new RangeError(`count (${count}) 超出范围容量 (${capacity})`);
  }
  if (count === 0) return [];

  // 1. 构建候选池数组并预分配空间
  const pool = new Array(capacity);
  for (let i = 0; i < capacity; i++) {
    pool[i] = min + i;
  }

  // 2. 原地部分洗牌:只循环 count 次
  for (let i = 0; i < count; i++) {
    // 在 [i, capacity - 1] 区间内随机选取索引
    const randIdx = Math.floor(Math.random() * (capacity - i)) + i;

    // 交换元素
    const temp = pool[i];
    pool[i] = pool[randIdx];
    pool[randIdx] = temp;
  }

  // 3. 截取前 count 项
  return pool.slice(0, count);
}

// 运行示例:在 [1, 10] 范围全取 10 个不重复数(即全随机打乱)
console.log(getRandomDistinctByShuffle(1, 10, 10));
// 示例输出: [ 7, 2, 9, 1, 5, 8, 3, 10, 4, 6 ]
四、方案三:超大区间的 Map 虚拟稀疏映射算法
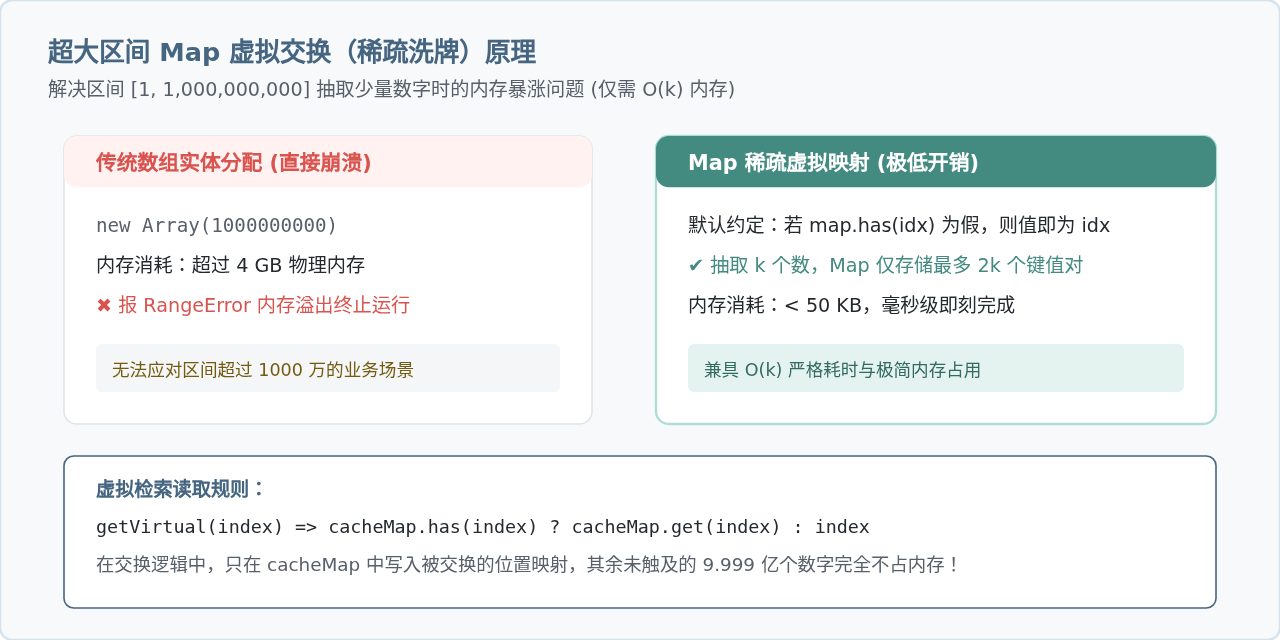
方案二虽然杜绝了碰撞,但它需要先分配一个大小为 capacity 的完整数组。如果用户要求:在 [1, 1,000,000,000](10亿)中抽取 10 个不重复随机数:
- 方案二分配 10 亿长度的数组将直接导致 V8 引擎抛出
RangeError: Invalid array length内存崩溃。 - 而如果用方案一的 Set,虽然内存占用极小,但如果抽取数量较多时依然存在重试开销。
针对“区间范围极大、但抽取数量有限”的高性能场景,业界标准做法是基于哈希表记录交换历史的虚拟洗牌算法:不实际创建大数组,而是在逻辑上认为 pool[i] = i,仅用一个 Map 记录被修改过的索引映射关系。
代码实现:虚拟洗牌通用抽取函数
/**
 * 虚拟洗牌抽取算法:支持超大跨度区间(如 1 到 10 亿)
 * 时间复杂度严格 O(count),空间复杂度仅 O(count)
 */
function getRandomDistinctSparse(min, max, count) {
  if (!Number.isInteger(min) || !Number.isInteger(max) || !Number.isInteger(count)) {
    throw new TypeError("参数必须为整数");
  }
  if (min > max) throw new RangeError("min 不能大于 max");

  const capacity = max - min + 1;
  if (count < 0 || count > capacity) {
    throw new RangeError(`count (${count}) 超过区间容量 (${capacity})`);
  }
  if (count === 0) return [];

  // 哈希表只记录被交换过映射关系的位置
  const cache = new Map();
  const result = [];

  function getVal(index) {
    return cache.has(index) ? cache.get(index) : index;
  }

  for (let i = 0; i < count; i++) {
    // 从剩余可抽范围 [i, capacity - 1] 选一个偏移下标
    const randOffset = Math.floor(Math.random() * (capacity - i)) + i;

    // 获取两端的值(若未被修改则就是自身下标)
    const pickedVal = getVal(randOffset);
    const currentHead = getVal(i);

    // 收集本次被抽中的值(偏移加回 min)
    result.push(pickedVal + min);

    // 更新映射:模拟将当前头元素挪到被抽走的随机位置
    cache.set(randOffset, currentHead);
  }

  return result;
}

// 运行示例:在 [1, 1000000000] (十亿) 中极速抽取 6 个不重复随机数
console.log(getRandomDistinctSparse(1, 1000000000, 6));
// 示例输出: [ 748291032, 1928472, 859302194, 40192841, 992837410, 502918294 ]
五、综合选型对比与决策模型
在实际工程业务中,面对不同的区间跨度和抽取目标数量,应遵循清晰的决策路径,从而在代码整洁性、运行耗时与内存安全之间取得平衡。
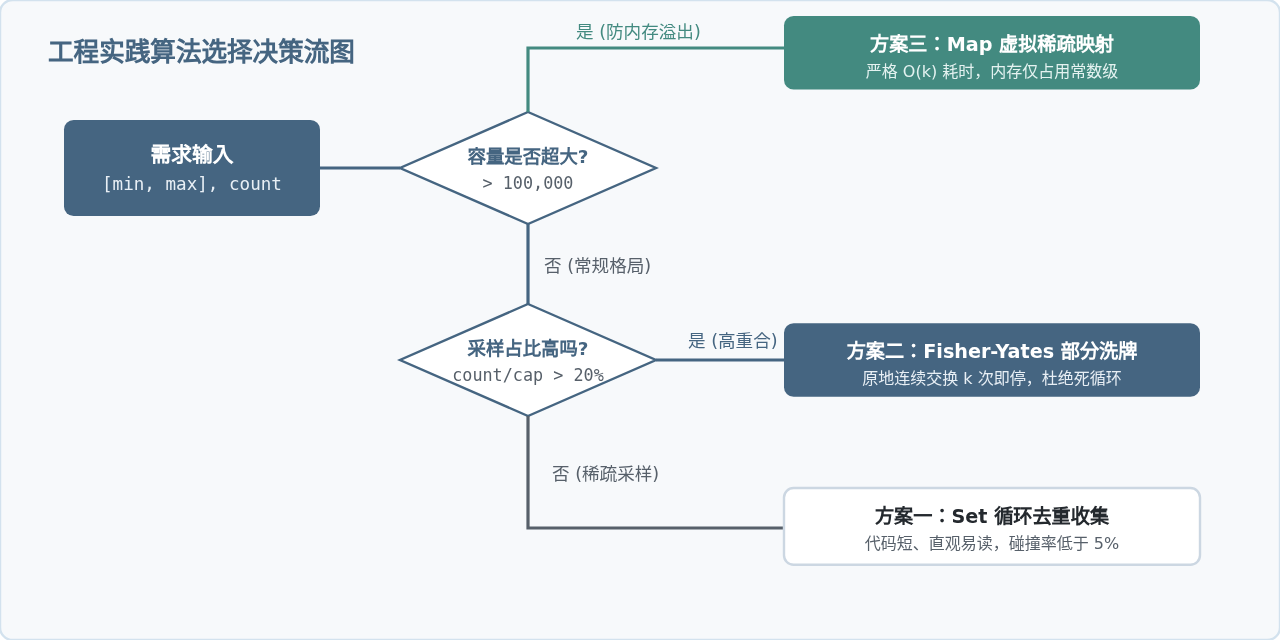
方案综合指标对比表
| 方案名称 | 时间复杂度 | 空间复杂度 | 冲突风险 | 最适用业务场景 |
|---|---|---|---|---|
| Set 循环去重 | 最好 O(k),最坏 O(∞) | O(k) | 极高(当抽样比例高时严重退化) | 区间小、采样个数少(如抽奖、验证码) |
| Fisher-Yates 洗牌 | 严格 O(k) | O(capacity) | 无冲突 | 中等容量池、打乱洗牌、全量或高密度抽样 |
| Map 虚拟稀疏洗牌 | 严格 O(k) | O(k) | 无冲突 | 海量数值范围、ID生成、高并发服务端采样 |
六、生产环境高容错统一实现
在企业级模块中,为了让调用者无需手动判断底层细节,通常会将上述逻辑封装为一个具备自适应分流能力的通用函数:内部根据 capacity 与 count 的比例自动选择最佳策略,既保证极致性能,又杜绝内存溢出风险。
/**
 * 生产级:自动适配生成指定范围的不重复随机数数组
 * @param {number} min 范围下限(整数)
 * @param {number} max 范围上限(整数)
 * @param {number} count 目标不重复数字数量
 * @returns {number[]} 随机整数数组
 */
function generateUniqueRandomNumbers(min, max, count) {
  // 1. 严格参数校验
  if (!Number.isInteger(min) || !Number.isInteger(max) || !Number.isInteger(count)) {
    throw new TypeError("参数 min, max, count 必须均为整数");
  }
  if (min > max) {
    throw new RangeError("min 不能大于 max");
  }
  const capacity = max - min + 1;
  if (count < 0 || count > capacity) {
    throw new RangeError(`请求数量 count (${count}) 超出范围容量 [${min}, ${max}] (${capacity})`);
  }
  if (count === 0) return [];

  // 2. 如果容量超大(> 50,000),使用 Map 稀疏虚拟洗牌,防止数组内存溢出
  if (capacity > 50000) {
    const map = new Map();
    const list = [];
    const getVal = (idx) => (map.has(idx) ? map.get(idx) : idx);

    for (let i = 0; i < count; i++) {
      const rand = Math.floor(Math.random() * (capacity - i)) + i;
      list.push(getVal(rand) + min);
      map.set(rand, getVal(i));
    }
    return list;
  }

  // 3. 如果容量中等且采样率 < 20%,使用 Set(轻量快速,GC 负担小)
  if (count / capacity < 0.2) {
    const set = new Set();
    while (set.size < count) {
      set.add(Math.floor(Math.random() * capacity) + min);
    }
    return Array.from(set);
  }

  // 4. 否则(中等容量且高密度采样),使用标准 Fisher-Yates 部分洗牌
  const pool = new Array(capacity);
  for (let i = 0; i < capacity; i++) {
    pool[i] = min + i;
  }
  for (let i = 0; i < count; i++) {
    const randIdx = Math.floor(Math.random() * (capacity - i)) + i;
    const temp = pool[i];
    pool[i] = pool[randIdx];
    pool[randIdx] = temp;
  }
  return pool.slice(0, count);
}

// 实际调用测试
console.log("低采样率测试:", generateUniqueRandomNumbers(1, 100, 5));
console.log("高采样率测试:", generateUniqueRandomNumbers(1, 10, 8));
console.log("超大区间测试:", generateUniqueRandomNumbers(1000000, 9999999, 4));
实现总结:
生成指定区间不重复随机数数组不是单一函数写到底的问题,而是“根据输入规模做策略适配”。牢记
count <= capacity 前置断言,在小抽取比例时用 Set,高比例时用 Fisher-Yates 洗牌,超大范围时采用 Map 虚拟映射,即可写出兼具可读性、安全性与工业级性能的 JavaScript 代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章