

本文详细讲解如何使用 face-api.js 在纯浏览器端调用摄像头视频流,实时完成人脸检测与 68 点特征关键点标记。包含环境准备、模型加载、Canvas 对齐与完整可执行代码。
face-api.js入门:浏览器端实时人脸检测与关键点标记实现
作者:白露
时间:2026-11-19
浏览:667
文章目录
分类:前端计算机视觉
运行环境:现代浏览器 (Chrome / Edge / Safari / Firefox)
依赖库:face-api.js v0.22.2
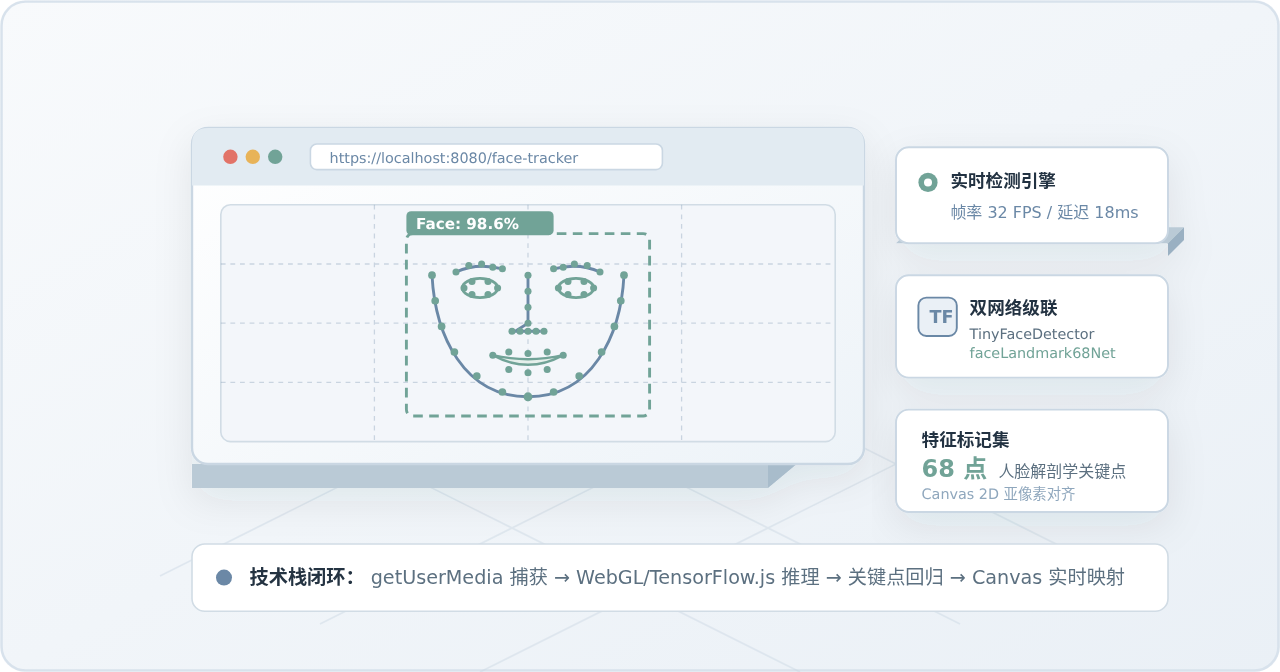
在现代 Web 应用中,利用 face-api.js 可以在纯前端(浏览器沙箱内)直接调用摄像头视频流,实时完成人脸检测(Face Detection)以及 68 个特征关键点标记(Face Landmarks Detection),无需将视频画面传输至后端服务器。本文通过搭建本地环境、加载轻量权重模型(TinyFaceDetector 与 faceLandmark68Net)、捕获摄像头流并结合 <canvas> 图层重叠渲染,完整实现端到端的人脸实时追踪与关键点绘制。
一、核心技术架构与实时数据流转
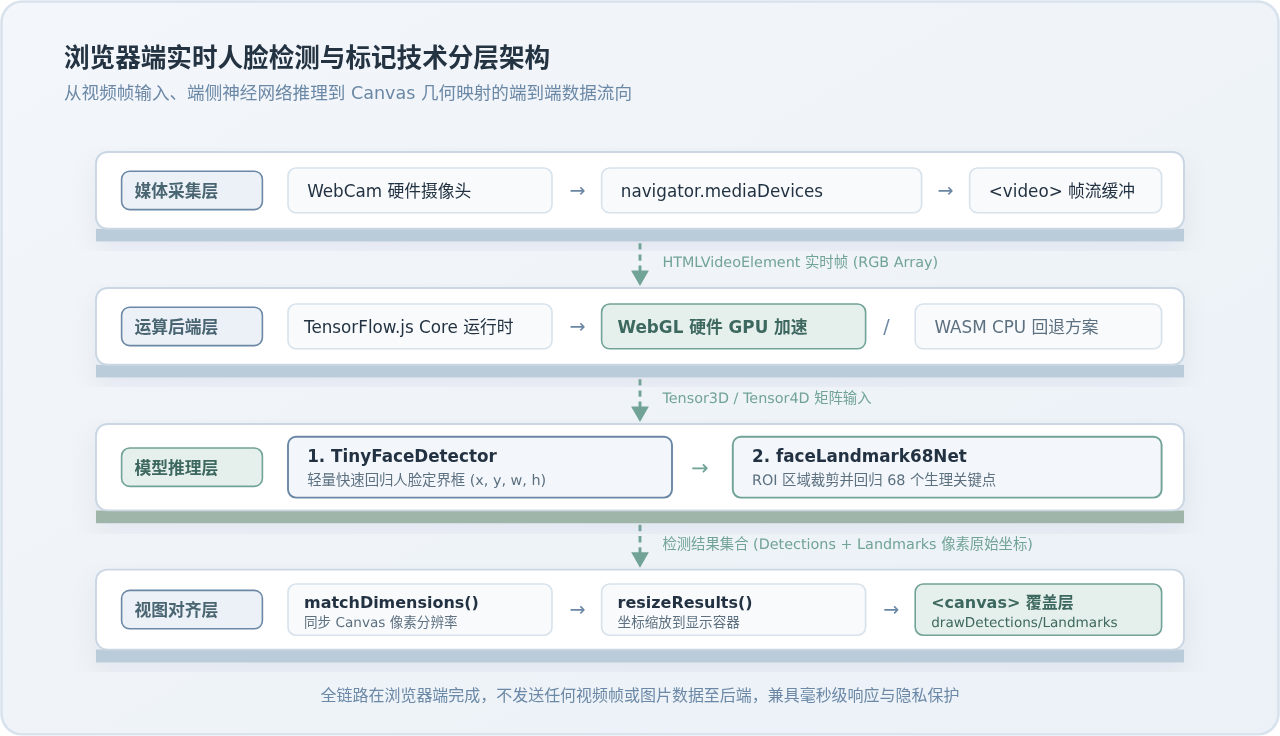
face-api.js 是构建在 TensorFlow.js 之上的轻量级人脸识别封装库。在浏览器中实现低延迟的实时处理,本质上是在主渲染循环中建立一条“视频帧输入 → 张量推断 → 几何缩放 → 画布重绘”的处理闭环。
整个处理链路划分为四个层次:
- 媒体采集层:通过浏览器原生的
navigator.mediaDevices.getUserMedia()API 请求设备摄像头,获取实时媒体流(MediaStream)并绑定到 HTML5 的<video>元素。 - 运算加速层:底层依托 TensorFlow.js 运行时,优先利用 WebGL 着色器直接调用本地 GPU 算力执行张量矩阵运算。在不支持 WebGL 的极端环境下自动回退为 CPU/WASM 计算。
- 模型推理层:采用两阶段级联架构。第一阶段由
TinyFaceDetector快速搜索画面并回归出人脸的外接矩形框(Bounding Box);第二阶段将候选区域裁剪后传入faceLandmark68Net,回归出代表五官几何拓扑的 68 个生理关键点。 - 视图对齐层:模型输出的原始坐标基于输入张量的归一化网格,必须通过几何缩放算法映射到当前页面中真实渲染的
<canvas>像素坐标系中,实现画面与标记的严密重合。
二、开发准备与工程目录规范
在开始编写代码前,必须明确浏览器的安全运行限制:摄像头视频采集 API(getUserMedia)仅允许在安全上下文(HTTPS 或本地 http://localhost)下运行;同时,face-api.js 通过 fetch() 加载模型分片文件,如果直接使用 file:// 协议在本地双击打开 HTML 文件,会因浏览器同源策略(CORS)报错而导致模型加载中断。
1. 依赖引入方式
推荐直接在 HTML 中引入构建好的静态脚本,或者通过官方发布的静态 CDN 加载:
<!-- 引入 face-api.js 核心库 -->
<script src="https://cdn.jsdelivr.net/npm/face-api.js@0.22.2/dist/face-api.min.js"></script>
2. 模型权重文件准备
实时视频流对帧率要求较高,为了兼顾高流畅度与低显存占用,本方案选用以下两组预训练权重文件:
tiny_face_detector_model-weights_manifest.json及其分片文件(人脸检测模型,体积仅约 190KB)face_landmark_68_model-weights_manifest.json及其分片文件(68 点特征标记模型,体积约 350KB)
将上述模型文件统一放置在工程根目录的 models/ 文件夹下。项目标准目录结构如下:
project/
├── index.html        # 页面结构与画布布局
├── style.css         # 绝对对齐与容器样式
├── script.js         # 模型加载、摄像头调用与帧循环
└── models/           # 静态神经网络权重与清单
    ├── tiny_face_detector_model-weights_manifest.json
    ├── tiny_face_detector_model-shard1
    ├── face_landmark_68_model-weights_manifest.json
    └── face_landmark_68_model-shard1
本地测试提示:可在工程根目录下执行
npx serve 或 Python 内置命令 python3 -m http.server 8080 启动一个本地静态服务,并在浏览器中访问 http://localhost:8080。
三、核心实施步骤与代码实现
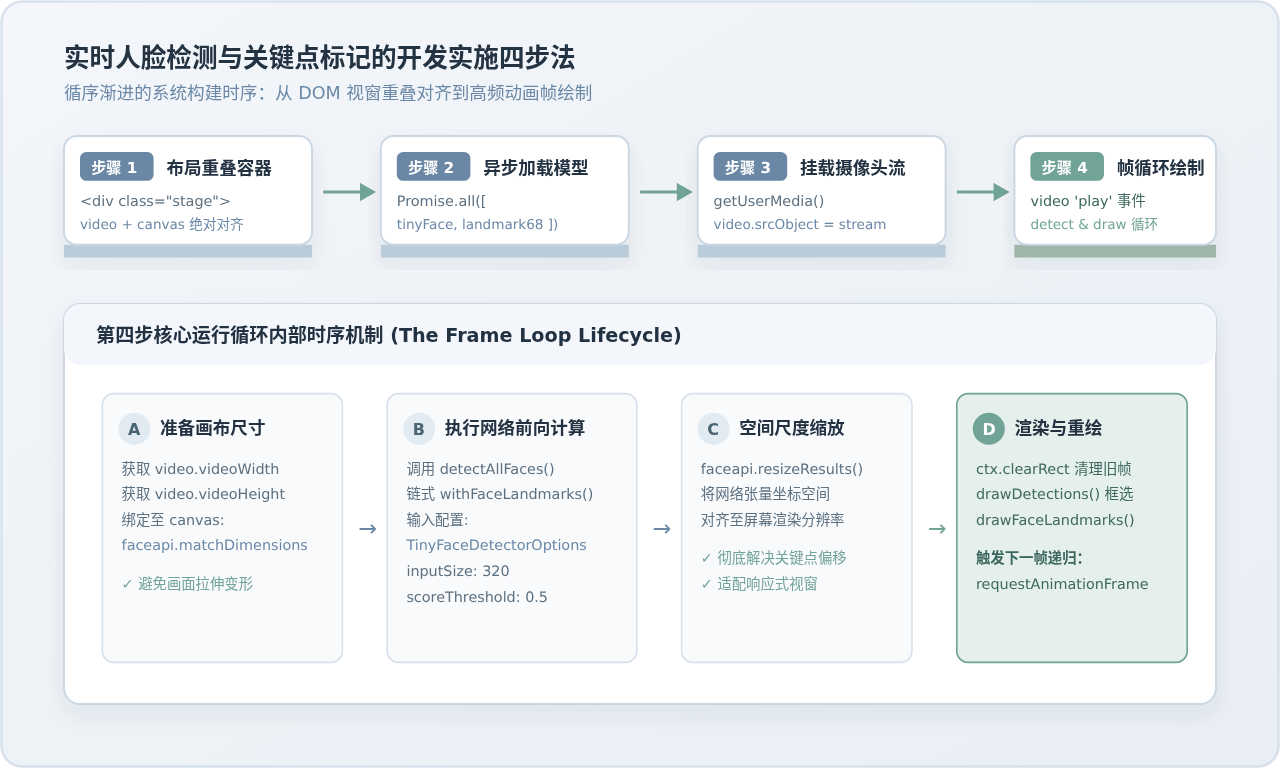
实时检测的完整实现遵循严密的四步实施流程:DOM 容器层叠布局、预加载模型、接入摄像头流、构建帧侦测循环。
第一步:创建视窗重叠容器 (index.html)
在页面中放置一个容器,内部包裹 <video> 和 <canvas> 两个元素。关键在于通过 CSS 使画布精准叠放在视频正上方:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>实时人脸检测与关键点追踪</title>
  <link rel="stylesheet" href="style.css">
  <script defer src="https://cdn.jsdelivr.net/npm/face-api.js@0.22.2/dist/face-api.min.js"></script>
  <script defer src="script.js"></script>
</head>
<body>
  <div class="stage-container">
    <video id="webcam" autoplay muted playsinline></video>
    <canvas id="overlay"></canvas>
  </div>
</body>
</html>
第二步:定义严密重合的层叠样式 (style.css)
为了防止关键点标记与人物画面产生错位,必须将父容器设为相对定位,并将画布设为绝对定位覆盖在视频表面:
body {
  margin: 0;
  display: flex;
  justify-content: center;
  align-items: center;
  min-height: 100vh;
  background-color: #1A2530;
}

.stage-container {
  position: relative;
  display: inline-block;
  border-radius: 8px;
  overflow: hidden;
  box-shadow: 0 8px 30px rgba(0, 0, 0, 0.4);
}

/* 视频与画布均设为块级显示 */
#webcam {
  display: block;
  max-width: 100vw;
  max-height: 100vh;
}

/* 画布绝对定位,初始坐标(0, 0)严密覆盖视频 */
#overlay {
  position: absolute;
  top: 0;
  left: 0;
  pointer-events: none; /* 穿透鼠标事件 */
}
第三步与第四步:业务逻辑与帧渲染循环 (script.js)
以下是完整的业务控制脚本。代码首先并行加载所需的模型权重,接着唤起摄像头;当视频流准备完毕(触发 play 事件)后,初始化画布尺寸并启动逐帧循环:
const video = document.getElementById('webcam');
const canvas = document.getElementById('overlay');

// 1. 异步并行加载网络权重
async function loadModels() {
  const MODEL_URI = '/models';
  await Promise.all([
    faceapi.nets.tinyFaceDetector.loadFromUri(MODEL_URI),
    faceapi.nets.faceLandmark68Net.loadFromUri(MODEL_URI)
  ]);
  console.log('神经网络模型加载完成');
}

// 2. 唤起本地摄像头
async function startWebcam() {
  try {
    const stream = await navigator.mediaDevices.getUserMedia({
      video: {
        width: { ideal: 1280 },
        height: { ideal: 720 },
        facingMode: 'user'
      },
      audio: false
    });
    video.srcObject = stream;
  } catch (err) {
    console.error('无法访问摄像头设备:', err);
  }
}

// 3. 监听视频开始播放,启动检测主循环
video.addEventListener('play', () => {
  // 获取视频实际显示分辨率
  const displaySize = { width: video.videoWidth, height: video.videoHeight };
  // 核心:同步 Canvas 的内部物理分辨率与视频真实尺寸
  faceapi.matchDimensions(canvas, displaySize);

  // 配置 TinyFaceDetector 检测参数
  // inputSize: 输入矩阵分辨率,必须是 32 的倍数(推荐 160, 224, 320, 416, 512)
  // scoreThreshold: 置信度过滤阈值,低于此值的结果将被丢弃
  const detectorOptions = new faceapi.TinyFaceDetectorOptions({
    inputSize: 320,
    scoreThreshold: 0.5
  });

  let isDetecting = false;

  async function onPlayFrame() {
    if (video.paused || video.ended) return;

    if (!isDetecting) {
      isDetecting = true;
      try {
        // 执行联合前向推断:检测所有人脸并提取关键点
        const detections = await faceapi
          .detectAllFaces(video, detectorOptions)
          .withFaceLandmarks();

        // 核心:将基于模型空间的点位坐标换算至 Canvas 显示空间
        const resizedDetections = faceapi.resizeResults(detections, displaySize);

        // 清理上一帧绘制的笔迹
        const ctx = canvas.getContext('2d');
        ctx.clearRect(0, 0, canvas.width, canvas.height);

        // 绘制人脸边界框
        faceapi.draw.drawDetections(canvas, resizedDetections);
        // 绘制 68 个特征关键点及拓扑连线
        faceapi.draw.drawFaceLandmarks(canvas, resizedDetections);
      } catch (e) {
        console.error('检测帧异常:', e);
      } finally {
        isDetecting = false;
      }
    }

    // 请求下一帧调度
    requestAnimationFrame(onPlayFrame);
  }

  // 触发第一帧渲染
  requestAnimationFrame(onPlayFrame);
});

// 启动入口
(async function init() {
  await loadModels();
  await startWebcam();
})();
四、深入理解:68 点人脸特征点拓扑与坐标空间转换
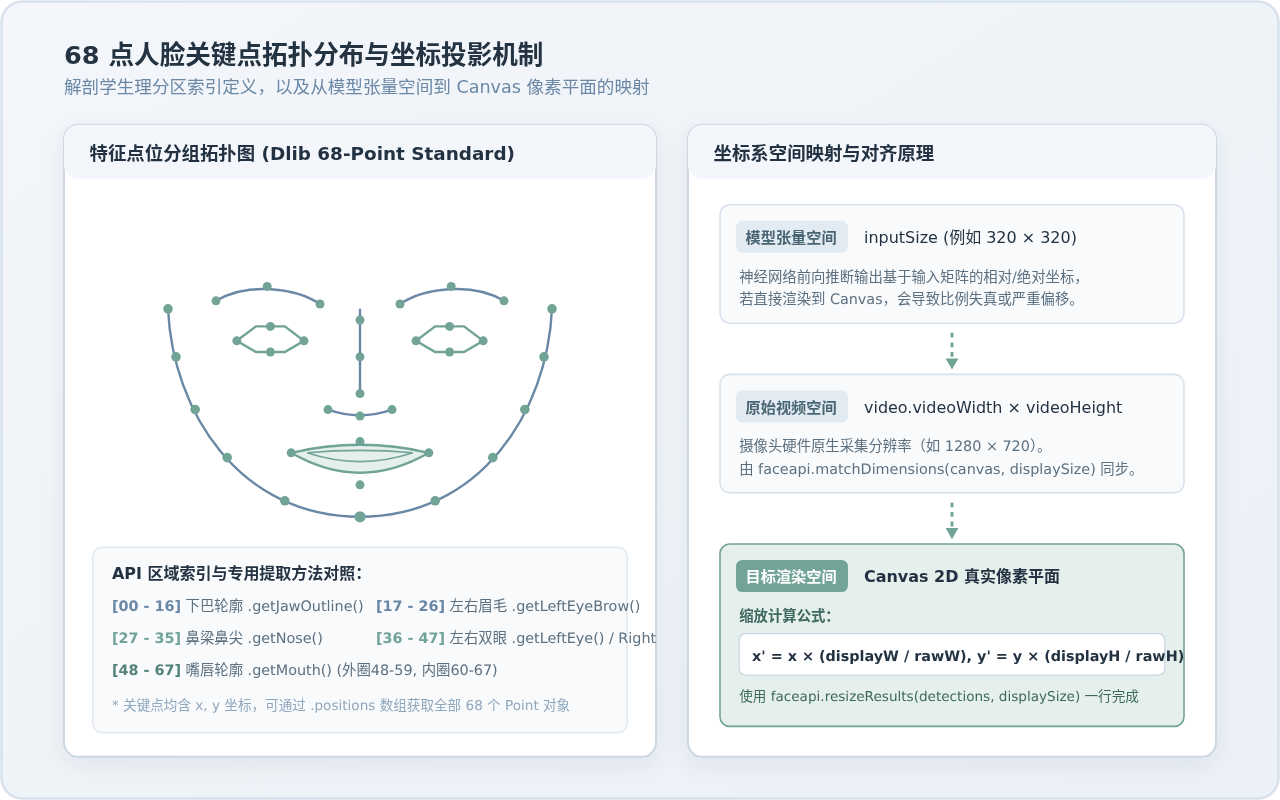
在人脸检测与生物特征分析中,face-api.js 采用业界标准的 Dlib 68 点特征点位定义。理解这些点位的索引编排与空间投影,对于后续实现虚拟试妆、眨眼检测、人脸姿态估计等二次开发至关重要。
1. 特征点生理分布与 API 提取
68 个关键点按从下至上、从外至内的顺序进行连续标号,并在 FaceLandmarks68 对象中提供了专用的分区获取方法:
| 点位索引范围 | 生理结构区域 | 专属 API 方法 | 典型二次开发用途 |
|---|---|---|---|
| 00 ~ 16 (共17点) | 下颌与下巴轮廓 (Jaw Outline) | landmarks.getJawOutline() |
瘦脸算法、下颌线贴合、脸型分类 |
| 17 ~ 21 (共5点) | 左侧眉毛 (Left Eyebrow) | landmarks.getLeftEyeBrow() |
挑眉动作捕捉、虚拟画眉 |
| 22 ~ 26 (共5点) | 右侧眉毛 (Right Eyebrow) | landmarks.getRightEyeBrow() |
表情丰富度检测 |
| 27 ~ 35 (共9点) | 鼻梁骨 (27-30) 与鼻底 (31-35) | landmarks.getNose() |
头部三维偏航角与俯仰角估计、眼镜贴纸 |
| 36 ~ 41 (共6点) | 左眼多边形 (Left Eye) | landmarks.getLeftEye() |
EAR (眼睛长宽比) 眨眼与疲劳检测 |
| 42 ~ 47 (共6点) | 右眼多边形 (Right Eye) | landmarks.getRightEye() |
瞳孔中心定位、注视方向估计 |
| 48 ~ 67 (共20点) | 嘴唇外圈 (48-59) 与内圈 (60-67) | landmarks.getMouth() |
张嘴检测、虚拟口红唇彩上色、微笑检测 |
2. 为什么必须调用 matchDimensions 与 resizeResults?
在开发过程中,许多初学者经常遇到“人脸移动时,绘制的框和点严重偏移或缩小在左上角”的问题。这是由于浏览器中存在三种不同的度量尺度:
- 模型张量空间:神经网络输入通常被降采样为固定尺寸(例如 320×320),模型输出的坐标基于该离散网格。
- 视频原生分辨率:摄像头采集的原始像素分辨率由硬件决定(例如 1280×720),存储在
video.videoWidth和video.videoHeight中。 - DOM 显示像素:CSS 样式可能将视频容器缩放为响应式宽度(例如 640×360)。
faceapi.matchDimensions(canvas, displaySize) 用于将 Canvas 画布的内部绘图缓冲区分辨率(canvas.width / canvas.height)强制与目标显示尺寸同步;而 faceapi.resizeResults(detections, displaySize) 则负责遍历所有的检测框与关键点,基于以下线性比例矩阵自动完成缩放映射:
// 坐标空间换算核心逻辑演示(resizeResults 内部数学原理)
const scaleX = displaySize.width / originalInputWidth;
const scaleY = displaySize.height / originalInputHeight;

const mappedPoints = landmarks.positions.map(pt => ({
  x: pt.x * scaleX,
  y: pt.y * scaleY
}));
五、常见问题排查与运行性能调优
在实际工程部署与多终端适配中,帧率下降与异常报错往往集中在资源分发、硬件加速与异步阻塞三个环节。
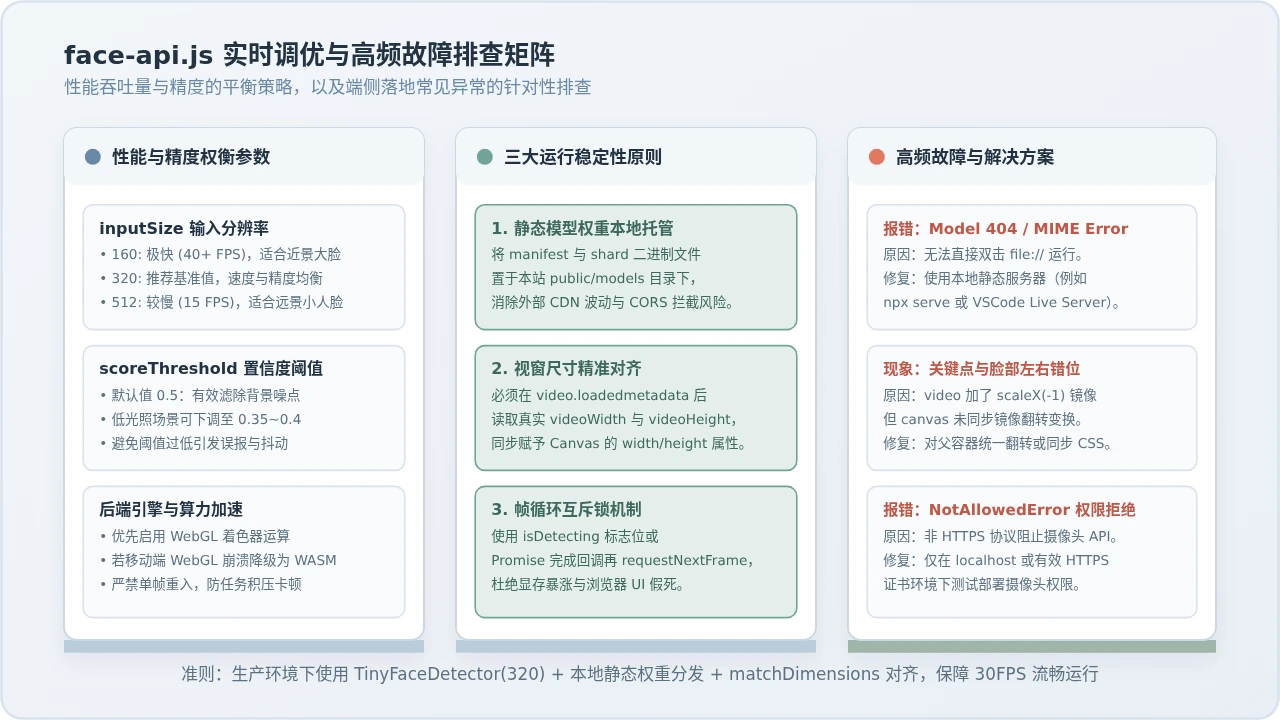
1. 高频异常表现与排查
- 报错:404 Not Found 或 Unexpected token < in JSON:表明模型 manifest 文件未能正确下载。请检查静态服务器路由配置,确保以绝对路径(如
/models)访问,且服务环境未对.json和无后缀分片文件施加阻断。 - 报错:NotAllowedError: Permission denied:用户在浏览器弹窗中拒绝了摄像头权限,或者当前运行环境未处于安全上下文(非 HTTPS / 非 localhost)。
- 现象:人脸向左移动,画面上的标记向右移动:如果为了符合用户镜面直觉在 CSS 中对
video添加了镜像翻转(transform: scaleX(-1);),必须同时对挂载在同一容器内的canvas应用相同的翻转样式,或者对包裹它们的父容器统一施加镜像翻转。
2. 性能提升关键优化项
- 调整 inputSize 参数:
TinyFaceDetectorOptions中的inputSize对推理耗时具有决定性影响。在移动端或性能较弱的核显设备上,可将inputSize从默认的 416 下调至 224 或 320,推理耗时可从 45ms 降至 16ms 左右,大幅提升画面流畅度。 - 采用非阻塞单帧互斥锁:神经网络推理是异步操作,由于各帧计算耗时存在波动,切忌在
setInterval中无脑触发推断。本文示例中通过isDetecting锁与requestAnimationFrame配合,确保上一帧计算完全结束后才处理下一帧,避免显存积压与页面假死。
六、总结与开发实践清单
基于 face-api.js 在浏览器端实现实时人脸检测与 68 点特征标记,核心在于利用轻量网络(TinyFaceDetector + faceLandmark68Net)降低端侧算力负担,同时依靠规范的 Canvas 绝对对齐与坐标缩放(matchDimensions + resizeResults)实现亚像素级的视觉重合。开发者在实施时,只需牢记以下要点:
- 始终在本地静态服务器或 HTTPS 环境下调试,确保摄像头授权畅通;
- 静态模型权重本地化部署,杜绝跨域网络加载延迟;
- 在视频播放事件触发后动态提取宽高,保障画布绘制像素与视频画面绝对一致;
- 利用 68 点分区语义方法,针对不同业务场景进行精准的特征数据提取与二次绘制。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章