

本文对比了Stable Diffusion 1.5与SDXL在提示词编写上的核心差异,涵盖自然语言支持度、长文本处理机制及特定前端语法(如权重和BREAK)的适用性,帮助用户根据不同模型特性优化提示词策略。
SD1.5与SDXL模型在Stable Diffusion提示词编写上的主要区别
作者:模型喵
时间:2026-11-07
浏览:261
文章目录
Stable Diffusion 1.5(以下简称 SD 1.5)与 SDXL 在提示词构建上存在共性:通常先定义画面主体,随后补充动作状态、环境背景及艺术风格。然而,两者在文本编码器架构、训练数据偏好以及所依赖的 WebUI 或工作流处理逻辑上存在显著差异,这些才是用户需要重点关注的区别所在。
这两代模型均具备处理自然语言的能力,也能有效识别简短的标签式描述。SDXL 引入了双文本编码器机制,其文本条件结构与 SD 1.5 有所不同;但这并不意味着它仅适用于长句,也不代表提示词越长生成效果越好。下文将针对实际编写提示词时最常遇到的场景,逐项进行对比分析。
1. 先把主体、动作和场景关系写清楚
使用逗号分隔关键词是 Stable Diffusion 中常见的提示词形式。例如 red bicycle, street, rain, night, neon 虽能罗列若干画面元素,却未明确自行车、街道与霓虹灯之间的空间关系。将其调整为“雨夜的街道上,一辆红色自行车停在霓虹灯旁”,能更清晰地界定主体、状态与环境,从而提升生成的准确性。
这种对语义关系的强调并非 SDXL 独有的“自然语言模式”。无论是 SD 1.5 还是 SDXL,都会将文本转化为模型可理解的条件信息,而词语能否精准映射到画面,还取决于模型检查点、微调数据集及编码方式。面对复杂构图时,用简练短句明确“谁在做什么”及“物体位置关系”,通常比堆砌近义词更易于控制和调整。此外,每次仅修改一个要素,也有助于定位变化来源。
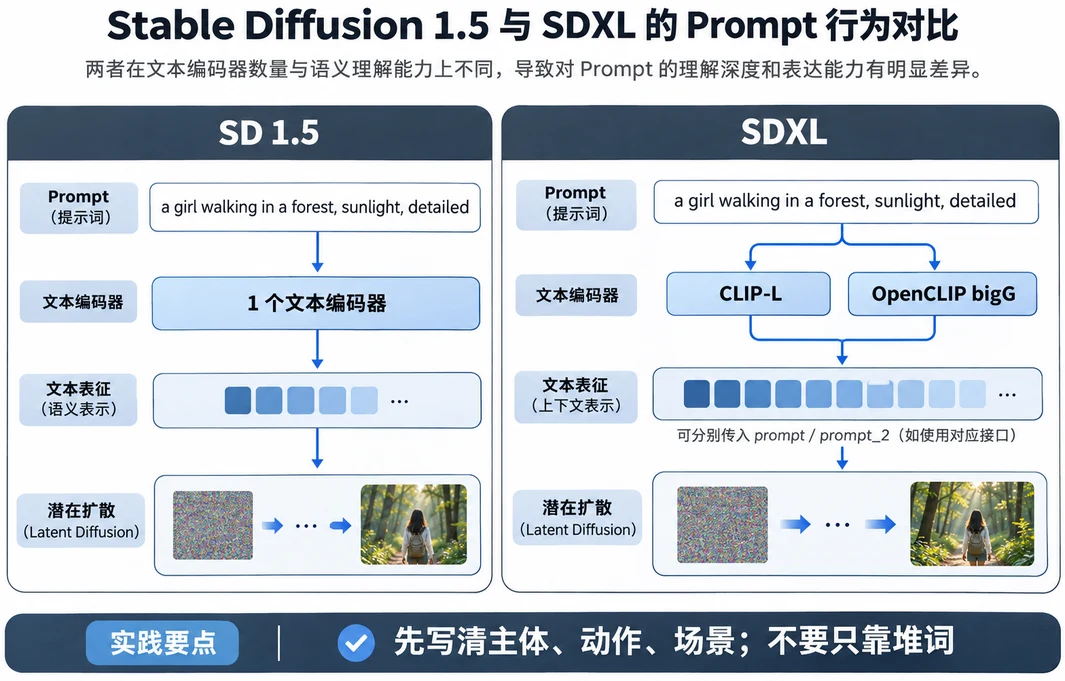
两代模型的文本编码结构不同。
2. 长提示词不等于模型能无限理解
当提示词长度增加时,其效果会受到文本编码器输入限制及前端处理方式的影响。不能简单地将 SD 1.5 与 SDXL 的编码器差异概括为“前者仅支持短提示词,后者能完整理解长文章”。部分 WebUI 会将长文本拆分为多个片段进行编码,而某些工作流则采用自定义的截断、拼接或权重分配策略,具体表现需结合所用工具分析。
因此,在处理较长提示词时,应首先确认当前前端如何显示或处理文本长度,并将核心的主体、属性及关系描述置于前列。同时,需删除冗余形容词,并检查否定提示词、嵌入向量或扩展内容是否占用了额外令牌。只有当新增文字提供了实质性新信息时才有意义,单纯增加字数并不会自动带来更精准的图像生成。
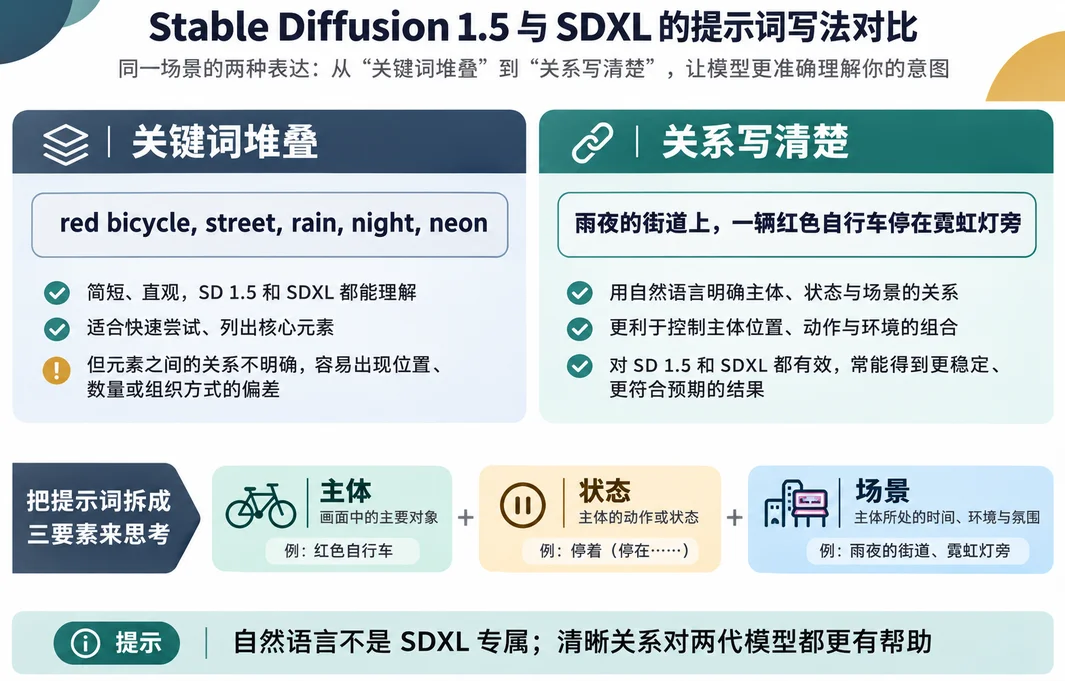
把主体、状态和场景关系写清楚。
3. 括号、权重和 BREAK 由界面决定
许多用户熟悉 (主体:1.2) 这类加权语法,以及使用 BREAK 分隔提示词片段的方式。需要注意的是,这些是特定前端提供的功能语法,而非模型原生标准。以 AUTOMATIC1111 WebUI 为例,其文档详细说明了括号强调、方括号减弱、显式权重设置及 BREAK 等用法。这些规则并不直接由 SD 1.5 或 SDXL 模型本身规定,而是依赖于前端解析器。
在迁移提示词时,务必先确认当前界面或节点是否支持上述语法;若不支持,括号和冒号可能仅被视为普通文本进行编码,导致效果偏差。此外,Diffusers 等接口允许为 SDXL 的两个编码器分别传入 prompt 与 prompt_2,但是否需要这样做取决于具体管线配置。对于普通用户而言,无需为了“充分利用双编码器”而重复编写提示词,优先确保主提示词对画面的完整描述即可。
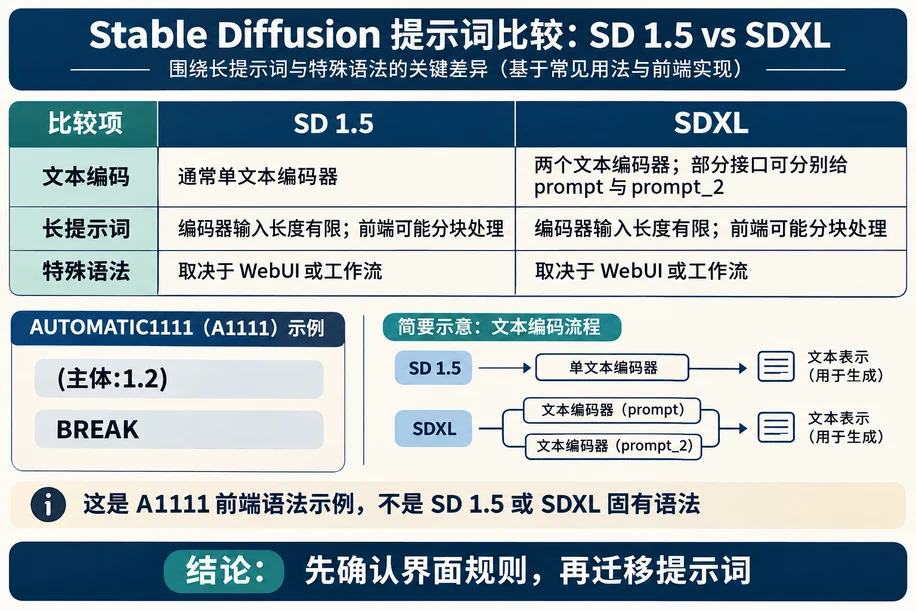
提示词语法取决于所用界面。
在实际操作中,建议保留一份通用的主体、动作及场景描述模板,再根据目标模型的特性调整具体词汇和前端语法。在对比 SD 1.5 与 SDXL 的生成效果时,还应固定采样器、步数、图像尺寸等其他参数,以排除干扰因素,确保观察到的差异确实源于提示词本身而非其他设置。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章