

深入解析前端JavaScript处理GBK及非UTF-8字符串编码的机制与实践方案。详解TextDecoder原生解码、FileReader文件读取、网络流式响应处理、编码输出与Excel导出BOM防乱码技巧。
JS前端怎么处理GBK等非UTF-8字符串编码
作者:资源驿站
时间:2026-11-19
浏览:129
文章目录
在 JavaScript 引擎中,所有的内存字符串本质上都是 UTF-16 编码序列,因此前端并不存在所谓的“GBK 字符串变量”。在前端处理 GBK 等非 UTF-8 编码,核心就是处理底层二进制字节流(ArrayBuffer / Blob)与 JavaScript 内存字符串之间的映射转换。现代浏览器原生提供了强大的
TextDecoder('gbk') API 和 FileReader,可以在不依赖任何第三方库的情况下秒级解码 GBK 数据;而在需要向外输出或导出 GBK 字节时,由于标准 TextEncoder 仅支持 UTF-8,开发者可以通过添加 UTF-8 BOM 标记(针对 Excel 场景)或引入轻量纯 JS 映射库解决。
一、底层原理:为什么前端会出现 GBK 乱码?
要彻底解决非 UTF-8 编码带来的乱码问题,首先要认清 JavaScript 内部字符串的存储机制。在 V8 或 JavaScriptCore 等现代引擎中,字符串由 UTF-16 代码单元(Code Units)构成。无论是 ASCII 字符还是中文汉字,进入 JS 变量后都以 Unicode 码点存在。
乱码产生的根本原因在于:外部输入的是按 GBK 规范排列的字节,但宿主环境(如 fetch 的 response.text() 或默认的文本解析器)却强制用 UTF-8 规则去解释这些字节。
例如,中文字符“你”在 GBK 中被编码为双字节 [0xC4, 0xE3],而在 UTF-8 中则被编码为三字节 [0xE4, 0xBD, 0xA0]。当以 UTF-8 规则读取 [0xC4, 0xE3] 时,因为不符合 UTF-8 字节序前缀标记,解析器便判定其为非法序列,只能用替代码点 U+FFFD(即显示的黑色菱形问号“”)呈现,从而产生乱码。
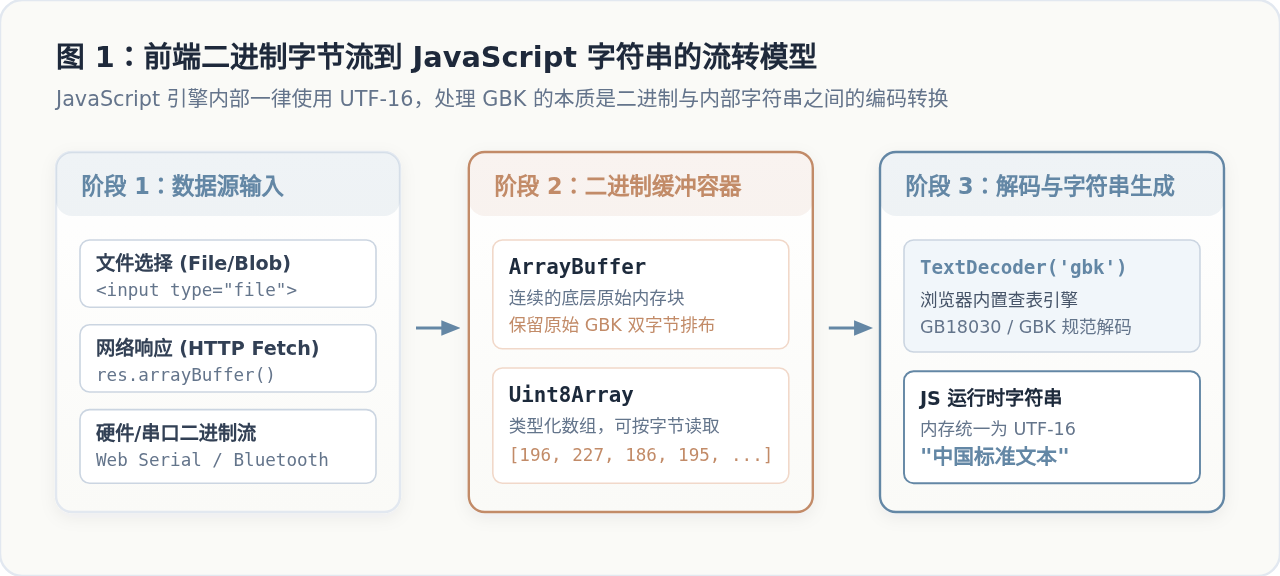
从上图可以看到,处理 GBK 的唯一可靠路径是:在将数据交给 JavaScript 解析为字符之前,先截获其底层的二进制对象(如 ArrayBuffer 或 Uint8Array),再通过指定了正确字符集的解码器映射为 Unicode 字符串。
二、方案一:读取本地 GBK 编码文件
在管理系统和旧版业务系统中,用户上传的 TXT 或 CSV 文件经常是 Windows 平台默认的 ANSI / GBK 格式。如果直接使用常规的 reader.readAsText(file),由于浏览器默认采用 UTF-8 解释,就会直接呈现满屏乱码。
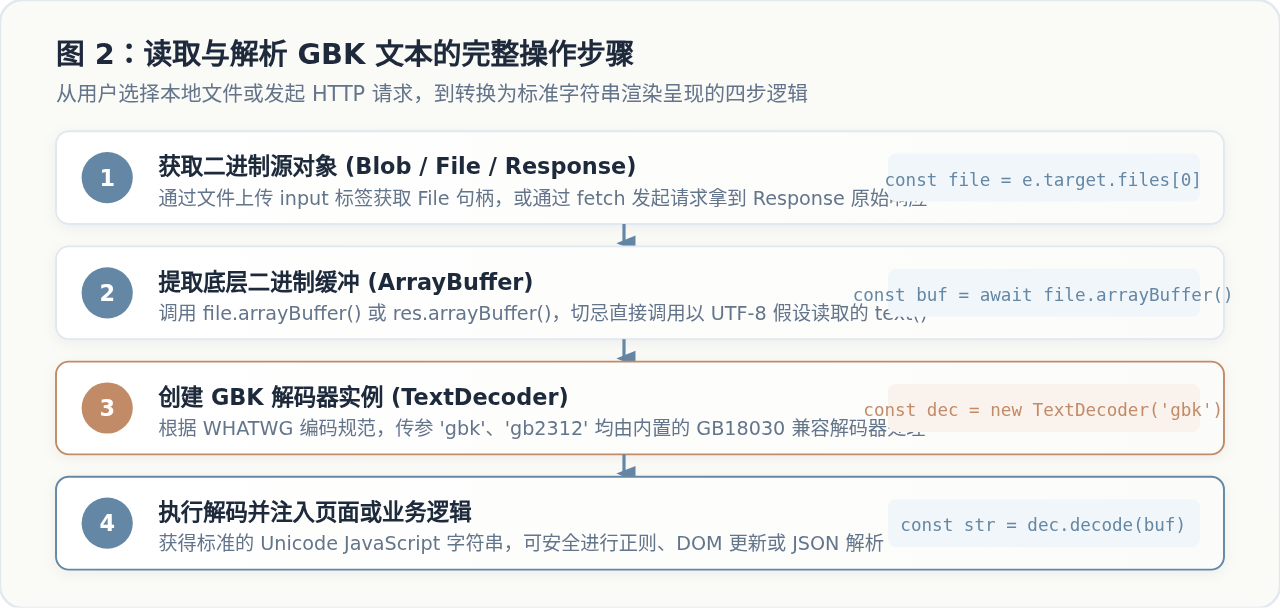
1. 现代化方案:Blob.arrayBuffer() 配合 TextDecoder(推荐)
现代浏览器标准为 Blob 与 File 对象提供了基于 Promise 的 arrayBuffer() 方法。配合原生 TextDecoder,代码逻辑极其紧凑,支持 async/await:
/**
 * 将 GBK 编码的 File 或 Blob 对象解析为普通 JavaScript 字符串
 * @param {File | Blob} file - 上传的文件对象
 * @returns {Promise<string>} 解码后的正常文本
 */
async function readGbkFile(file) {
  // 1. 获取文件的原始字节数据 (ArrayBuffer)
  const buffer = await file.arrayBuffer();

  // 2. 实例化原生 TextDecoder,明确指定为 'gbk'
  // 根据 WHATWG 标准规范,'gbk' 和 'gb2312' 都会映射到底层的 GB18030 超集解码器
  const decoder = new TextDecoder('gbk');

  // 3. 将字节缓冲区解码为字符串
  const text = decoder.decode(buffer);
  return text;
}

// 实际使用示例:绑定至 input[type=file]
const fileInput = document.querySelector('#file-upload');
fileInput.addEventListener('change', async (event) => {
  const file = event.target.files[0];
  if (!file) return;

  try {
    const content = await readGbkFile(file);
    console.log('解码成功的正文内容:', content);
    document.querySelector('#output-preview').textContent = content;
  } catch (error) {
    console.error('文件解码异常:', error);
  }
});
2. 传统兼容方案:FileReader.readAsText
如果项目需要兼容较老版本的浏览器或旧版 Web Worker,可以使用成熟的 FileReader API。其 readAsText 方法原生接收第二个参数 encoding:
function readGbkFileLegacy(file) {
  return new Promise((resolve, reject) => {
    const reader = new FileReader();

    reader.onload = () => {
      // reader.result 即为解码后的字符串
      resolve(reader.result);
    };

    reader.onerror = () => {
      reject(reader.error);
    };

    // 第二个参数显式传入 'gbk'
    reader.readAsText(file, 'gbk');
  });
}
提示:在 WHATWG 编码规范中,
'gbk'、'gb2312'、'chinese' 均作为别名(Aliases)被严格归属到 gb18030 解码算法中。因此在现代浏览器里无论传 'gbk' 还是 'gb18030',都能完美向下兼容 GB2312 中的所有简体汉字以及 GBK 扩充字集。
三、方案二:网络请求 GBK 接口与大文件流式解码
在对接某些遗留服务端系统或第三方开放平台时,返回的响应内容可能是 GBK 编码。如果直接调用 fetch 的 response.text(),浏览器会优先遵循 HTTP 头部的 Content-Type: text/html; charset=gbk。但如果服务端遗漏了 charset 声明,response.text() 就会静默按 UTF-8 解码导致乱码。
1. 通用 HTTP 请求解码
最稳妥的方法是统一提取原始的 arrayBuffer(),规避默认行为:
async function fetchGbkData(url) {
  const response = await fetch(url);
  if (!response.ok) {
    throw new Error(`网络响应错误,HTTP状态码: ${response.status}`);
  }

  // 关键:不使用 response.text(),而是读取二进制 ArrayBuffer
  const buffer = await response.arrayBuffer();

  // 使用原生 TextDecoder 转换
  const decoder = new TextDecoder('gbk');
  return decoder.decode(buffer);
}
2. 进阶场景:分块大文件流式解码(防止汉字被截断)
当读取几十兆乃至数百兆的超大 GBK 文本时,一次性把全部内容加载到 ArrayBuffer 会导致内存暴增甚至页面卡死。此时应该使用 ReadableStream 进行分块读取。
必须注意的关键细节:GBK 是双字节编码。网络数据包分块(chunk)到达时,一个中文字符的 2 个字节恰好可能被硬生生切分在两个不同的 chunk 中。如果盲目对每个 chunk 单独调用 decoder.decode(chunk),被切断的字节就会被当成坏字符丢弃,导致相邻位置出现乱码。
正确的做法是在 decode() 时传入 { stream: true },让解码器自动缓存不完整的字节序列,等到下一个数据包到达时拼合解析:
async function streamFetchGbk(url, onChunkReceived) {
  const response = await fetch(url);
  const reader = response.body.getReader();
  const decoder = new TextDecoder('gbk');

  let fullResult = '';

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    // 关键配置:stream: true 保证切片跨越汉字多字节边界时,剩余字节能暂存于解码器内部缓冲中
    const chunkText = decoder.decode(value, { stream: true });
    fullResult += chunkText;

    if (onChunkReceived) {
      onChunkReceived(chunkText);
    }
  }

  // 最后调用一次不带 stream 参数的 decode,清空剩余缓冲
  fullResult += decoder.decode();
  return fullResult;
}
四、方案三:前端生成与导出 GBK 数据(编码困局与破局)
前面两节讲解的是“从外部读取 GBK(Decoding)”,而现实中很多开发者面临的另一半难题是“在前端生成 GBK 字节(Encoding)”。
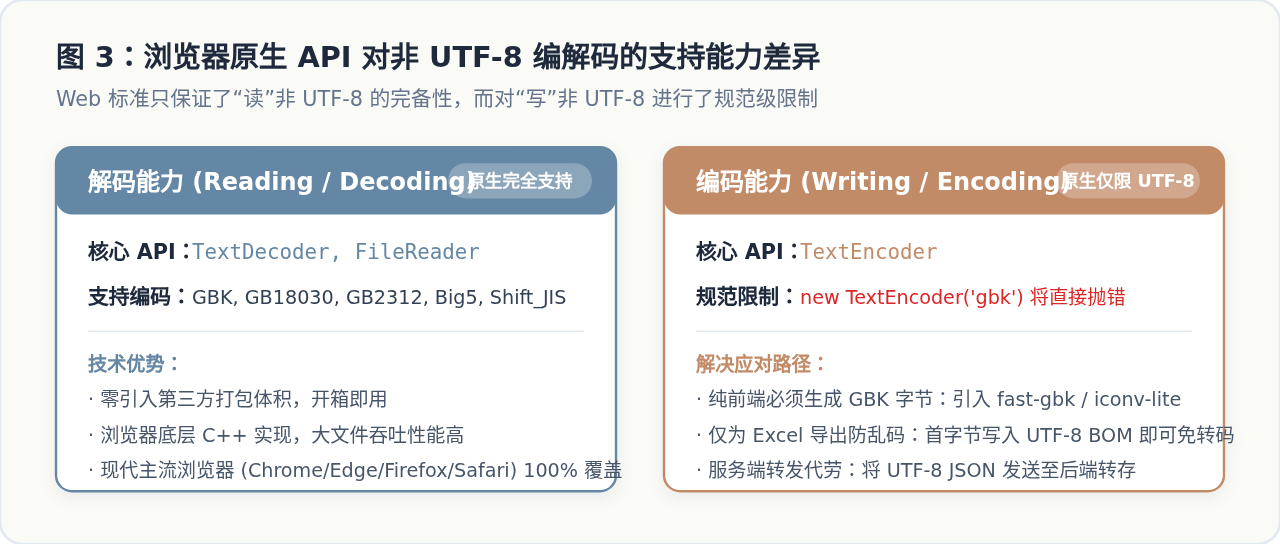
浏览器原生提供了一个与 TextDecoder 对称的 API 叫 TextEncoder。然而很多初学者尝试编写:
// 错误用法演示:这在所有现代浏览器中都会报错!
const encoder = new TextEncoder('gbk');
// 抛出 TypeError: Failed to construct 'TextEncoder': The encoding label provided ('gbk') is invalid.
这是因为 WHATWG 规范出于推动全球 Web 编码标准化的考虑,强制规定 TextEncoder 仅允许支持 UTF-8,禁止浏览器实现非 UTF-8 的编码器。因此,如果需要向外输出非 UTF-8 编码,必须按具体业务场景分别处理:
场景 A:纯前端导出 CSV 供旧版 Excel 打开(最常用)
绝大多数开发者之所以想在前端生成 GBK 编码,是因为用 JavaScript 拼接生成的 CSV 文件在中文 Windows 环境的 Excel 打开时直接乱码。Windows 上的 Excel 默认会用 ANSI(GBK)方式打开 CSV。
最优解决方案:完全不需要将字符串转为 GBK!只需要在导出的 UTF-8 文件的最前端追加一个 BOM(Byte Order Mark)字符 。Excel 在检测到文件开头的 BOM 标记(字节序为 0xEF, 0xBB, 0xBF)后,会强制自动切换为 UTF-8 编码读取,既支持全部复杂汉字,又完全免去了引入庞大 GBK 码表的开销。
/**
 * 纯前端将二维表格数据导出为带 BOM 的 UTF-8 CSV 文件
 * 彻底解决 Excel 打开乱码问题,无需任何第三方编码转换库
 */
function exportCsvForExcel(headers, rows, fileName = 'export.csv') {
  // 1. 将数据转为 CSV 文本行
  const csvLines = [];
  csvLines.push(headers.join(','));

  for (const row of rows) {
    const sanitized = row.map(item => `"${String(item).replace(/"/g, '""')}"`);
    csvLines.push(sanitized.join(','));
  }

  const csvContent = csvLines.join('\r\n');

  // 2. 关键点:在首部加上 \uFEFF (UTF-8 BOM)
  // 浏览器打包为 Blob 时会自动将 \uFEFF 转换为 0xEF 0xBB 0xBF 三个字节
  const blob = new Blob(['\uFEFF' + csvContent], {
    type: 'text/csv;charset=utf-8;'
  });

  // 3. 触发浏览器文件下载
  const downloadUrl = URL.createObjectURL(blob);
  const anchor = document.createElement('a');
  anchor.href = downloadUrl;
  anchor.download = fileName;
  document.body.appendChild(anchor);
  anchor.click();
  document.body.removeChild(anchor);
  URL.revokeObjectURL(downloadUrl);
}

// 调用示例
exportCsvForExcel(
  ['姓名', '部门', '入职日期'],
  [
    ['张三', '技术部', '2024-01-15'],
    ['李四', '运营部', '2024-03-20']
  ],
  '员工名单.csv'
);
场景 B:严格要求输出 GBK 二进制(硬件串口、遗留硬件协议)
如果业务场景是 Web Serial 驱动针式热敏打印机、蓝牙硬件设备通信,或者是上传给只能接收原生 GBK 二进制的特定接口,此时必须生成真实的 GBK 字节数组。
此时必须借助第三方纯 JavaScript 实现的编码表库,例如极其轻量的 fast-gbk 或 iconv-lite:
// 方式一:在打包工程中引入轻量库(npm install fast-gbk)
import { encode } from 'fast-gbk';

// 将 JS 字符串编码为 GBK 二进制 Uint8Array
const text = "技术部";
const gbkUint8Array = encode(text);

console.log('GBK 字节数组:', gbkUint8Array);
// 输出类似:Uint8Array(6) [188, 188, 202, 245, 178, 191]

// 方式二:如果通过 CDN 引入 gbk.js,可使用挂载的全局方法:
// const gbkBytes = window.GBK.encode("技术部");
五、关键避坑点与技术选型决策
在开发实践中,还有以下几个容易引发隐蔽 Bug 的技术细节需要格外警惕:
1. 字符集别名与繁体扩展问题
在给 TextDecoder 传参时,推荐优先传入 'gbk' 或 'gb18030'。虽然标准规定 'gb2312' 也是别名,但旧版规范中部分非标浏览器可能仅保留 GB2312 基础区(约 6763 个汉字)。如果文本中含有罕见字、人名字或繁体字,用 gb18030 / gbk 可以确保无漏字。
2. URL 编码的盲区
前端常用的 encodeURIComponent() 严格按 UTF-8 输出百分号编码(例如“中”转为 %E4%B8%AD)。如果需要向一个只接受 GBK 百分号编码(如 %D6%D0)的旧搜索接口拼装 GET 参数,encodeURIComponent 完全无能为力。此时必须先用 fast-gbk 获得字节,再手动将每个字节拼接为十六进制字符串 '%' + byte.toString(16).toUpperCase()。
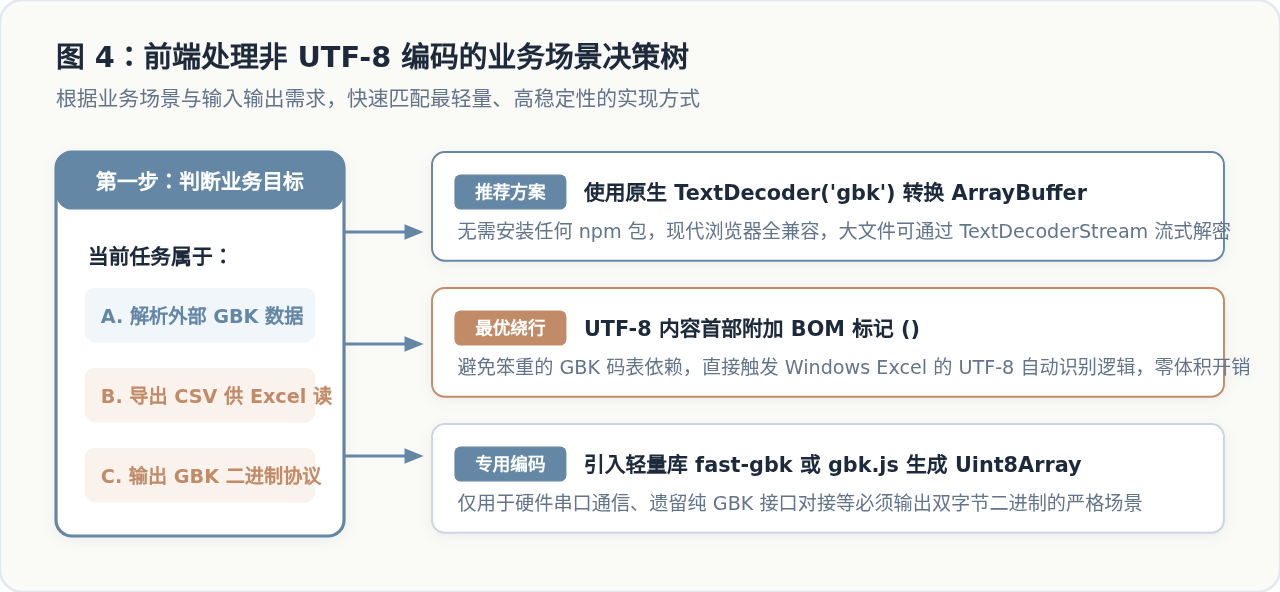
3. 方案对比与决策速查
为了帮助大家在日常开发中快速选型,下表列出了常见方案的维度对比:
| 方案类型 | 适用目标 | 是否依赖第三方库 | 浏览器支持度 | 关键特性与注意点 |
|---|---|---|---|---|
| TextDecoder('gbk') | 读取文件、fetch 响应、二进制流 | 否(纯原生) | 现代浏览器全部支持 | 性能最高,首选方案;分块流式需加 stream: true。 |
| FileReader.readAsText | 本地文件上传读取 | 否(纯原生) | 所有浏览器(含旧IE) | 基于事件回调,语法略显啰嗦,适合老系统维护。 |
| UTF-8 BOM () | 导出 CSV 文件防 Excel 乱码 | 否(纯原生) | 全平台 Excel 均兼容 | 秒级解决 Excel 乱码,零包体积开销,避免走转码弯路。 |
| fast-gbk / iconv-lite | 硬件通信、特定 GBK 接口上传 | 是(约需几十KB码表) | 全平台 | 纯前端输出 GBK 二进制的唯一合法解法。 |
六、总结
前端处理非 UTF-8 字符编码的核心在于“认清方向、区分动词”:
- “读”数据(输入与解析):直接使用浏览器原生提供的
TextDecoder('gbk'),把从File或Response拿到的ArrayBuffer转为 JS 字符串,无需安装任何外部模块。 - “写”数据(输出与导出):如果只是为了满足 Excel 查看表格不乱码,直接在 UTF-8 CSV 头部追加
即可;只有在必须与底层硬件、网络裸字节打交道的严苛场景下,才考虑引入fast-gbk等码表库进行编码。
遵循这套路径,不仅能彻底根治项目中的乱码报错,还能保证前端打包体积的最轻量与运行效率的最大化。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章