
深入剖析JavaScript中二维及多维数组的正确初始化方案,揭示fill()方法导致的共享引用陷阱底层原因,提供从Array.from映射、经典双重循环到多维通用递归函数的完整实践与性能选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS怎么正确初始化二维或多维数组
作者:函数茶馆
时间:2026-11-19
浏览:221
文章目录
在 JavaScript 中初始化二维数组,最标准且简洁的做法是使用
Array.from({ length: rows }, () => new Array(cols).fill(initialValue))。最危险也是最容易踩中的误区,则是直接使用 new Array(rows).fill(new Array(cols))。两者虽仅有一行代码之差,但底层内存模型完全不同。本文将从浅拷贝引用陷阱的根源剖析出发,详细讲解二维数组的三种正确构建方式、多维数组的通用递归实现,以及高性能场景下的平铺选型。
一、避开经典陷阱:为什么 fill() 会导致全行联动
在很多初学者的直觉中,既然 new Array(cols).fill(0) 可以生成一个长度为 cols 且充满 0 的一维数组,那么只要在外层再包一层 new Array(rows).fill(...),理应就能得到一个网格矩阵:
// ❌ 经典错误示范
const rows = 3, cols = 3;
const matrix = new Array(rows).fill(new Array(cols).fill(0));

// 尝试只修改第一行第一个元素
matrix[0][0] = 1;

// 查看输出结果:
console.log(matrix);
// 实际打印:
// [ [1, 0, 0],
//   [1, 0, 0],
//   [1, 0, 0] ]  <-- 所有行的第0个元素全部变成了 1!
表面上看,我们创建了 3 行,但在执行 matrix[0][0] = 1 后,第 1 行与第 2 行的第 0 列也同时变成了 1。发生这种诡异现象的原因,在于 JavaScript 的参数传递与 Array.prototype.fill() 的实现规范。
核心原理解析:在 JavaScript 中,函数参数是“按值传递”的。当参数为对象或数组等引用类型时,这个“值”实际上是该对象在堆内存中的引用地址指针。表达式
new Array(cols).fill(0) 在执行时只运行了一次,在内存中分配了一个具体的数组实例。随后的 fill(...) 将这个唯一的内存指针复制到了外层数组的每一个槽位中。外层数组的 3 个索引位实际上共享同一个内层数组对象。
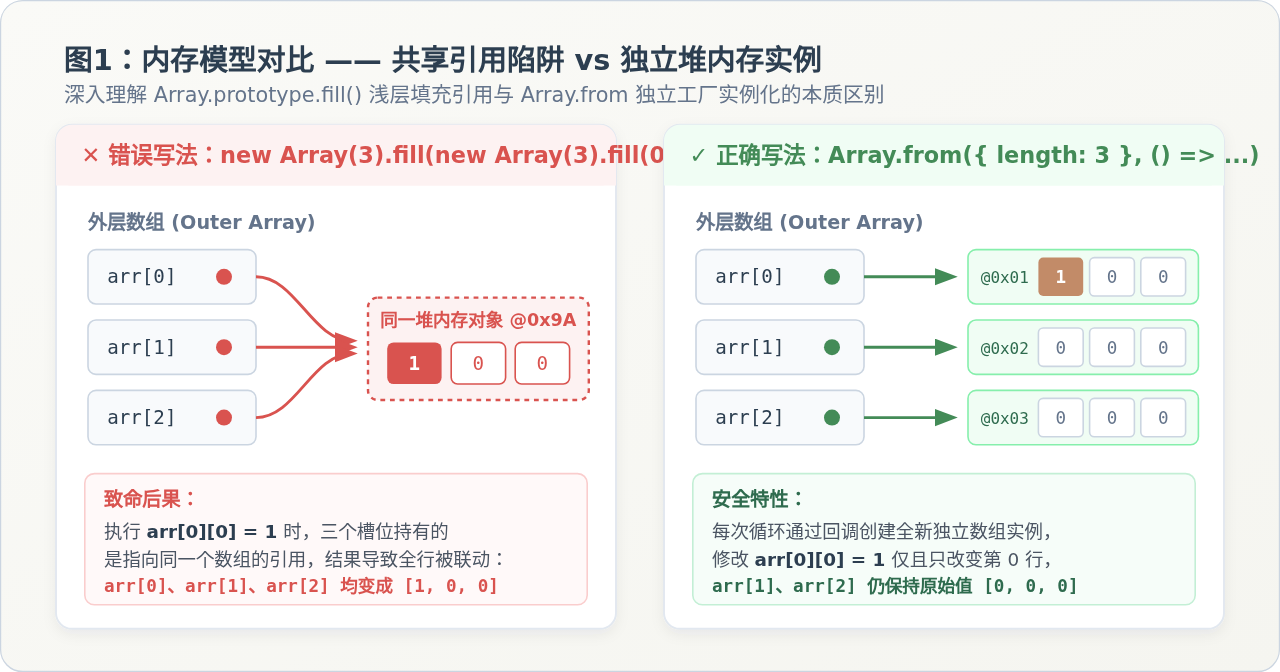
如上图1所示,左侧错误写法中,外层数组的所有索引指针都收敛到了同一个内层数组实例上。因此,通过任何一个行索引修改元素,本质上都是在对同一块堆内存进行变异操作。要彻底解决这个问题,必须确保外层数组的每一个槽位都拥有独立创建、分配在不同堆内存地址的内层数组实例。
二、正确初始化二维数组的三种常用方法
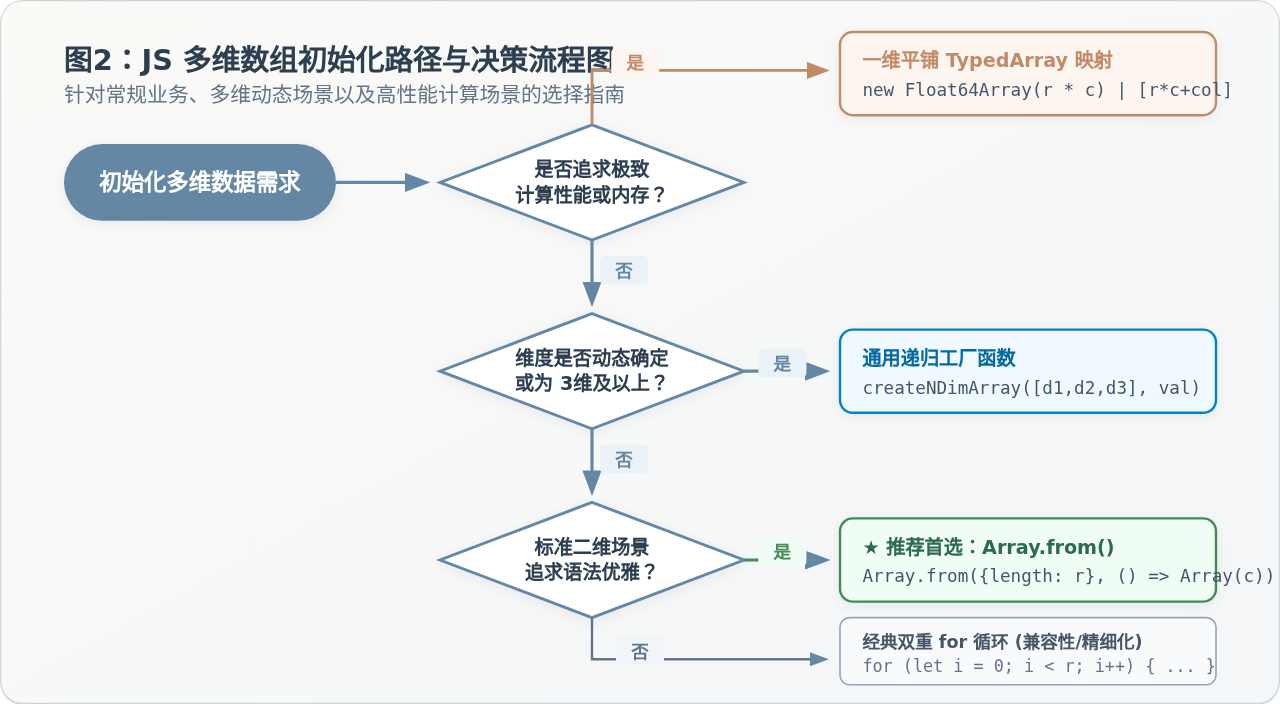
针对二维数组的初始化,不同场景有不同的最佳解法。以下是三种经过工程验证的标准实现方案。
方法一:Array.from() 映射工厂(首选标准做法)
ES6 引入的 Array.from() 接收一个类数组对象(例如 { length: rows })以及一个可选的映射函数。对于新数组的每一个索引位,Array.from() 都会独立触发一次映射回调。我们可以在回调中返回一个新创建的内层数组:
const rows = 3, cols = 4;

// 填充固定默认值(如 0)
const grid = Array.from({ length: rows }, () => new Array(cols).fill(0));

// 验证独立性
grid[0][0] = 99;
console.log(grid[1][0]); // 输出: 0,互不干扰!
如果每个单元格的初始值依赖其所在的行列坐标(例如生成递增编号或乘法表),映射函数还支持接收当前行索引 r,并可与内层 Array.from() 组合:
// 动态根据坐标计算初始值:val = r * cols + c
const numberedGrid = Array.from({ length: rows }, (_, r) =>
  Array.from({ length: cols }, (_, c) => r * cols + c)
);
方法二:经典嵌套 for 循环(直观可控、兼容性最佳)
虽然函数式写法语法简练,但传统的命令式 for 循环在执行效率、低版本浏览器兼容性以及调试透明度上仍然具备显著优势。特别是在需要构建每一行长度不同的不规则数组(锯齿数组)时,循环是最直接的实现方式:
function create2DArray(rows, cols, initialValue = 0) {
  const matrix = new Array(rows);
  for (let i = 0; i < rows; i++) {
    matrix[i] = new Array(cols);
    for (let j = 0; j < cols; j++) {
      matrix[i][j] = initialValue;
    }
  }
  return matrix;
}
方法三:链式调用 Array(rows).fill(null).map(...)
在很多现有代码库中,你可能会看到这种写法:new Array(rows).fill(null).map(() => new Array(cols).fill(0))。
这里有一个极易被忽略的细节:为什么中间必须先调用一次 .fill(null)?
new Array(rows) 构造出来的是一个“稀疏数组”(Sparse Array),内部只有 length 属性,各个索引位置并没有实际被赋键值(在 V8 引擎中标记为“空槽 Hole”)。而 Array.prototype.map() 规范规定会自动跳过未赋值的空槽。如果直接写 new Array(rows).map(...),回调函数一次都不会执行,最终返回的依然是一个全空的稀疏数组。先通过 .fill(null) 让数组密集化(Dense Array),map() 回调才能正常触发。
三、扩展到三维及任意高维数组:通用递归初始化
当数据结构扩展到三维(如三维网格空间、立体体素)乃至四维(如时间切片序列数据)时,手写三重或四重嵌套循环会带来严重的样板代码冗余,且无法适应动态给定的维度参数。
解决任意高维数组初始化的通用思路是分治递归:把一个高维数组看作“外层数组”,其每个元素是由剩余维度构成的子数组;当维度缩减到最后的一维时,触发递归基线条件并返回实际填充好数值的基础数组。
/**
 * 通用多维数组初始化函数
 * @param {number[]} dimensions 维度尺寸数组,例如 [2, 3, 4] 表示 2x3x4 的三维数组
 * @param {*} initialValue 单元格初始默认值
 * @returns {Array} 构造完毕的多维数组
 */
function createNDimArray(dimensions, initialValue = 0) {
  // 参数校验
  if (!Array.isArray(dimensions) || dimensions.length === 0) {
    return [];
  }

  // 基线条件(Base Case):如果只剩最后一个维度,直接返回填充好的一维数组
  if (dimensions.length === 1) {
    return new Array(dimensions[0]).fill(initialValue);
  }

  // 递归步骤:针对当前首个维度长度,为每个位置递归构造剥离首维后的剩余维度
  const [currentDim, ...remainingDims] = dimensions;
  return Array.from({ length: currentDim }, () =>
    createNDimArray(remainingDims, initialValue)
  );
}

// 使用示例 1:创建 2 x 3 x 4 的三维立体数组
const cube = createNDimArray([2, 3, 4], 0);
cube[0][1][2] = 77;
console.log(cube[1][1][2]); // 输出: 0 (严格独立,无引用污染)

// 使用示例 2:动态创建四维数组 [2, 2, 2, 2]
const hyperCube = createNDimArray([2, 2, 2, 2], "node");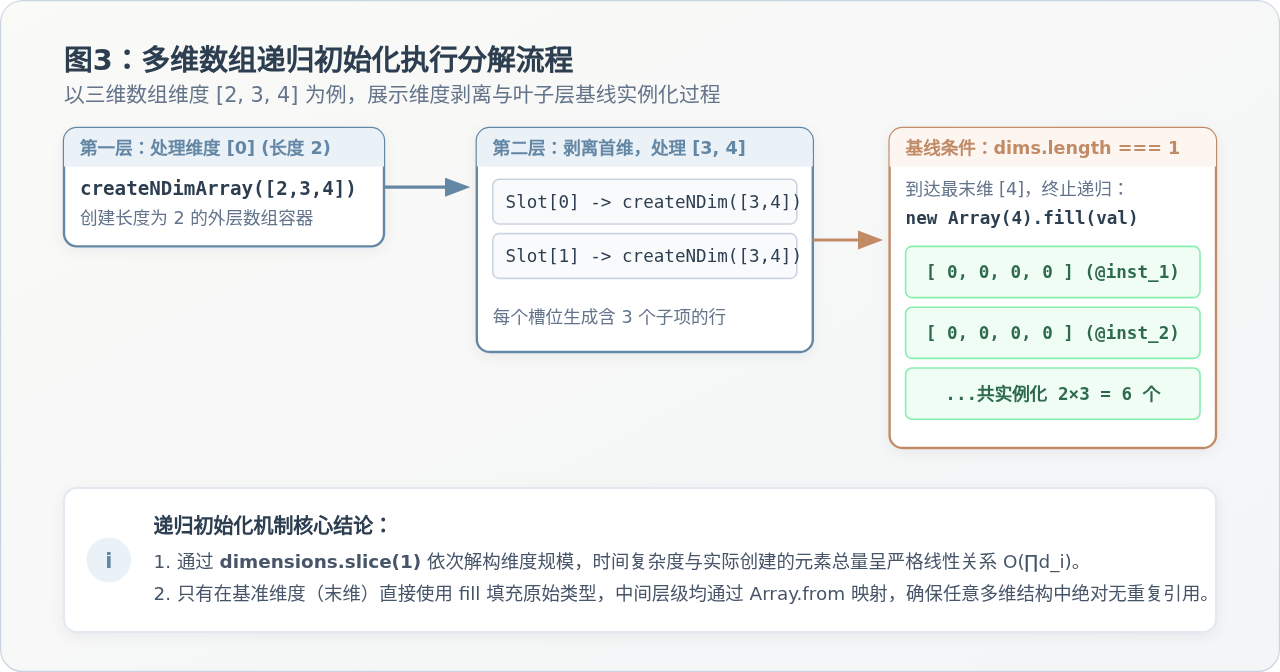
如上图3所示,递归过程严格保证了“只有在最末端的叶子维度”才调用 fill 进行基本类型填充,所有上层维度均通过 Array.from 动态产生全新的容器引用,从而彻底杜绝了任何层级的内存引用混淆。
四、进阶与性能考量:一维平铺矩阵
虽然嵌套数组在语法上符合直觉(支持 matrix[r][c] 双下标访问),但在底层执行机制上,JavaScript 的数组并非 C/C++ 意义上的连续内存矩阵,而是“存放对象指针的数组”。
- 内存碎片与 GC 压力:一个 1000×1000 的常规二维数组,实际在内存中创建了 1 个外层数组对象加上 1000 个独立的内层数组对象(共 1001 个堆对象),给垃圾回收器带来了显著的寻址与标记开销。
- CPU 缓存命中率低:双重指针跳转破坏了物理内存的局部连续性(Spatial Locality),导致每次内层取值都容易产生 CPU 缓存缺失(Cache Miss)。
如果你的项目涉及图像处理、物理模拟、大规模数值矩阵或 WebGL 数据交换,更推荐的工程方案是使用一维平铺数组(Flat Array)搭配类型化数组(TypedArray):
// 使用连续内存的类型化数组模拟二维矩阵
class Matrix2D {
  constructor(rows, cols) {
    this.rows = rows;
    this.cols = cols;
    // 分配完全连续的二进制物理内存缓冲区,默认初始化全为 0
    this.data = new Float64Array(rows * cols);
  }

  // 二维坐标映射为一维偏移量:index = r * cols + c
  get(r, c) {
    return this.data[r * this.cols + c];
  }

  set(r, c, val) {
    this.data[r * this.cols + c] = val;
  }
}

const mat = new Matrix2D(1000, 1000);
mat.set(10, 20, 3.1415);
console.log(mat.get(10, 20)); // 输出: 3.1415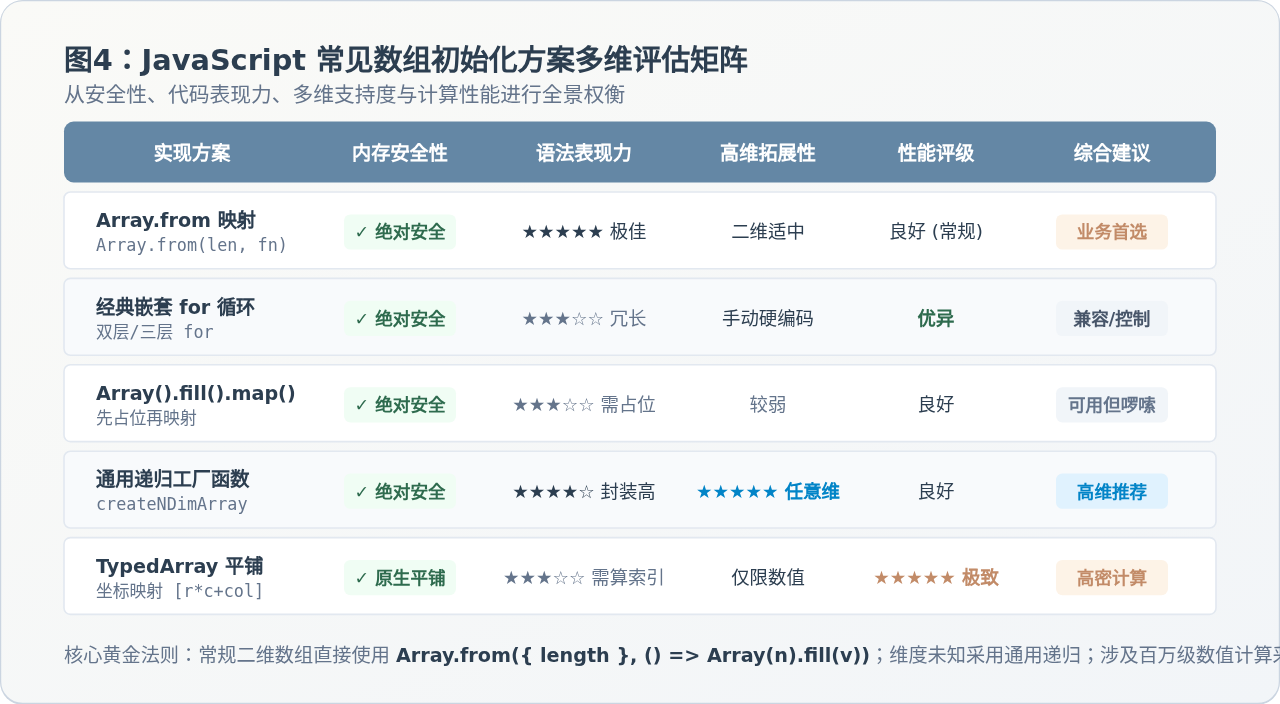
五、避坑清单与日常开发建议
在实际工程开发中,除了最初的 fill() 陷阱,还有以下两个高频出现的关联踩坑点需要重点防范:
1. 默认值为对象时的连带陷阱
即使使用了 Array.from({ length: rows }, () => new Array(cols).fill({ status: 'pending' })),每一行内部的多个对象元素仍然会指向同一个对象!因为内层的 .fill({ ... }) 同样是将同一个对象引用填充到各个列中。如果默认值包含对象、数组或 Set 等引用类型,内层也必须使用工厂函数:
// ❌ 错误:每行中的每一个单元格对象指向同一块引用
Array.from({ length: rows }, () => new Array(cols).fill({ count: 0 }));

// ✅ 正确:双层 Array.from,确保每个单元格对象独立生成
Array.from({ length: rows }, () =>
  Array.from({ length: cols }, () => ({ count: 0 }))
);
2. 二维数组浅拷贝误区
在需要复制已有矩阵时,使用 [...matrix] 或 matrix.slice() 仅仅复制了外层数组的容器本身,内层子数组的引用仍然被新旧矩阵共同持有。修改新矩阵的单元格会污染旧矩阵。
// ❌ 浅拷贝:内层子数组仍为同一引用
const cloned = [...matrix];

// ✅ 浅深隔离拷贝(针对基础数据类型矩阵):
const safeClone = matrix.map(row => [...row]);
总结:正确初始化 JavaScript 二维或多维数组的关键,在于理解“指针复用与独立实例化”的区别。对于绝大多数常规前端业务开发,直接使用 Array.from({ length: rows }, () => new Array(cols).fill(defaultValue)) 是兼顾可读性、执行安全与优雅语法的黄金标准;当面对动态高维输入时,采用分治递归生成器;面对大规模密集矩阵计算时,果断选用一维 TypedArray 平铺映射。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章