
本文详细讲解在JavaScript中使用[...str]展开运算符遍历和拆分含Emoji字符串的实用方法、底层UTF-16代理对机制、操作步骤与常见认知辨析。

当前位置:首页 > JavaScript 基础 > 正文
JS使用[...str]展开运算符遍历含Emoji的字符串
作者:函数茶馆
时间:2026-11-18
浏览:322
文章目录
在 JavaScript 中,如果直接使用传统索引循环 for (let i = 0; i < str.length; i++) 或 str.split('') 处理含 Emoji 的字符串,往往会将单个表情符号拆散成乱码或两个不可读的孤立代理字符。解决这一问题的最直接做法,是使用 ES6 展开运算符 [...str] 将字符串展开为真正的 Unicode 码点(Code Point)字符数组。展开运算符底层依赖内置的字符串迭代器协议,能自动将 UTF-16 代理对(Surrogate Pair)合并输出。本文将从底层编码原因、具体操作步骤、内部工作原理以及复合 Emoji 边界四个方面,详细讲解如何使用展开运算符安全遍历含 Emoji 的字符串。
一、为什么传统遍历方法遇到 Emoji 会“碎裂”
要理解 [...str] 为什么能解决问题,首先需要明白传统方法为什么会失效。许多开发者习惯用 str.split('') 将字符串切分成字符数组,或者通过 str.length 和 str[i] 进行索引遍历。这种做法在纯英文字符或基础汉字中表现正常,但一旦遇到 Emoji 表情就会出现异常。
这是因为 JavaScript 的字符串在底层使用 UTF-16 编码。在 UTF-16 规范中,最基本的存储单元是 16 位的码元(Code Unit)。普通 ASCII 字符(如 'A')和大部分常用汉字(如 '中')位于“基本多语言平面”(BMP),其码点数值可以用单个 16 位码元容纳,因此码元数量与我们视觉感知到的字符数量恰好是一对一的关系。
然而,绝大多数现代 Emoji 表情符号(例如 '😊'、'🚀'、'👋')位于“辅助平面”(SMP),其 Unicode 码点超出了 16 位整数的最大范围(大于 0xFFFF)。UTF-16 为了兼容存储这些高位字符,采用了代理对(Surrogate Pair)机制:用两个连续的 16 位码元(一个高位代理和一个低位代理)共同表示一个 Emoji 字符。
const text = "Hi 😊";

// 传统获取长度:这里的 😊 被计算为 2 个码元
console.log(text.length); // 输出: 5(而不是视觉上的 4)

// 传统 split 切割:将高低代理切开成两个孤立码元
const splitted = text.split('');
console.log(splitted);
// 示例输出: ['H', 'i', ' ', '\\uD83D', '\\uDE0A']
正如上面的示例所示,str.split('') 和索引访问是盲目按照 16 位码元进行切分的。当它遇到 '😊'(编码为 \\uD83D\\uDE0A)时,硬生生从中间切了一刀,导致每个单元都成了无效的代理片段。
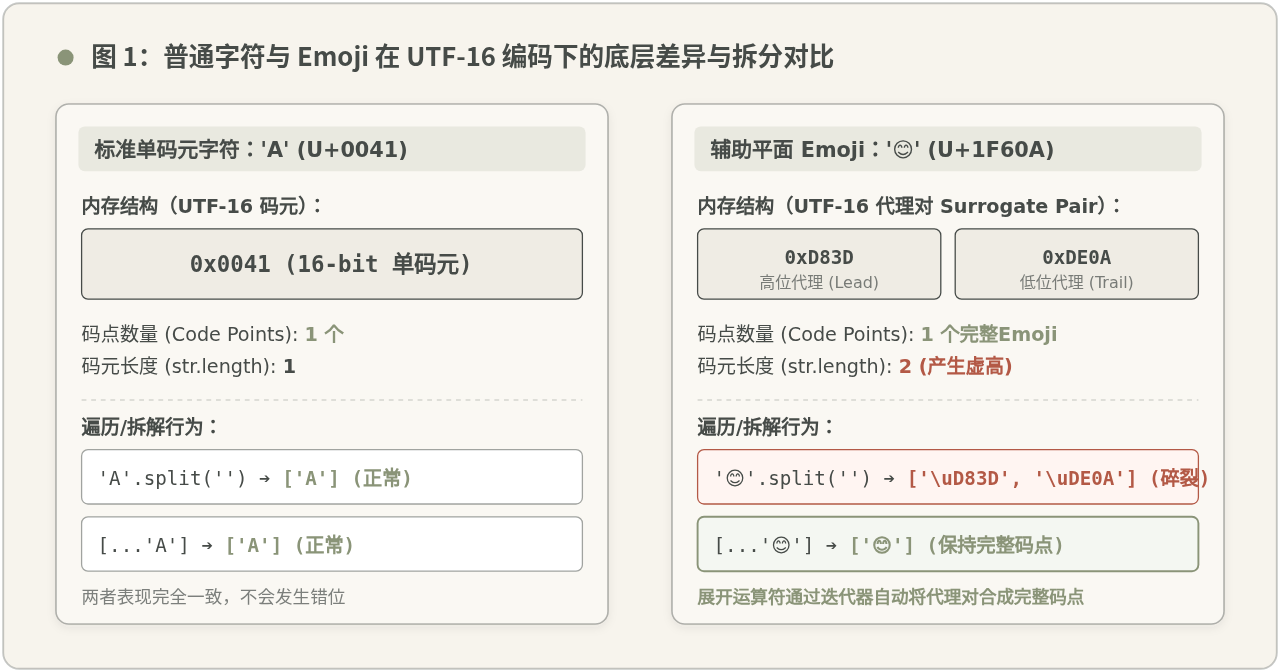
图 1:基础平面字符与辅助平面 Emoji 在 UTF-16 码元及传统切分下的行为差异
二、使用 [...str] 遍历含 Emoji 字符串的操作步骤
使用展开运算符 [...str] 是目前处理常见单码点 Emoji 最简洁、最符合现代 ES6+ 语法习惯的标准方案。下面是完整的具体操作步骤与代码实践:
步骤 1:利用展开运算符合并代理对并生成数组
将含 Emoji 的原始字符串放入数组字面量中,并使用三点展开运算符 ...。展开运算符会触发底层码点迭代器,自动识别并拼接相邻的高低代理对,生成每个元素都是完整字符的数组。
const message = "你好 👋 编码 🚀";

// 展开为码点数组
const charList = [...message];

console.log(charList);
// 示例输出: ['你', '好', ' ', '👋', ' ', '编', '码', ' ', '🚀']
步骤 2:获取真实的字符数量与安全索引
传统 message.length 输出的是码元数量,而展开后数组的 length 属性代表的是真正的 Unicode 码点数量。在此基础上,通过常规数组索引访问也可以安全取得完整的表情符号。
console.log(message.length);     // 输出: 11(Emoji各占2,导致虚高)
console.log(charList.length);    // 输出: 9(准确反映实际字符数)

// 安全按索引访问 Emoji
console.log(charList[3]);        // 输出: '👋'(不会出现半截字符)
console.log(charList[8]);        // 输出: '🚀'
步骤 3:结合数组高阶方法或 for...of 进行安全遍历
生成字符数组后,即可利用成熟的 JavaScript 数组生态(如 forEach、map、filter)或 for...of 循环执行逐字处理逻辑:
// 方式 A:使用 forEach 遍历并打印字符与其码点位置
charList.forEach((char, index) => {
  console.log(`第 ${index + 1} 个字符: ${char} (CodePoint: U+${char.codePointAt(0).toString(16).toUpperCase()})`);
});

// 方式 B:也可以直接对字符串使用 for...of 进行循环遍历
for (const char of message) {
  // 这里的 char 同样是正确合并后的完整 Emoji
  processChar(char);
}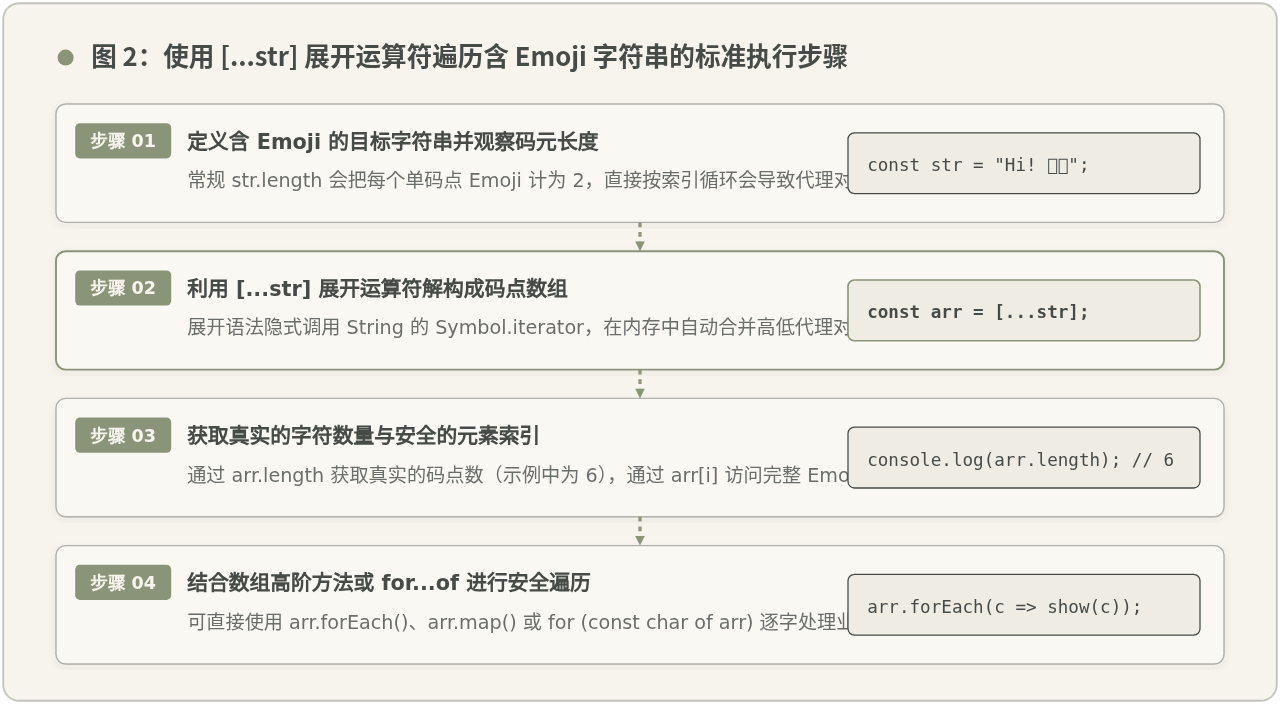
图 2:使用 [...str] 展开运算符遍历含 Emoji 字符串的标准执行流程
三、深入原理:为什么 [...str] 能够识别代理对
为什么 [...str] 与 str.split('') 在语法上看起来都是“拆分字符串”,执行结果却有本质不同?核心区别在于两者底层的取值协议。
split('') 是早期的宿主方法,其规范被严格定义为按照 UTF-16 码元索引逐个截取字符;而 ES6 引入的展开运算符 ... 和 for...of 遵循的是现代 可迭代协议(Iterable Protocol)。
在 JavaScript 引擎中,String.prototype 原生实现了 Symbol.iterator 方法。当遍历器在字符串上前进时,其内部游标并不仅仅是简单地递增 index++:
- 游标读取:游标读取当前位置的 16 位码元数值;
- 范围检测:检查该数值是否落在 UTF-16 高位代理区间(
0xD800到0xDBFF); - 代理合并:如果属于高位代理,并且下一个位置紧随低位代理(
0xDC00到0xDFFF),迭代器会将这两个 16 位码元合并成一个 21 位的 Unicode 码点,作为一个单独的字符字符串产出(yield),同时将内部游标向前跨越 2 个码元; - 单码元产出:如果不是代理对,则直接产出当前码元字符,游标向前跨越 1 个码元。
正是由于 [...str] 是基于 String.prototype[Symbol.iterator] 构建的语法糖,它天然继承了按码点扫描和步进的能力,因此从根本上杜绝了切碎代理对的问题。
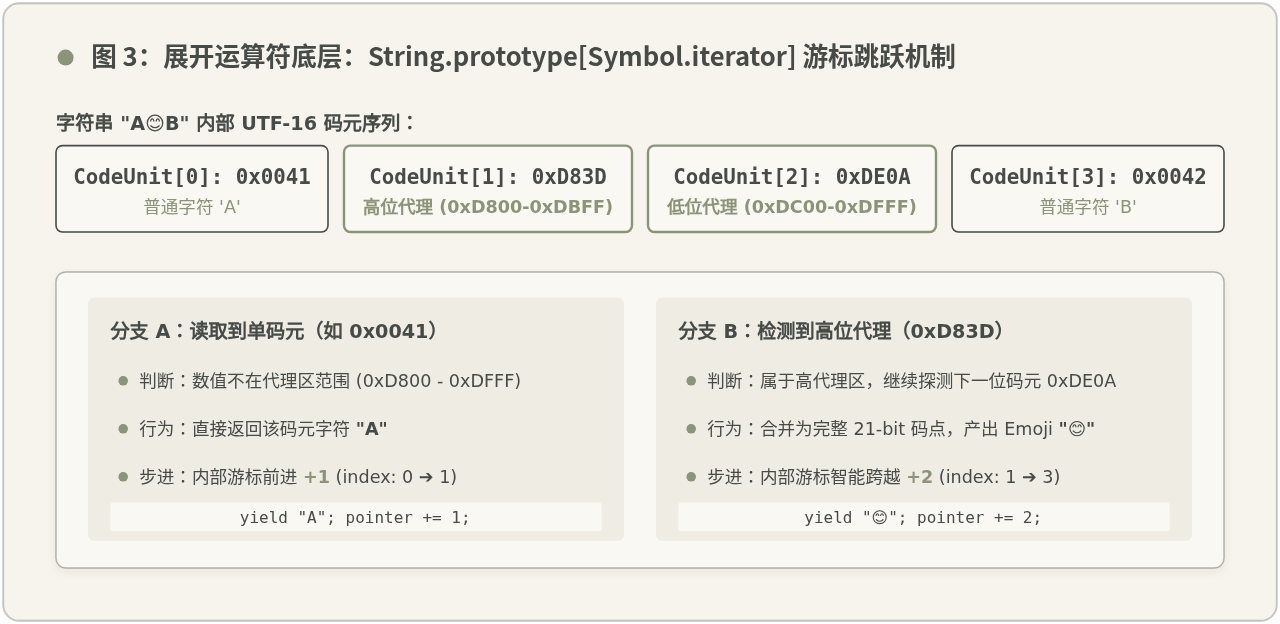
图 3:String.prototype[Symbol.iterator] 内部游标在遇到代理对时的判断与步进机制
四、认知辨析:[...str] 能完美解决所有的 Emoji 吗?
在很多前端交流中,有一种看似合理且流传甚广的说法:“在 JavaScript 里只要用 [...str] 展开,就能彻底搞定所有 Emoji 字符串的长度和遍历问题。”
这种说法在绝大多数常见单码点 Emoji(例如 😄、🌟、🔥、🎉)场景下是完全成立的,但如果认为它能“无条件搞定所有 Emoji”,就需要做必要的修正与补充。
边界场景:复合 Emoji 与 ZWJ 连字序列
Unicode 标准为了在不无限增加独立码点的前提下表达更丰富的现实含义,引入了复合 Emoji 规范。最典型的就是通过零宽连字符(Zero-Width Joiner,缩写为 ZWJ,Unicode 编码为 \u200D)将多个单码点 Emoji 拼接在一起,渲染为一个单一视觉字形。
例如,家庭表情 '👨👩👧👦' 在用户屏幕上看起来只是一个图标,但它在 Unicode 层面实际上是由 4 个独立的人物 Emoji 和 3 个零宽连字符拼接而成的长序列:
const family = "👨👩👧👦";
// 传统 length:高低代理对叠加连字符
console.log(family.length); // 输出: 11
// 使用展开运算符 [...str] 展开
const familyChars = [...family];
console.log(familyChars.length);
// 输出: 7(包含 4 个单人 Emoji 和 3 个看不见的 ZWJ 字符)
console.log(familyChars);
// 示例输出: ['👨', '\u200D', '👩', '\u200D', '👧', '\u200D', '👦']
除了 ZWJ 序列,带肤色修饰符的表情(如 '👍🏽' = '👍' + '🏽')和多国国旗序列(如 '🇨🇳' 由两个区域指示符号码点组成)同样属于多码点复合字符。
高精场景的升级方案:Intl.Segmenter
如果你在业务中面临的是严格面向用户视觉展示的场景(例如社交媒体限定用户最多输入 20 个“人眼可见的字符”),此时单纯按码点展开的 [...str] 就会把复合 Emoji 的计数放大。
在现代现代浏览器与 Node.js 16+ 环境中,官方标准提供了 Intl.Segmenter API,它专门按照用户可见字形群(Grapheme Cluster)进行分词与分割:
const segmenter = new Intl.Segmenter('zh', { granularity: 'grapheme' });
const segments = [...segmenter.segment("👨👩👧👦")];
console.log(segments.length); // 输出: 1(完美识别为单一视觉字形)
console.log(segments[0].segment); // 输出: '👨👩👧👦'
选型结论:
展开运算符
[...str] 的优势在于语法轻量、零依赖且性能优异,完全胜任 95% 以上常规单码点 Emoji 与多语言字符的遍历与拆分;只有在需要严格把复合 Emoji、肤色表情视作绝对单一字符的高精排版或计数业务中,才需要引入 Intl.Segmenter。
五、方案对比与选型决策
为了在工程开发中清晰选择适用的方案,我们可以将 JavaScript 中常见的四种字符串遍历与拆分方式进行横向对比:
| 技术方法 | 底层粒度 | 单码点 Emoji(如 😊) | 复合 Emoji(如 👨👩👧👦) | 推荐使用场景 |
|---|---|---|---|---|
str.split('') / str[i] |
16位码元 (Code Unit) | ❌ 代理对断裂,产生乱码 | ❌ 严重破碎 | 仅限纯 ASCII 字符或内部特定编码操作 |
[...str](展开运算符) |
Unicode 码点 (Code Point) | ✔ 保持完整字符 | 拆分为多个码点元素 | 常规业务首选:通用遍历、单字形处理、大多数日常输入 |
Array.from(str) |
Unicode 码点 (Code Point) | ✔ 保持完整字符 | 拆分为多个码点元素 | 与 [...str] 行为一致,适合函数式调用链场景 |
Intl.Segmenter |
字形簇 (Grapheme Cluster) | ✔ 保持完整字符 | ✔ 保持完整单一字形 | 输入框精确字数限制、富文本编辑器、国际化排版系统 |
在实际编写前端业务代码时,如果需要遍历、反转、截取包含 Emoji 的字符串,建议直接将旧式的 str.split('') 升级为 [...str]。例如实现字符串翻转:[...str].reverse().join('') 能够确保绝大部分表情符号在反转后依然完整可用,而不会因为代理对前后倒置而损坏。
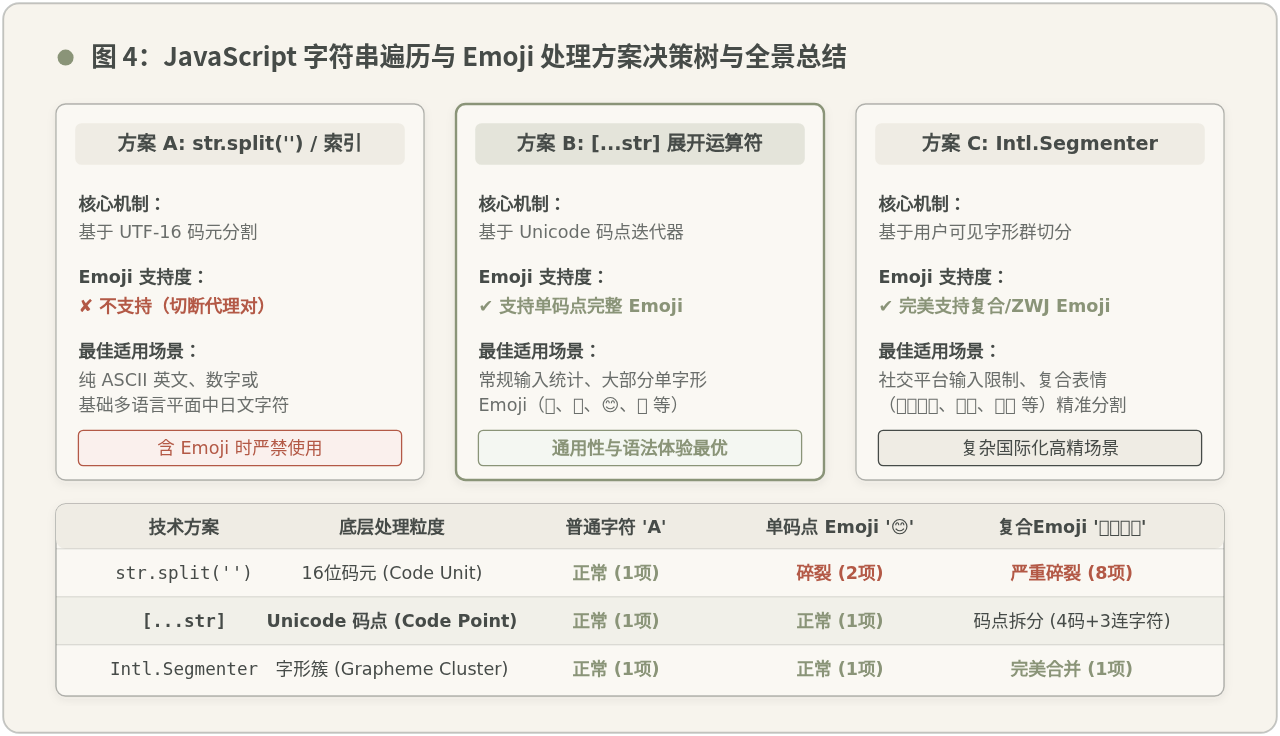
图 4:JavaScript 字符串遍历与 Emoji 处理方案决策树与全景总结
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章