
针对JavaScript中使用split('')拆分字符串导致Emoji表情截断成乱码的问题,深入剖析UTF-16代理对与字形簇原理,并提供基于扩展运算符、Intl.Segmenter以及兼容降级的完整解决方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS字符串逐字符转数组时Emoji被截断怎么办
作者:纸飞机
时间:2026-11-19
浏览:580
文章目录
JavaScript 字符编码
Unicode / UTF-16
Intl.Segmenter
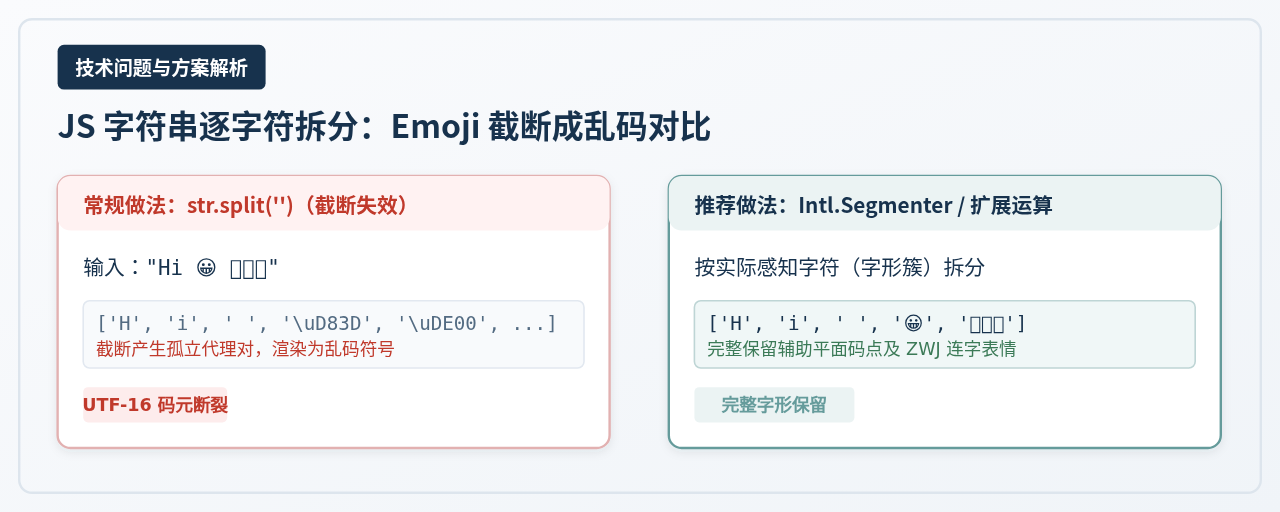
在 JavaScript 中,如果直接使用
str.split('') 将包含 Emoji 的字符串拆分为数组,大部分 Emoji 会被硬生生切成两半,变成形如 \uD83D 的无效孤立代理对,在界面上渲染为 [...str] 或 Array.from(str);对于带有肤色、性别或连字符号(如 👨👩👧👦)的复合 Emoji,标准且稳健的方案是使用内置的 Intl.Segmenter。
1. 现象复现:为什么 split('') 会截断 Emoji
许多初学者在需要做逐字动画、敏感词高亮、文本截断或打字机效果时,会下意识地写出 str.split('')。但在现代社交应用场景中,用户输入的文本往往夹杂着表情符号,此时该操作会立即暴露出严重缺陷。
const str = 'Hi😀';
const chars = str.split('');

console.log(chars);
// 实际输出: ['H', 'i', '\uD83D', '\uDE00']
// chars.length 为 4,而不是预期的 3
console.log(chars[2]);
// 输出乱码或空白字符:
从代码输出可以看到,一个笑脸符号 😀 在拆分后并没有完整保存在一个数组元素里,而是被分成了两个无法独立显示的十六进制编码片段。如果直接将拆分后的数组进行 slice(0, 3) 截取再拼接,整个 Emoji 就会彻底损毁。
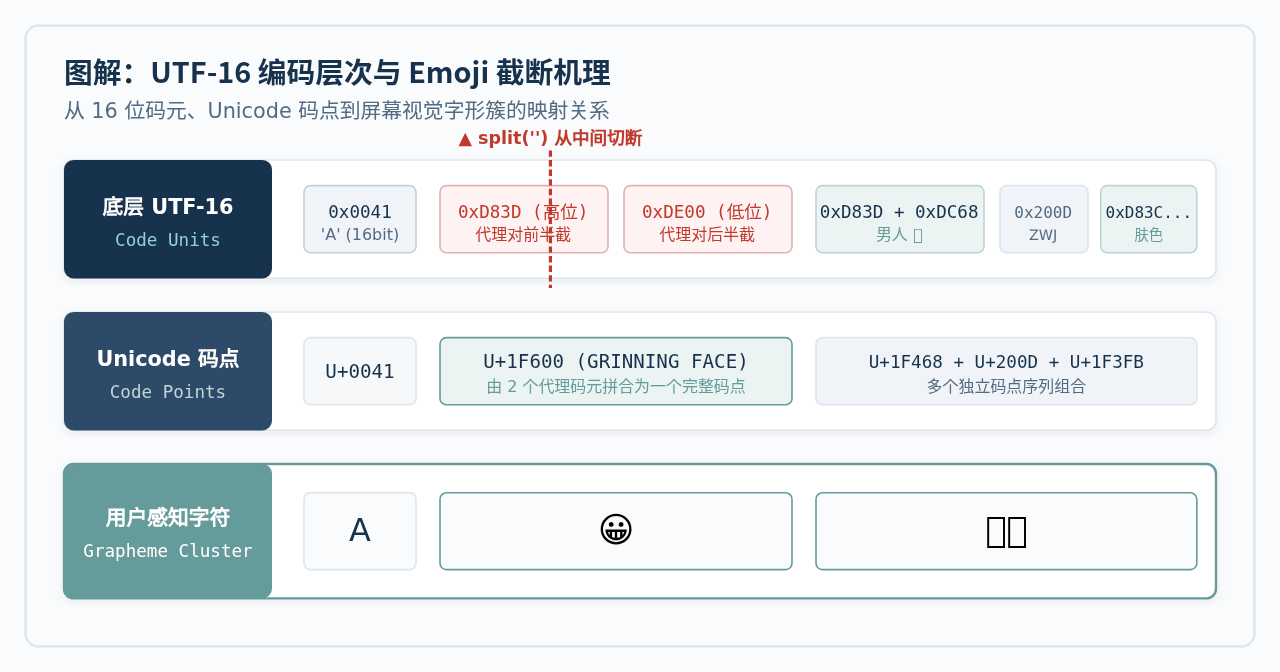
2. 根源探究:UTF-16 码元与字形簇机制
要彻底理解截断原因,必须了解 JavaScript 引擎内部存储字符串的底层逻辑:
- UTF-16 码元(Code Unit): JavaScript 诞生初期采用了 UCS-2 编码,随后演化为 UTF-16。JavaScript 的
length属性和split('')方法,底层操作的本质是 16 位的码元。 - Unicode 码点(Code Point): Unicode 为世界上的每个字符分配了一个唯一的编号(码点)。Unicode 空间分为基本多语言平面(BMP,U+0000 到 U+FFFF)和 16 个辅助平面(U+10000 到 U+10FFFF)。基本平面的字符只需 1 个 16 位码元即可表示。
- 代理对(Surrogate Pairs): 绝大多数 Emoji 的码点都大于 U+FFFF(位于辅助平面)。在 UTF-16 中,必须由两个 16 位的码元(一个高位代理和一个低位代理)拼合在一起才能表示一个字符。
split('')盲目按 16 位码元切分,导致代理对被拆散。 - 用户感知字符(Grapheme Cluster,字形簇): 更复杂的 Emoji(如家庭
👨👩👧👦)由多个独立码点通过零宽连字符(ZWJ,\u200D)连接而成,或者由基底字符加上肤色修饰符(如👍🏽)组成。它们在视觉上是一个字符,但在底层是多个连续码点。
3. 逐步排查与解决方案演进
针对不同的场景需求和运行环境,社区与标准库提供了多个层级的处理方案。以下按照方案的演进次序逐一说明。
方案一:使用 ES6 展开运算符或 Array.from(解决基础代理对)
ES6 为 JavaScript 引入了 Unicode 意识(Unicode-aware)。在 ES6 中,字符串实现了可迭代协议([Symbol.iterator]),其迭代器会按照 Unicode 码点(Code Point) 进行步进,而不是按 16 位码元切分。
const str = 'Hi😀';

// 方式 A:展开运算符
const arr1 = [...str];
console.log(arr1); // ['H', 'i', '😀']

// 方式 B:Array.from
const arr2 = Array.from(str);
console.log(arr2); // ['H', 'i', '😀']
注意局限性: 展开运算符和
Array.from 能够完美解决绝大多数单一 Emoji(如 😀、🎉、🐱),但依然无法正确处理带有变色修饰符或 ZWJ 连字符号的复合 Emoji。
例如,家庭表情 👨👩👧👦 本质上是由 4 个独立人像 Emoji 通过 3 个零宽连字符连接而成的复合字形:
const family = '👨👩👧👦';
console.log([...family]);
// 输出包含 7 个元素: ['👨', '\u200D', '👩', '\u200D', '👧', '\u200D', '👦']
// 视觉上是一个人脸图标,但数组长度依然变成了 7方案二:现代标准终极解法——Intl.Segmenter(字形簇粒度)
为了从语言标准层面彻底解决复杂的国际化文字分词与字形边界判定,ECMAScript 规范制定了 Intl.Segmenter API(已被所有现代浏览器以及 Node.js 16+ 广泛支持)。通过指定 granularity: 'grapheme'(字形簇),能够精确匹配人类在屏幕上所感知的字符单元。
function splitGraphemes(text, locale = 'zh') {
// 实例化分词器,指定粒度为字形簇 (grapheme)
const segmenter = new Intl.Segmenter(locale, { granularity: 'grapheme' });
// 将 Segments 迭代器映射为纯字符数组
return Array.from(segmenter.segment(text), s => s.segment);
}
// 测试复杂 Emoji 组合
const complexStr = 'A😀👍🏽👨👩👧👦🇨🇳';
const result = splitGraphemes(complexStr);
console.log(result);
// 完美输出: ['A', '😀', '👍🏽', '👨👩👧👦', '🇨🇳']
console.log(result.length); // 准确输出 5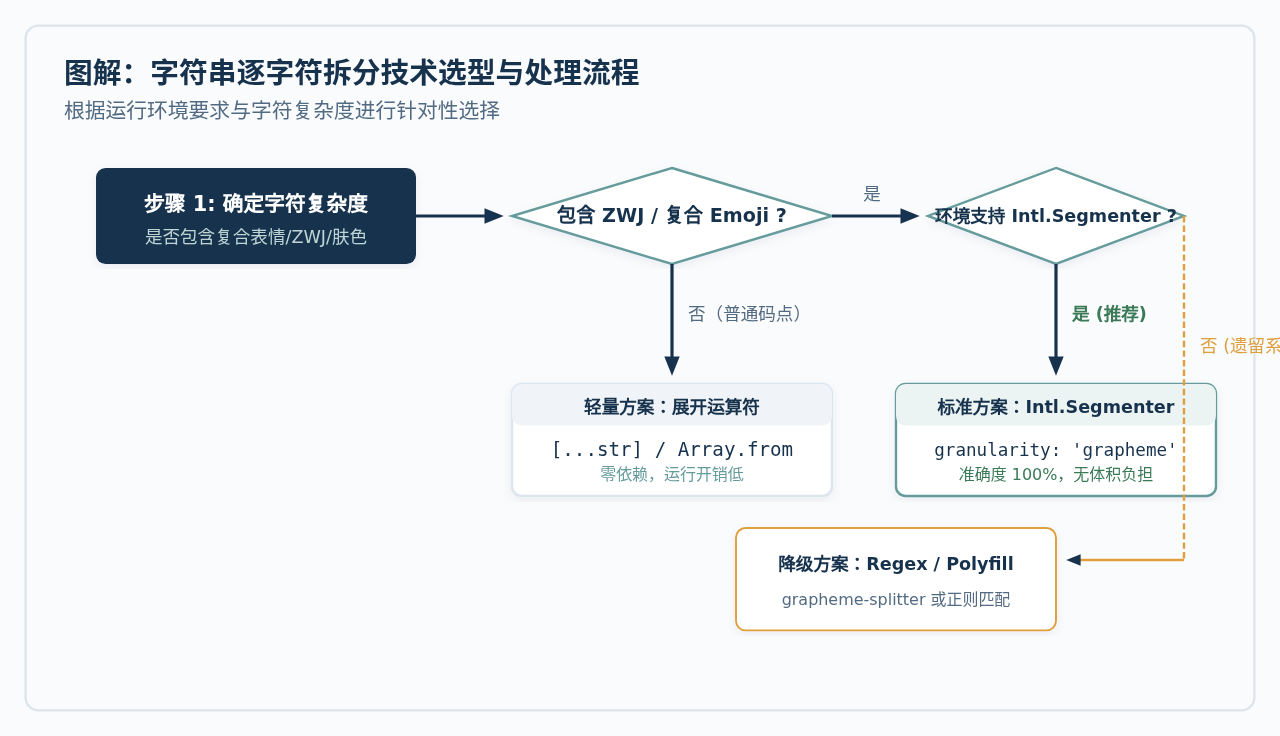
方案三:使用 Unicode 正则表达式拆分
如果运行环境暂时没有 Intl.Segmenter,但 JavaScript 引擎支持 ES2018 的 Unicode 属性转义(\p{...}),可以通过正则表达式按“图元字符”进行匹配提取:
function splitWithRegex(str) {
  // 匹配图元字符或任意单字符
  const regex = /\p{Extended_Pictographic}|\p{Regional_Indicator}{2}|./gu;
  return str.match(regex) || [];
}

const text = 'Hi😀🇨🇳';
console.log(splitWithRegex(text));
// 输出: ['H', 'i', '😀', '🇨🇳']
需要提醒的是,手写正则很难穷尽所有的 Unicode 组合规则(例如复合肤色序列、连续 ZWJ 表情)。因此在非标准环境下,引入轻量且经过充分单元测试的专用库(如 grapheme-splitter)会更加稳妥。
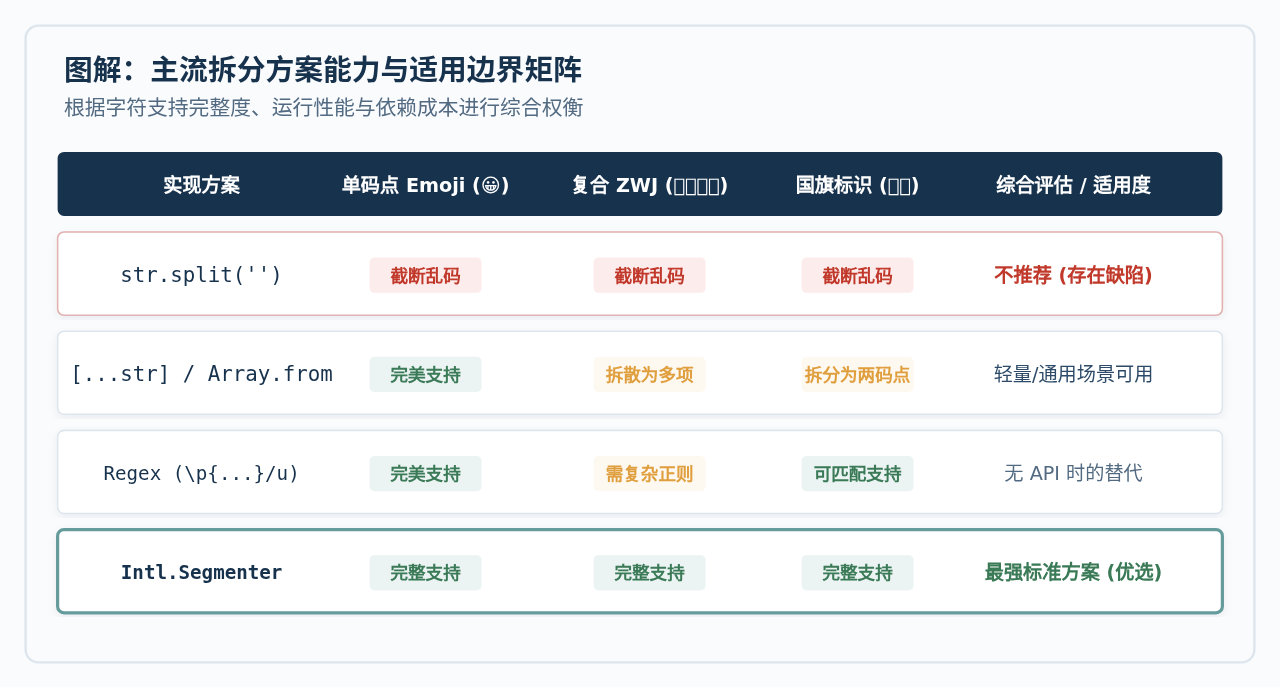
4. 四种拆分方案的详细能力对比
为了帮助读者在不同项目中作出准确决策,我们将常见方案在各维度的表现整理如下:
5. 生产级最佳实践:安全字符拆分函数封装
在实际生产环境中,我们不仅需要保证 Emoji 不被截断,还要考虑旧版运行环境(例如部分早期移动端 WebView 或旧版 Node.js)的平稳降级。我们可以封装一个开箱即用的工具函数 safeSplitChars:
/**
* 安全地将字符串逐字符转为数组,防止 Emoji 截断与乱码
* @param {string} str 输入字符串
* @returns {string[]} 字符数组
*/
function safeSplitChars(str) {
// 边界处理
if (!str || typeof str !== 'string') return [];
// 优先使用官方标准 Intl.Segmenter (支持复合 Emoji 与字形簇)
if (typeof Intl !== 'undefined' && Intl.Segmenter) {
const segmenter = new Intl.Segmenter(undefined, { granularity: 'grapheme' });
return Array.from(segmenter.segment(str), s => s.segment);
}
// 降级方案:使用 ES6 迭代器 (保证单码点代理对 Emoji 不被拆断)
return [...str];
}
// 验证执行结果
const text = '你好👋 欢迎来到2026! 👨👩👦';
const result = safeSplitChars(text);
console.log(result);
// 无论在现代浏览器还是兼容环境下,均不会出现半个乱码符号 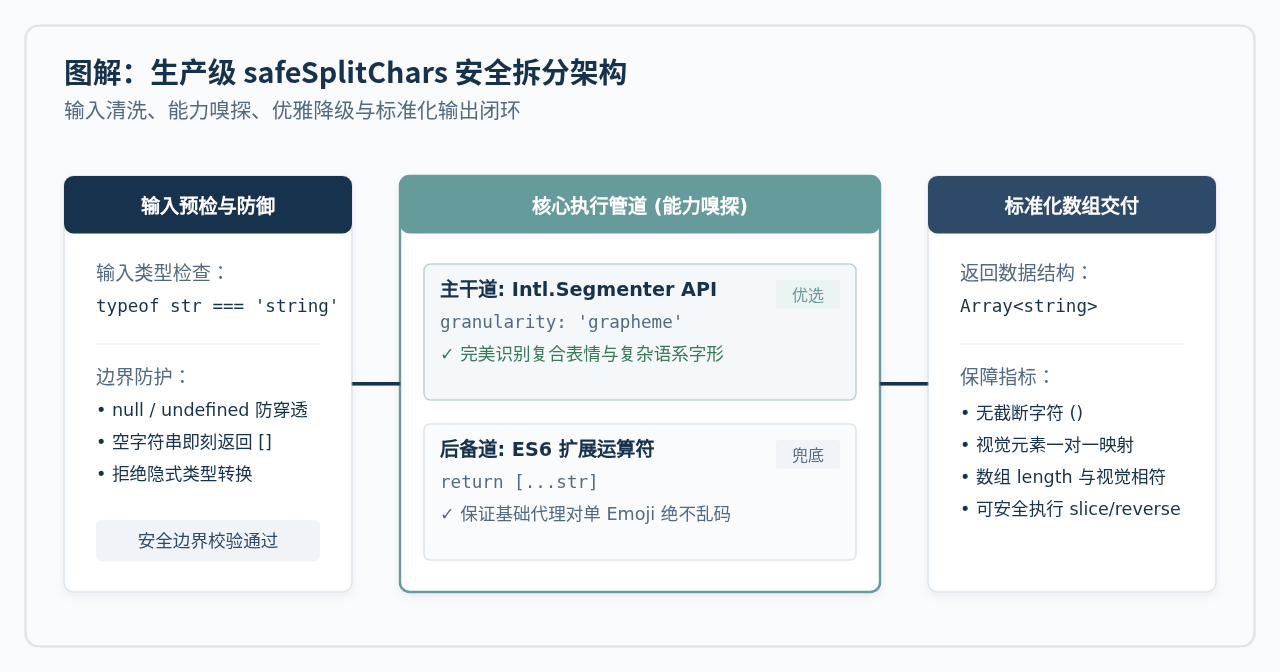
6. 常见相关问题(FAQ)
Q1: 获取带 Emoji 字符串的“真实视觉长度”应该用什么?
千万不要直接使用 str.length。如果字符串中包含 👨👩👧👦,str.length 会返回 8。正确且准确的方式是调用上述的 safeSplitChars(str).length,或者直接使用 new Intl.Segmenter().segment(str) 统计段落数量。
Q2: 字符串反转(Reverse)时 Emoji 损坏怎么办?
常见的反转写法 str.split('').reverse().join('') 会彻底损坏代理对和复合表情,使 😀 变成两个倒置的非法字节。正确的反转方式是:
function reverseString(str) {
return safeSplitChars(str).reverse().join('');
}
console.log(reverseString('Hello 😀 👨👩👧'));
// 正常输出: '👨👩👧 😀 olleH'Q3: 将文本截断为固定字数并添加省略号时该注意什么?
传统的 str.substring(0, limit) 会盲目按码元截断,容易在末尾留下半个 Emoji。应先通过 safeSplitChars 拆分为数组,使用 arr.slice(0, limit).join('') 进行截取,从而确保最后一个字符永远是完整的图形。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章