
深入对比JavaScript中5种常用的数组去重方法,从底层原理、时间复杂度到对NaN、对象引用与基本类型的边界支持,提供实用的技术选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组去重的5种常用方法对比
作者:纸飞机
时间:2026-11-18
浏览:205
文章目录
在 JavaScript 开发中,数组去重是一项高频基础操作。看似简单的去重任务,在实际工程中往往需要权衡执行效率(时间复杂度跨越 O(n) 到 O(n²))、内存占用、代码可读性,以及对各种特殊数据类型(如 NaN、undefined、区分数字与字符串 1 与 '1'、对象引用)的边界处理能力。本文全面梳理 5 种最常用的去重方案,从底层机制、代码示例、性能开销到边界异常进行深度横向评测,助你在不同业务场景中做出最合适的选型。
方法一:ES6 Set 与扩展运算符(现代工程首选)
ES6 引入了集合数据结构 Set,它的一大核心特性就是成员值唯一。结合扩展运算符(Spread Operator ...)或 Array.from(),可以用一行代码完成数组的去重操作,这也是现代前端工程中最主流、可读性最好的去重手段。
代码实现
// 方式 A:使用扩展运算符(推荐)
const uniqueWithSpread = (arr) => [...new Set(arr)];

// 方式 B:使用 Array.from
const uniqueWithArrayFrom = (arr) => Array.from(new Set(arr));

// 示例验证
const rawList = [1, '1', 2, 2, NaN, NaN, null, undefined, undefined];
console.log(uniqueWithSpread(rawList));
// 输出: [1, '1', 2, NaN, null, undefined]
底层机制与边界表现
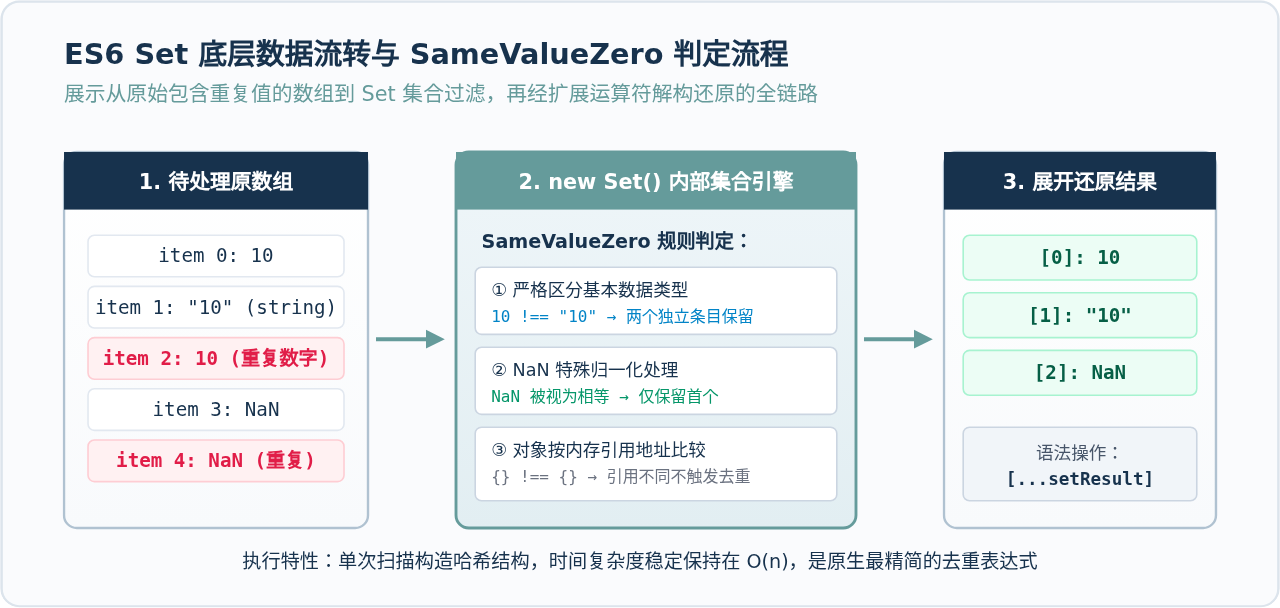
Set 内部在判断元素是否重复时,依据 ECMAScript 规范采用的是 SameValueZero(零值相等) 算法。
- 基本类型严格区分:数字
1与字符串'1'类型不同,会被视为不同元素分别保留。 - 正确处理 NaN:虽然在 JavaScript 的全等判定中
NaN === NaN恒为false,但在 SameValueZero 规则下,NaN被视为相互相等,因此能正确合并重复的NaN,仅保留一个。 - 对象引用限制:
Set仅比对对象的内存引用地址。两个内容完全相同但内存地址独立的对象(例如{ a: 1 }与{ a: 1 })会被视为不同条目,无法实现深层属性去重。
方法二:filter 配合 indexOf(经典函数式写法)
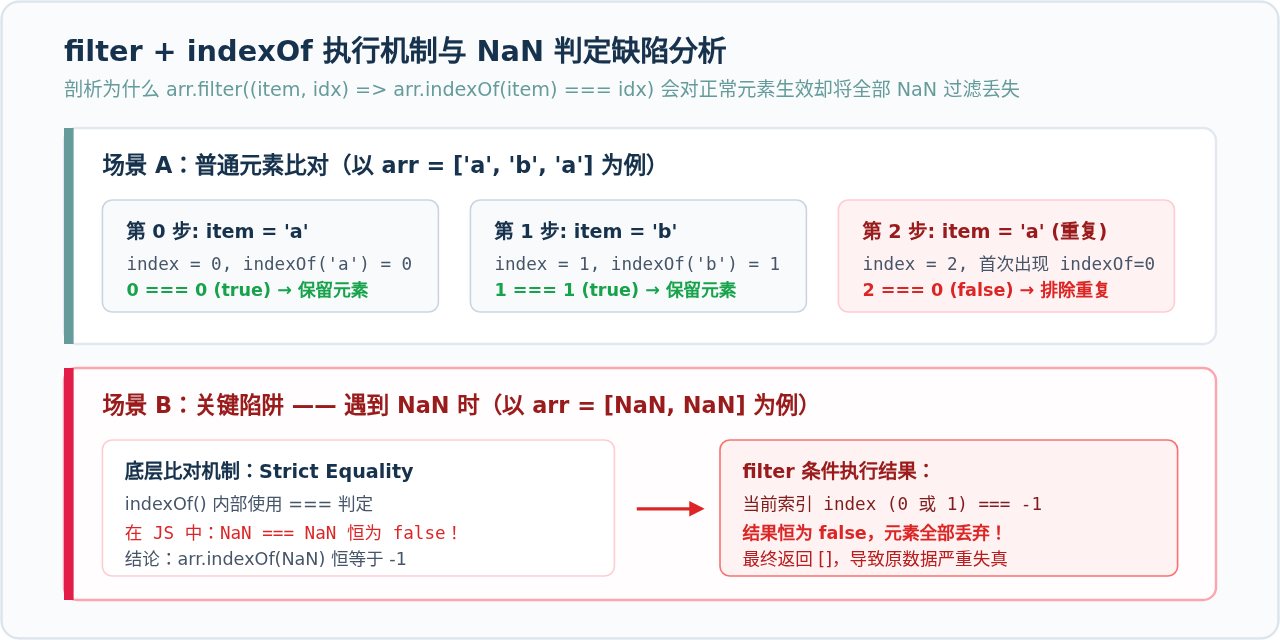
在 ES5 时代,利用数组原型链上的高阶函数 filter 结合 indexOf 是最典范的函数式去重写法。它的核心逻辑是:只保留当前元素在整个数组中第一次出现的下标与当前遍历下标相等的项。
代码实现
function uniqueByFilter(arr) {
  return arr.filter((item, index) => arr.indexOf(item) === index);
}

// 基础示例
const numbers = [1, 2, 3, 2, 1, 4];
console.log(uniqueByFilter(numbers)); // [1, 2, 3, 4]
缺陷与关键陷阱剖析
尽管代码表达直观,但该方案在实际生产环境中存在两个致命缺陷:
陷阱警示:NaN 会被完全误杀丢弃
indexOf() 底层遵循严格相等(Strict Equality Comparison, ===)。在 JavaScript 中,NaN === NaN 返回 false,导致 arr.indexOf(NaN) 永远返回 -1。因此在 filter 回调中,条件 index === -1 永远为假,数组中所有的 NaN 都会被过滤掉,导致原始数据丢失!
此外,filter 本身是一层循环,内部调用的 indexOf 又执行了一次线性扫描,时间复杂度为 O(n²)。在万级数据量时,页面会出现肉眼可见的阻塞。
方法三:循环或 reduce 配合 includes(直观无漏检)
为了弥补 indexOf 无法识别 NaN 的缺陷,ES2016 (ES7) 提供了 Array.prototype.includes。该方法同样基于 SameValueZero 规范,能够正确判断数组是否包含 NaN。我们可以通过 for...of 循环或 reduce 构建新数组。
代码实现
// 方式 A:reduce 累加收集
function uniqueByReduce(arr) {
  return arr.reduce((acc, curr) => {
    return acc.includes(curr) ? acc : [...acc, curr];
  }, []);
}

// 方式 B:for...of 简单高效收集
function uniqueByIncludes(arr) {
  const result = [];
  for (const item of arr) {
    if (!result.includes(item)) {
      result.push(item);
    }
  }
  return result;
}

// 验证特殊值
console.log(uniqueByIncludes([NaN, 1, NaN, '1']));
// 输出: [NaN, 1, '1'](NaN 得到正确保留)
适用场景与注意事项
该方法的优势在于逻辑简单易读、能妥善处理 NaN。但必须注意,result.includes(item) 在未找到时需要遍历整个已收集结果数组,因此整体时间复杂度依然是 O(n²)。对于几十或上百条数据的小型数组是适用的,但不宜用于大数据集。
方法四:基于 Map 的哈希标记法(高性能与复杂类型兼顾)
在算法层面,要将时间复杂度从 O(n²) 优化至 O(n),核心在于引入哈希查找(Hash Table)。在 ES6 之前,开发者常利用普通 JavaScript 对象(Object)作为哈希字典,但普通对象存在严重的类型转换陷阱。现代开发推荐使用 ES6 Map。
为什么普通对象 Object 存在缺陷?
传统 JavaScript 对象的属性名只支持字符串和 Symbol。如果执行 obj[1] = true 与 obj['1'] = true,数字 1 会被隐式转换为字符串 "1",导致数字和字符串发生键名冲突;更严重的是,所有普通对象在转为键名时都会变成 "[object Object]",导致所有对象都被误判为重复。
Map 方案代码实现
// 通用基本数据类型 Map 去重
function uniqueByMap(arr) {
  const seen = new Map();
  return arr.filter(item => !seen.has(item) && seen.set(item, true));
}

// 进阶应用:对象数组按指定字段(如 id)去重
function uniqueObjectsByProp(arr, propKey) {
  const map = new Map();
  return arr.filter(item => {
    const key = item[propKey];
    return !map.has(key) && map.set(key, true);
  });
}

// 示例:按业务 id 去重
const users = [
  { id: 101, name: '张三' },
  { id: 102, name: '李四' },
  { id: 101, name: '张三(副本)' }
];
console.log(uniqueObjectsByProp(users, 'id'));
// 输出: [{ id: 101, name: '张三' }, { id: 102, name: '李四' }]
方案评价
Map 的键可以是任意 JavaScript 数据类型,完美保持了数据的原始类型隔离,并且 has() 与 set() 的查找与插入时间复杂度均为 O(1)。这使得整体去重时间复杂度稳定在 O(n)。在需要自定义对象属性去重的复杂业务中,这是最健壮、扩展性最强的方案。
方法五:排序后相邻比较法(sort + 单次扫描)
在算法面试或极端注重内存开销的场景下,可以先对数组进行排序,使相同的元素在内存序列中相邻排列,然后通过一次线性扫描将不相等的元素挑选出来。
代码实现
function uniqueBySort(arr) {
  if (!Array.isArray(arr) || arr.length <= 1) return [...arr];

  // 浅拷贝避免污染原数组,并传入明确的数字/字符比较器
  const sorted = [...arr].sort((a, b) => {
    if (a === b) return 0;
    return a > b ? 1 : -1;
  });

  const result = [sorted[0]];
  for (let i = 1; i < sorted.length; i++) {
    if (sorted[i] !== sorted[i - 1]) {
      result.push(sorted[i]);
    }
  }
  return result;
}

console.log(uniqueBySort([3, 1, 3, 2, 1, 5])); // [1, 2, 3, 5]
优缺点与边界限制
- 时间与空间成本:现代 JS 引擎(如 V8 的 Timsort 算法)排序时间复杂度为 O(n log n),遍历比较为 O(n),整体复杂度为 O(n log n)。相比 O(n²) 方法明显更快。
- 致命局限:此方法会改变数组原本的元素先后顺序。若业务逻辑对数组先入先出的顺序有强要求,该方法不可用。此外,对于混合了对象、Symbol 的异构数组,自定义排序器的编写成本极高。
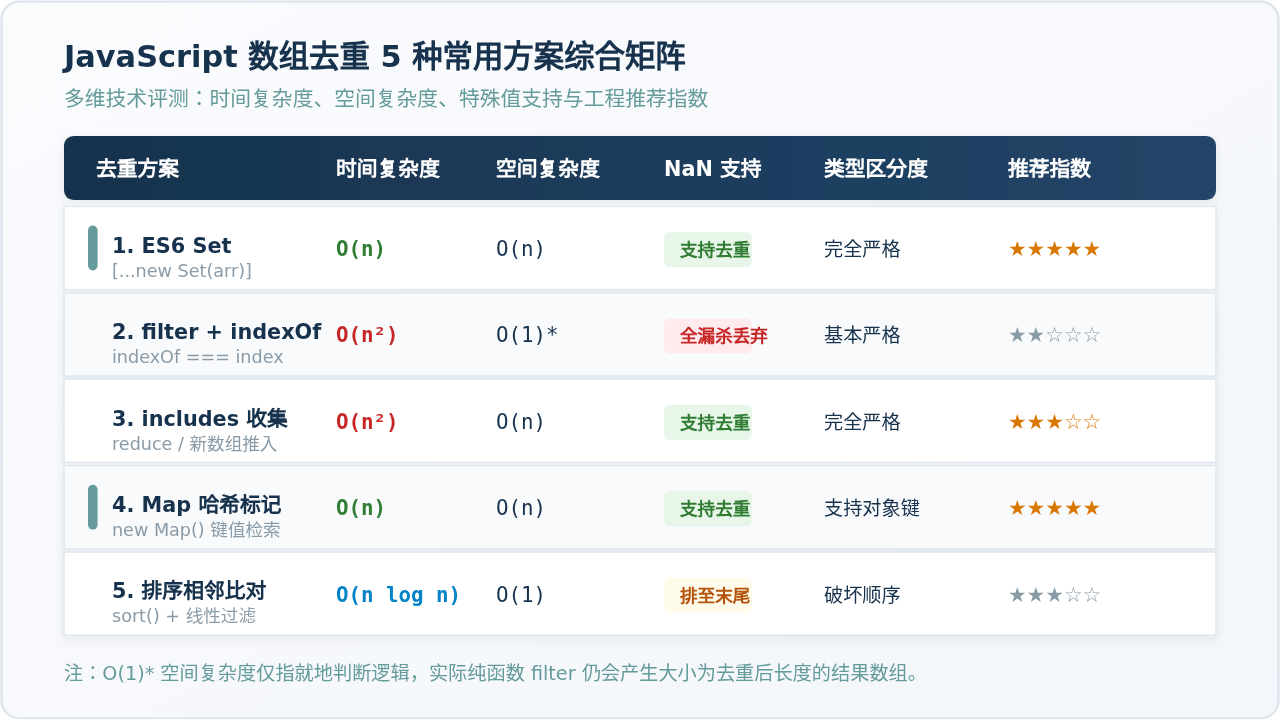
5种常用去重方案全面横向对比
| 去重方案 | 时间复杂度 | 空间复杂度 | 保留原始顺序 | NaN 正确去重 | 对象属性定制 |
|---|---|---|---|---|---|
| 1. ES6 Set | O(n) | O(n) | 是 | 支持 | 否(仅比对引用) |
| 2. filter + indexOf | O(n²) | O(1)* | 是 | 误杀全丢弃 | 否 |
| 3. includes 收集 | O(n²) | O(n) | 是 | 支持 | 否 |
| 4. Map 哈希标记 | O(n) | O(n) | 是 | 支持 | 完美支持 |
| 5. sort + 相邻对比 | O(n log n) | O(1)* | 否(顺序打乱) | 视排序规则而定 | 需复杂比较器 |
技术选型指南与决策路径
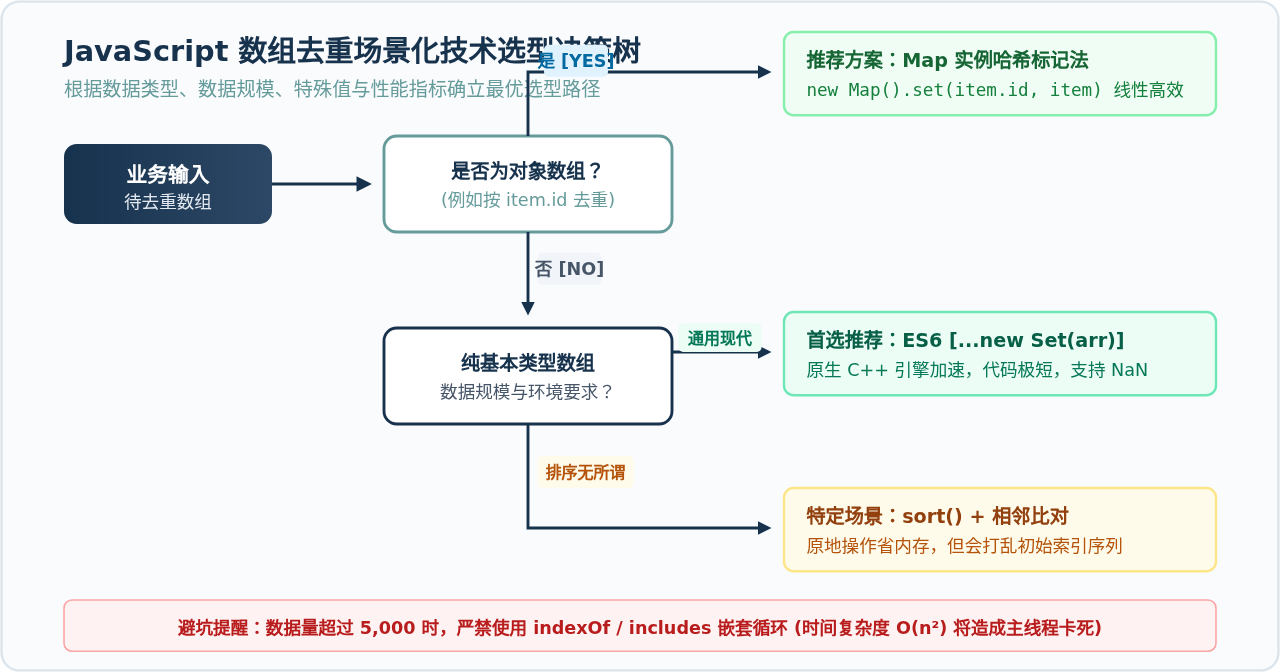
面对具体业务场景时,建议参考下图所示的选型决策树,从而在代码整洁度、执行性能与特殊边界支持之间取得最佳平衡:
选型建议总结
- 默认推荐:日常开发中面对纯数字、字符串、布尔值等基础类型数组,直接使用
[...new Set(arr)]。代码量极短,底层由浏览器原生优化,性能与容错率均为最佳。 - 对象去重首选:如果需要对包含对象的列表根据唯一业务标识(如
item.id或item.uuid)去重,推荐使用Map结合filter。 - 杜绝使用 filter + indexOf 处理未知数据:由于该方法会将
NaN全部丢失且时间复杂度高,已不适应现代大型 Web 应用程序,切勿在涉及浮点运算或数据采集清洗时使用。 - 超大数据量处理:当数组条目达到数万乃至数十万级别时,必须严格选用时间复杂度为 O(n) 的
Set或Map方案,坚决规避导致主线程卡顿的 O(n²) 双重循环。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章