
详细解析JavaScript中parentNode与parentElement的本质区别,通过DOM继承体系、属性推导步骤与典型边界场景代码验证,讲清两者在日常开发中的选型建议。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS中parentNode与parentElement有什么区别
作者:白露
时间:2026-11-18
浏览:90
文章目录
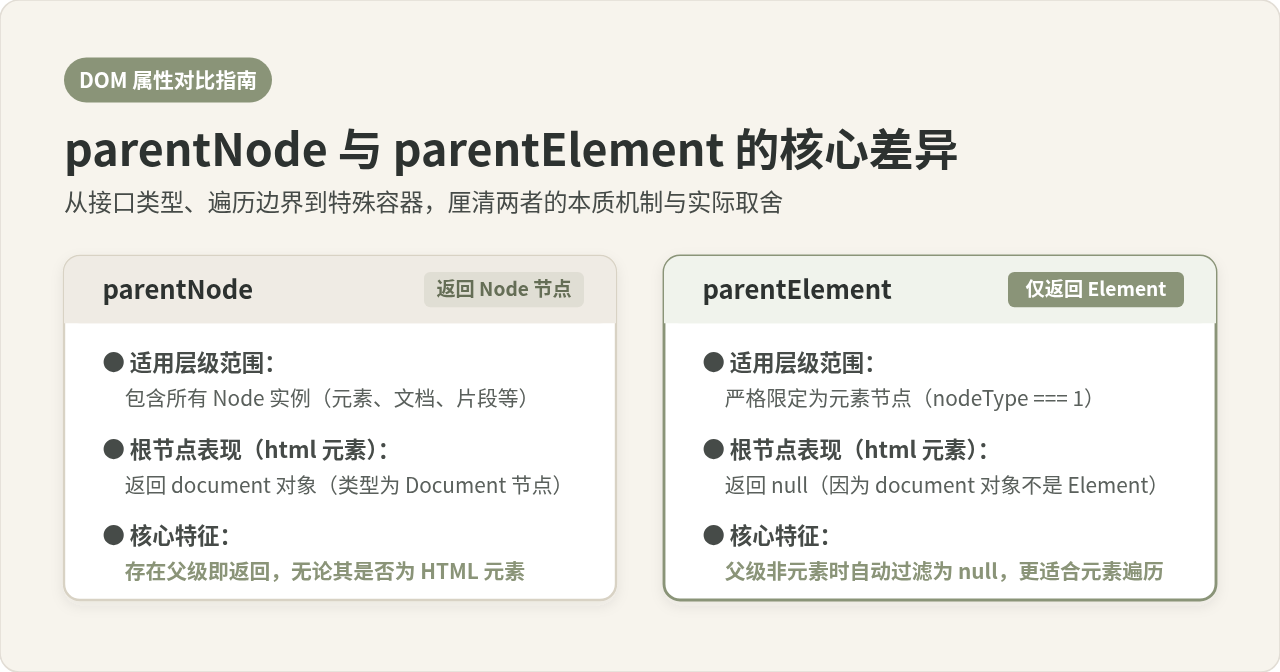
在 JavaScript 的 DOM 树遍历中,parentNode 与 parentElement 最核心的区别在于返回值类型的约束范围:parentNode 返回当前节点的直接父级节点(Node),只要该节点在树中存在父层级(无论是常规元素、顶层文档 Document,还是内存中的 DocumentFragment),都会原样返回;而 parentElement 仅在父级是元素节点(Element,即 nodeType === 1)时才返回该元素对象,若父级不是元素(例如父级为 document 对象),或者当前节点未接入 DOM 树,则返回 null。对于日常位于 <body> 内的大多数标准 HTML 元素,两者的返回值完全相等,其真正差异主要体现在根节点、文档片段和循环向上查找的终止条件上。
一、Node 与 Element 的继承体系与接口归属
要透彻理解这两个属性的差别,首先需要明确 DOM 规范中 Node(节点)与 Element(元素)的关系。在 W3C DOM 标准中,文档内的所有内容都由节点构成。Node 是最顶层的通用基类接口之一,派生出了多种具体的节点类型;而 Element 只是 Node 的一个专门子类,特指带有标签名、属性和开始/闭合标签的 HTML 或 XML 元素。
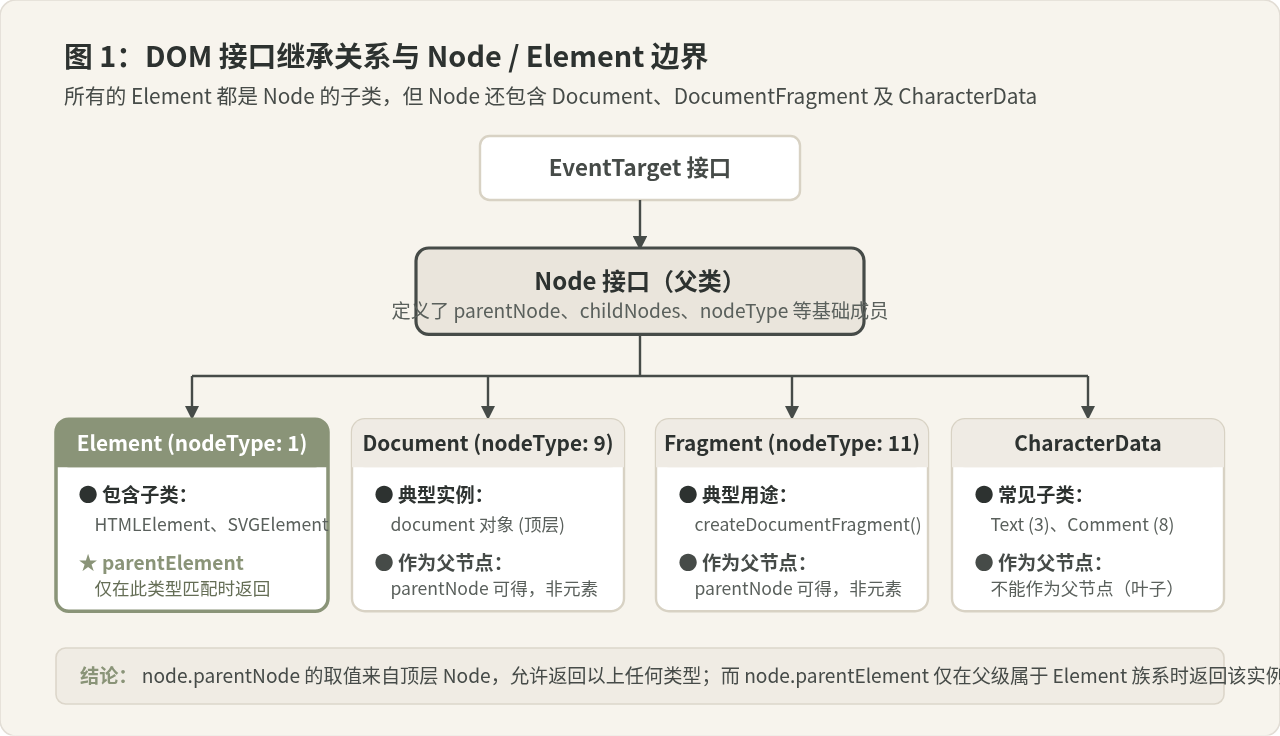
从接口规范与历史演进来看:
parentNode定义在Node接口上。由于所有的 DOM 对象(包括 Document、DocumentFragment、Element、Text 文本节点、Comment 注释等)都继承自Node,因此每个节点实例天生都拥有parentNode属性。它的返回值声明为Node | null。parentElement最初是 Internet Explorer 为便于直接获取父级 HTML 元素而引入的专有属性,后来由于其实用性被纳入了 W3C 的 Element 遍历标准规范(Element Traversal Specification),并在现代浏览器中全面实现。它的返回值声明严格为Element | null。
这意味着:所有的 Element 都是 Node,但并非所有的 Node 都是 Element。当一个节点的父级恰好不是 Element 时,两个属性便给出了不同的回应。
二、为什么绝大多数常规场景下两者完全相同?
在日常业务开发中,开发者操作的大多数节点都位于 <body> 容器内部。例如下面这段典型的 HTML 片段:
<div id="container" class="box">
  <p id="target">这是一段示例文本</p>
</div>
在控制台中获取 #target 并读取它的父级:
const target = document.getElementById('target');

console.log(target.parentNode);    // <div id="container" class="box">
console.log(target.parentElement); // <div id="container" class="box">
console.log(target.parentNode === target.parentElement); // true
因为 #target 的直接父级是 <div id="container">,这个父级既是一个 Node,同时也是一个标准 Element(其 nodeType 值为 1)。因此无论是 parentNode 还是 parentElement,返回的都是内存中同一个 HTMLDivElement 对象的引用,严格全等运算结果为 true。
常见说法辨析:有观点认为“parentElement 比 parentNode 执行更快,应该在所有地方完全取代 parentNode”。
这种说法看似合理,主要是因为日常业务代码中操作的几乎全是 HTML 元素,使用 parentElement 能让返回值的类型提示更直接收窄为 Element。但在现代 JavaScript 引擎的底层实现中,两者只是在读取父指针后做了一次微秒级不到的类型标志位校验,性能差别完全可以忽略不计。两者的取舍应当基于语义需求与边界预期,而非无根据的性能执念。
三、属性求值逻辑与两者的执行推导过程
当开发者在脚本中访问这两个属性时,浏览器引擎内部的判断路径存在明确的分支流程。通过流程图可以清晰梳理从读取属性到获得最终返回值的步骤:
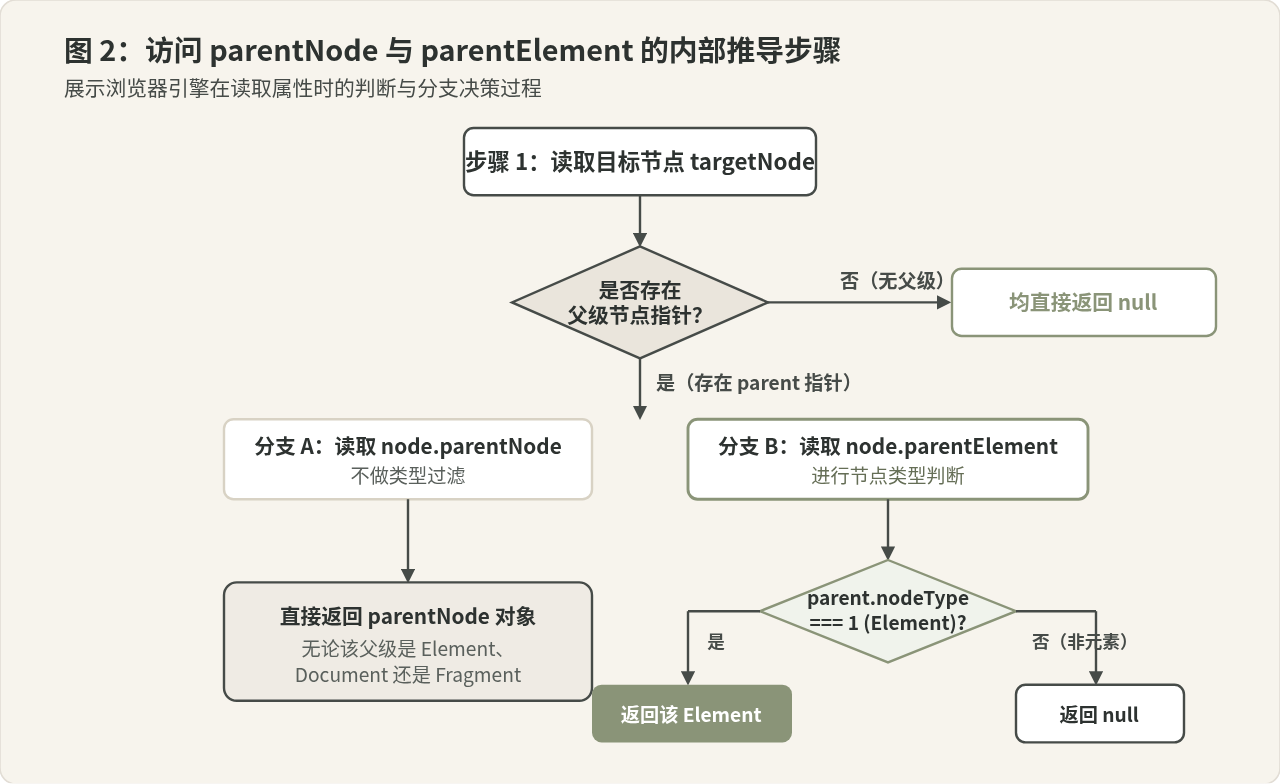
从推导流程可以看出,关键分水岭在于步骤 3 中的类型拦截:parentNode 只要发现父指针非空就直接交出该节点;而 parentElement 必须额外审查目标父节点的 nodeType 是否等于 1(即 Node.ELEMENT_NODE)。如果不等于 1,则将其丢弃并直接回退为 null。
四、出现分歧的核心边界场景与代码验证
理解了上述拦截机制后,我们可以通过两个最具代表性的边界场景,观察两者行为的真正分歧。
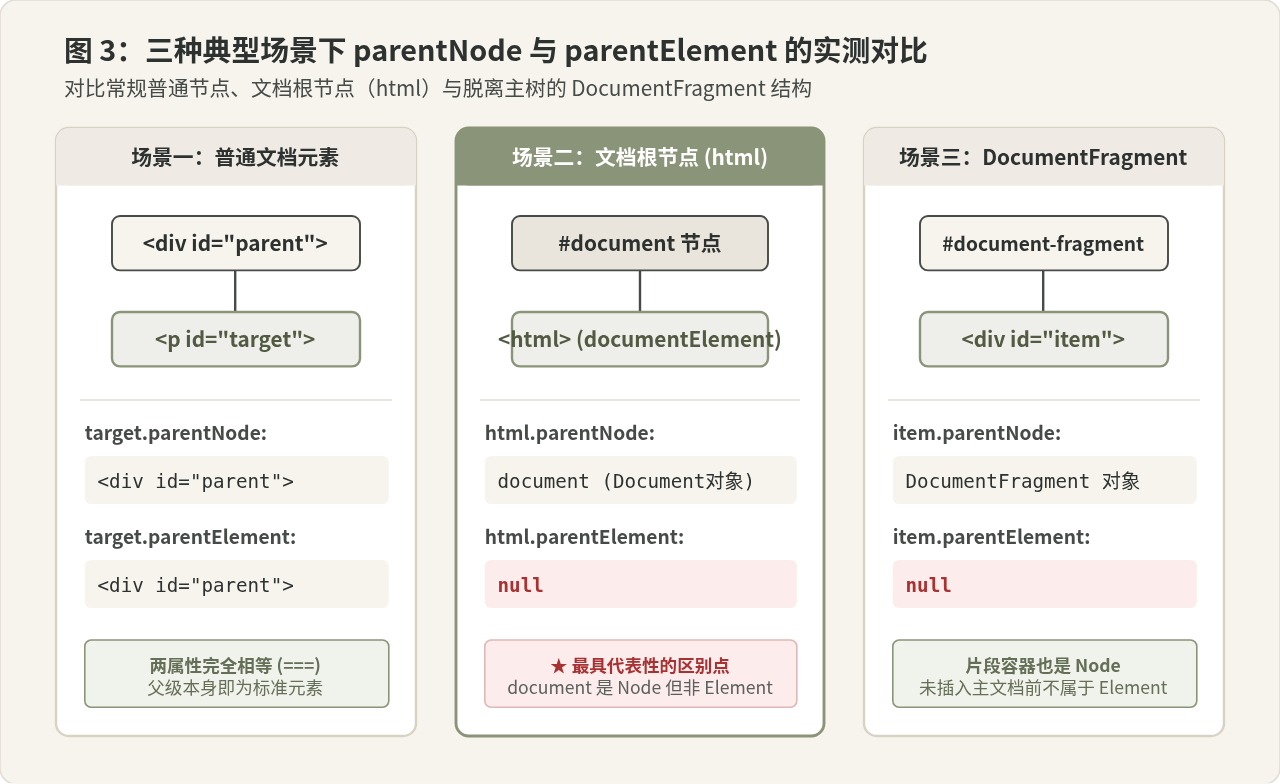
1. 文档根元素 <html>(最关键区别点)
在网页中,document.documentElement 指向的就是页面最顶层的 <html> 标签。根据 DOM 树规定,<html> 节点的父节点是全局 document 对象:
const html = document.documentElement;

// 读取 parentNode
console.log(html.parentNode);
// 输出: #document(HTMLDocument 实例,nodeType 为 9)

// 读取 parentElement
console.log(html.parentElement);
// 输出: null原因非常明确:document 对象继承自 Node,因此它是一个合法的父节点,html.parentNode 成功拿到了 document;但 document 是全局文档对象,不是由 HTML 标签生成的 Element(其 nodeType 为 9 而非 1),因此 html.parentElement 在类型校验未通过时返回了 null。
2. 内存文档片段 DocumentFragment
在前端性能优化或组件模板渲染中,经常使用 document.createDocumentFragment() 来创建离线临时容器以批量插入节点:
const fragment = document.createDocumentFragment();
const item = document.createElement('div');
item.id = 'temp-node';
fragment.appendChild(item);

// 此时 item 尚未挂载到真实的页面 DOM 树中
console.log(item.parentNode);    // #document-fragment(DocumentFragment 实例)
console.log(item.parentElement); // null
DocumentFragment 的 nodeType 为 11,它是一个轻量的节点容器,同样不是 Element。因此子元素 item 的 parentNode 能够正确追溯到所在的片段容器,而 parentElement 则返回 null。
3. 未挂载的游离节点与 document 自身
刚用 document.createElement() 新建且尚未被 appendChild 或 insertBefore 挂载的游离节点,以及 document 对象本身,由于根本没有上层父指针,因此两者的返回值一致为 null:
const span = document.createElement('span');
console.log(span.parentNode);    // null
console.log(span.parentElement); // null

console.log(document.parentNode);    // null
console.log(document.parentElement); // null
五、循环向上查找祖先时的安全性差异
在实现自定义的祖先元素检索逻辑(例如在没有 Element.prototype.closest 的旧环境,或需要匹配特殊条件向上回溯)时,选择哪个属性会对循环的退出机制产生直接影响。
请看下面使用 parentNode 遍历的潜在隐患示例:
// 存在类型隐患的向上查找代码
function findAncestorClassBuggy(node, className) {
  let current = node;
  while (current) {
    // 当 current 遍历到 document 时,调用 getAttribute 或 classList 会抛出异常!
    if (current.classList && current.classList.contains(className)) {
      return current;
    }
    current = current.parentNode; // 最终会赋值为 document,然后再赋为 null
  }
  return null;
}
在上面的循环中,当遍历到 <html> 后,下一轮 current 会变成 document。虽然 document 对象不会立即导致循环中断,但 document 上并没有 classList 或标准的元素属性。如果在循环内部直接调用 current.getAttribute(...) 或 current.matches(...),程序就会在最后一次迭代时抛出 TypeError: current.getAttribute is not a function。
如果改用 parentElement,代码天然更加安全:
// 推荐的安全写法
function findAncestorClassSafe(element, className) {
  let current = element;
  while (current) {
    // 循环中的 current 保证 100% 是 Element 实例,所有元素方法均可安全调用
    if (current.classList.contains(className)) {
      return current;
    }
    current = current.parentElement; // 到达 <html> 后的下一个值为 null,自然安全退出
  }
  return null;
}
因为 html.parentElement 为 null,循环在离开 <html> 后便立即自然终止,遍历范围被严格限定在可见的元素树内部,杜绝了意外触碰 document 对象的可能。
六、特性速查与实际选型建议
结合前面的机制分析与代码验证,我们可以将两者的全部特性归纳为以下决策矩阵:
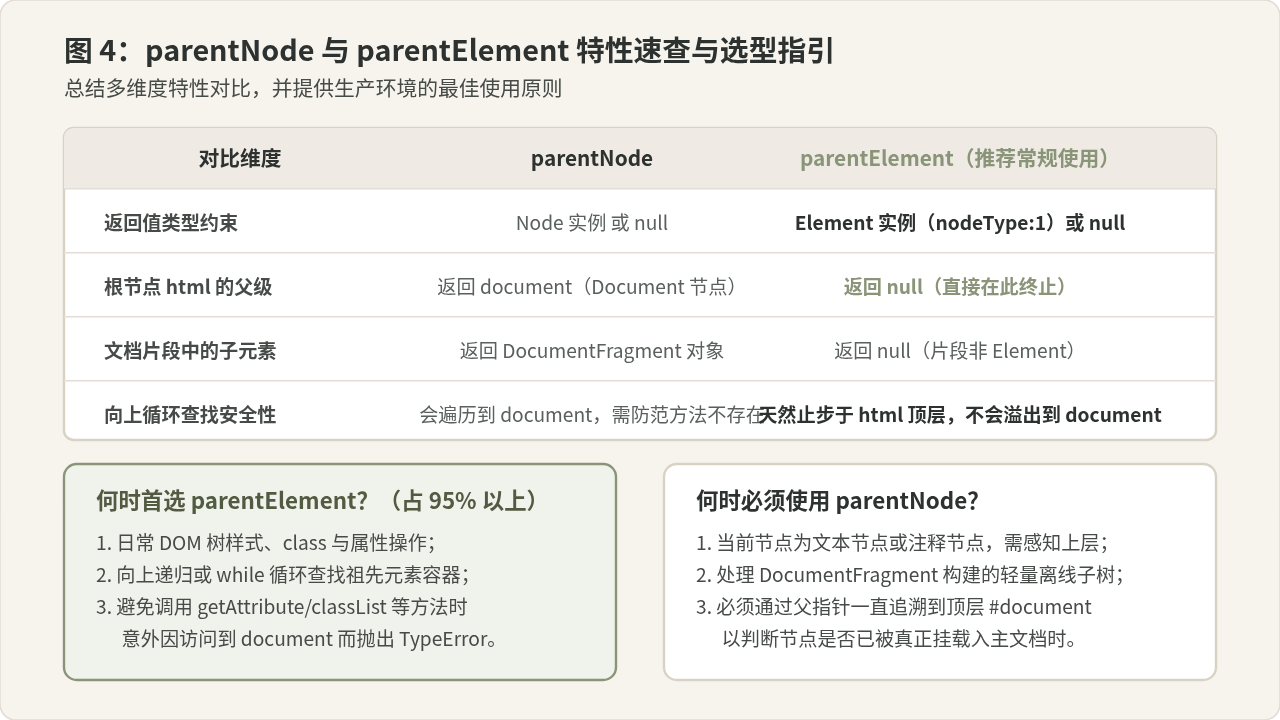
在实际编码中,可以遵循以下原则来做出合理的选择:
- 优先选用
parentElement的场景(日常开发的 95% 以上):在处理点击事件冒泡回溯、查找父级容器、读取或修改父级 CSS 样式与类名等操作时,首选parentElement。它不仅在语义上准确表达了“我要找的是父级元素”,还能天然在根元素处止步,避免类型越界错误。 - 必须使用
parentNode的场景:- 非元素节点的父级定位:需要从某个
Text(文本节点)或Comment(注释节点)出发获取其所依附的父级结构时。 - 处理离线片段:在复杂的 DOM 操作中,子元素被暂时包裹在
DocumentFragment中,需要感知和操作该片段容器时。 - 全链路挂载检查:需要编写通用工具函数,通过不断沿着
parentNode递归向上回溯直到#document,以严格判断一个节点当前是否已真实挂载到页面主文档中时。
- 非元素节点的父级定位:需要从某个
总结而言,parentNode 体现的是 DOM 树通用的节点拓扑关系,而 parentElement 则是面向页面元素逻辑的实用约束。根据操作对象的类型边界选择对应属性,既能写出语义清晰的代码,也能从根本上规避边界场景下的类型异常。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章