
深入讲解JavaScript合并数组并去重的工程化最佳实践,剖析基础数据类型与对象数组在去重机制、时间复杂度与内存模型上的核心差异,提供健壮且高性能的代码实现。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS合并数组并去重的最佳实践
作者:半夏
时间:2026-11-18
浏览:563
文章目录
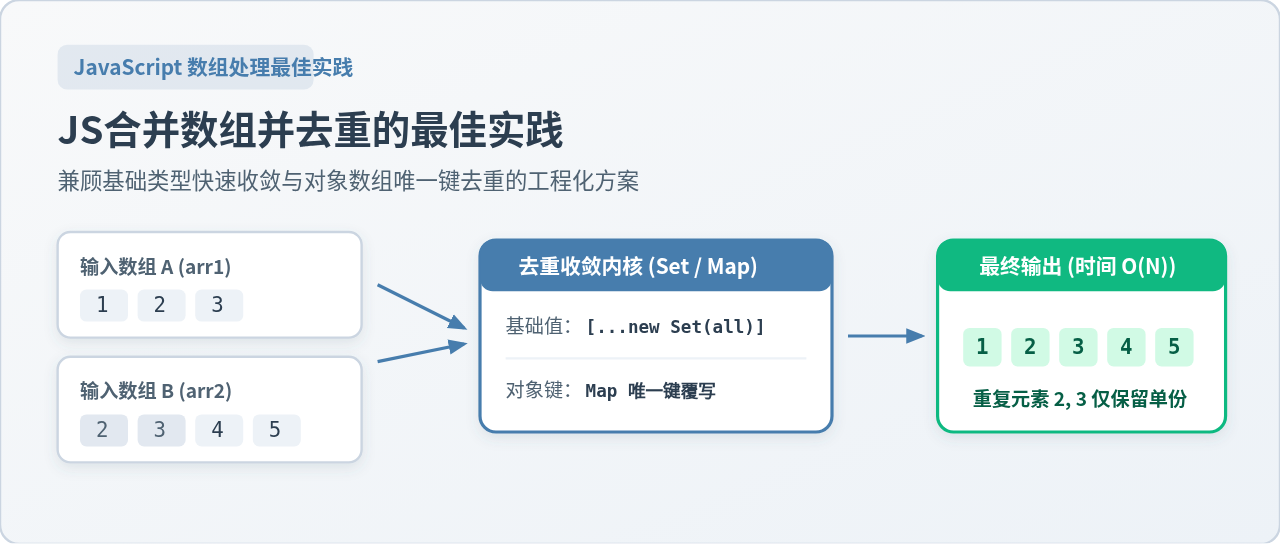
在 JavaScript 开发中,数组合并与去重的核心在于区分基础数据类型(原始值)与引用数据类型(对象)。对于数字、字符串等原始类型,使用 [...new Set([...arr1, ...arr2])] 是兼顾语法简洁与线性执行效率的标准方案;而对于包含业务对象的数组,由于对象在内存中按引用比较,直接使用 Set 无法去重,必须依据业务唯一键(如 id),借助 Map 结构在 O(N) 时间复杂度内完成合并与去重。本文将针对这两种场景分别提供清晰可行的代码实现与选型依据。
基础类型数组:基于 Set 的高效解法
处理由数字、字符串、布尔值等基本类型构成的数组时,最常见且效率最高的方式是组合使用 ES6 的扩展运算符(Spread Syntax)与 Set 集合对象。
// 基础数据类型数组合并与去重示例
const arr1 = [1, 2, 3, 4];
const arr2 = [3, 4, 5, 6];

// 执行合并与去重
const result = [...new Set([...arr1, ...arr2])];

console.log(result);
// 示例输出: [1, 2, 3, 4, 5, 6]上述代码的执行分为清晰的三阶段:首先,[...arr1, ...arr2] 通过迭代器依次读取两个原数组中的所有项,拼装出一个包含重复项的完整扁平过渡数组;接着,该数组作为参数传入 new Set(...) 构造函数,Set 内部利用哈希表机制,遍历传入的数据并在常数时间 O(1) 内检测元素是否已存在;最后,外层的扩展运算符将 Set 实例中已去重的项解构到全新的普通数组中。
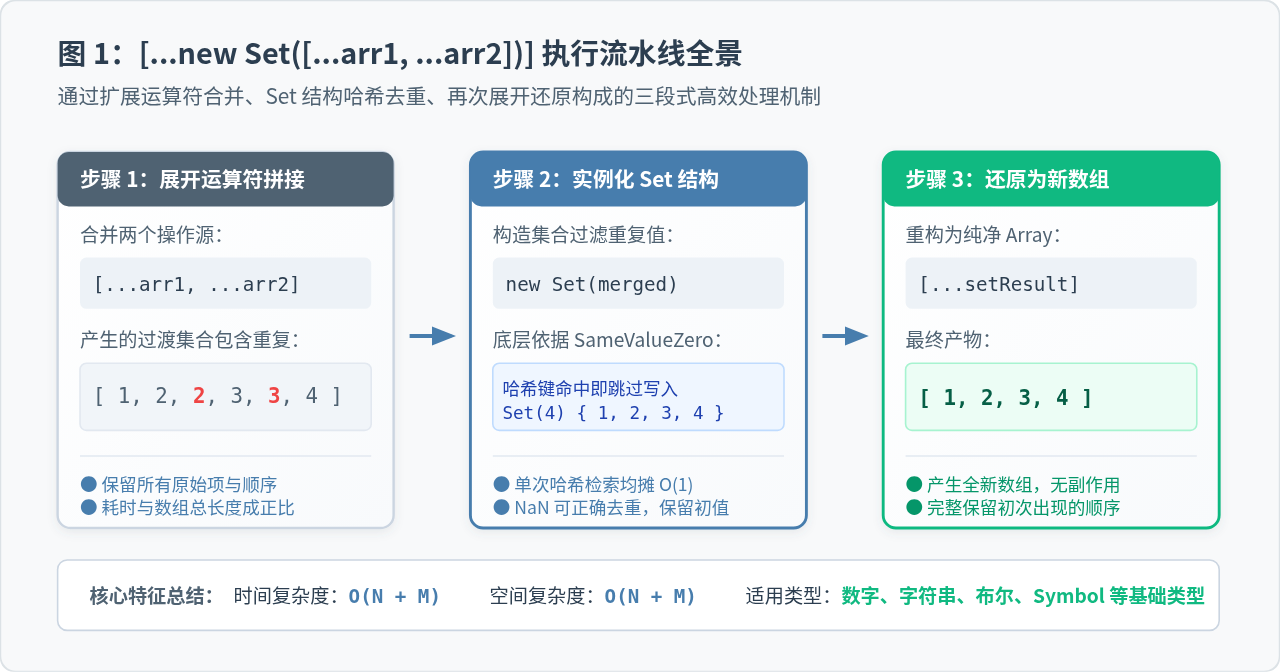
这套方案的时间复杂度为 O(N + M)(其中 N 和 M 分别为两个数组的长度),空间复杂度同为 O(N + M)。更重要的是,它不会修改原数组 arr1 与 arr2,符合纯函数无副作用的设计要求。此外,Set 内部的比较算法遵循 ECMAScript 规范中的 SameValueZero,它能够正确将数组中出现的多个 NaN 判定为相同值并成功去重,同时将 +0 与 -0 视作相等。
必须避开的传统嵌套循环陷阱
在早期的 JavaScript 开发中,常有人通过 concat() 拼接数组后,配合 filter() 与 indexOf() 进行去重:
// 存在严重性能缺陷的反面模式,不建议在实际项目中使用
const inefficientMerge = (a, b) => {
  const combined = a.concat(b);
  return combined.filter((item, index) => combined.indexOf(item) === index);
};这种写法的严重缺陷在于算法的时间复杂度。filter 本身进行一次全量遍历(耗时 O(N)),但在每一次回调中调用的 indexOf(item) 又会对数组进行一次线性搜索(耗时 O(N))。两层循环嵌套使得整体时间复杂度骤升为 O(N²)。当数组总长度达到 10 万条时,Set 方案仅需十几毫秒即可完成,而双重循环方案则可能需要耗费数秒甚至导致浏览器界面无响应。因此,凡涉及基础类型去重,均应坚决弃用 indexOf 或 includes 的嵌套循环。
引用类型陷阱:为什么 Set 无法直接去重对象数组?
许多初学者尝试直接对对象数组使用 [...new Set([...arr1, ...arr2])],却发现包含完全相同属性的对象并未被剔除:
const users1 = [{ id: 1, name: '张三' }];
const users2 = [{ id: 1, name: '张三' }];

const merged = [...new Set([...users1, ...users2])];
console.log(merged.length);
// 示例输出: 2 (去重未生效,两项均被保留)
这一现象的根本原因在于 JavaScript 的数据存储机制。对象属于引用数据类型,变量中保存的实际上是指向堆内存区域的引用地址。在上面的示例中,字面量形式创建的两个对象分别开辟了独立的堆内存空间,其指针地址(例如 0x00A1 与 0x00B2)完全不同。在 SameValueZero 判定中,不同的引用指针被直接判定为不相等,因此 Set 会将它们作为两个完全独立的值全部保留。
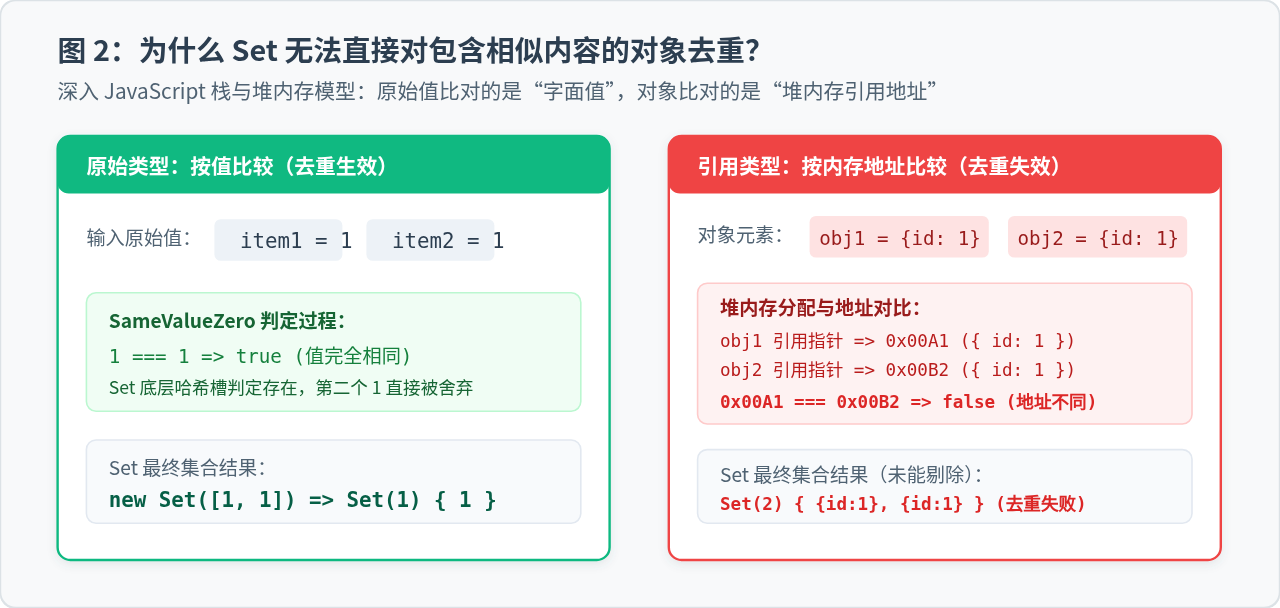
注意事项:只有当两个元素引用的是完全相同的对象实例(即内存指针完全一致)时,
Set 才能识别去重。但在实际业务中,不同接口或不同批次返回的数据即使业务标识相同,也是不同的对象实例,必须显式提取主键进行去重。
对象数组去重最佳实践:基于 Map 的唯一键索引法
针对对象数组的合并与去重,工业界标准的做法是以对象的唯一标识(如 id、code 等属性)为 Key,利用 ES6 Map 的键唯一性在 O(N) 线性时间内完成筛选。
场景 A:后出现的对象覆盖先出现的对象(更新模式)
在合并列表时,如果希望后一个数组中的数据覆盖前一个数组中对应 id 的旧数据,可以直接利用 Map.prototype.set() 会自动更新相同 Key 对应值的特性:
// 场景 A: 后项覆盖前项
const listA = [
  { id: 1, name: '项目 Alpha', version: 'v1.0' },
  { id: 2, name: '项目 Beta', version: 'v1.0' }
];

const listB = [
  { id: 2, name: '项目 Beta', version: 'v2.0' }, // 具有相同 id,但版本已更新
  { id: 3, name: '项目 Gamma', version: 'v1.0' }
];

function mergeObjectsOverwrite(arr1, arr2, key = 'id') {
  const map = new Map();
  // 依次遍历两个数组的所有项并压入 Map
  [...arr1, ...arr2].forEach(item => {
    if (item && typeof item === 'object') {
      map.set(item[key], item);
    }
  });
  return Array.from(map.values());
}

const mergedList = mergeObjectsOverwrite(listA, listB, 'id');
console.log(mergedList);
/* 示例输出:
[
  { id: 1, name: '项目 Alpha', version: 'v1.0' },
  { id: 2, name: '项目 Beta', version: 'v2.0' }, // 已成功覆盖为最新的 v2.0
  { id: 3, name: '项目 Gamma', version: 'v1.0' }
]
*/
场景 B:优先保留首次出现的对象(锁定初值模式)
如果业务要求以先到达的数据为准,后续出现的相同 id 对象一律丢弃,则只需要在写入 Map 前加入 has() 检查:
// 场景 B: 优先保留首次出现的对象
function mergeObjectsKeepFirst(arr1, arr2, key = 'id') {
  const map = new Map();
  for (const item of [...arr1, ...arr2]) {
    if (item && !map.has(item[key])) {
      map.set(item[key], item);
    }
  }
  return Array.from(map.values());
}

const preservedList = mergeObjectsKeepFirst(listA, listB, 'id');
console.log(preservedList[1].version);
// 示例输出: "v1.0" (保留了 listA 中先出现的初始版本)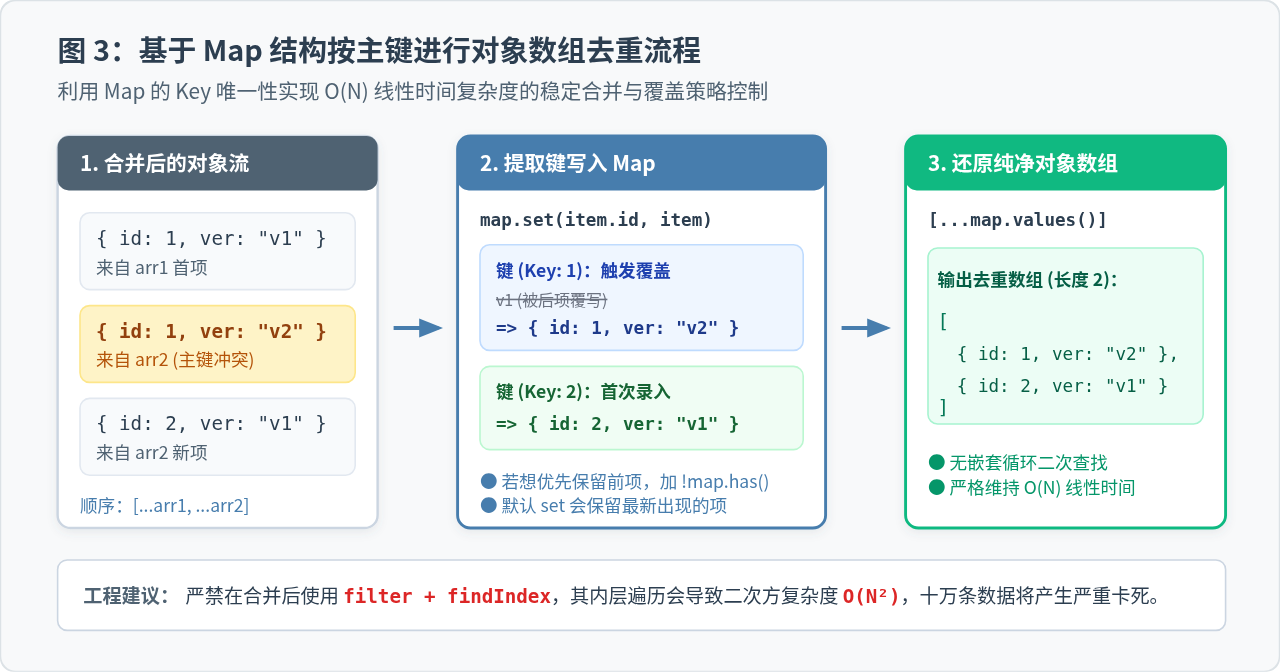
基于 Map 的方案之所以被称为最佳实践,是因为 map.set() 与 map.has() 的操作均摊复杂度均为 O(1)。对整个数组单次遍历即可完成去重,无论数据量是 100 条还是 10 万条,耗时都能保持与总数据量成正比的平稳线性表现。
复杂业务场景:复合键与非扁平结构去重
在某些更复杂的数据结构中,唯一性可能由多个属性共同决定,例如“分类 ID + 用户 ID”。此时可以借助模板字符串生成复合序列化 Key,继续复用 Map 方案:
// 基于多字段复合键去重
const records1 = [
  { categoryId: 101, userId: 1, role: 'admin' },
  { categoryId: 102, userId: 2, role: 'member' }
];

const records2 = [
  { categoryId: 101, userId: 1, role: 'superAdmin' }, // 复合键相同
  { categoryId: 103, userId: 1, role: 'guest' }        // categoryId 不同,属于有效新记录
];

function mergeByCompositeKey(arr1, arr2, getKeyFn) {
  const map = new Map();
  for (const item of [...arr1, ...arr2]) {
    const compositeKey = getKeyFn(item);
    map.set(compositeKey, item);
  }
  return Array.from(map.values());
}

// 传入复合键生成函数
const finalRecords = mergeByCompositeKey(
  records1,
  records2,
  item => `${item.categoryId}_${item.userId}`
);

console.log(finalRecords.length);
// 示例输出: 3 (成功按复合字段维度识别并去重)
综合对比与选型指南
为了让不同场景下的选型更加明确,下表整理了常见数组合并去重方案的核心指标:
| 实现方案 | 适用数据类型 | 时间复杂度 | 空间复杂度 | 选型建议 |
|---|---|---|---|---|
[...new Set([...a, ...b])] |
基础类型(数字/字符串等) | O(N + M) |
O(N + M) |
首选。代码极简,原生支持良好。 |
Map 键索引法 |
对象数组(按 ID 等单键/复合键) | O(N + M) |
O(N + M) |
首选。线性耗时,可自由控制覆盖规则。 |
filter + findIndex / indexOf |
通用 | O((N + M)²) |
O(1) |
坚决避免。大数据量下容易造成主线程卡死。 |
reduce + includes |
基础类型 | O((N + M)²) |
O(N + M) |
不推荐。同样存在嵌套线性遍历问题。 |
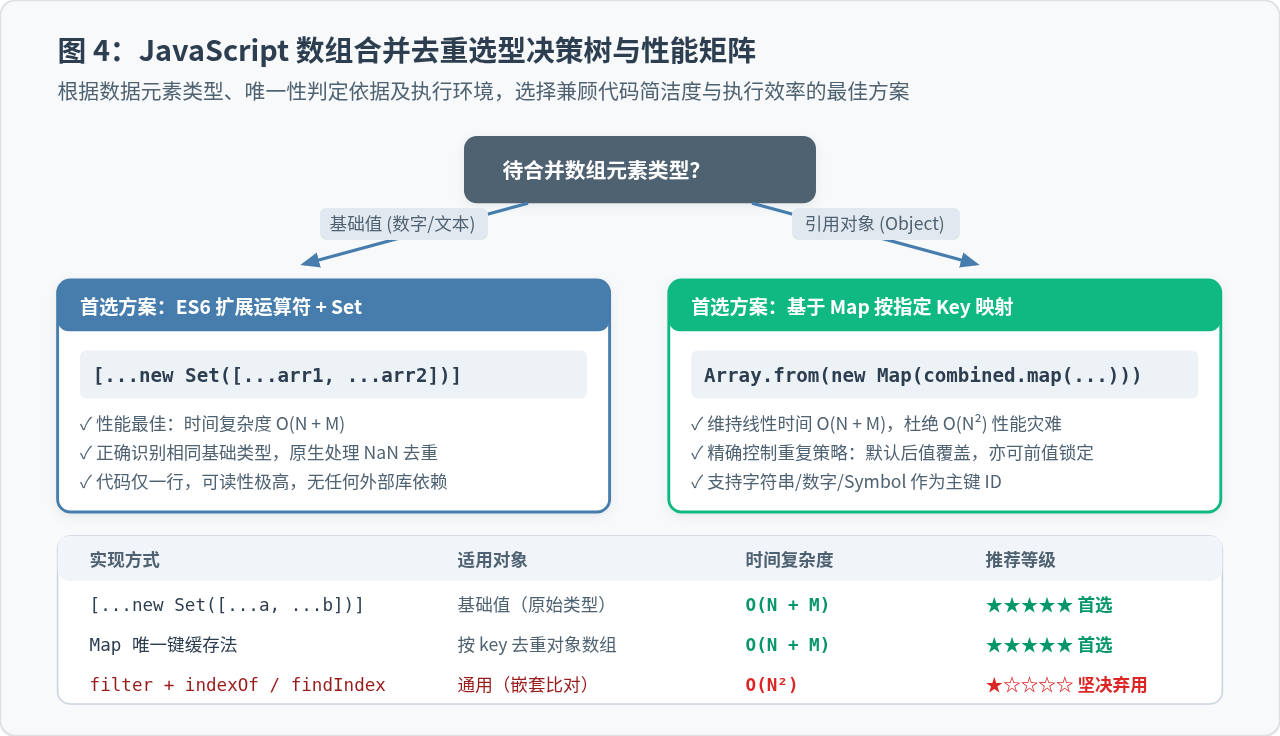
总结而言,在日常 JavaScript 工程开发中,面对数组合并与去重需求,应当养成“先判别数据类型,再选定专属数据结构”的习惯:遇到基础类型直接使用 Set,遇到对象数组果断选择 Map 配合主键索引。这种明确的技术路径不仅能保证业务逻辑的严谨性,更能为大型应用的大数据量运算筑牢性能防线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章