
在JavaScript中处理包含重复值的树形结构,通过深度优先遍历与回溯算法完整收集所有目标节点的根到叶路径,并对比DFS与BFS的内存和性能差异。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript处理树中重复值:返回所有匹配节点的路径集合
作者:半夏
时间:2026-11-16
浏览:660
文章目录
在前端与 Node.js 业务开发中,组织架构树、级联类目选择器、权限菜单以及多级文档目录等数据大都以树形结构存在。普通的树查找通常在匹配到第一个符合条件的节点后便立即中断退出;然而在实际工程场景中,树的多个分支下往往会存在同名或同属性值的节点(例如不同分部下均设有“财务组”或“技术研发部”,不同父级目录下存在同名文件或通用标签)。要准确表达每个匹配项在业务层级中的具体隶属关系,就不能仅返回节点自身,而必须对树进行全量遍历,收集从根节点到达每一个匹配节点的完整路径,形成路径集合。
一、问题模型与数据准备
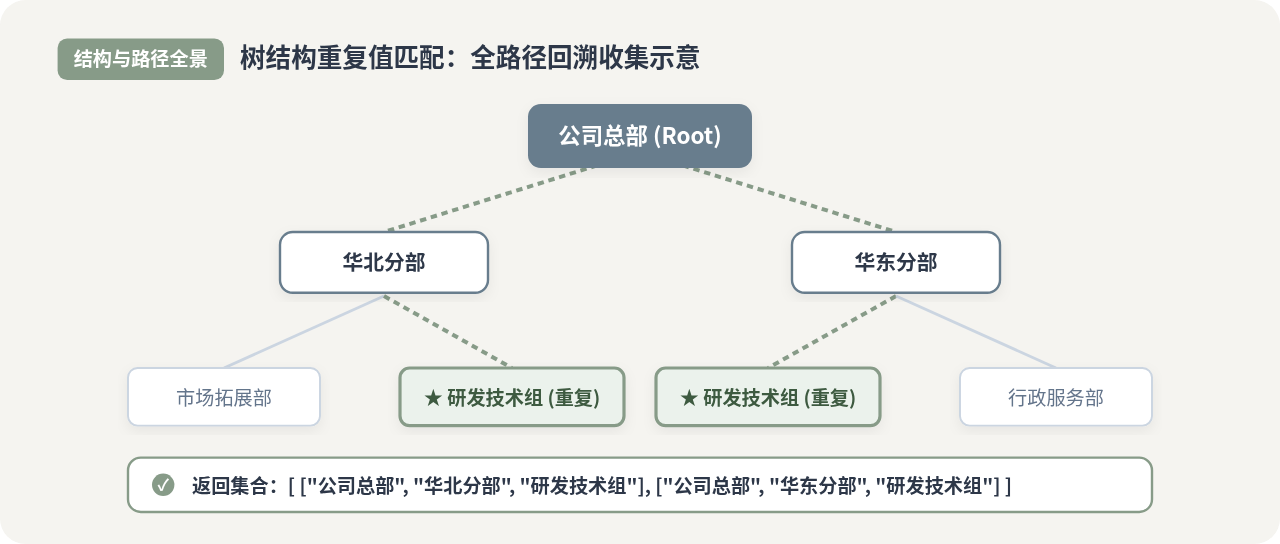
树形结构通常由嵌套的对象及其 children 数组构成。当目标值在树中出现多次时,每一次出现都对应着一条从根节点延伸至该节点的独立探索线。我们可以通过一个典型的企业部门树来直观呈现:
// 示例数据:包含同名重复节点“研发技术组”
const organizationTree = {
  id: 'root',
  name: '公司总部',
  children: [
    {
      id: 'branch-north',
      name: '华北分部',
      children: [
        { id: 'dept-n-market', name: '市场拓展部' },
        { id: 'dept-n-rd', name: '研发技术组' } // 目标节点 (1)
      ]
    },
    {
      id: 'branch-east',
      name: '华东分部',
      children: [
        { id: 'dept-e-rd', name: '研发技术组' }, // 目标节点 (2)
        { id: 'dept-e-admin', name: '行政服务部' }
      ]
    }
  ]
};
对于上述结构,如果我们搜索名称为 "研发技术组" 的节点,期望获得的输出不是单个路径,而是一个二维集合:
[
  ["公司总部", "华北分部", "研发技术组"],
  ["公司总部", "华东分部", "研发技术组"]
]
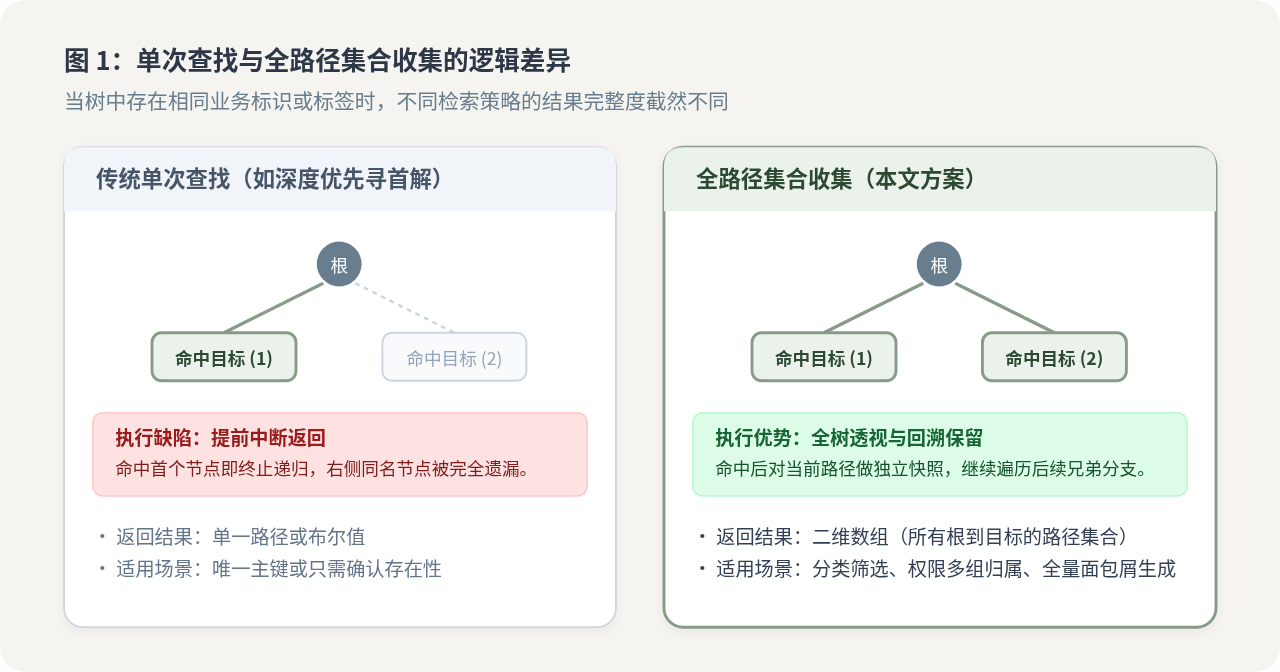
常规的单目标搜索方法在第一次查找到华北分部下的研发技术组后就会直接 return,导致华东分部下的同名节点被静默丢弃。因此,算法必须具备两个核心能力:全分支探查不提前中断,以及动态记录并快照当前回溯路径。
二、核心实现:深度优先遍历(DFS)与回溯收集
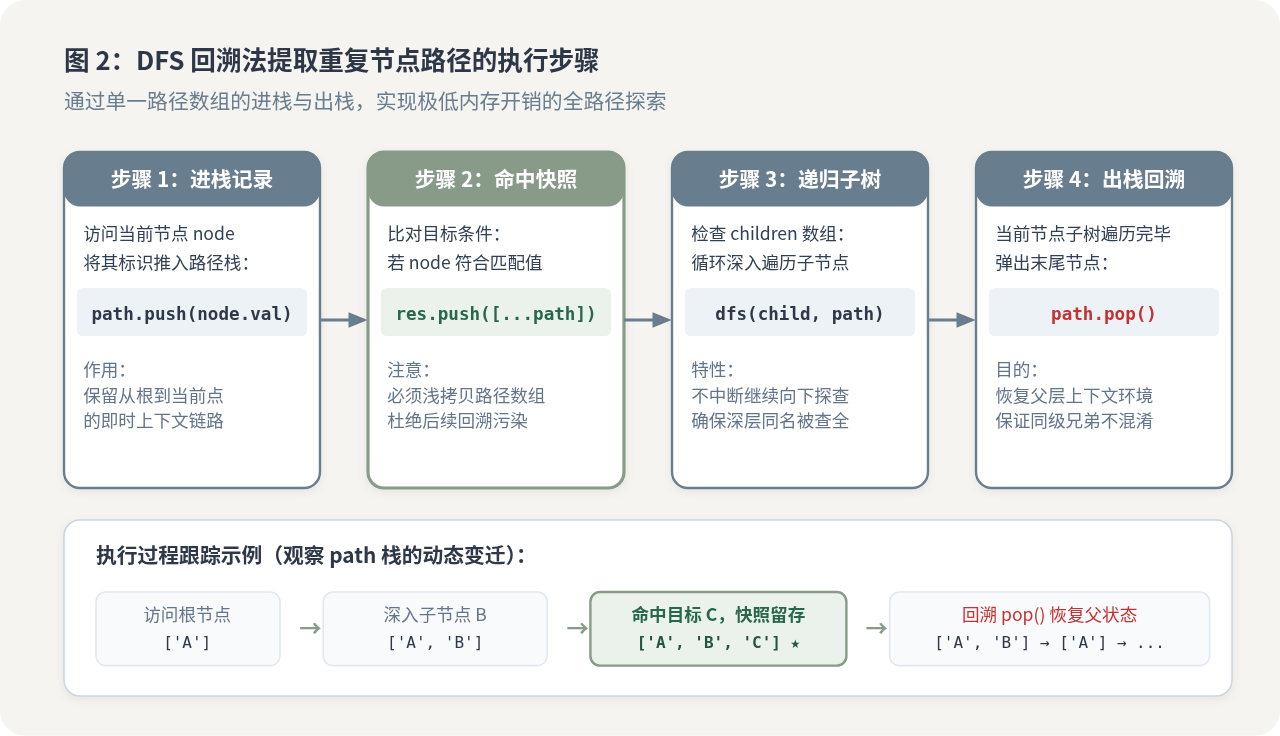
深度优先遍历配合回溯法(Backtracking)是处理树路径收集最经典且内存占用最小的方案。回溯的核心思想在于:在向下探查子节点时将当前节点推入一个维护全局当前位置的路径栈;当深入到某叶子或分支并探索完毕后,退回上一级时必须将当前节点从路径栈中弹出(pop),以保证同一父节点的其他兄弟分支不会受到污染。
实现该算法需要严格遵循以下四个步骤:
- 节点进栈:进入递归函数后,立即将当前节点标识加入
currentPath。 - 条件比对与快照:检查当前节点是否匹配目标条件。若匹配成功,务必使用浅拷贝(如扩展运算符
[...currentPath])将当前路径存入结果集,而不能直接存入currentPath引用。 - 深入子树:如果当前节点包含子节点数组,依次对每个子节点发起子递归调用。
- 出栈回溯:在当前节点及其所有后代均探索完毕后,执行
currentPath.pop(),恢复进入该节点前的路径状态。
下面是完整、可直接在生产环境使用的 JavaScript 函数实现:
/**
 * 遍历树结构,收集所有匹配谓词条件的节点路径集合
 * @param {Object|Array} tree - 根节点对象或多根节点数组
 * @param {Function} predicate - 节点匹配判定函数,入参为 (node) => boolean
 * @param {string} [key='name'] - 路径记录的属性键名(也可传入空表示记录整个节点对象)
 * @returns {Array<Array>} 所有匹配路径组成的二维数组
 */
function findAllPathsDFS(tree, predicate, key = 'name') {
  const results = [];
  const currentPath = [];

  // 内部递归函数
  function backtrack(node) {
    if (!node || typeof node !== 'object') return;

    // 1. 当前节点进栈
    const pathItem = key ? node[key] : node;
    currentPath.push(pathItem);

    // 2. 判定是否匹配目标条件,命中则创建路径快照
    if (predicate(node)) {
      results.push([...currentPath]); // 关键点:浅拷贝,切断后续回溯的引用关联
    }

    // 3. 递归遍历子节点(防御性检查子节点是否为数组)
    if (Array.isArray(node.children) && node.children.length > 0) {
      for (let i = 0; i < node.children.length; i++) {
        backtrack(node.children[i]);
      }
    }

    // 4. 当前节点及后代探索完毕,出栈回溯
    currentPath.pop();
  }

  // 兼容单根对象或森林(数组)结构
  if (Array.isArray(tree)) {
    for (const root of tree) {
      backtrack(root);
    }
  } else {
    backtrack(tree);
  }

  return results;
}

// 验证调用
const matchedPaths = findAllPathsDFS(
  organizationTree,
  (node) => node.name === '研发技术组',
  'name'
);

console.log(matchedPaths);
// 示例输出:
// [
//   [ '公司总部', '华北分部', '研发技术组' ],
//   [ '公司总部', '华东分部', '研发技术组' ]
// ]
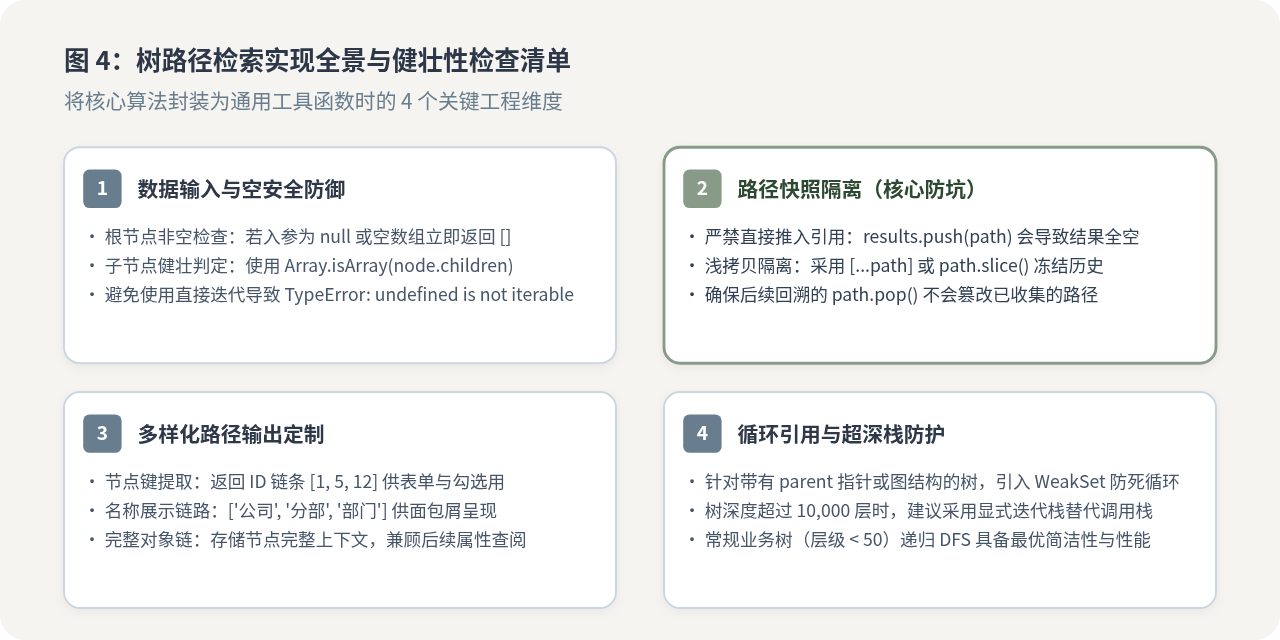
注意避免常见陷阱:第 2 步中必须写成
results.push([...currentPath]) 或 results.push(currentPath.slice())。如果直接写成 results.push(currentPath),推入结果集的只是指向同一个数组的引用。随着后续回溯过程不断执行 pop(),在递归彻底结束时,currentPath 会变回一个空数组 [],最终会导致 results 里的所有项都被清空成 [[], []]。
三、策略对比:DFS 回溯与 BFS 队列传递的关键差异
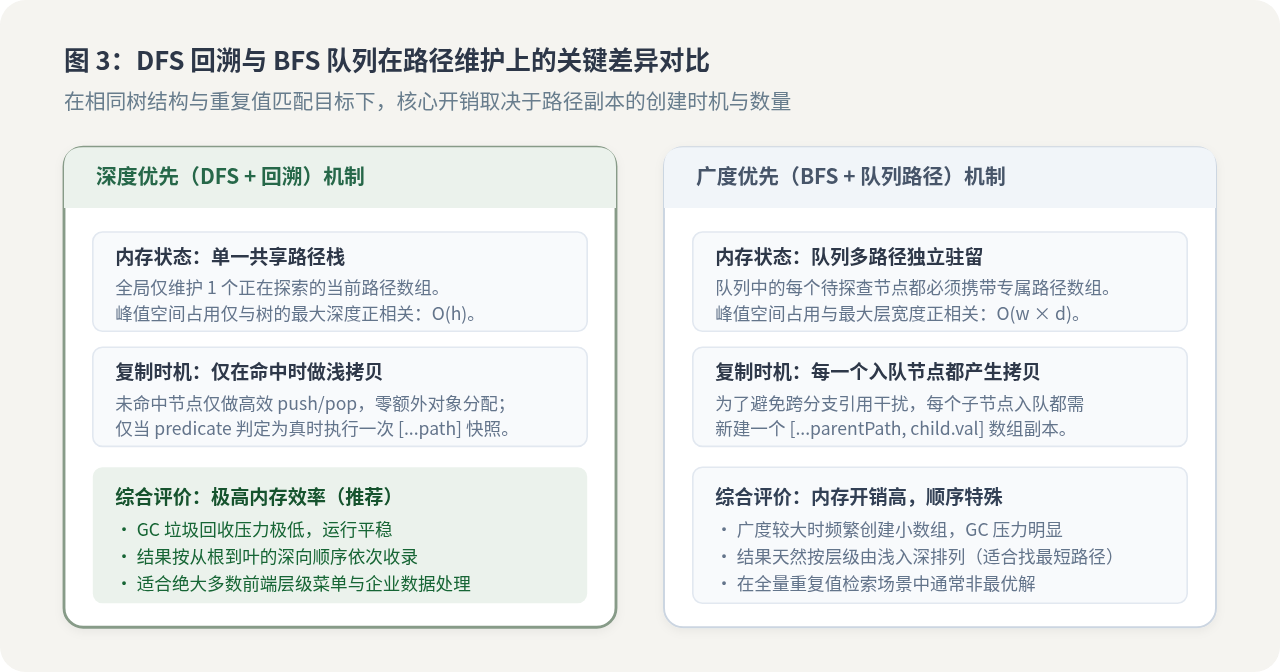
除了深度优先搜索(DFS),很多开发者也熟悉基于队列的广度优先搜索(BFS)。在处理单目标查找时,BFS 能够优先找到层级最浅的节点;但在“全量收集所有重复值路径”的任务下,DFS 回溯法与 BFS 队列传递在机制与内存行为上有着本质区别。
为了直观对比,我们先看 BFS 实现全路径收集时的具体代码:
function findAllPathsBFS(tree, predicate, key = 'name') {
  const results = [];
  if (!tree) return results;

  // 队列元素同时存储当前节点和到达该节点的完整路径副本
  const initialNodes = Array.isArray(tree) ? tree : [tree];
  const queue = initialNodes.map(node => ({
    node,
    path: [key ? node[key] : node]
  }));

  while (queue.length > 0) {
    const { node, path } = queue.shift();

    // 命中目标
    if (predicate(node)) {
      results.push(path);
    }

    // 子节点入队,并复制全新路径数组
    if (Array.isArray(node.children)) {
      for (const child of node.children) {
        queue.push({
          node: child,
          path: [...path, key ? child[key] : child] // 每次入队均创建新数组
        });
      }
    }
  }

  return results;
}
两者的关键差异及其影响
在完全相同的树结构和重复值分布条件下,两者在底层运作上的差异主要体现在以下三个维度:
| 对比维度 | 深度优先(DFS + 回溯) | 广度优先(BFS + 队列) | 对工程实现的影响 |
|---|---|---|---|
| 路径内存占用 | \(O(h)\)(仅取决于树的深度 \(h\)) | \(O(w imes d)\)(取决于树的最大层宽度 \(w\) 与深度 \(d\)) | 大规模树形数据下,BFS 会使内存中同时保留海量未出队的路径副本,易引发内存峰值与频繁 GC。 |
| 数组复制频率 | 仅在命中时复制(按需快照) | 每个节点入队均强制复制 | DFS 在未命中节点上只发生 push 和 pop 原地操作;BFS 在每一个节点入队时都执行扩展复制,耗费额外堆内存。 |
| 结果排列顺序 | 按树分支由深至浅顺序排列 | 按层级由浅入深排列 | 若业务仅需要“距离根节点最近的路径集合”,BFS 具有层次优势;但在全量收集场景下,DFS 的内存收益显著更高。 |
因此,对于“返回所有匹配节点的路径集合”这一特定需求,DFS 回溯机制在计算资源和内存分配上具有压倒性的优势,应作为标准实现首选。
四、工程落地与边界防护
在企业级真实业务项目中,树结构可能来源于不同的第三方 API 或后端数据库,往往伴随着缺省字段、不规范属性甚至环形引用。在将算法封装为通用工具库时,需要做好以下防御性考虑:
1. 输出形式的多样化定制
实际业务对于“路径”的需求各不相同:有时前端 UI 面包屑需要展示节点名称 ['中国', '北京', '海淀'];有时 Ant Design 或 Element Plus 的级联选择器(Cascader)回显需要节点的主键 ID [1, 102, 1024];有时后续计算逻辑需要完整的节点对象链路。我们可以将 key 参数进一步升级为映射函数(selector):
/**
 * 支持自定义映射器的全路径采集器
 */
function findTreePaths(tree, predicate, selector = (node) => node.id) {
  const results = [];
  const currentPath = [];

  function walk(node) {
    if (!node || typeof node !== 'object') return;

    currentPath.push(selector(node));

    if (predicate(node)) {
      results.push([...currentPath]);
    }

    if (Array.isArray(node.children)) {
      for (const child of node.children) {
        walk(child);
      }
    }

    currentPath.pop();
  }

  if (Array.isArray(tree)) {
    tree.forEach(walk);
  } else {
    walk(tree);
  }

  return results;
}
2. 防御异常环形结构(Circular Reference)
纯粹的树结构理论上不存在环形引用(一个节点不可能成为其祖先节点的父级)。但在某些富客户端状态管理或 ORM 关联对象中,子节点可能通过 node.parent 反向引用了父节点,这会导致无保护的递归陷入无限死循环(RangeError: Maximum call stack size exceeded)。通过引入 WeakSet 可以零内存泄漏地实现访问标记:
function findTreePathsSafe(tree, predicate, selector = (node) => node.id) {
  const results = [];
  const currentPath = [];
  const visited = new WeakSet(); // 记录已访问的节点引用

  function walk(node) {
    if (!node || typeof node !== 'object') return;
    if (visited.has(node)) {
      console.warn('检测到循环引用,已跳过该节点探索:', node);
      return;
    }

    visited.add(node);
    currentPath.push(selector(node));

    if (predicate(node)) {
      results.push([...currentPath]);
    }

    if (Array.isArray(node.children)) {
      for (const child of node.children) {
        walk(child);
      }
    }

    currentPath.pop();
  }

  if (Array.isArray(tree)) {
    tree.forEach(walk);
  } else {
    walk(tree);
  }

  return results;
}
五、要点总结
处理树中包含重复值的路径检索,核心在于理解树遍历与状态快照的协同。掌握以下三条原则即可在各类树操作中游刃有余:
- 全覆盖遍历:不同于常规的寻找首个节点,遇到匹配项时只记录快照、不中断递归,确保同名兄弟分支被完整探索。
- 回溯快照隔离:维护单一
currentPath栈,利用push与pop模拟探路与回退;在匹配命中时执行浅拷贝,防止后续回溯修改已有结果。 - 选型优先级:全路径收集场景优先使用 DFS 回溯而非 BFS 队列,将空间复杂度严格控制在与树深度成正比的 \(O(h)\) 范围内,避免高并发与大数据量下的堆内存骤增。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章