
深入解析 JavaScript 中的 String.prototype.localeCompare 方法,讲解本地化字符串排序机制、拼音与笔画排序、自然数字排序配置及高频调用下的性能优化方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript localeCompare方法详解:实现本地化字符串排序
作者:代码拾荒
时间:2026-11-16
浏览:82
文章目录
在 JavaScript 中,直接对字符串数组调用默认的
sort() 方法往往会产生反常识的排列:中文人名顺序错乱、包含数字的编号 file10 排在 file2 前面。这是因为默认排序仅逐位比较字符的 UTF-16 码点数值。要让排序逻辑符合人类语言的真实规范与阅读习惯,核心解决方案是使用 String.prototype.localeCompare()。本文将具体拆解该方法的比对原理、返回值特性、关键配置项,以及在大数据量下的性能进阶方案。
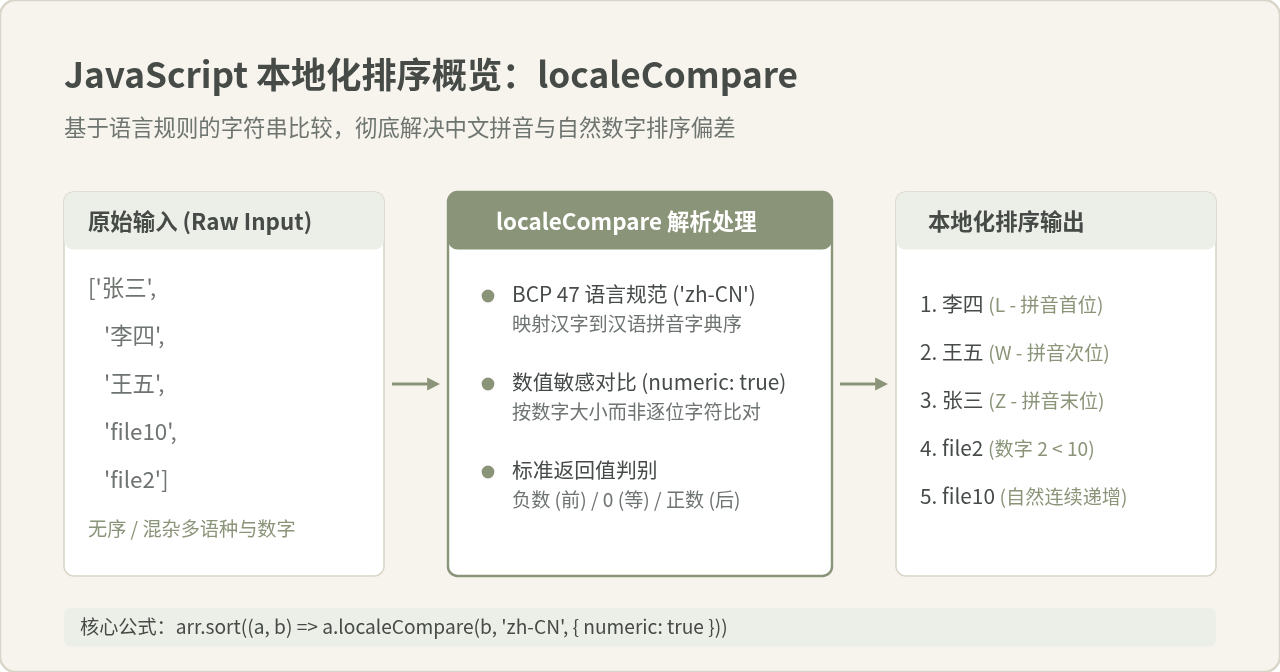
概览:JavaScript localeCompare 本地化排序处理流与应用效果
一、为什么默认排序会失效:码点比较 vs 本地化规则
在不传入任何参数时,JavaScript 的 Array.prototype.sort() 会将所有元素转为字符串,并根据每个字符在 UTF-16 字符集中的码点(Code Point)大小按升序排列。这种机制在处理英文字符或本地语言时会暴露出两个常见问题。
1. 中文字符顺序与拼音完全脱节
例如,我们对包含三个中文姓名的数组进行排序:
// 默认排序示例
const names = ['张三', '李四', '王五'];
names.sort();
console.log(names);
// 示例输出: [ '张三', '李四', '王五' ]按照汉语拼音首字母规则,这三个人名的排序应为:李四(Lǐ,L)→ 王五(Wáng,W)→ 张三(Zhāng,Z)。但默认排序却把“张三”排在首位。其原因在于底层码点数值:
'张'.charCodeAt(0)对应 16 进制0x5F20(十进制 24352)'李'.charCodeAt(0)对应 16 进制0x674E(十进制 26446)'王'.charCodeAt(0)对应 16 进制0x738B(十进制 29579)
由于 24352 < 26446 < 29579,“张”由于在 Unicode 编码表里的位置碰巧靠前,就被排到了最前面。这证明默认的码点排序完全不包含任何人类语言的声韵或字典规则。
2. 数字文件名的逐位截断比对
同样的现象也出现在混合数字的字符串中:
const files = ['file1', 'file10', 'file2'];
files.sort();
console.log(files);
// 示例输出: [ 'file1', 'file10', 'file2' ]
因为字符 '1' 的码点(0x31)小于字符 '2' 的码点(0x32),引擎在比对到第五个字符时直接判定 'file10' < 'file2',导致 10 号文件插在了 1 号与 2 号之间。
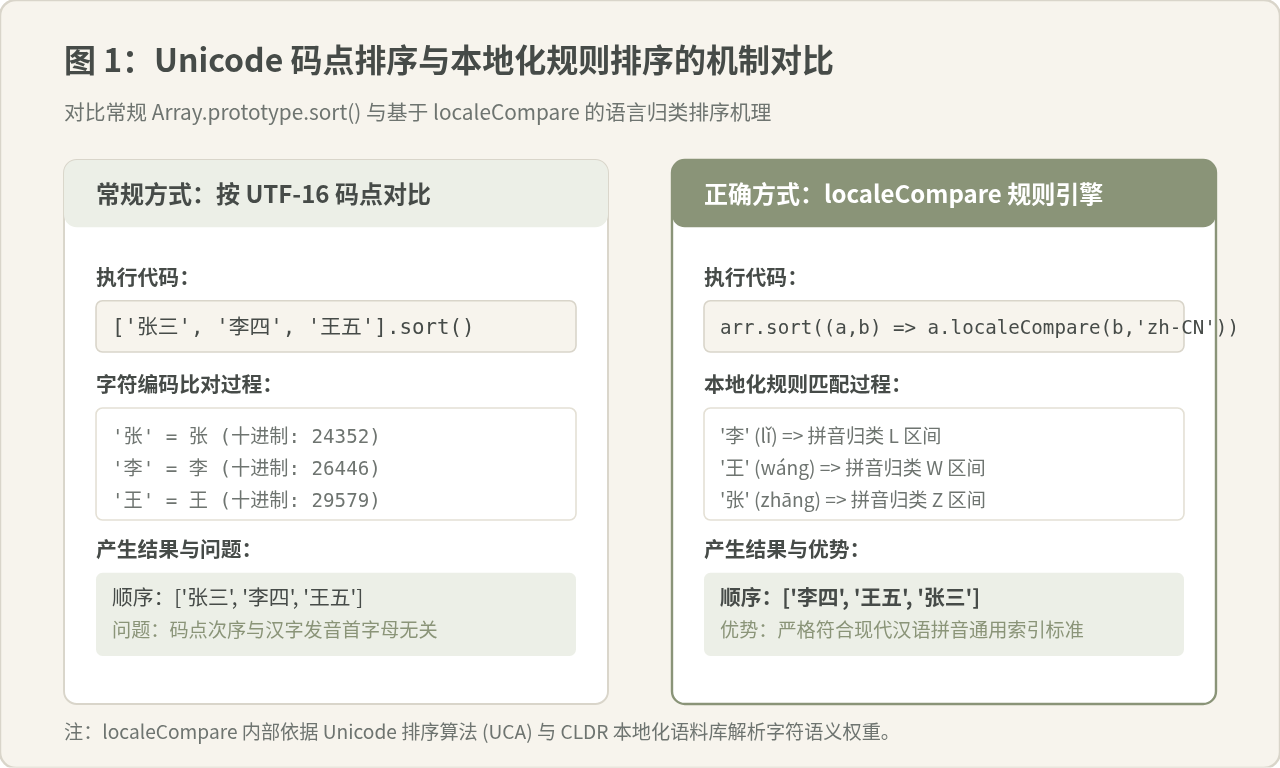
图 1:Unicode 码点排序机制与本地化 Collation 规则引擎的比对
二、localeCompare 方法语法与返回值规范
为了解决上述问题,ECMAScript 标准提供了 localeCompare() 方法,专门依据特定的语言区域习惯(Collation)对两个字符串进行权重比较。
1. 方法基础语法
referenceStr.localeCompare(compareString[, locales[, options]])referenceStr:基准比较字符串。compareString:被比较的字符串目标。locales(可选):符合 BCP 47 标准的语言代码字符串或数组。options(可选):用于调整比对行为的详细配置对象。
2. 常见误区辨析:返回值绝不保证是固定的 -1 和 1
辨析与警示:许多开发者初学时会误以为该方法“小于返回 -1,等于返回 0,大于返回 1”,并写出类似
if (a.localeCompare(b) === -1) 的条件语句。这种写法在实际生产环境中存在潜在缺陷。
根据 ECMAScript 规范定义,localeCompare() 的返回值仅保证三类符号区间:
- 负数(< 0):
referenceStr在语言排序规则中排在compareString之前。 - 零(=== 0):两个字符串在所选排序规则下等价。
- 正数(> 0):
referenceStr在语言排序规则中排在compareString之后。
不同浏览器核心(如 V8、SpiderMonkey、JavaScriptCore)内部实现不同,完全可能返回 -2、2 或其他整数。因此,判断相对次序时必须使用大小关系运算符(< 0 或 > 0)。而这正好与 Array.prototype.sort((a, b) => a.localeCompare(b)) 所需的比较函数签名完美契合。
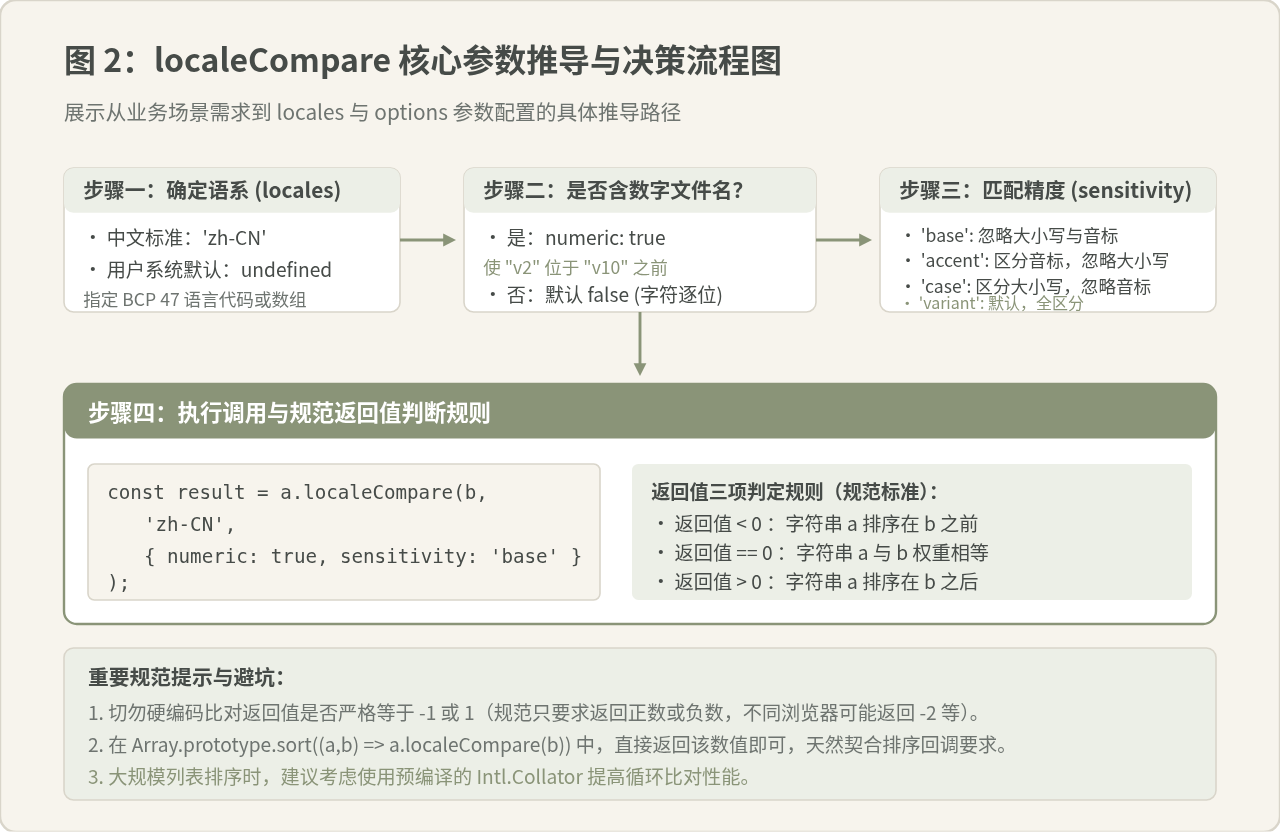
图 2:localeCompare 核心参数推导与决策流程图
三、关键参数配置指南:locales 与 options
1. locales 语言区域设置
locales 参数用来指定排序规则所依据的语言体系。常用的取值包括:
'zh-CN'或'zh-Hans-CN':简体中文(中国大陆),默认以汉语拼音为首要排序依据。'en-US':美式英语字典顺序。undefined:省略时将使用当前运行环境(宿主系统或浏览器)的本地设置。
此外,BCP 47 语言标签支持使用 -u-co- 扩展子标签指定特殊的归类规则,例如:
'zh-Hans-CN-u-co-pinyin':明确指定按拼音顺序排列。'zh-Hans-CN-u-co-stroke':按汉字笔画顺序排列(先少后多,适合正式公文与签到名单)。
2. options 核心选项说明
通过配置 options 对象,可以精准控制比较细节。以下是四个最常用的选项:
| 选项属性 | 可用值 | 行为效果与适用场景 |
|---|---|---|
numeric |
true / false(默认) |
设为 true 时启用自然数排序。使 "item2" 自动排在 "item10" 之前,非常适合带编号的文件名、版本号排序。 |
sensitivity |
'base', 'accent', 'case', 'variant' |
灵敏度分级: • 'base':忽略大小写与音标(如 a、A、á 视为相等)• 'accent':区分音标,忽略大小写• 'case':区分大小写,忽略音标• 'variant'(默认):大小写与音标均严格区分
|
caseFirst |
'upper', 'lower', 'false' |
当字母相同时,决定大写字母排在前('upper')还是小写字母排在前('lower')。 |
ignorePunctuation |
true / false(默认) |
是否忽略标点符号和空格的干扰。在对比清洗不规范的文本标题时非常实用。 |
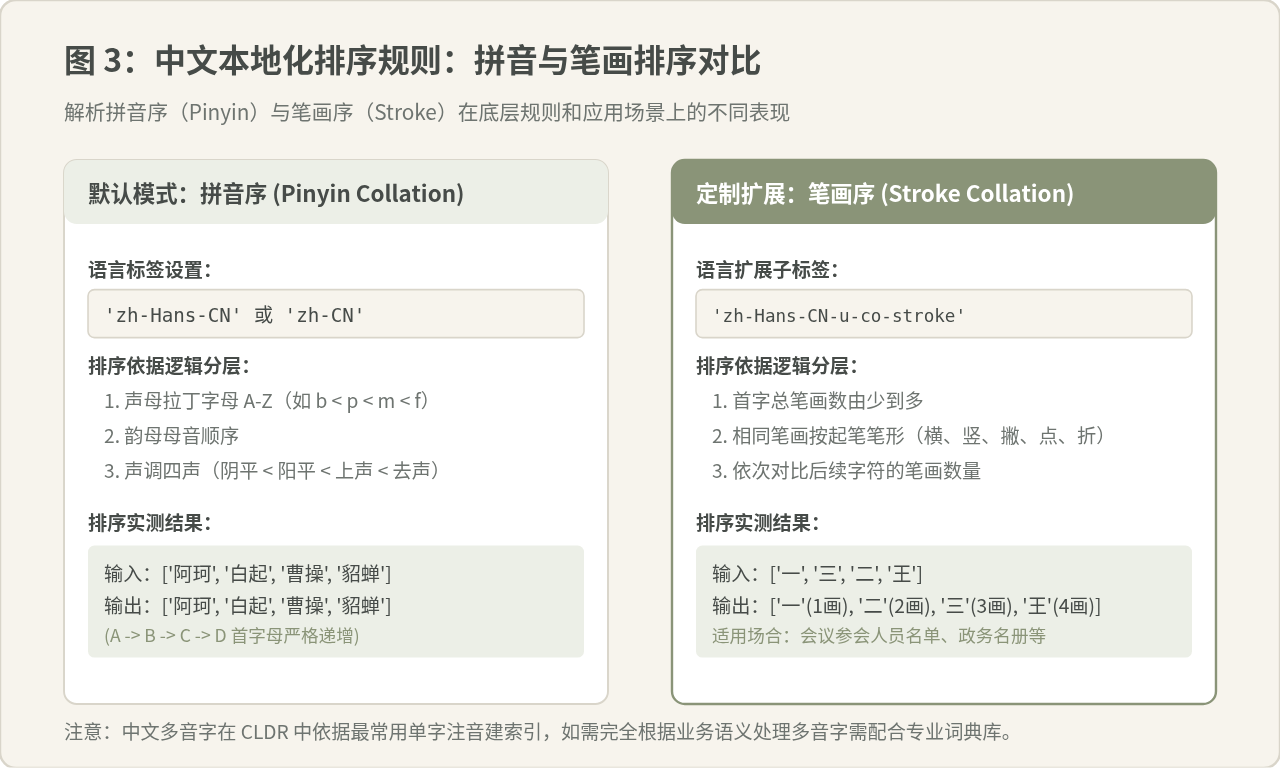
图 3:中文本地化排序规则:拼音序与笔画序的底层逻辑对比
四、典型实战场景与完整代码实现
场景 1:中文姓名按拼音首字母排序并提取首字母分组
在用户通讯录、员工花名册等前端展示场景中,我们需要将名单按拼音 A-Z 顺序排列:
// 中文姓名拼音排序完整示例
const contacts = ['张伟', '陈敏', '王芳', '李娜', '白杰', '戴强'];

// 按简体中文拼音排序
contacts.sort((a, b) => a.localeCompare(b, 'zh-CN'));

console.log(contacts);
// 示例输出: [ '白杰', '陈敏', '戴强', '李娜', '王芳', '张伟' ]
// 对应首字母: B -> C -> D -> L -> W -> Z
如果业务需要按照笔画从少到多排列(如会议代表名单),只需调整语言标签:
const strokeList = ['一', '王', '张', '李'];
strokeList.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN-u-co-stroke'));

console.log(strokeList);
// 示例输出: [ '一', '王', '李', '张' ]
// 笔画数递增: 1画 -> 4画 -> 7画 -> 7画(后续按起笔比对)
场景 2:带数字编号的文件名自然排序(Natural Sorting)
对于混合文字与数字的日志文件名或文档章节,开启 numeric: true 即可消除 10 插在 1 和 2 之间的问题:
const chapters = ['第1章 概述', '第10章 总结', '第2章 架构', '第20章 附录', '第3章 流程'];

// 启用 numeric 选项
chapters.sort((a, b) => a.localeCompare(b, 'zh-CN', { numeric: true }));

console.log(chapters);
// 示例输出:
// [
//   '第1章 概述',
//   '第2章 架构',
//   '第3章 流程',
//   '第10章 总结',
//   '第20章 附录'
// ]
场景 3:国际化搜索与不区分大小写的标签排序
在处理英文技术标签或多语种混合文本时,我们往往希望大小写统一归并:
const tags = ['Vue', 'react', 'Angular', 'react-native', 'vuex'];

// 忽略大小写差异进行基础比较
tags.sort((a, b) => a.localeCompare(b, 'en', { sensitivity: 'base' }));

console.log(tags);
// 示例输出: [ 'Angular', 'react', 'react-native', 'Vue', 'vuex' ]
五、中文多音字与特殊边界辨析
虽然 localeCompare 能够解决绝大部分中文拼音排序需求,但在实际业务中必须理解其边界条件:
多音字的成立条件与局限:Unicode 提供的 CLDR 本地化数据库为每个汉字分配了一个基于通用频率的默认拼音注音。例如汉字“沈”,在作为姓氏时读
shěn,但由于单字最常用发音包含 chén(同沉),底层字库可能将其归类于 C 区间而非 S 区间。
同样地,“重庆”(Chóngqìng)中的“重”字若被作为单字独立解析,可能匹配到“重量”(zhòng)。因此,若产品对百家姓或多音字有极端严苛的业务需求(如金融机构核心征信名单),不能完全依赖通用字库,而应先由后端拼音库(如基于词组上下文的 pinyin-pro)为数据附加标准拼音字段,再通过拼音英文字符串调用 localeCompare 排序。
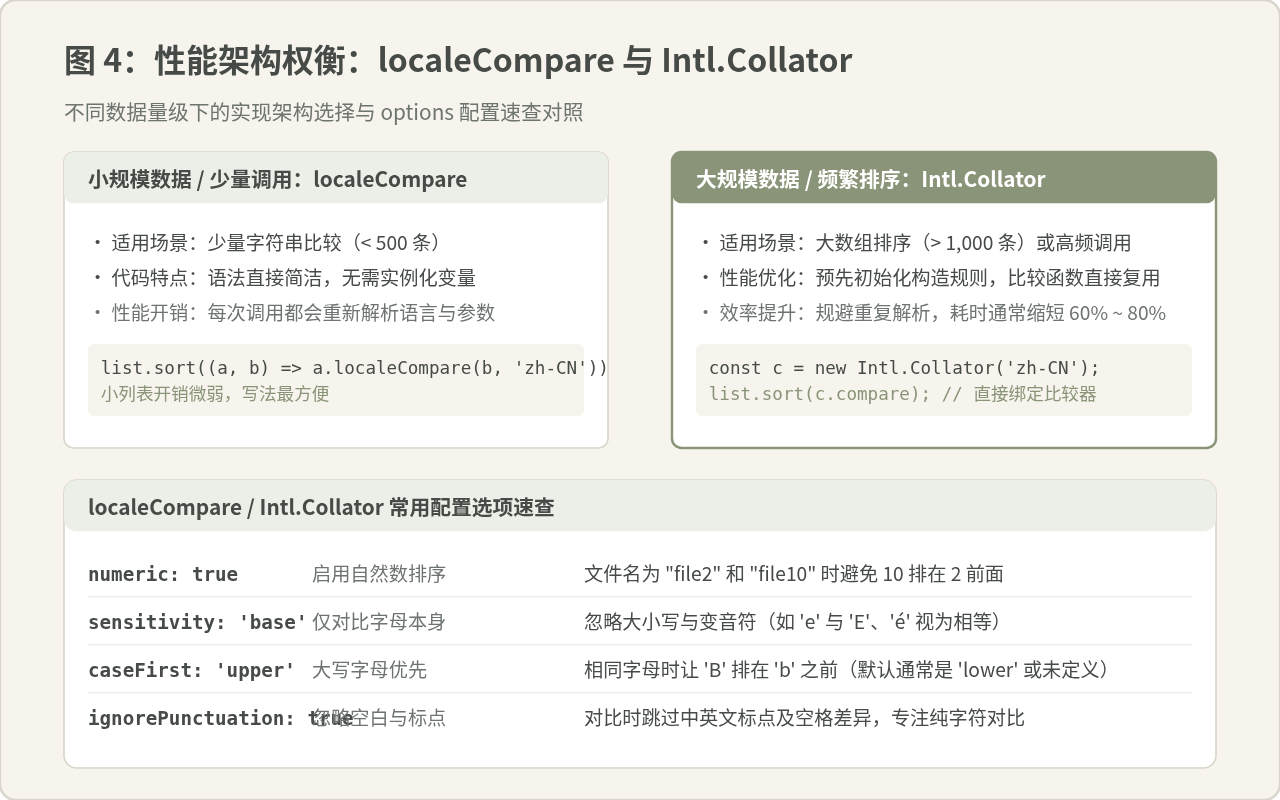
图 4:性能架构权衡:localeCompare 与 Intl.Collator 对照速查表
六、性能权衡:localeCompare 与 Intl.Collator 的架构抉择
1. 为什么大量数据调用 localeCompare 会有性能开销?
localeCompare 属于高层次的高级 API。每次执行 a.localeCompare(b, 'zh-CN', options) 时,JavaScript 引擎都要在底层经历以下完整流程:
- 解析并验证
locales字符串(校验 BCP 47 合法性)。 - 解析并标准化
options字典属性(填充默认值)。 - 构建内部排序规则表与权重树。
- 执行双字符串权重逐位匹配。
在对一个拥有 5,000 个元素的数组执行 arr.sort() 时,比较函数会被触发数万次(O(N log N) 复杂度)。如果每次比较都重复执行步骤 1 到 3,会导致巨大的 CPU 冗余计算。
2. 优化方案:使用 Intl.Collator 预编译实例
在 ECMAScript 国际化 API 中,localeCompare 本质上就是对 Intl.Collator 的轻量封装。对于包含上千条数据的大数组,最佳实践是先显式构造一个 Intl.Collator 实例,然后在排序中反复复用其 compare 方法:
// 性能优化方案:预实例化 Intl.Collator
const largeList = [ /* 包含数千项中文名称的数组 */ ];

// 1. 仅在循环外实例化一次排序器
const collator = new Intl.Collator('zh-CN', { numeric: true });

// 2. 将 collator.compare 作为比较器函数传入
largeList.sort(collator.compare);
根据实测基准测试,对于超过 1,000 个元素的数组,复用 Intl.Collator 实例相比在 sort 回调中直接写 a.localeCompare(b, 'zh-CN', { numeric: true }),执行耗时通常可直接缩减 60% 到 80%,同时大幅降低垃圾回收(GC)开销。
七、实用避坑清单与最佳实践总结
- 始终指定明确的 locales:不要依赖省略参数的宿主环境默认值。同一段代码在服务器 Node.js(可能为
en-US)与国内用户浏览器(zh-CN)上如果不指定'zh-CN',排序结果可能截然不同。 - 使用正负关系而不是绝对值:严格遵循规范约定,只利用返回值的
< 0、=== 0、> 0,绝不写=== -1。 - 数字文件名务必开启 numeric:处理包含章节、序号、尺寸、版本的列表时,始终传入
{ numeric: true }。 - 按数据规模选择 API:简单单次比对用
localeCompare;大列表或高频比对,提取单一Intl.Collator实例。 - 认识拼音字库的局限:通用环境优先使用
'zh-CN'拼音排序,涉及严格行业姓氏与生僻多音字时,配合专用词典预处理。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章