
深入解析JavaScript多维数组赋值与初始化中的引用共享陷阱,剖析栈堆内存模型,对比浅拷贝与深克隆的本质差异,并提供生产环境可行的深层嵌套数据处理方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS多维数组赋值陷阱:深层嵌套数据的引用处理
作者:纸飞机
时间:2026-11-16
浏览:131
文章目录
JavaScript 进阶
数据结构与内存
前端工程实践
在 JavaScript 中操作多维数组时,修改某个坐标位置的元素(例如
grid[0][0] = 1)却意外导致整列或所有行的数据同步发生改变,是极具隐蔽性的经典缺陷。该问题的根源并不在于赋值语法本身,而在于初始化或数据拷贝阶段对“深层嵌套对象的引用地址”进行了错误复用。本文将从 V8 引擎底层的栈堆内存模型切入,逐层分析常见初始化陷阱与浅拷贝失效机理,并给出涵盖原生 structuredClone、工厂初始化以及状态不可变更新在内的全套工程化解决方案。
一、经典重现:两类最常见的引用复用陷阱
多维数组在网格地图、表格渲染、图形算法与动态规划等场景中非常普遍。但在实际编码中,很多开发者习惯使用语法简短的内置方法构造二维矩阵,从而埋下了连锁反应的隐患。
1. 陷阱一:Array(n).fill([]) 批量填充陷阱
当需要构造一个 3 行 3 列全为 0 的矩阵时,不少人会写出如下代码:
// 构造 3 行 3 列的矩阵
const matrix = new Array(3).fill(new Array(3).fill(0));

// 预期:仅将第 0 行第 0 列的值改为 1
matrix[0][0] = 1;

// 实际输出:[[1, 0, 0], [1, 0, 0], [1, 0, 0]]
console.log(matrix);
输出结果表明,不仅 matrix[0][0] 变成了 1,连同 matrix[1][0] 和 matrix[2][0] 也一同变成了 1。这是因为 fill() 方法接收的参数是在传入前被求值的,函数内部只是将同一个子数组的内存引用依次填入外层数组的 3 个槽位中。外层数组的 3 个索引实际指向堆内存中的同一个实体。
2. 陷阱二:展开运算符 [...matrix] 造成的浅拷贝假象
另一个高频陷阱发生在试图“复制”一份多维数据作为副本进行临时运算时:
const original = [[1, 2], [3, 4]];
const snapshot = [...original]; // 试图创建副本

snapshot[0][0] = 99;

// 原始矩阵同样被污染:[[99, 2], [3, 4]]
console.log(original);
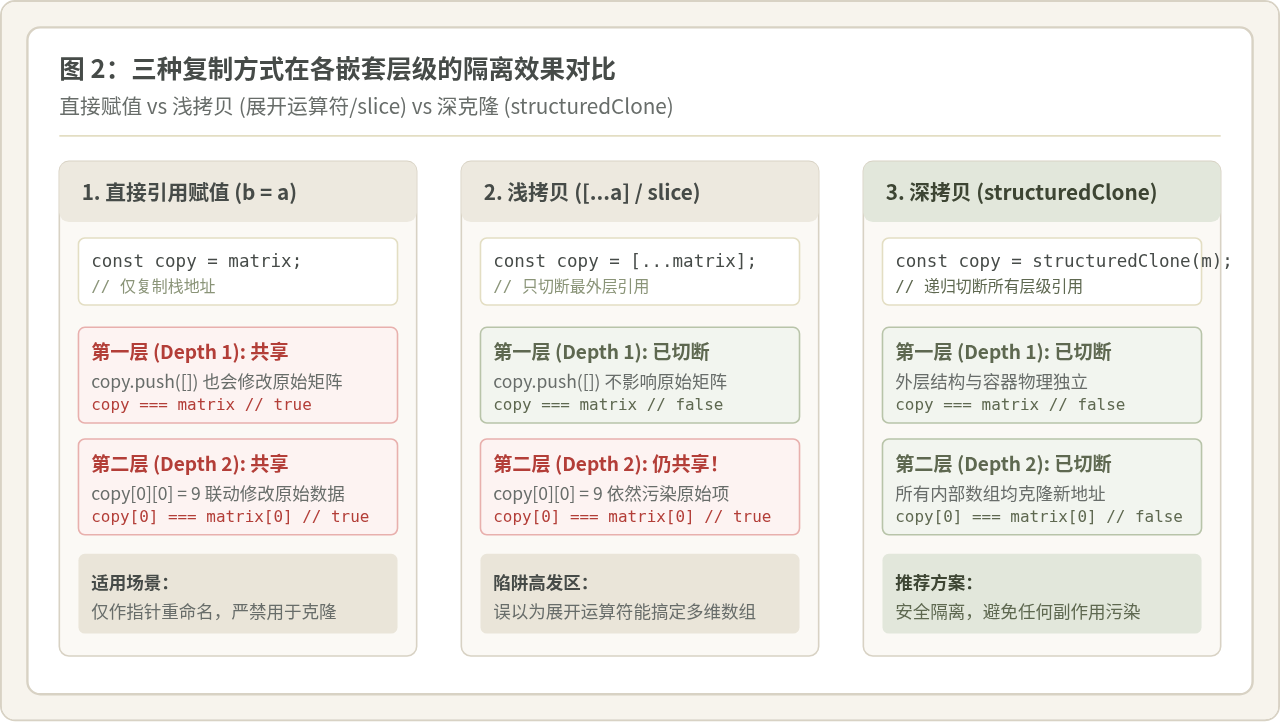
开发者往往认为展开运算符(Spread Operator)已经生成了全新数组,但实际上它只切断了最外层外壳的引用,其内部存放的子数组仍然原封不动地保留了旧引用。
注意事项:任何只作用于顶层数组的复制方法(如
slice()、concat()、Array.from(arr)、[...arr]),在多维数组场景下均属于浅拷贝,无法切断嵌套数组之间的关联。
二、底层机理:栈内存与堆内存的指针拓扑关系
要彻底避免上述问题,需要理解 JavaScript 引擎如何存储复合数据类型。JavaScript 的变量名以及原始值(如 Number、Boolean)存放在栈内存(Stack)中,而数组、对象等引用类型则统一分配在堆内存(Heap)中。
在多维数组中,外层数组并不是把内层数组的物理元素平铺在自身空间内,而是存入内层数组在堆内存中的内存起始地址指针。当执行 Array(3).fill([]) 时,内存中实际只开辟了两个堆对象:一个是容纳 3 个指针的外层数组,另一个是内层数组实体。外层数组的 3 个槽位全部被写入了同一个堆地址指针。
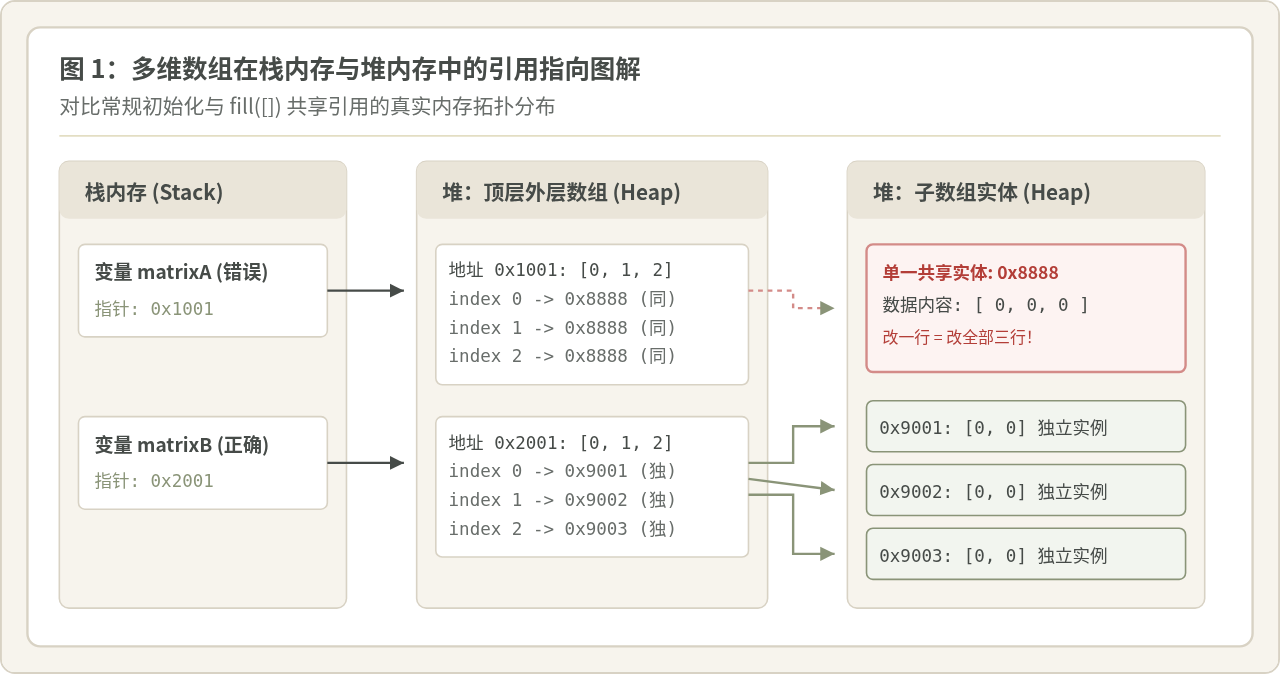
从图 1 可以直观地看到:当指针全部汇聚于 0x8888 时,通过任意一个索引(无论是 matrix[0] 还是 matrix[2])进行属性赋值,都是顺着指针修改 0x8888 地址所对应的内容。因此,任何一处的变动必然在所有位置同步呈现。
三、容易混淆的认知辨析
在日常讨论中,存在一些看似合乎直觉但并不严谨的说法。客观剖析这些说法的成立边界,有助于建立稳固的心智模型:
1. 辨析:“扩展运算符 [...arr] 已经生成新数组,为什么还会联动?”
为何看似合理:因为对新数组执行 snapshot.push([5, 6]) 时,原数组 original 确实完全不受影响,snapshot === original 的求值结果也是 false。这给人一种“两个数组完全独立”的直觉。
成立条件与边界:这种独立性仅严格限制在第一层级(Depth 1)。展开运算符遍历原数组并把每个元素逐一赋值给新容器,当遇到子数组时,它复制的就是子数组的引用指针。因此,第一层的增删相互隔离,但第二层元素的改动依旧共享内存。
2. 辨析:“深拷贝用 JSON.parse(JSON.stringify(arr)) 就能解决所有场景?”
为何看似合理:先序列化为纯字符串再反序列化,可以在不需要引入第三方库的情况下斩断所有引用链条,对于只包含数字或字符串的简单多维矩阵极其轻便高效。
成立条件与修正:这种方法只能在数据类型极其纯粹的纯 JSON 场景下成立。一旦多维数组内包含 undefined、函数、Symbol,对应项在序列化后会被转为 null 或丢失;包含 NaN 或 Infinity 会被强制序列化为 null;包含 Date 对象会退化为 ISO 字符串;更严重的是,若数组中存在循环引用,代码将直接抛出 TypeError: Converting circular structure to JSON 异常导致程序崩溃。
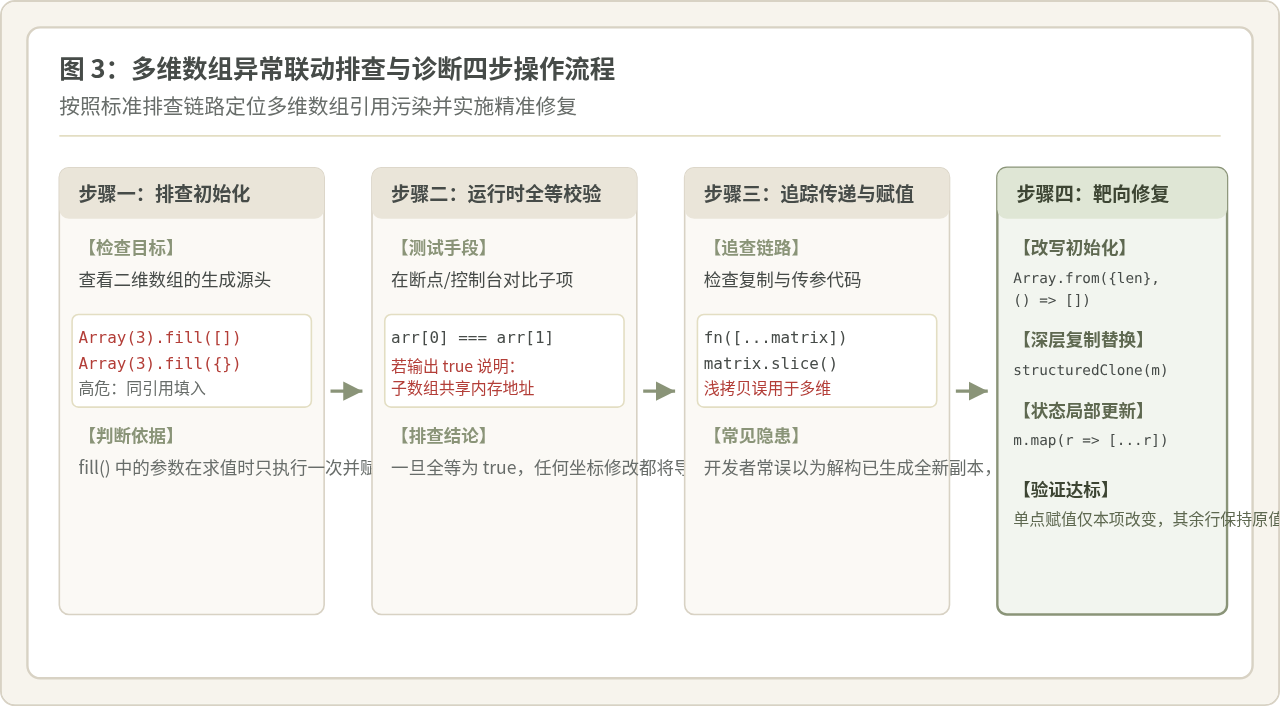
四、排查与诊断:定位异常联动的四步操作
在面对庞大的遗留代码或复杂的状态逻辑时,如果发现矩阵数据存在诡异的连锁反应,可以按照以下标准诊断流程进行快速排查与修正:
-
步骤一:排查初始化语句
全局搜索多维数组的创建位置,重点排查是否存在Array.prototype.fill()接收对象/数组字面量的情况。若存在fill([])或fill({}),即可确认引用复用源头在此。 -
步骤二:运行时全等性断言
在控制台或断点处对相邻元素进行严格全等比对:
若控制台打印console.log(matrix[0] === matrix[1]); // 若为 true 则证明共享同一物理地址true,则证实子级数组为同一个对象。 -
步骤三:追查调用链与拷贝操作
检查在函数传参、Redux Reducer 或自定义工具类中,是否使用了[...matrix]或matrix.slice()作为保护性克隆。一旦涉及多维结构,浅拷贝无法提供预期防护。 -
步骤四:执行针对性重构与结果验证
根据业务需求将初始化改写为动态生成,或引入真正的深层克隆方法。修改后再次执行单点修改,确认其他坐标值保持原状。
五、生产环境推荐方案与实战代码
1. 正确构建多维数组:基于 Array.from 的工厂模式
创建多维数组时,核心原则是:每一次迭代都必须显式执行一次实例化,保证每次返回独立的堆对象。推荐采用 Array.from() 配合映射函数:
// 创建 3 行 4 列的二维数组,默认填充 0
const rows = 3;
const cols = 4;

const grid = Array.from({ length: rows }, () =>
  new Array(cols).fill(0)
);

grid[0][0] = 88;
console.log(grid[0]); // [88, 0, 0, 0]
console.log(grid[1]); // [0, 0, 0, 0] —— 其余行完全独立!在这个实现中,Array.from() 第二个参数为映射函数,每次构建新行时都会执行一次 new Array(cols).fill(0),产生完全独立的行实例。
2. 标准原生全量深克隆:structuredClone
现代 JavaScript 环境(Node.js 17+ 以及所有现代主流浏览器)已经正式内置了原生深拷贝 API structuredClone()。它是处理深层嵌套数组的首选标准:
const originalMatrix = [
  [{ id: 1 }, { id: 2 }],
  [{ id: 3 }, { id: 4 }]
];

// 原生深拷贝,自动切断所有嵌套层级
const safeCopy = structuredClone(originalMatrix);

safeCopy[0][0].id = 999;

console.log(originalMatrix[0][0].id); // 输出 1,原数据未受任何污染
console.log(safeCopy[0] === originalMatrix[0]); // false
structuredClone 采用结构化克隆算法(HTML Structured Clone Algorithm),不仅性能优于手写递归,且原生支持处理循环引用、Map、Set、Date、RegExp、ArrayBuffer 及类型化数组等复杂数据类型。
3. React / Vue 状态管理:路径局部浅拷贝(Path Cloning)
在响应式 UI 开发中,如果多维数组规模较大(例如 100x100 的网格),每次修改单个坐标都使用 structuredClone 进行全局全量深复制会带来显著的 CPU 计算与垃圾回收(GC)负担。此时业界推荐的做法是采用沿路径浅拷贝:
// 函数式单点不可变更新:只克隆受影响的行与顶层
function updateMatrixCell(prevMatrix, targetRow, targetCol, nextValue) {
  return prevMatrix.map((row, rIdx) => {
    // 非目标行:直接复用旧引用,零额外开销
    if (rIdx !== targetRow) return row;

    // 目标行:仅对当前行进行浅拷贝更新
    return row.map((val, cIdx) => (cIdx === targetCol ? nextValue : val));
  });
}

const initialGrid = [[0, 0], [0, 0]];
const nextGrid = updateMatrixCell(initialGrid, 0, 1, 5);

console.log(nextGrid);            // [[0, 5], [0, 0]]
console.log(initialGrid);         // [[0, 0], [0, 0]] (原状态保持纯净)
console.log(nextGrid[1] === initialGrid[1]); // true (未修改行引用得以保持,利于 React 渲染优化)
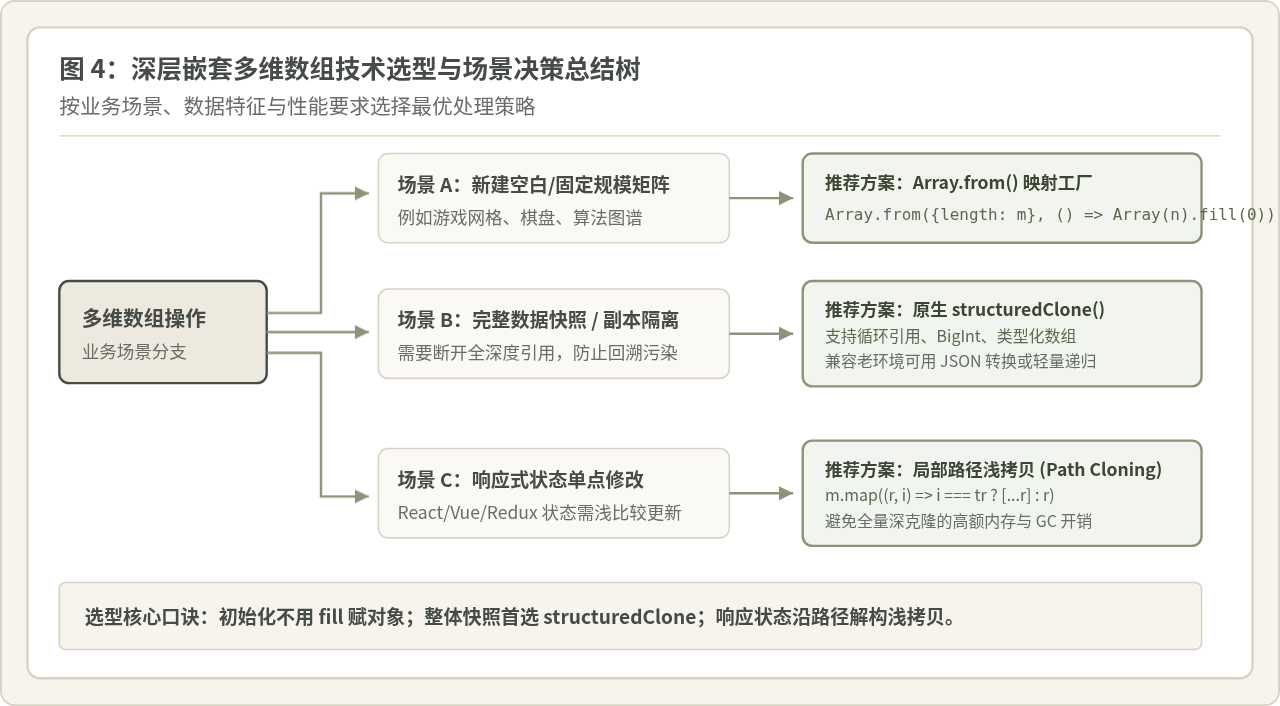
六、方案对比与选型决策
下表总结了日常开发中常见处理手段的特性边界,帮助在安全性和性能之间做出清晰的权衡:
| 处理方式 | 嵌套层级隔离 | 特殊类型支持 | 性能开销 | 最适用场景 |
|---|---|---|---|---|
[...arr] / slice() |
仅最外层独立 | 完整保留引用 | 极低 | 纯一维基本类型数组拷贝 |
JSON.parse(JSON.stringify) |
所有层级完全隔离 | 弱(不支持函数/undefined/NaN等) | 中等 | 纯数字/字符串格式的多维快照备份 |
structuredClone() |
所有层级完全隔离 | 强(支持循环引用/Map/Set等) | 优(原生底层实现) | 复杂数据全量深克隆、数据快照隔离 |
Array.from(length, () => []) |
各行独立,无引用共用 | 根据构造函数确定 | 极低 | 空白矩阵、棋盘或初始数据结构声明 |
| 路径局部浅拷贝 (Path Cloning) | 修改链路独立,其余共享 | 完整保留引用 | 低(内存复用率高) | React、Redux、Vue 响应式状态单点修改 |
七、核心总结
多维数组的赋值异常绝非难以捉摸的怪异现象,而是 JavaScript 引用传递机制在嵌套层级上的必然表现。规避此问题的核心规则可概括为以下三点:
- 初始化时避开复用:切勿使用
Array.prototype.fill()填充包含数组或对象的复杂引用类型,应始终通过工厂函数按需创建独立实例。 - 清晰认知拷贝深度:展开运算符
...与slice()只负责第一层浅拷贝。面对多维数据时,不可心存侥幸依赖浅拷贝实现隔离。 - 按需选用现代工具:针对整体全量副本首选现代原生
structuredClone();针对响应式前端组件状态的单点微调,应采用按需局部浅拷贝模式,兼顾数据不可变性与渲染性能。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章