
全面讲解JavaScript中三维数组深拷贝的实现原理、踩坑陷阱与最佳实践,深入剖析浅拷贝导致多维数据污染的根本原因,提供structuredClone、定制递归克隆与TypedArray扁平化优化等落地方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS三维数组深拷贝怎么做?避免引用共享导致的数据污染
作者:纸飞机
时间:2026-11-16
浏览:635
文章目录
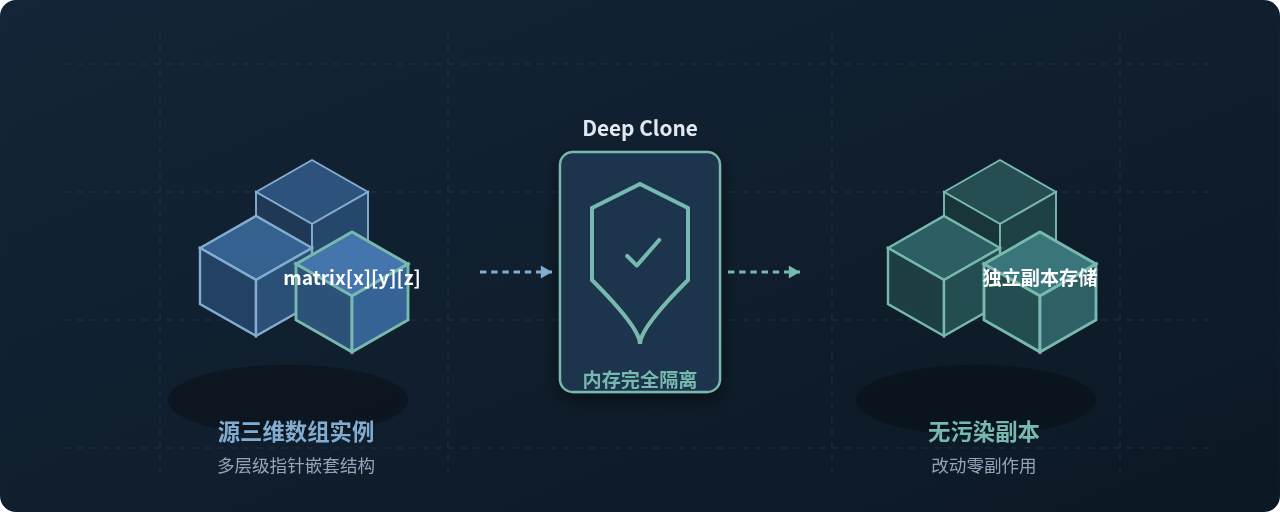
图 0:JavaScript 三维数组深拷贝内存拓扑与状态隔离抽象模型
在处理 3D 体素渲染、立体棋盘模拟或多维空间网格算法时,三维数组是不可或缺的底层数据载体。然而,许多开发者试图通过
[...matrix]、matrix.slice() 或 Array.from(matrix) 对三维数据做状态快照时,却惊讶地发现修改副本坐标 copy[x][y][z] = 1 会导致原始矩阵的数据同步改变。要彻底切断引用共享导致的数据污染,必须对每一级嵌套维度都分配独立的堆内存,本文将直接给出标准 API 解法、定制递归实现以及极致性能下的替代方案。
一、为什么常规拷贝在三维数组中彻底失效?
假设我们正在开发一个包含立体方块坐标的体素沙盒,定义了一个代表 2x2x2 空间的初始三维数组:
// 原始三维数组 (X -> Y -> Z)
const originalGrid = [
  [
    [0, 0],
    [0, 0]
  ],
  [
    [0, 0],
    [0, 0]
  ]
];

// 常见错误:试图使用解构扩展运算符浅拷贝
const copiedGrid = [...originalGrid];

// 修改克隆体中坐标 (0, 0, 0) 的元素
copiedGrid[0][0][0] = 999;

// 验证污染情况
console.log(originalGrid[0][0][0]); // 输出: 999 !!原始数据被严重污染很多初学者在此处感到困惑:[...originalGrid] 确实创建了一个新的数组,两者的外层引用并不相等(copiedGrid !== originalGrid 为 true)。但 JavaScript 中的多维数组并非连续的块状多维内存,而是“数组的数组(Arrays of Arrays)”。最外层数组存放的根本不是数值,而是第二层子数组的对象内存指针;同理,第二层数组存放的也是第三层数组的指针。
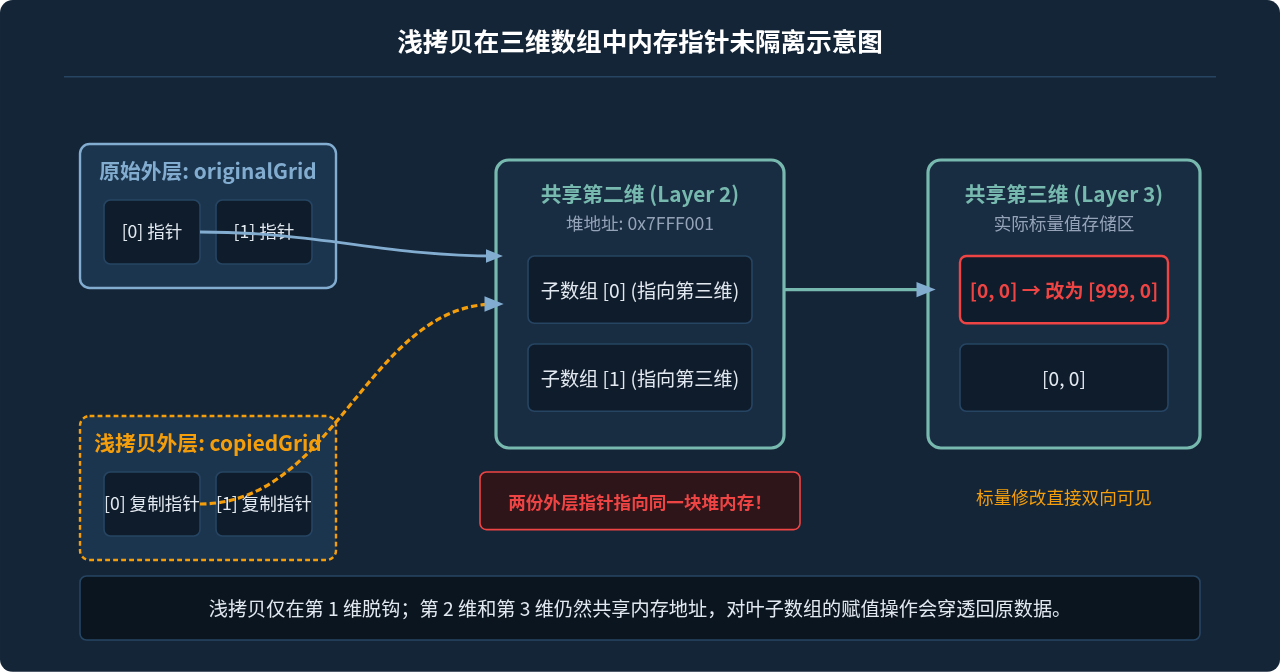
图 1:浅拷贝仅克隆最外层指针,深层嵌套引用共享造成“隔空串扰”
二、标准现代方案:优先使用 structuredClone()
在 ECMAScript 与现代 Web/Node.js 标准中,我们已经拥有了原生的全局深拷贝方法:structuredClone()。它由底层原生实现,使用结构化克隆算法(HTML Structured Clone Algorithm),天生支持任意多维数组,并具备自动处理循环引用的能力。
1. 基础调用与结果检验
// 原始三维体素矩阵
const voxelWorld = [
  [[1, 2], [3, 4]],
  [[5, 6], [7, 8]]
];

// 执行真正的深拷贝
const clonedWorld = structuredClone(voxelWorld);

// 修改克隆数据中的深层叶子元素
clonedWorld[0][0][0] = 999;

// 验证污染情况
console.log(voxelWorld[0][0][0]); // 输出: 1 (原始数据完全未被破坏)
console.log(clonedWorld[0][0][0]); // 输出: 999 (副本数据修改成功)
console.log(voxelWorld[0] === clonedWorld[0]); // 输出: false (第一维独立)
console.log(voxelWorld[0][0] === clonedWorld[0][0]); // 输出: false (第二维独立)环境兼容性要求:structuredClone 在 Node.js 17.0.0+、Chrome 98+、Firefox 94+、Safari 15.4+ 以及所有现代主流运行时中均已原生集成。如果运行环境符合现代标准,这是最安全、最符合规范的首选解法。
三、手写稳健递归:专为三维及多维数组设计的纯函数
如果需要在较旧的微前端容器、特定打包工具或低版本 Node.js 环境下运行,或者希望避免函数/特殊对象的副作用,手写一个轻量且健壮的多维数组递归克隆函数是极具实用价值的方案。
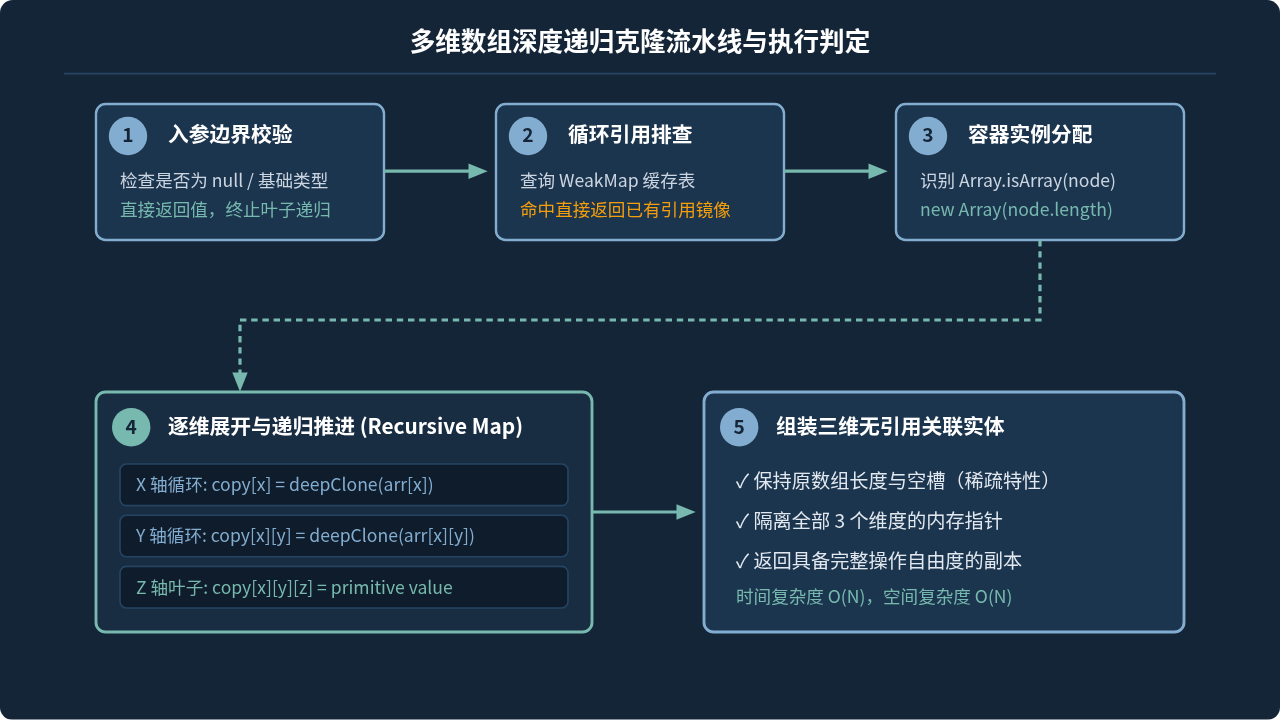
图 2:针对嵌套数组的逐层解构、递归映射与内存分配操作步骤
2. 实现代码:通用且防循环引用的 deepClone3D
/**
 * 针对三维数组及复杂多维结构的高性能深拷贝函数
 * @param {any} target 要克隆的目标
 * @param {WeakMap} map 缓存哈希表,用于解决循环引用死循环
 * @returns {any} 克隆后的独立全新副本
 */
function deepCloneArray(target, map = new WeakMap()) {
  // 1. 如果不是对象或为 null,说明已到底层标量(数字、字符串、布尔等),直接返回
  if (target === null || typeof target !== 'object') {
    return target;
  }

  // 2. 检查循环引用缓存
  if (map.has(target)) {
    return map.get(target);
  }

  // 3. 针对数组类型的分支优化
  if (Array.isArray(target)) {
    const length = target.length;
    // 预分配数组大小,避免多次扩容带来的性能损耗
    const clonedArr = new Array(length);
    map.set(target, clonedArr);

    for (let i = 0; i < length; i++) {
      // 处理稀疏数组的情况,确保未定义的索引不会被意外强制填充
      if (i in target) {
        clonedArr[i] = deepCloneArray(target[i], map);
      }
    }
    return clonedArr;
  }

  // 4. 处理嵌套在数组中的普通对象
  const clonedObj = Object.create(Object.getPrototypeOf(target));
  map.set(target, clonedObj);

  for (const key of Reflect.ownKeys(target)) {
    clonedObj[key] = deepCloneArray(target[key], map);
  }

  return clonedObj;
}如果当前场景确定只包含纯粹的三维数字/布尔数组(例如纯三维数据矩阵),还可以使用极其紧凑的 map 级联表达式,三行代码即可完成:
// 针对三维纯数值数组的简洁解构克隆方案
const clone3DMatrix = (matrix) =>
  matrix.map(layer2 =>
    layer2.map(layer3 =>
      [...layer3] // 在最深一维执行浅拷贝,由于元素是基本类型,达到彻底深拷贝效果
    )
  );
这种纯函数写法利用内建的 Array.prototype.map,保证了外层两维每次都新建 Array 实例,而在第三维由于存放的是纯标量(如 0 或 1),解构扩展运算符 [...layer3] 足以实现完全隔离。
四、JSON 序列化快照:适用场景与边界陷阱
在业务代码中,许多人习惯直接调用 JSON.parse(JSON.stringify(matrix))。这种做法究竟能否解决三维数组的深拷贝?答案是:在满足特定数据约束下可以,但必须警惕其边界隐患。
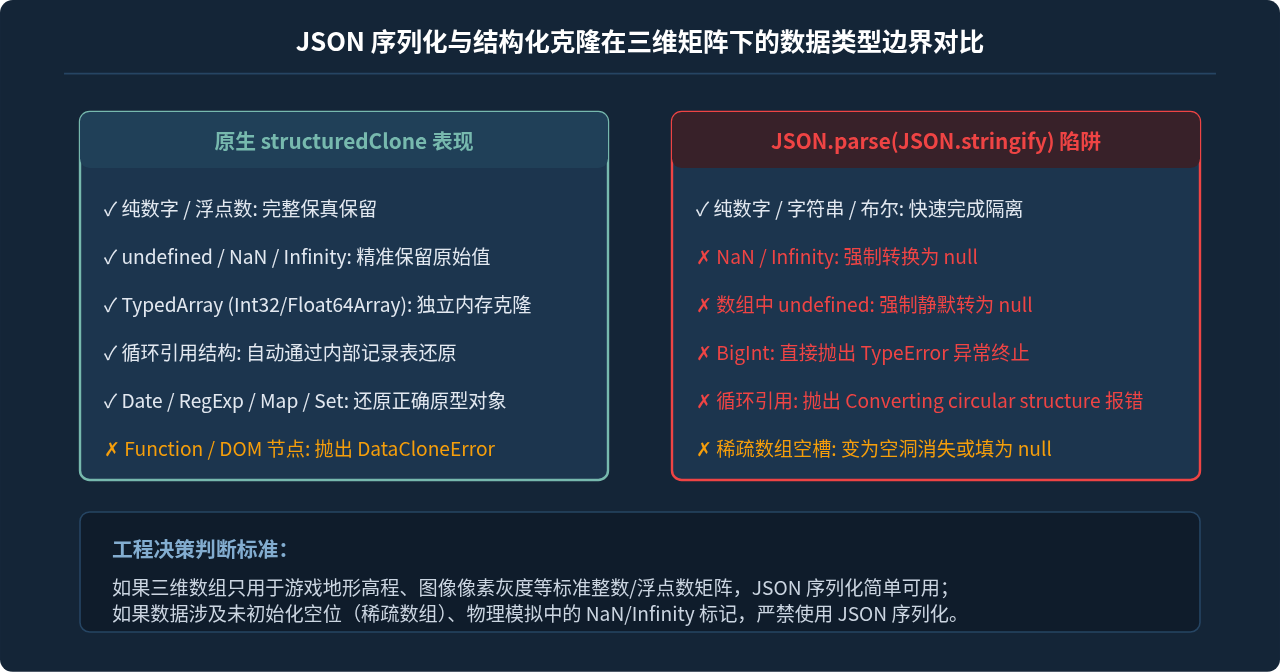
图 3:三维数据在结构化克隆与序列化流转中的数据类型边界与失真对比
五、大规模三维矩阵性能调优与架构替代方案
在立体体素空间中,三维数组的数据量膨胀极其迅速。例如一个中等大小的 100 × 100 × 100 空间网格,一共包含 1,000,000(一百万) 个数据点。
如果使用传统的 JS 嵌套数组存储,这不仅仅是一百万个数字,而是:
- 1 个外层 X 数组
- 100 个内层 Y 数组
- 10,000 个最底层 Z 数组
- 总计 10,101 个 JS Array 对象实例,每一个数组对象在 V8 引擎中都占用独立的句柄和内存元数据。
对这样的三维数组执行深拷贝,需要新建上万个堆对象并逐一建立指针关联,会产生数秒的停顿与垃圾回收(GC)压力。
架构替代:一维 TypedArray + 步长(Stride)索引
在高性能三维计算中,业界通行的做法是将三维坐标通过公式扁平化映射到连续的一维 Float32Array 或 Int32Array 中:
// 尺寸规格: 100 x 100 x 100
const SIZE_X = 100, SIZE_Y = 100, SIZE_Z = 100;
const voxelBuffer = new Int32Array(SIZE_X * SIZE_Y * SIZE_Z);

// 坐标映射寻址辅助函数
function getIndex(x, y, z) {
  return x * (SIZE_Y * SIZE_Z) + y * SIZE_Z + z;
}

// 写入数据
voxelBuffer[getIndex(10, 20, 30)] = 42;

// 高性能深拷贝:仅需调用 TypedArray.prototype.slice()
// 底层直接执行一次连续内存字节块 memcpy,耗时通常仅需零点几毫秒!
const clonedBuffer = voxelBuffer.slice();

// 验证独立性
clonedBuffer[getIndex(10, 20, 30)] = 999;
console.log(voxelBuffer[getIndex(10, 20, 30)]); // 42 (毫无污染,零 GC 负担)
六、方案对比与选型决策指南
针对不同开发阶段与运行环境,我们汇总了各深拷贝方案的差异与选型依据:
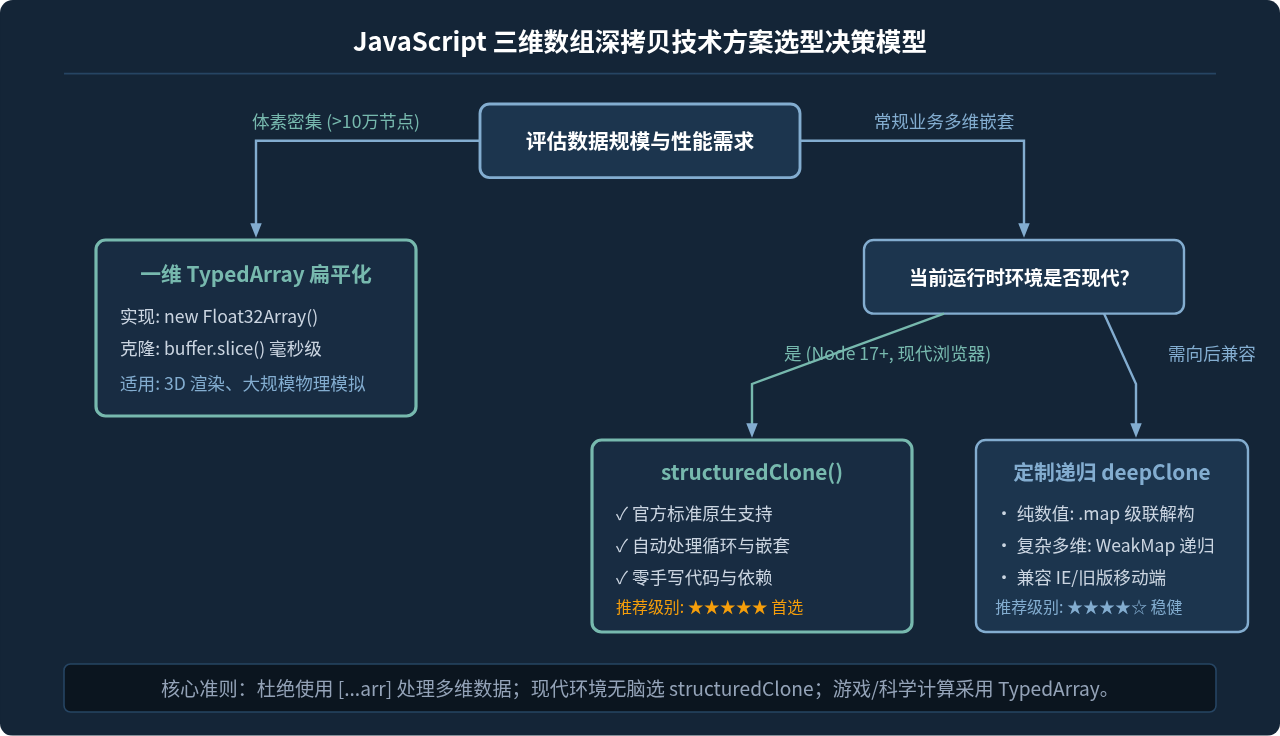
图 4:三维数据深拷贝综合选型指南与性能决策路径
| 实现方案 | 三维独立性 | 性能开销 (100³矩阵) | 循环引用 | 推荐使用场景 |
|---|---|---|---|---|
[...arr] / slice() |
仅最外层独立(严重污染) | 极低(但无法达成目标) | 不适用 | 严禁用于多维数组 |
structuredClone() |
完全独立 | 中等(原生内部实现) | 原生支持 | 现代标准浏览器、Node.js 17+ 业务应用首选 |
手写递归 deepClone |
完全独立 | 中等(依赖 JS 递归优化) | WeakMap 支持 | 需要向下兼容老旧环境,或纯数字三维数组 .map() |
JSON.parse(stringify) |
完全独立 | 高(产生大量中间字符串) | 直接报错崩溃 | 仅包含简单数字/字符串的小型三维数据快捷处理 |
一维 TypedArray + 步长 |
完全独立 | 极快 (单次 memcpy) | 扁平化无循环概念 | 3D 游戏引擎、体素沙盒、计算机图形学高频数据 |
七、总结与防御性开发建议
处理三维乃至更高维度的 JavaScript 数组时,关键在于理解对象指针的层级传递。浅拷贝只能阻断第一层引用的连锁反应,深层嵌套引用依然会直通底层内存,导致难以察觉的“幽灵数据污染”。
在日常开发中,建议遵循以下两条最佳实践:
- 默认优先采用
structuredClone():避免重复造轮子,让浏览器或 Node.js 原生底层 C++ 算法负责内存分配与类型复制。 - 在核心状态上施加不可变防护:在开发或单元测试环境中,可以通过
Object.freeze()深度递归冻结状态,或使用 TypeScript 将三维数组声明为只读类型readonly (readonly (readonly number[])[])[],从编译期与运行时两端彻底掐断意外修改源数据的隐患。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章