

用Node.js读取两起Claude事故,按独立记录和更新标识整理时间线。
JavaScript如何整理Claude事故时间线,避免混淆恢复通知
作者:纸飞机
时间:2026-11-15
浏览:498
文章目录
JavaScript处理Claude事故更新时,可以用“事故ID+更新ID”标识记录,再按created_at排序;不要把状态页的同一产品名当作事故主键。11月13日的两起恢复事件分别有独立ID,把它们合并为一条时间线结论,可能让较晚的恢复覆盖较早事故的实际影响范围。
先看容易合并错的两种异常
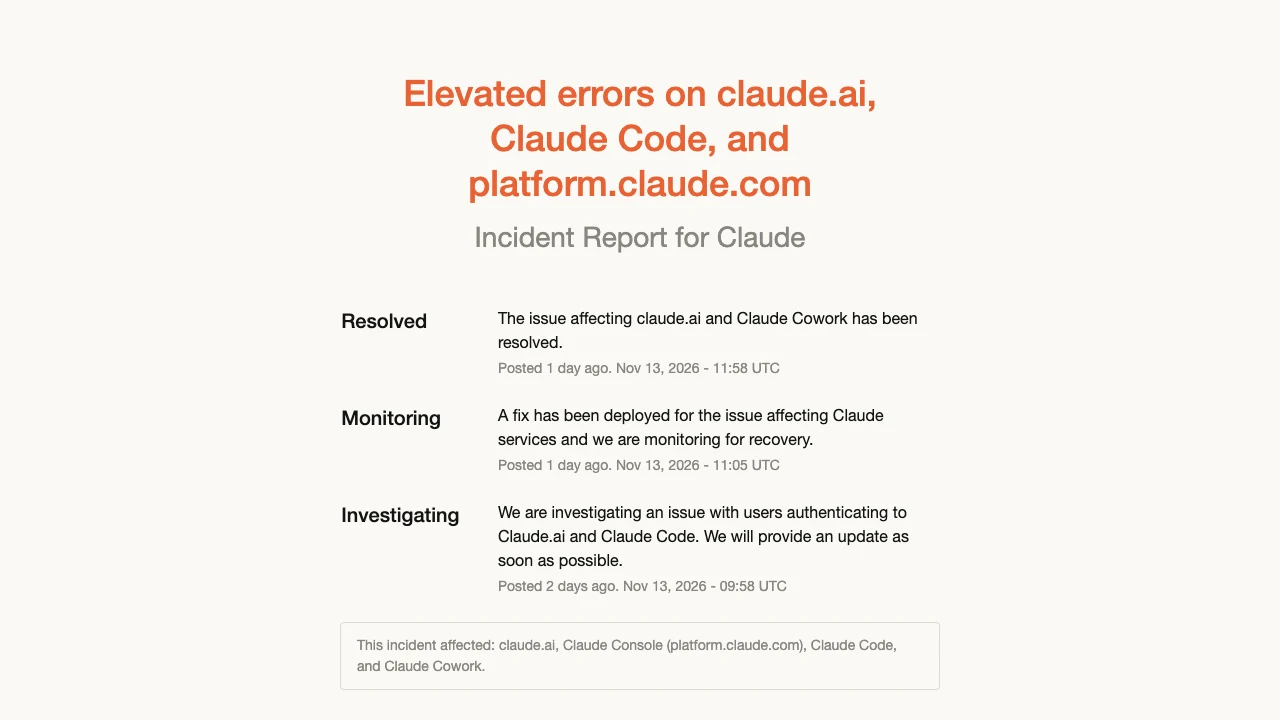
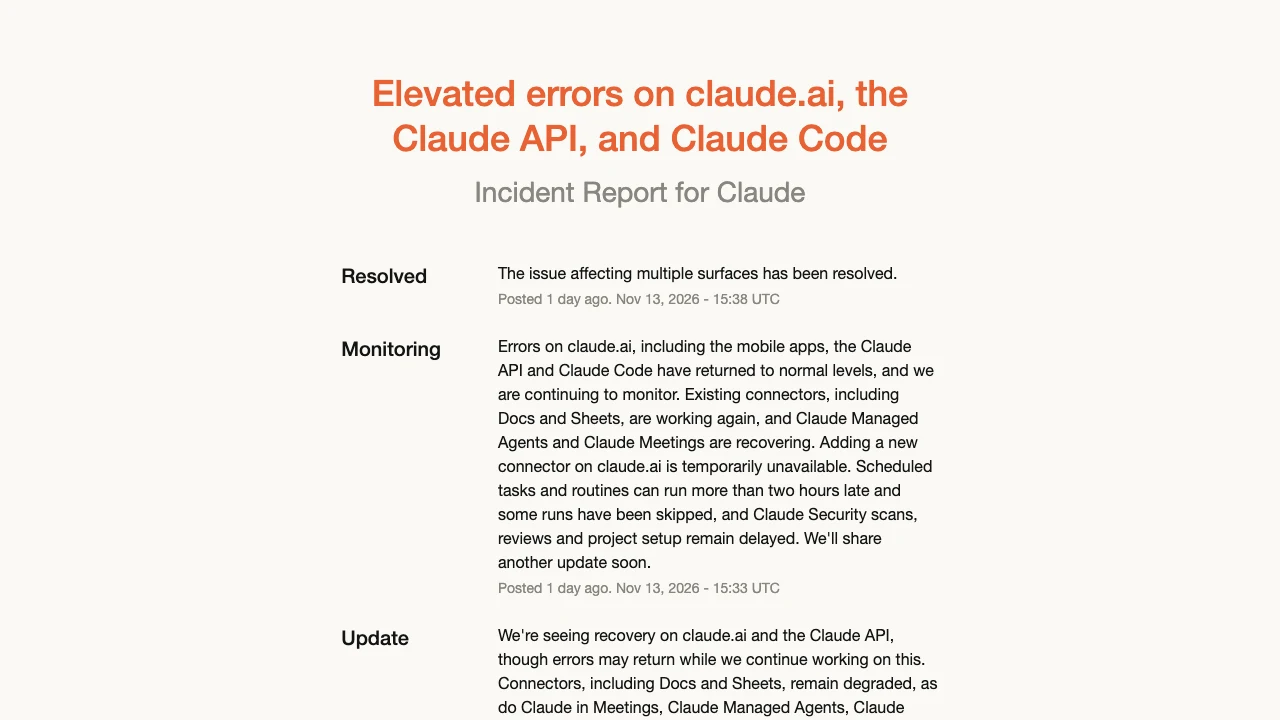
nn11wk485zfn标题涉及claude.ai、Claude Code和platform.claude.com,调查说明聚焦用户身份验证异常。它的最终说明明确影响claude.ai和Claude Cowork的问题已解决。34wq7gxnxvvm则记录claude.ai、Claude API及Claude Code错误升高,后续还提及连接器、Security和Managed Agents;最终更新宣布多个入口的问题已解决。这两个ID属于两起事故,而非一个事故标题的两次修改。
按事故分别整理更新,不依赖数组的原始顺序
下面代码适用于Node.js 24,使用内置fetch,无需依赖包和密钥。保存为claude-history.mjs后运行即可。代码仅请求两个公开事故端点,以更新创建时间从早到晚排列;HTTP非成功状态直接报错,不会生成“恢复正常”的假结果。
const ids = ["nn11wk485zfn", "34wq7gxnxvvm"];
for (const id of ids) {
  const response = await fetch(
    `https://status.claude.com/api/v2/incidents/${id}.json`
  );
  if (!response.ok) throw new Error(`HTTP ${response.status}: ${id}`);
  const { incident } = await response.json();
  const timeline = [...incident.incident_updates].sort(
    (a, b) => Date.parse(a.created_at) - Date.parse(b.created_at)
  );
  console.log(JSON.stringify({
    incidentId: incident.id,
    name: incident.name,
    state: incident.status,
    updates: timeline.map(update => ({
      key: `${incident.id}:${update.id}`,
      time: update.created_at,
      state: update.status,
      message: update.body
    }))
  }));
}
结果应为两个JSON对象,每个包含自身的更新数组。最后阶段均为resolved,但各自的更新数量和正文不同。组合key用于区分不同事故中的更新;这段示例没有数据库写入或自动重试功能,也没有将公开记录解释成账户运行结果。
为何不能只拿最后一条文字做全局提示
第二起事故在Monitoring阶段说明网页、移动应用、API及Code错误回落,已有Docs和Sheets连接器恢复;当时新增连接器暂不可用,部分计划执行被跳过,若干功能仍延迟。后续Resolved改变了该事故的结论,所以应用若展示中间限制,应同时展示其历史阶段,避免把过去的描述当成当前故障。
反过来,最终恢复通知没有给出每次任务的完成清单,不能据此把跳过任务标为已补跑。组件的整体状态还可能受其他事故影响。Microsoft 365连接器另有独立事故,其进展不由上述两个ID决定。按记录身份组织信息,才能让界面提示清楚表达“哪起事故已解决”,而不是笼统承诺“Claude所有功能都恢复”。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章