
在 JavaScript 中使用正则表达式实现首字母大写的完整教程。详细解析句首首字母大写与全词首字母大写的正则模式、replace 回调函数机制、边界符号与连字符处理及最佳工程实践。

当前位置:首页 > JavaScript 基础 > 正文
JS用正则表达式实现首字母大写
作者:拾光
时间:2026-11-16
浏览:592
文章目录
JavaScript 核心技巧
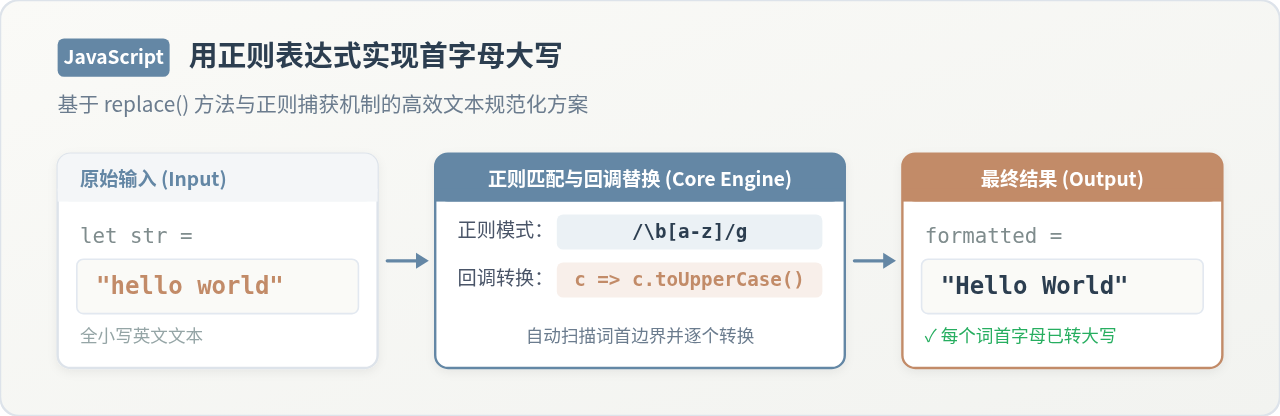
缩略图:JavaScript 正则表达式首字母转换工作模式概览
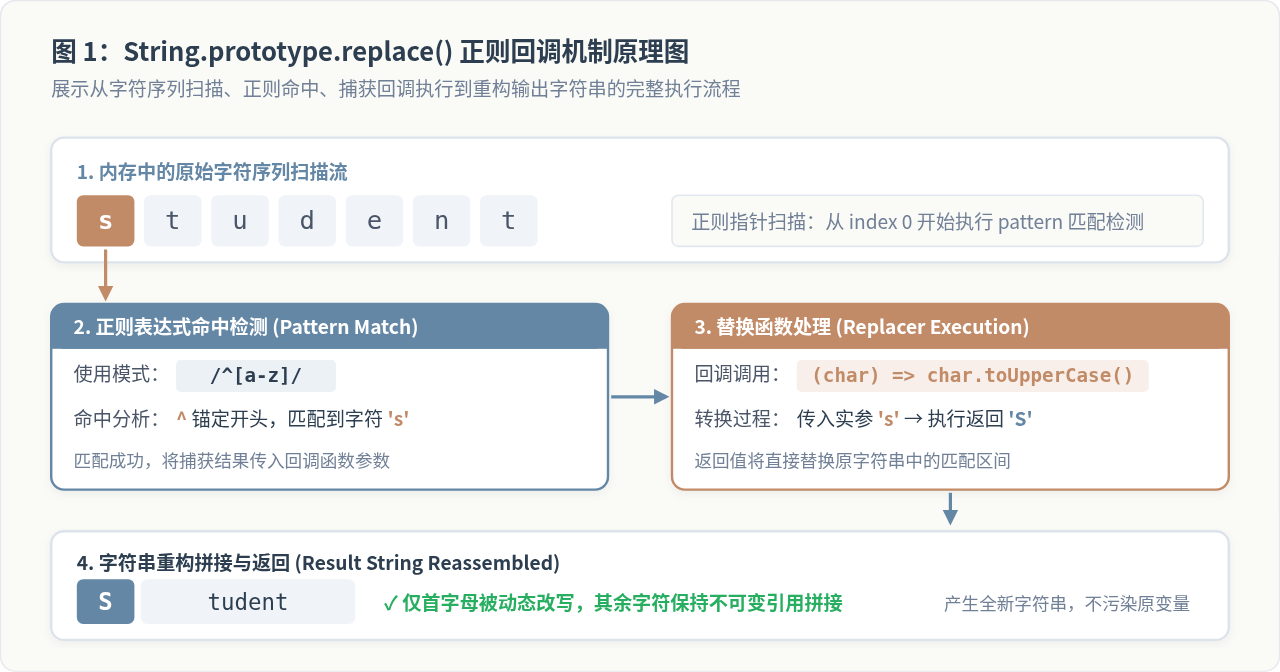
图 1:String.prototype.replace() 正则回调机制原理图
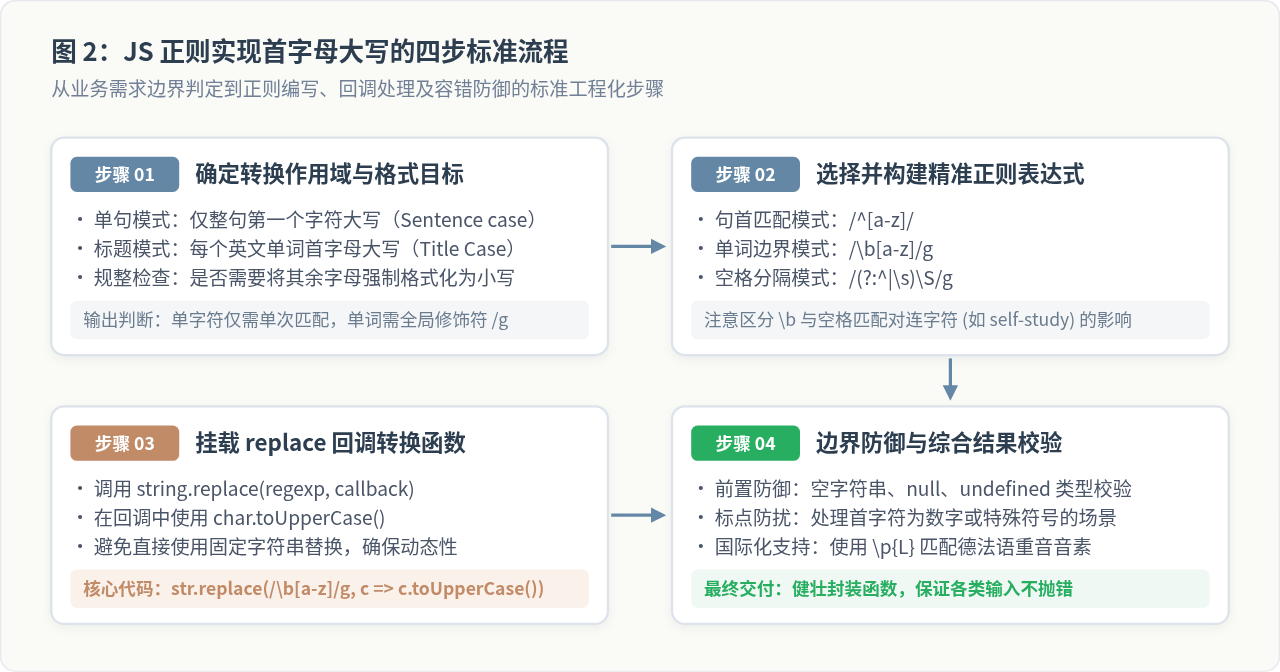
图 2:JS 正则实现首字母大写的四步标准流程
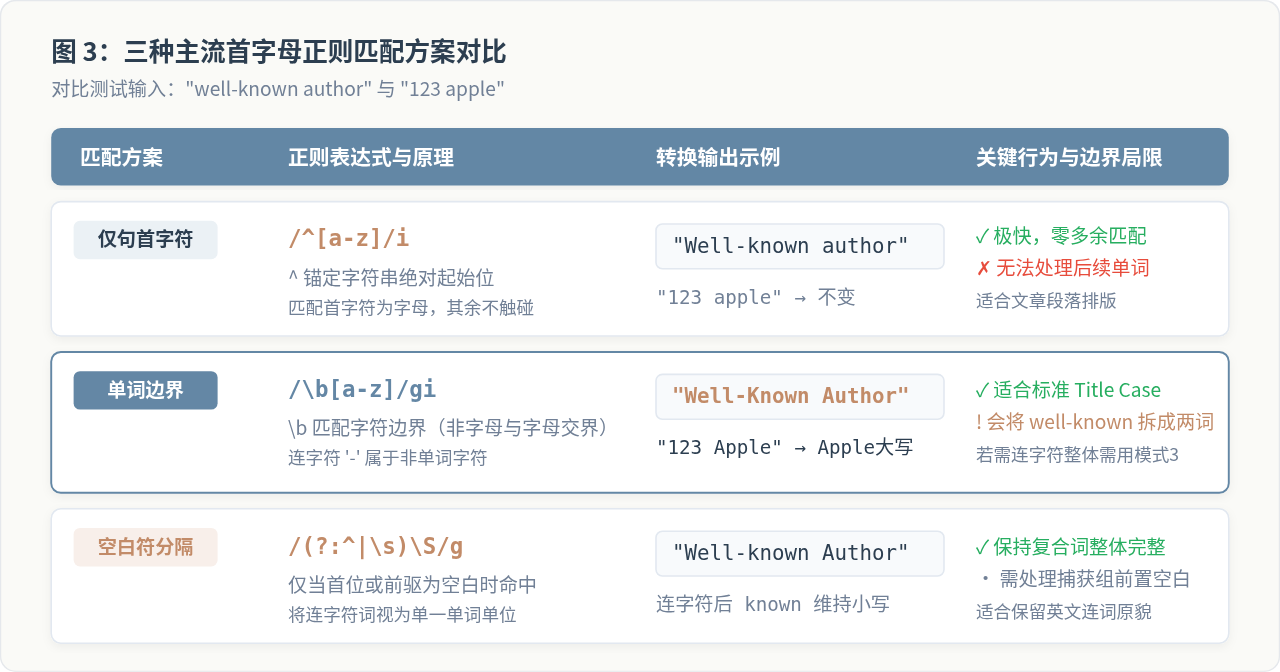
图 3:三种主流首字母正则匹配方案对比
常见疑问一:是否可以使用 CSS 的
常见疑问二:相比数组
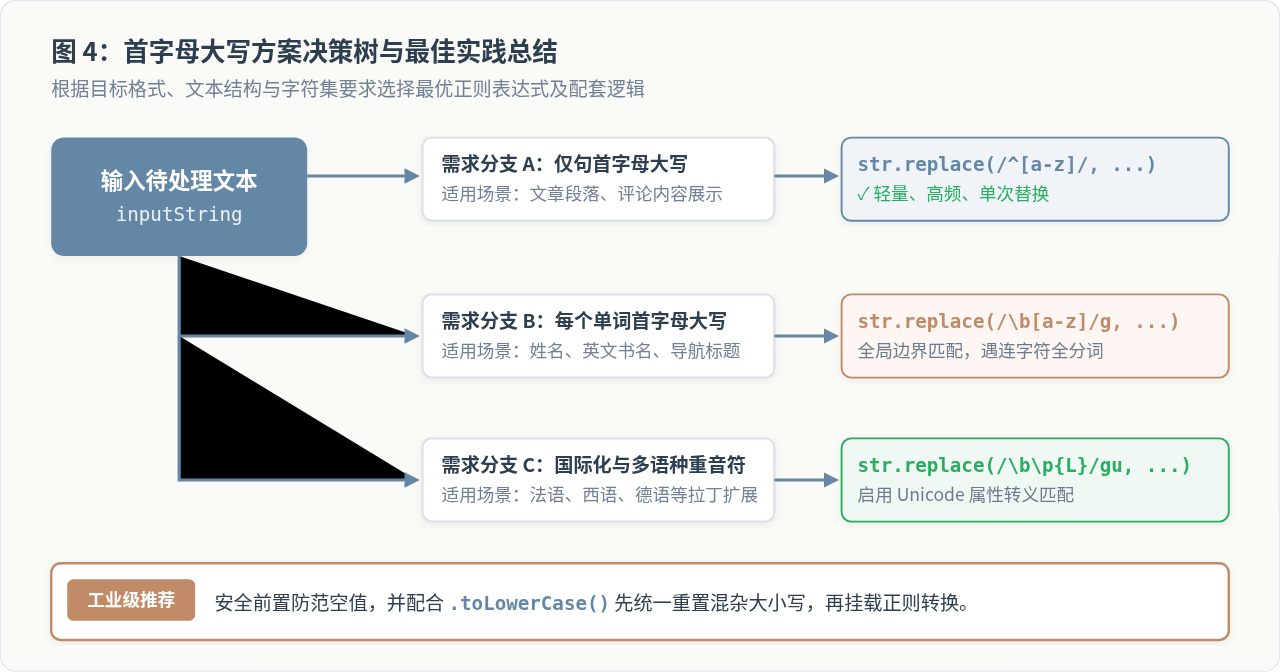
图 4:首字母大写方案决策树与最佳实践总结
在 JavaScript 中实现字符串首字母大写,最简洁且灵活的方式是借助 String.prototype.replace() 方法,配合正则表达式匹配目标字母,并通过回调函数调用 toUpperCase() 完成动态转换。本文将清晰拆解句首单字符与全文各单词首字母大写的两种核心模式,分析正则边界匹配原理,并提供应对连字符、标点与国际化字符的完整健壮方案。
一、核心结论与两行典型用法
字符串处理中所谓的“首字母大写”,业务上通常分为两种完全不同的诉求:第一种是只将整段字符串的第一个字母大写(Sentence case),常用于句子或自然段开头;第二种是将字符串中每一个英文单词的首字母均转为大写(Title Case),常见于英文人名、图书书名或页面标题排版。
由于 JavaScript 原生没有提供类似 Python str.capitalize() 或 str.title() 的方法,我们直接使用正则表达式实现:
1. 仅将整句首字母大写
// 匹配整段文本的首个字母并转大写
const capitalizeSentence = (str) =>
  str.replace(/^[a-z]/i, (match) => match.toUpperCase());

// 示例输出
console.log(capitalizeSentence("javascript is powerful"));
// 输出: "Javascript is powerful"
2. 将每个单词的首字母均大写(Title Case)
// 结合全局修饰符 g 和单词边界
const capitalizeWords = (str) =>
  str.replace(/[a-z]/gi, (match) => match.toUpperCase());

// 示例输出
console.log(capitalizeWords("javascript is powerful"));
// 输出: "Javascript Is Powerful"
核心判断:为什么不能直接写
str.replace(/^[a-z]/, "$1".toUpperCase())?因为字符串参数中的 $1 是在调用 replace 之前被求值的普通字符串,JavaScript 引擎在此时尚未执行正则匹配,因此 "$1".toUpperCase() 依然是纯字符 "$1"。必须将函数作为 replace 的第二个参数,才能在每次正则命中捕获时动态获得具体字符。
二、replace 与正则回调的运作机制
理解这套方案的关键,在于弄清 String.prototype.replace(regexp, replacerFunction) 在底层的协作过程。当 JavaScript 引擎执行该语句时,内部处理流可分解为以下连续环节:
- 序列扫描:引擎从左往右遍历字符串中的字符序列,同时维护匹配游标指针;
- 规则判定:正则引擎评估当前位置是否符合正则模式(例如是否为行首
^或单词边界紧随小写字母); - 中断与回调:一旦命中匹配,引擎将命中的字符作为实参传递给回调函数
(match) => match.toUpperCase(); - 返回值植入:回调函数将计算完成的大写字母返回给引擎,引擎将其装配入结果字符串;
- 继续扫描:如果是全局匹配
/g,指针推进并继续检索后续单词;若无/g则提前终止扫描并输出新字符串。
值得注意的是,由于 JavaScript 中的基本类型字符串是不可变(Immutable)的,整个替换过程从不会修改原始变量,而是动态拼接并在内存中生成一个全新的字符串,这保证了纯函数式的安全性和无副作用特性。
三、实现首字母大写的标准操作步骤
在实际业务开发中,随意套用一行正则往往会在遇到非标数据时引发异常。要构建一个健壮且符合工程规范的首字母大写功能,建议遵循以下四个标准步骤:
步骤一:明确转换作用域与格式目标
在动手编写代码之前,必须确认业务期望转换的是“整句开头”还是“每个词开头”。此外,还需要检查输入文本中是否已存在非预期的大写字符(例如用户输入了 "hELLO wORLD")。如果需要标准的标题格式,应先通过 str.toLowerCase() 将整体重置为小写,再行执行首字母大写。
步骤二:选择并构建匹配正则表达式
根据确定的作用域构造正则:
- 整句首字母:选用
/^[a-z]/(若需忽略大小写也可加上i修饰符)。符号^确保仅在字符串物理起始位置生效; - 每个词首字母:选用
/[a-z]/g。其中是零宽单词边界断言,匹配位于\w与非\w字符交界处的位置,g保证扫描全文所有单词。
步骤三:挂载 replace 动态转换函数
通过箭头函数建立映射:c => c.toUpperCase()。回调函数接收匹配字符,调用原生方法返回对应的大写字符。
步骤四:边界防御与类型安全校验
编写防御逻辑,防止在接收到 null、undefined 或数字类型时引发运行时报错。以下是经过四步校验后的完整生产级函数示例:
/**
 * 将字符串中每个英文单词的首字母大写,并规范其余字母为小写
 * @param {string} input - 待处理的原字符串
 * @returns {string} 格式化后的字符串
 */
function toTitleCase(input) {
  // 步骤一 & 四:防御非空与非法类型
  if (typeof input !== "string" || input.length === 0) {
    return "";
  }

  // 步骤一:统一转换为全小写,避免混杂大写脏数据
  const normalized = input.toLowerCase();

  // 步骤二 & 三:使用单词边界正则动态转换
  return normalized.replace(/[a-z]/g, (letter) => letter.toUpperCase());
}

// 示例测试
console.log(toTitleCase("tHiS iS a tEsT")); // 输出: "This Is A Test"
console.log(toTitleCase(""));               // 输出: ""
四、常见正则匹配模式对比与关键细节
在不同业务场景下,单词边界的定义可能大相径庭。理解不同正则模式在边界细节上的表现差异,能帮助我们避免诸如连字符、缩写撇号被误判的问题。
1. 连字符复合词处理(Hyphenated Words)
在英语中,许多单词通过连字符连接,例如 "well-known"、"user-friendly"。
- 使用
/[a-z]/g时:由于-属于非单词字符,它在well和known之间构成了两次边界,因此输出结果为"Well-Known"。这在大多数标题排版中是符合要求的; - 如果不希望连字符后的字母大写,而是希望将
well-known视为一个独立单元,则应该基于“空格或开头”进行匹配,模式改为/(?:^|\s)\S/g。
const raw = "well-known author";

// 模式一:边界模式(连字符两侧均大写)
console.log(raw.replace(/[a-z]/g, c => c.toUpperCase()));
// 输出: "Well-Known Author"

// 模式二:空白字符分隔模式(仅空格后首字符大写)
console.log(raw.replace(/(^|\s)\S/g, match => match.toUpperCase()));
// 输出: "Well-known Author"
2. 缩写撇号陷阱(Apostrophes)
对于诸如 "don't" 或 "it's" 这类单词,若使用不恰当的正则匹配非字母后的字符,可能会误把 't 或 's 当成新单词的首字母而转换成 "Don'T"。
值得庆幸的是,标准的 [a-z] 在处理单引号 ' 时,单引号通常被视为边界标点,但在标准英语分词中需特别留意。如果在业务中严格要求 "don't" 保持原样,可将正则限制为“前驱非撇号”的前瞻/后顾断言,或直接使用基于空格的分词方案。
3. 国际化与 Unicode 重音字符支持
在处理多语种或带重音音素的拉丁扩展字符(如法文 "éclair"、德文 "über"、西班牙文 "año")时,基础的 [a-z] 仅涵盖 ASCII 范围内的 26 个英文字母,会导致重音首字母无法被识别。
在支持 ES2018+ 的现代 JavaScript 环境中,可以通过启用 u(Unicode)标志,并结合 Unicode 属性转义 \p{L}(匹配任何语言的字母)来实现全语言支持:
// 支持全语言 Unicode 字母的首字母大写
const capitalizeUnicode = (str) =>
  str.replace(/\p{L}/gu, (c) => c.toUpperCase());

console.log(capitalizeUnicode("éclair au chocolat"));
// 输出: "Éclair Au Chocolat"
五、生产实践中的注意事项与常见疑问
注意混杂大小写的覆盖问题:
如果原字符串包含大写字母(例如
"hELLO wORLD"),仅使用 /[a-z]/g 替换只会针对小写字母生效,结果会变成 "HELLO WORLD",而无法修复单词内部异常大写的 ELLO。因此,在需要统一排版的标题场景下,务必先执行 toLowerCase()。
常见疑问一:是否可以使用 CSS 的 text-transform: capitalize 替代 JS 正则?
在纯 UI 渲染层面,CSS 的 text-transform: capitalize; 性能更优,且不占用主线程计算资源。但如果格式化后的字符串需要提交到后端数据库、参与哈希签名计算、导出为 Excel/PDF 报表,或者用于系统日志,则必须在 JavaScript 数据层使用正则进行持久化转换。
常见疑问二:相比数组 split(' ').map().join(' '),正则方案优势在哪里?
传统的数组方案(如 str.split(' ').map(w => w[0].toUpperCase() + w.slice(1)).join(' '))存在明显短板:
- 连续空格被破坏:若单词之间存在多个空格或制表符
split(' ')会产生空字符串元素并破坏原始排版间距; - 内存开销大:
split会在堆内存中创建数组对象和多个子字符串,随后map与join又进行额外分配; - 正则更优雅健壮:正则在底层流式处理,完好保留原有的标点符号、空格数量与制表格式,执行效率更高且逻辑紧凑。
六、方案选型指南与完整总结
为方便在不同项目中做出正确的技术选型,可参考下述决策流程图:
下表汇总了各种正则实现方式的核心特征与适用环境:
| 需求场景 | 推荐正则表达式 | 核心代码实现 | 典型适用业务 |
|---|---|---|---|
| 仅首句首字符大写 | /^[a-z]/i |
str.replace(/^[a-z]/i, c => c.toUpperCase()) |
自然段落首句、用户评论、说明文字 |
| 全词首字母大写 (Title Case) | /[a-z]/g |
str.toLowerCase().replace(/[a-z]/g, c => c.toUpperCase()) |
导航菜单、英文人名、商品品名、文章标题 |
| 保持连字符整体词 | /(?:^|\s)\S/g |
str.replace(/(?:^|\s)\S/g, c => c.toUpperCase()) |
保留如 well-known 等复合形容词 |
| 国际化跨语言支持 | /\p{L}/gu |
str.replace(/\p{L}/gu, c => c.toUpperCase()) |
包含德语、法语、西班牙语等多语言文本 |
总体而言,利用正则表达式配合 replace() 回调函数是 JavaScript 字符串首字母大写的终极利器。在开发过程中,根据实际语境选择合适的边界匹配模式,并做好前置类型防范与全小写归一化,即可构建出兼具性能与鲁棒性的格式化代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章