
深入讲解在JavaScript中将字符串转换为Base64字符串的完整方案,涵盖浏览器环境纯ASCII与中文字符串转换、TextEncoder标准处理流程、Node.js服务端Buffer转换,以及反向解码与常见报错避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
js字符串怎么转base64字符串
作者:拾光
时间:2026-11-13
浏览:606
文章目录
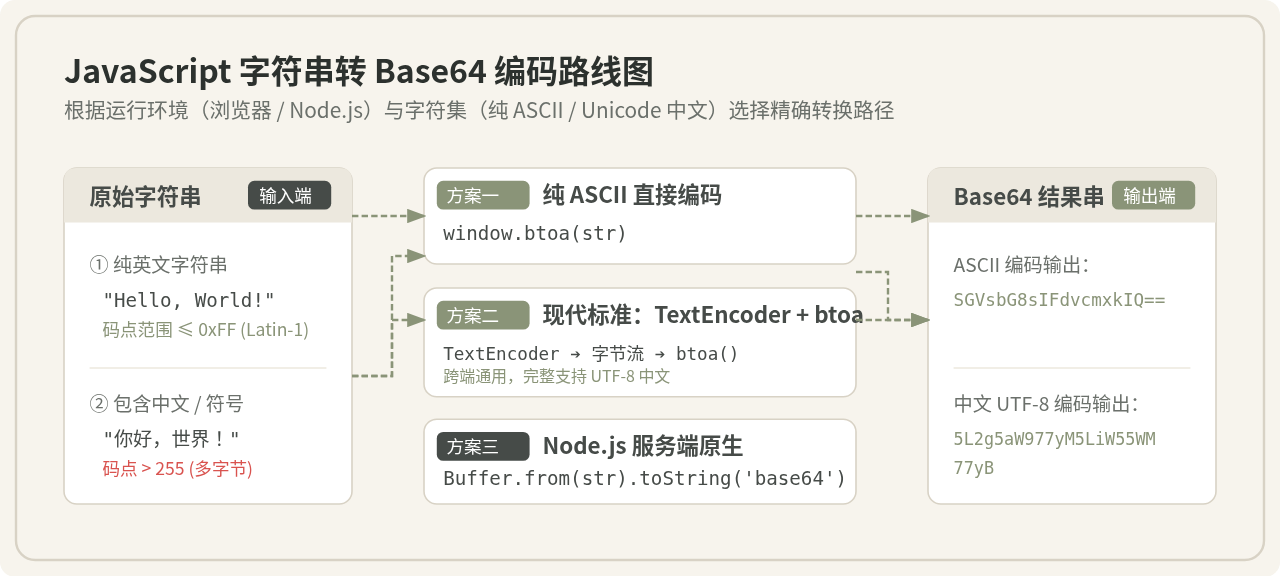
在 JavaScript 中,将字符串转为 Base64 字符串的常规解决路径由运行环境与字符编码决定:若在浏览器端处理纯 ASCII 字符串,可直接调用内置的
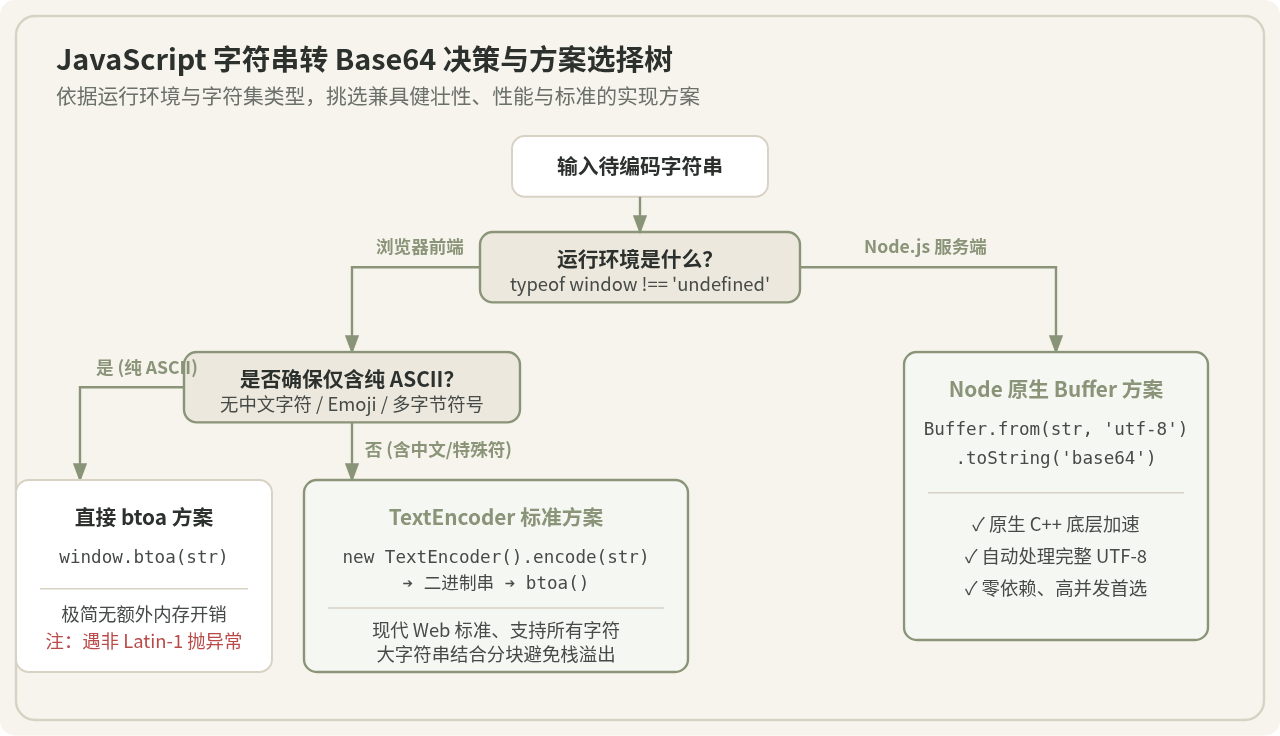
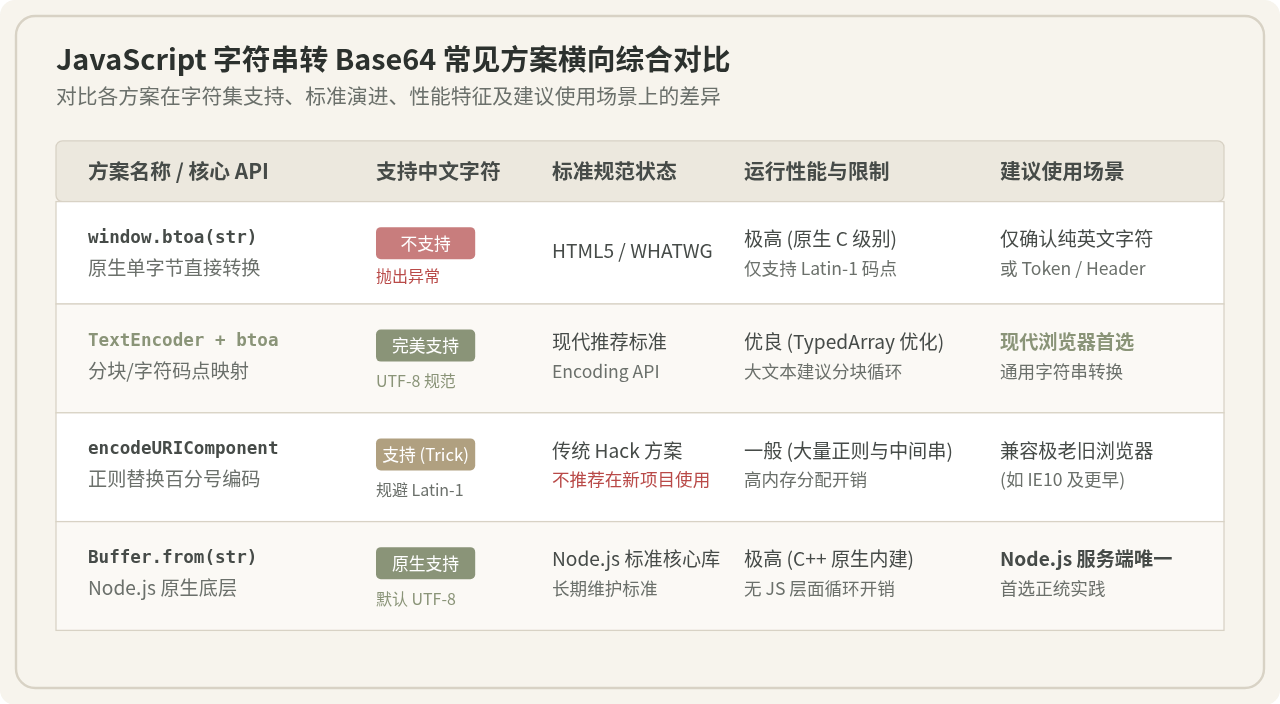
window.btoa(str);若字符串包含中文、生僻字或多字节 Unicode 符号,直接调用 btoa 会触发范围异常,现代标准做法是通过 TextEncoder 将字符转为 UTF-8 字节序列后再转为 Base64;若在 Node.js 服务端,则直接使用原生的 Buffer.from(str, 'utf-8').toString('base64')。
一、为什么 btoa 不能直接处理中文字符串?
初学者在尝试使用 btoa() 转换中文字符串时,最常遇到的现象是控制台直接报错。例如执行以下代码:
// 尝试直接转换中文
const str = "你好,世界";
const base64 = btoa(str);
// 报错:Uncaught DOMException: Failed to execute 'btoa' on 'Window':
// The string to be encoded contains characters outside of the Latin1 range.
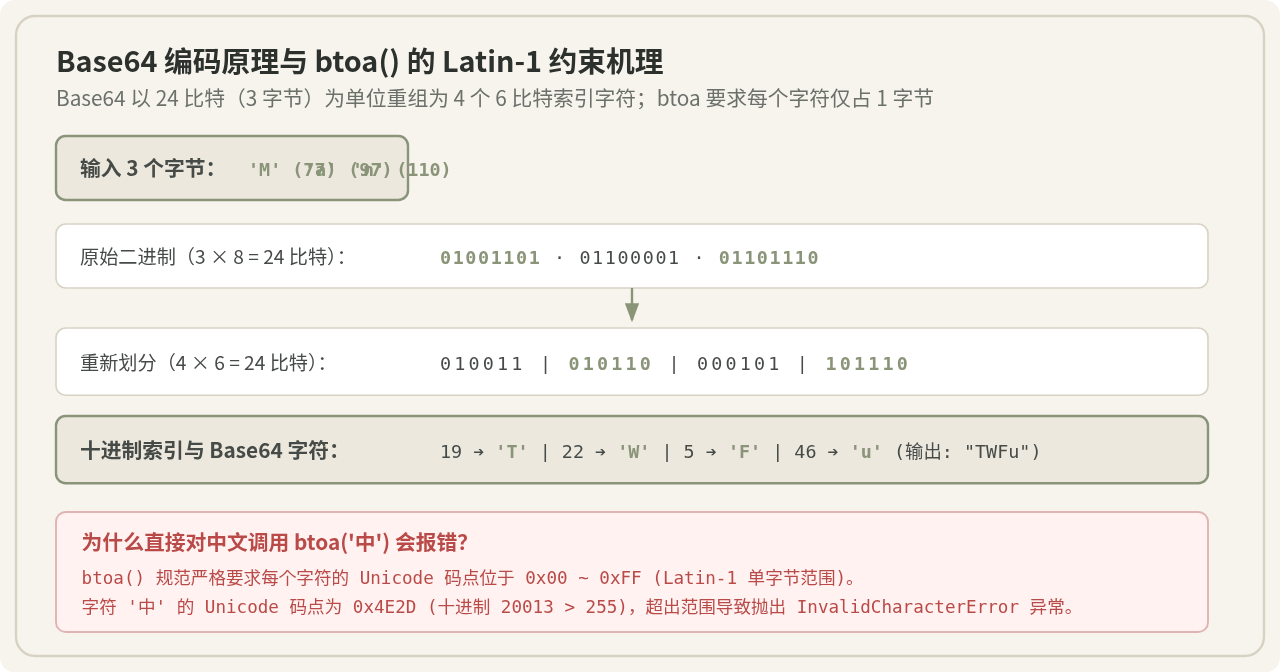
这一报错的根源在于 btoa 的底层规范。Base64 编码的本质是将每 3 个字节(共 24 个比特位)拆分成 4 组、每组 6 个比特位,并根据 Base64 字符映射表输出 4 个可打印字符。浏览器规范对 btoa 输入字符串的定义是“二进制字符串(Binary String)”,即该字符串中的每一个字符单元必须视作一个单字节数据,其字符码点(Code Point)必须落在 0x00 ~ 0xFF(0 到 255)的 Latin-1 范围内。
然而,现代 JavaScript 字符串采用 UTF-16 内存表示。英文 ASCII 字符的码点小于 128,完全处于 Latin-1 单字节范围;但中文字符(例如“你”的码点为 0x4F60,即十进制 20320)远远超过了 255 的上限。btoa 无法直接知道高码位应如何按字节切分,因此规范强制要求抛出 InvalidCharacterError 异常以避免数据静默损坏。
二、现代浏览器端:支持中文的通用标准方案
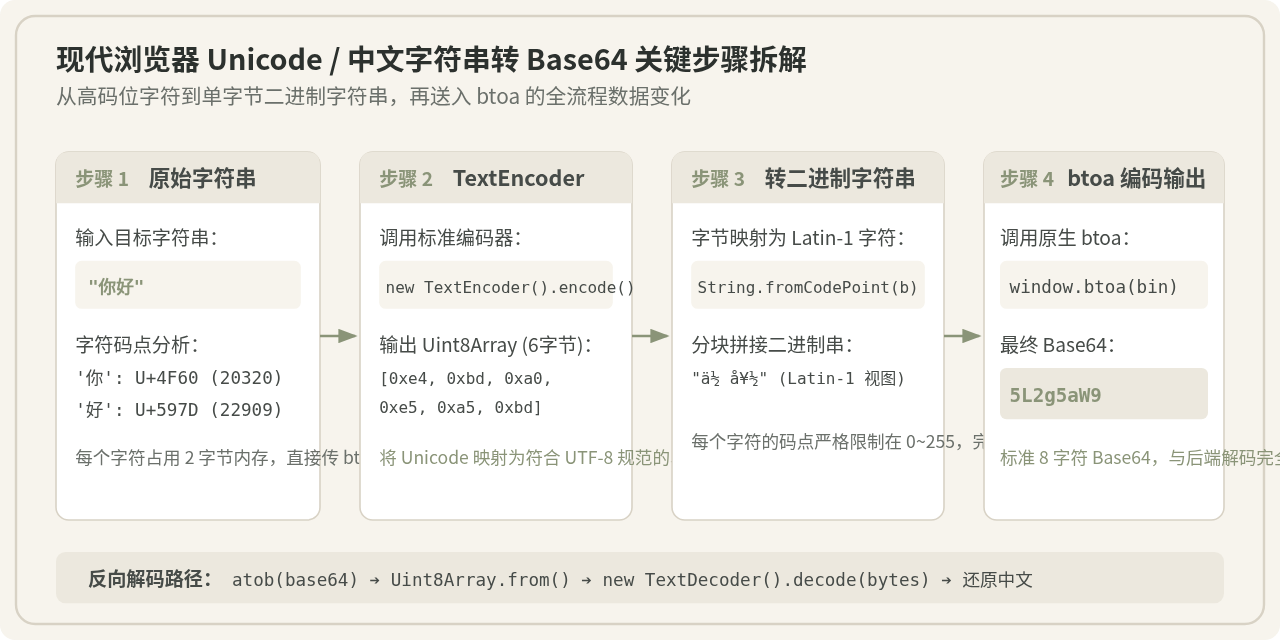
为了让 btoa 正确处理包含中文的任意 Unicode 字符串,标准的解决思路是两步走:
- 使用浏览器内置的
TextEncoder,将字符串按照标准的 UTF-8 规则编码为字节数组(Uint8Array)。 - 将这组字节数组还原为符合 Latin-1 单字节码点约束的二进制字符串,再送入
btoa()进行编码。
1. 简洁实现代码
对于绝大多数常规长度的文本,可以通过 Array.from 或映射函数将字节依次转为单字节字符:
/**
 * 现代浏览器通用:将任意 JavaScript 字符串安全转换为 Base64
 * @param {string} str 待编码字符串(支持中文、Emoji 及多字节字符)
 * @returns {string} Base64 编码字符串
 */
function stringToBase64(str) {
  // 1. 使用 TextEncoder 获取 UTF-8 编码字节流 (Uint8Array)
  const bytes = new TextEncoder().encode(str);

  // 2. 将每个字节按 0~255 单字节字符还原为二进制字符串
  const binString = Array.from(bytes, (byte) => String.fromCodePoint(byte)).join('');

  // 3. 交由原生 btoa 完成 Base64 编码
  return btoa(binString);
}

// 示例验证
const input = "你好,世界!Hello World!";
const result = stringToBase64(input);
console.log(result);
// 输出: 5L2g5aW977yM5LiW55WM77yISGVsbG8gV29ybGQh
2. 长文本溢出规避(分块优化版)
部分教程会使用 String.fromCharCode(...bytes) 或 String.fromCharCode.apply(null, bytes) 进行一次性转换。这种写法在字符串较短时没有问题,但当待转换字符串较长(例如超过数万字或大文本)时,过多的参数会导致 JavaScript 引擎抛出 RangeError: Maximum call stack size exceeded(调用栈溢出)。
生产环境中处理较大文本时,建议采用分块(Chunking)循环切片拼接:
/**
 * 高性能分块版:规避展开语法在大数据量下的栈溢出问题
 */
function stringToBase64Safe(str) {
  const bytes = new TextEncoder().encode(str);
  const CHUNK_SIZE = 0x8000; // 32KB 分块大小
  let binaryString = '';

  for (let i = 0; i < bytes.length; i += CHUNK_SIZE) {
    const chunk = bytes.subarray(i, i + CHUNK_SIZE);
    binaryString += String.fromCharCode.apply(null, chunk);
  }

  return btoa(binaryString);
}
三、常见遗留写法辨析:encodeURIComponent + btoa
在查阅一些早期的技术文章时,常会见到类似如下的代码片段:
// 遗留技巧写法(不推荐在新代码中使用)
function legacyBase64Encode(str) {
  return btoa(encodeURIComponent(str).replace(/%([0-9A-F]{2})/g, function(match, p1) {
    return String.fromCharCode('0x' + p1);
  }));
}
为什么这种写法看似能正常工作?
encodeURIComponent 会将非 ASCII 字符转换为 UTF-8 字节并以百分号十六进制形式表达(例如中文字符“你”变成 %E4%BD%A0)。随后的正则替换利用 String.fromCharCode('0x' + p1) 将 E4、BD、A0 等两位的十六进制数值直接转为对应的单字节字符,从而将 Unicode 强行拼装成符合 Latin-1 范围的假单字节串,最后传给 btoa。
为什么现在不再推荐这种写法?
- 不必要的字符串膨胀与内存开销:
encodeURIComponent首先将原始字符展开为冗长的百分号字符串,随后正则回调又创建大量临时小对象,对垃圾回收(GC)造成额外压力。 - 意图不明确且易出错:
encodeURIComponent的本职是 URL 转义而非字符集转换,利用副作用实现编解码属于典型的 Hack 手法。 - 现代标准完全就绪:
TextEncoder和TextDecoder早在 2017 年前后就已成为所有主流浏览器(Chrome、Firefox、Safari、Edge)及 Node.js 的内建标准,直接使用标准 TypedArray 不仅语义清晰,执行效率也显著更高。
四、Node.js 服务端环境下的推荐做法
在 Node.js 服务端,处理 Base64 编码无需使用 btoa,因为 Node.js 原生提供了高效的 Buffer 模块。Buffer 由底层的 C++ 层面实现,直接对接内存操作,是处理二进制与编码转换的标准方案。
1. Node.js 标准编码方法
// Node.js 服务端编码
function nodeStringToBase64(str) {
  return Buffer.from(str, 'utf-8').toString('base64');
}

// 示例
const content = "使用 Buffer 转换中文 Base64";
const b64 = nodeStringToBase64(content);
console.log(b64);
// 输出: 5L2/55SoIEJ1ZmZlciDosazmjaLkuK3mlocgQmFzZTY0
关于 Node.js 16+ 中的全局 btoa
Node.js 从 v16.0.0 开始在全局作用域中引入了与浏览器一致的 btoa() 函数。但是,它的行为完全遵循 WHATWG 浏览器标准,依然要求输入字符在 Latin-1 范围内。因此在 Node.js 中若传入中文字符,btoa() 同样会报错。在服务端编写代码时,请始终优先使用 Buffer.from(str, 'utf-8').toString('base64')。
五、反向解码:Base64 字符串如何还原为 JS 字符串?
完成编码后,逆向的解码流程同样需要兼顾字符编码,才能保证中文字符不出现乱码。
1. 现代浏览器端标准反向解码
先使用 atob() 将 Base64 解码为二进制字符串,提取每个字符的单字节码点构成 Uint8Array,最后由 TextDecoder 按照 UTF-8 还原为原始字符串:
/**
 * 现代浏览器通用:将 Base64 字符串安全解码还原为原始字符串
 * @param {string} base64Str 待解码的 Base64 字符串
 * @returns {string} 解码后的原始字符串(含中文支持)
 */
function base64ToString(base64Str) {
  // 1. 原生 atob 解码为单字节二进制字符串
  const binString = atob(base64Str);

  // 2. 将每个字符的码点转换为 Uint8Array 字节数组
  const bytes = Uint8Array.from(binString, (char) => char.codePointAt(0));

  // 3. 使用 TextDecoder 还原 UTF-8 字符
  return new TextDecoder().decode(bytes);
}

// 验证反向解码
const encoded = "5L2g5aW977yM5LiW55WM";
console.log(base64ToString(encoded));
// 正确输出: "你好,世界"
2. Node.js 反向解码
Node.js 服务端执行对应的反向操作极为简明:
function nodeBase64ToString(base64Str) {
  return Buffer.from(base64Str, 'base64').toString('utf-8');
}
六、工程实践中的注意事项与常见陷阱
-
URL 安全变体(Base64URL):
标准的 Base64 编码包含
+、/以及末尾补位符号=。若将生成的 Base64 字符串直接放置在 URL Query 参数中,+会被很多服务端解析为空格,导致解码失败。若在 URL 场景传输,应转换为 Base64URL 格式:// 转为 URL 安全的 Base64 变体 function toBase64Url(base64) { return base64.replace(/\+/g, '-').replace(/\//g, '_').replace(/=+$/, ''); } -
补位符
=的处理: Base64 要求输入字节数必须能被 3 整除,不足时在末尾补充 1 到 2 个=。部分服务端接口返回的 Base64 会省略=,在前端调用atob()前需确保补齐长度为 4 的整数倍,否则atob会抛出The string to be decoded is not correctly encoded错误。 -
跨端环境适配函数:
如果编写的代码需要同时在浏览器与 Node.js 混用(如 Universal / Isomorphic 模块),可通过检测全局对象进行环境自适应分流:
function universalStringToBase64(str) {
  if (typeof Buffer !== 'undefined') {
    return Buffer.from(str, 'utf-8').toString('base64');
  }
  const bytes = new TextEncoder().encode(str);
  const binString = Array.from(bytes, (b) => String.fromCodePoint(b)).join('');
  return btoa(binString);
}
七、核心要点总结
将 JavaScript 字符串转换为 Base64 字符串的核心要点可归结为三条规则:
- 区分字符编码:
btoa是专为单字节(Latin-1)设计的原生工具;处理多字节的中文和特殊符号时,必须先行通过TextEncoder进行 UTF-8 字节转换。 - 弃用 Hack 方案:
encodeURIComponent替换法已成为历史,现代项目应坚定使用TextEncoder与TextDecoder标准 API。 - 明确运行环境: 浏览器端使用
TextEncoder + btoa(大文本配合分块);Node.js 服务端始终首选Buffer.from().toString('base64')。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章