
深入解析在 JavaScript 中使用 split('') 将包含 Emoji 的字符串转换为数组时出现拆分为两个元素的底层原因,详解 UTF-16 编码机制、Unicode 码点与代理对原理,并给出从 ES6 展开运算符到现代 Intl.Segmenter 的完整解决方案与工程实践指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组为什么emoji变成两个元素
作者:半夏
时间:2026-11-13
浏览:564
文章目录
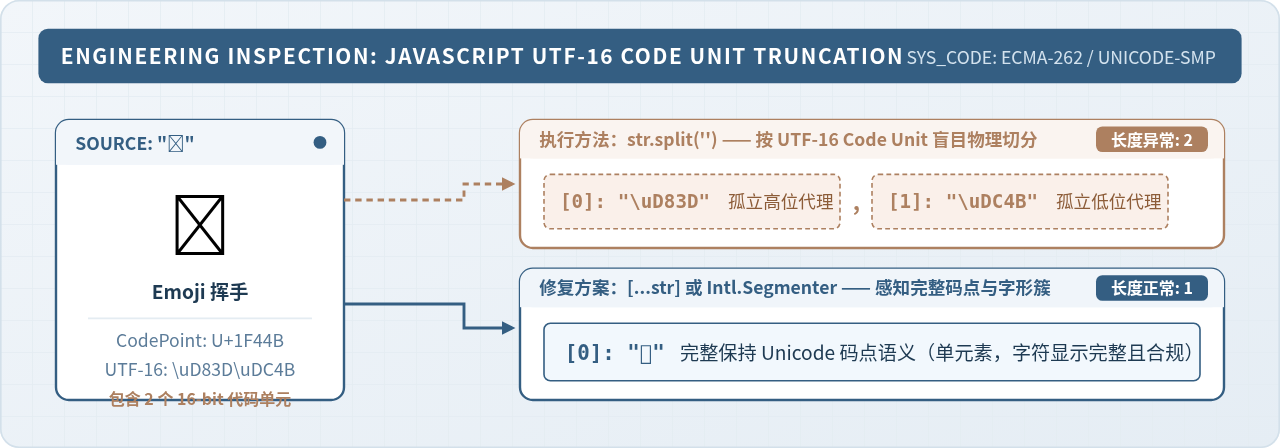
在 JavaScript 中使用 str.split('') 将包含 Emoji 的字符串转为数组时,出现一个 Emoji 被拆分为两个元素的原因在于:JavaScript 的字符串底层采用 UTF-16 编码单元(Code Unit,16 位)进行索引与物理存储,而 split('') 仅机械地按单个 16 位代码单元逐一刀切,并不感知 Unicode 字符的语义边界。日常字母与常见汉字位于 Unicode 的基本多语言平面(BMP),占用 1 个 16 位代码单元;而绝大多数 Emoji 位于辅助平面,必须使用由“高位代理”和“低位代理”组成的代理对(Surrogate Pair,共 2 个 16 位代码单元)来表示。split('') 强行将这一对代理切断,产生两个非法的半字符元素。要正确将 Emoji 转换为独立数组元素,应使用感知 Unicode 代码点的 ES6 语法 [...str],或使用专门识别视觉字形簇的现代标准 Intl.Segmenter。
一、问题复现:看似简单的 split('') 为什么会踩坑
在开发用户输入长度限制、字符翻转、打字机动画或昵称处理等前端功能时,很多开发者习惯使用 str.split('') 将字符串快速分割为单字符数组。然而,当输入文本中包含表情符号(Emoji)时,就会出现意料之外的长度膨胀与乱码。
可以通过以下极简代码复现该问题:
// 示例 1:split('') 导致的切分异常
const text = "Hi!😀";

// 预期:["H", "i", "!", "😀"],数组长度应为 4
const result = text.split('');

console.log(result.length); // 示例输出:5
console.log(result);
// 示例输出:["H", "i", "!", "\uD83D", "\uDE00"]

console.log(result[3]); // 示例输出:"\uD83D"(在控制台显示为乱码或空白占位符)
console.log(result[4]); // 示例输出:"\uDE00"(同为不合法的半字符)
可以看到,原字符串表面上只有 4 个肉眼可见的字符,但通过 split('') 切分后得到的数组长度却是 5。表情符号 😀 并未作为一个完整的元素保留,而是被割裂成了 \uD83D 和 \uDE00 两个不可独立显示的单元。如果后续对该数组执行 result.reverse().join('') 翻转,或者通过切片截取前几个字符,就会导致乱码甚至崩溃。
二、底层机制:Unicode 码点与 JavaScript 的 UTF-16 历史包袱
要彻底搞懂这个现象,必须追溯 JavaScript 处理字符编码的历史根源。
1. UCS-2 到 UTF-16 的历史沿革
JavaScript 诞生于 1995 年。彼时,国际 Unicode 标准仅收录了不到 65536 个字符,认为使用定长的 16 位(2 字节)空间即可表示全球所有语言文字,这一方案被称为 UCS-2。网景公司在设计 JavaScript 运行时,便直接选用了 16 位的字符串底层存储模型。
然而,随着数字化进程加速,Unicode 收录的字符迅速突破 65536 的上限。为了向后兼容,Unicode 引入了平面划分机制(共划分为 17 个平面,编码范围扩展至 U+0000 到 U+10FFFF),并制定了 UTF-16 变长编码规范。JavaScript 随之将底层解释机制升级为 UTF-16,但为了保持向后兼容,字符串的许多基础 API(如 str.length、str.charAt()、str.charCodeAt() 以及 str.split(''))依然保留了“以 16 位为一个步长单位”的原始行为。
2. 基本平面(BMP)与辅助平面的差异
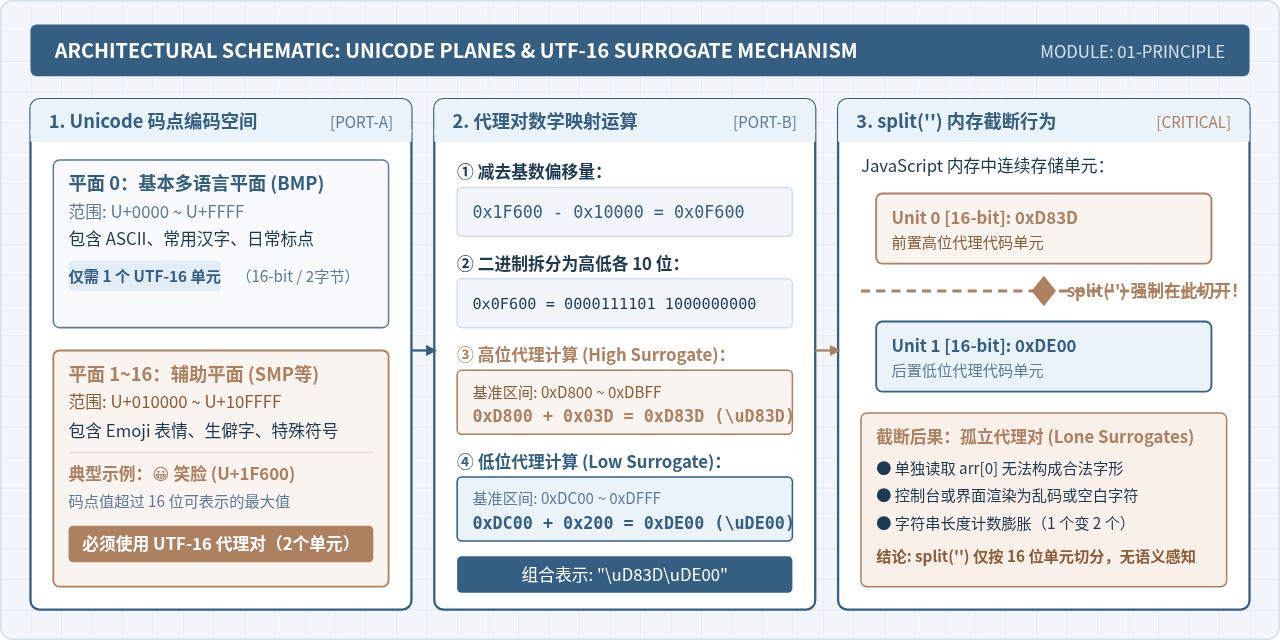
Unicode 将字符空间分为两大类:
- 基本多语言平面(BMP,Plane 0):范围从
U+0000到U+FFFF。涵盖了英文字母、常用汉字(如“中”字为U+4E2D)、日韩假名和常见标点符号。这些字符在 UTF-16 中刚好占用一个 16 位的代码单元(Code Unit),因此split('')处理它们时表现正常。 - 辅助平面(Supplementary Planes,Plane 1~16):范围从
U+010000到U+10FFFF。包含了历史古文字、罕见汉字以及日常使用极其频繁的 Emoji 表情符号(如大部分 Emoji 集中在第一辅助平面 SMP,U+1F300 ~ U+1FAFF)。
3. 代理对(Surrogate Pair)运算与推导
由于辅助平面中的码点数值超过了 16 位的容纳极限(0xFFFF),UTF-16 巧妙地在基本平面中保留了一段未分配给任何实际字符的“保留空洞”,专门用来作为代理标记:
- 高位代理(High Surrogate / Leading Surrogate):取值区间为
0xD800~0xDBFF(共 1024 个码位)。 - 低位代理(Low Surrogate / Trailing Surrogate):取值区间为
0xDC00~0xDFFF(共 1024 个码位)。
当一个字符的 Unicode 码点 C ≥ 0x10000 时,UTF-16 将其拆分为一对代理单元。具体计算推导过程如下:
- 扣除偏移量:计算有效载荷 C' = C - 0x10000。由于 C ≤ 0x10FFFF,C' 恰好是一个 20 位的二进制数(0x00000 到 0xFFFFF)。
- 高 10 位映射:取出 C' 的高 10 位(右移 10 位),加上高位代理基数
0xD800,得到高位代理单元。 - 低 10 位映射:取出 C' 的低 10 位(与
0x3FF进行与运算),加上低位代理基数0xDC00,得到低位代理单元。
数学算例推导:以 Emoji
1. 偏移计算:
2. 高 10 位:
3. 低 10 位:
4. 最终在 UTF-16 内存中以两个 16-bit 单元存储:
😀(U+1F600)为例1. 偏移计算:
0x1F600 - 0x10000 = 0x0F600,展开为 20 位二进制:0000111101 1000000000。2. 高 10 位:
0000111101(十六进制为 0x03D)。高位代理 = 0xD800 + 0x03D = 0xD83D。3. 低 10 位:
1000000000(十六进制为 0x200)。低位代理 = 0xDC00 + 0x200 = 0xDE00。4. 最终在 UTF-16 内存中以两个 16-bit 单元存储:
\uD83D 紧跟 \uDE00。
由于 split('') 的底层规范定义为“在每个 16 位代码单元边界进行分割”,它并不检查这两个单元是否构成一个代理对,因而直接在 \uD83D 与 \uDE00 中间切了一刀,导致本来完整的单个 Emoji 字符被硬生生解构成两个数组元素。
三、正确转换方案:如何安全地将字符串转为字符数组
要避免 Emoji 被切断,核心是改用感知 Unicode 完整代码点(Code Point)或感知人类视觉字形簇(Grapheme Cluster)的 API。以下是工程中经过充分验证的三种正确做法。
方法一:ES6 展开运算符 [...str](首选基础方案)
ECMAScript 2015 (ES6) 引入了迭代器协议(Iteration Protocols),并为 String.prototype 实现了内置的 [Symbol.iterator]。该迭代器在遍历字符串时,会自动检测高位代理与低位代理并将其成对合并,每次迭代返回一个完整的 Unicode 代码点。
// 示例 2:使用 ES6 展开运算符安全转换
const text = "Hi!😀";
const arr = [...text];

console.log(arr.length); // 示例输出:4
console.log(arr);        // 示例输出:["H", "i", "!", "😀"]
console.log(arr[3]); // 示例输出:"😀"(完整表情,无损坏)适用场景:语法最简洁直观,在现代前端构建工具(如 Vite、Webpack)和 Node.js 环境中完全通用,能完美解决所有单码点 Emoji 的分割问题。
方法二:Array.from(str)(兼顾转换与映射)
Array.from() 同样基于字符串的 [Symbol.iterator] 协议,在内部逐一消费 Unicode 代码点。它还支持传入第二个映射函数参数,适合需要在转数组的同时对每个字符进行处理的场景。
// 示例 3:使用 Array.from() 进行转换并做映射
const text = "A😀B🎉";
const arr = Array.from(text, (char, index) => index + ": " + char);

console.log(arr.length); // 示例输出:4
console.log(arr);
// 示例输出:["0: A", "1: 😀", "2: B", "3: 🎉"]
方法三:带 u 修饰符的正规表达式 str.match(/./gu)
在正则表达式中,默认的点号 . 也是按 16 位代码单元匹配的。但加上 u(Unicode)修饰符后,正则表达式引擎会开启完整的 Unicode 码点匹配模式。
// 示例 4:正则 unicode 模式切分
const text = "Hi!😀";
const arr = text.match(/./gu) || [];

console.log(arr.length); // 示例输出:4
console.log(arr);        // 示例输出:["H", "i", "!", "😀"]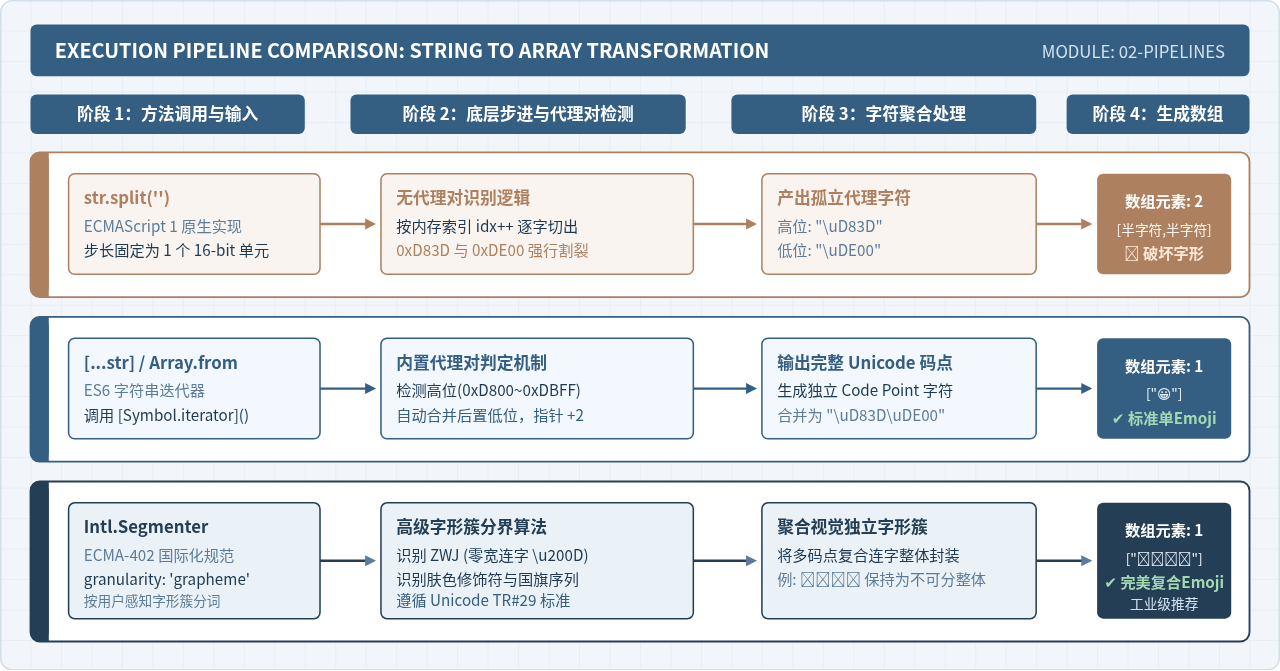
四、进阶隐患:复合 Emoji 为什么连 Array.from 也会失效
很多开发者认为掌握了 [...str] 就彻底解决了 Emoji 的处理问题。然而在真实业务中,一旦用户输入了更复杂的 Emoji,[...str] 依然会再次“失灵”。
1. 复合 Emoji 的三种常见形态
现代 Unicode 标准为了表达丰富的现实世界含义,并不为每一个新表情单独分配一个独立码点,而是通过组合多个基础码点来呈现一个新表情:
- 肤色修饰符(Fitzpatrick Modifiers):例如带深肤色的挥手
👋🏽,由基础手势👋(U+1F44B)加上肤色码点🏽(U+1F3FD)拼合而成。 - 国旗序列(Regional Indicator Symbols):例如中国国旗
🇨🇳,由两个字母符号🇨(U+1F1E8)和🇳(U+1F1F3)组合呈现。 - 零宽连字序列(ZWJ, Zero-Width Joiner):通过不可见的控制字符
\u200D(零宽连字)将多个角色粘合成一个整体。最具代表性的是家庭 Emoji👨👩👧👦。
深度剖析:家庭 Emoji
这个视觉上单一的表情,在底层其实是由 7 个 Unicode 码点链式连接而成的:
其在 UTF-16 内存中占用了整整 11 个代码单元!
👨👩👧👦 的底层解构这个视觉上单一的表情,在底层其实是由 7 个 Unicode 码点链式连接而成的:
👨 (U+1F468) + ZWJ (\u200D) + 👩 (U+1F469) + ZWJ (\u200D) + 👧 (U+1F467) + ZWJ (\u200D) + 👦 (U+1F466)其在 UTF-16 内存中占用了整整 11 个代码单元!
如果用不同方法去分割这个复合 Emoji,结果差异极为明显:
// 示例 5:复合 Emoji 在不同方法下的分割行为
const family = "👨👩👧👦";
console.log(family.split('').length); // 示例输出:11(彻底破坏所有代理对)
console.log([...family].length); // 示例输出:7(按码点拆开,ZWJ 单独成为元素)
console.log([...family]);
// 示例输出:["👨", "\u200D", "👩", "\u200D", "👧", "\u200D", "👦"]
可以看到,[...family] 虽然没有破坏底层的 16 位代理对,但它破坏了 ZWJ 连字语义,把一家人活生生拆成了 4 个独立人像和 3 个不可见的连字标记!这在用户感知层面同样是不符合预期的。
2. 终极工业级方案:Intl.Segmenter
人类肉眼感知的“一个字符”,在 Unicode 术语中称为扩展字形簇(Extended Grapheme Cluster)。ECMAScript 国际化 API 规范(ECMA-402)推出了标准的文本分词利器——Intl.Segmenter,它内置了 Unicode TR#29 文本分界算法,能够准确将复合 Emoji 识别为不可分割的单一视觉字形:
// 示例 6:使用 Intl.Segmenter 实现真正的人类视觉单字切分
function splitToGraphemes(str) {
// 创建按字形簇粒度切分的分词器
const segmenter = new Intl.Segmenter('zh-Hans', { granularity: 'grapheme' });
const segments = segmenter.segment(str);
// 提取每一个独立的字形簇文本
return Array.from(segments, s => s.segment);
}
// 验证测试:
console.log(splitToGraphemes("Hi!😀"));
// 示例输出:["H", "i", "!", "😀"],长度 4
console.log(splitToGraphemes("👨👩👧👦"));
// 示例输出:["👨👩👧👦"],长度 1!(完美保持为单个完整元素)
console.log(splitToGraphemes("中国🇨🇳加油"));
// 示例输出:["中", "国", "🇨🇳", "加", "油"],长度 5!(国旗不被拆散)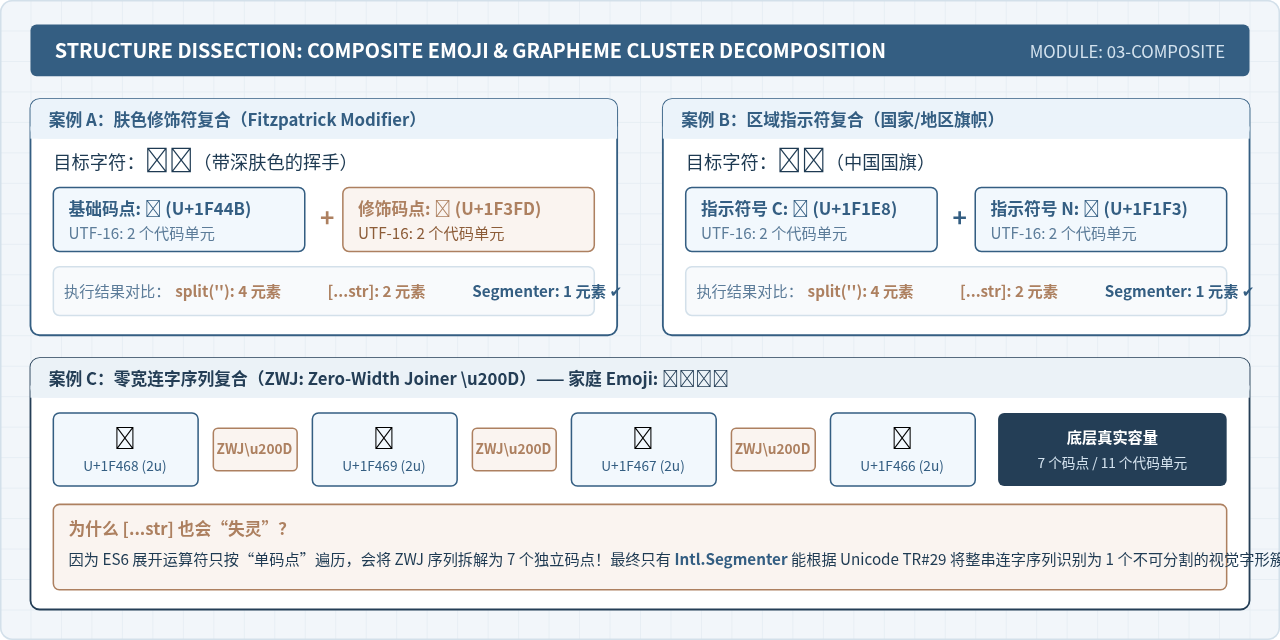
五、工程实践与技术选型指南
在实际项目开发中,选择哪种方式将字符串转为数组,需要结合业务输入场景、浏览器兼容性以及性能敏感度进行权衡。
| 切分方式 | 底层遵循标准 | 普通 Emoji (😀) | 复合 Emoji (👨👩👧👦) | 性能开销 | 推荐使用场景 |
|---|---|---|---|---|---|
str.split('') |
16-bit Code Unit | ❌ 异常(切分为 2) | ❌ 异常(切分为 11) | 极低(纯内存复制) | 内部受控协议、纯 ASCII/Base64、已确定无多字节字符的场景 |
[...str] |
Unicode Code Point | ✔ 正常(长度 1) | ❌ 拆解(切分为 7) | 低(迭代器扫描) | 常规前端业务、轻量级字符分割、单表情展示 |
Array.from(str) |
Unicode Code Point | ✔ 正常(长度 1) | ❌ 拆解(切分为 7) | 低(迭代器扫描) | 转数组同时需要执行 map 转换回调的场景 |
Intl.Segmenter |
Grapheme Cluster | ✔ 正常(长度 1) | ✔ 完美保持(长度 1) | 中等(需状态机分词) | 强力推荐:评论区字数统计、富文本编辑器、昵称截断、复杂排版 |
常见陷阱与注意事项
-
千万不要使用
str.slice或str.substring随意截断用户输入:如果截断位置恰巧落在代理对的高位与低位之间,会直接造成高位代理孤立,导致接口报错或数据库存储乱码(如 MySQL utf8mb4 字段报错)。正确的截断做法是先通过Intl.Segmenter转为字形数组,再切取前 N 个元素后使用join('')重组。 -
表单输入字数统计的统一性:许多产品需求中规定“最多输入 20 个字”,如果直接读取
input.value.length,用户输入 10 个 Emoji 就会提示超过 20 字符,导致极差的用户体验。应统一封装getGraphemeLength(str)函数替代原生.length。 -
环境兼容性考量:
Intl.Segmenter已经获得 Chrome 87+、Edge 87+、Safari 14.1+、Firefox 125+ 以及 Node.js 16+ 的全主流环境支持。如果需要兼容更低版本的极老旧环境,可以使用社区成熟且经过规范认证的垫片库(如grapheme-splitter)。
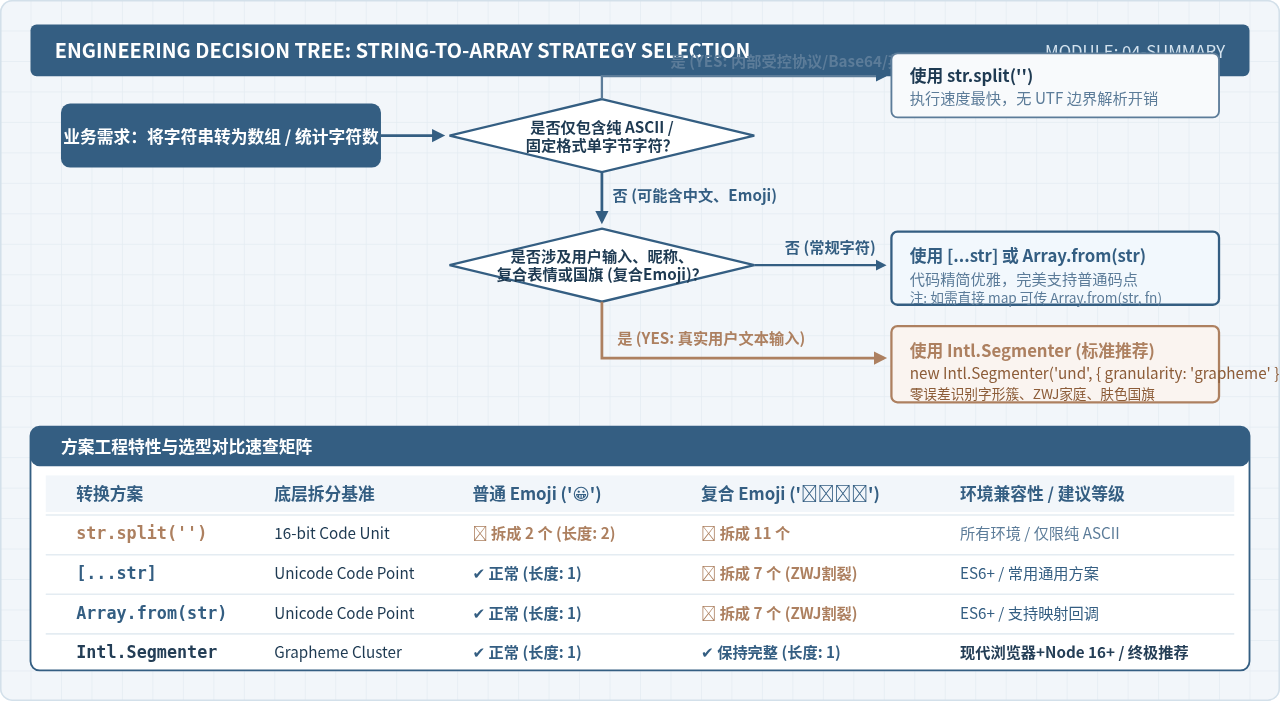
六、总结
回顾标题中的核心疑问——“js字符串转数组为什么emoji变成两个元素”,关键结论可以提炼为以下四点:
- 核心根源:JavaScript 字符串在底层遵循 UTF-16 编码模型,传统 API
str.split('')以 16 位的代码单元(Code Unit)为物理基准进行机械切割。 - 代理对机制:Emoji 处于 Unicode 辅助平面,需要占用两个 16 位单元构成的代理对(高位代理 + 低位代理)。
split('')将代理对强行撕裂,产生了两个无法独立存在的非法半字符。 - 通用修复方案:对于常规单码点 Emoji,使用 ES6 展开运算符
[...str]或Array.from(str)即可,它们通过字符串迭代器自动合并代理对。 - 工业级终极方案:针对包含肤色修饰符、国旗序列及 ZWJ 零宽连字(如
👨👩👧👦)的复杂用户输入,应当采用现代标准的Intl.Segmenter,按人类视觉感知的“字形簇(Grapheme Cluster)”进行安全切分,从根源上杜绝乱码与计数失真。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章