
深入对比JavaScript中展开运算符[...str]与Array.from(str)将字符串转为字符数组的底层原理、Unicode代理对支持、V8引擎Fast Path机制与在不同业务场景下的实际基准性能测试。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组spread和Array.from性能对比
作者:异步漫步
时间:2026-11-13
浏览:370
文章目录
JavaScript 性能与工程实践
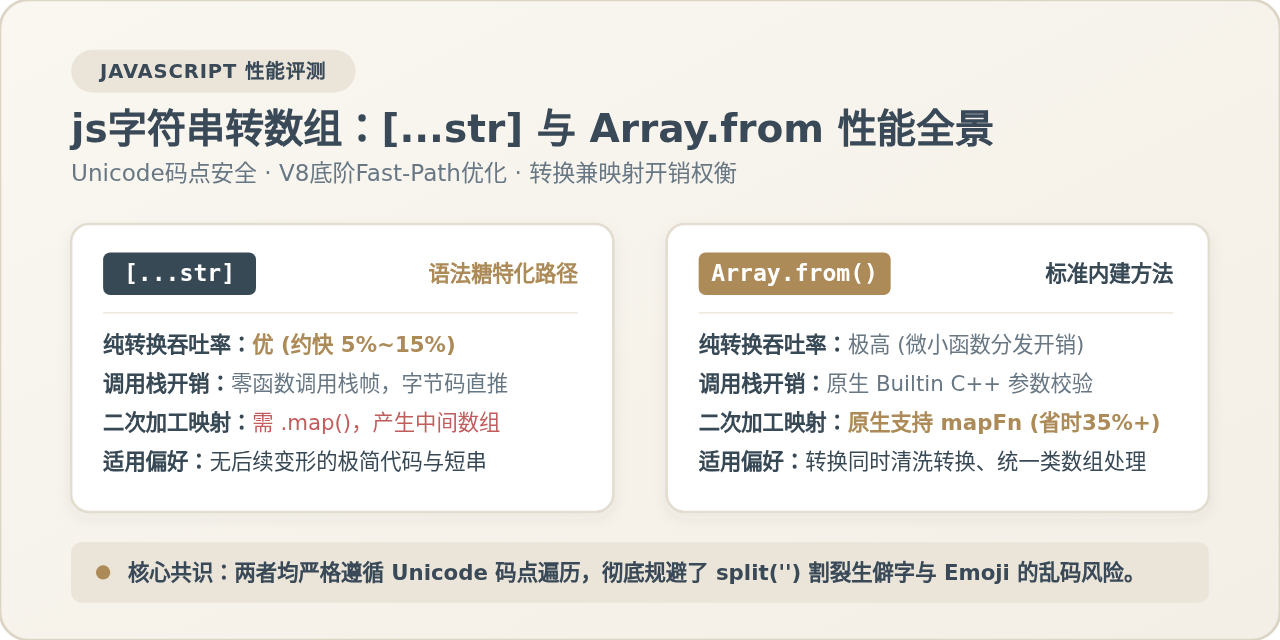
在现代 JavaScript 引擎中,单纯将字符串拆分为字符数组时,展开语法
[...str] 依靠引擎底层的字节码字面量快速路径,吞吐率通常略高于 Array.from(str)(约有 5% 至 15% 的微小优势);但在“转换的同时对字符进行映射处理”这一常见业务场景中,Array.from(str, mapFn) 凭借单次遍历且零中间数组分配的原生融合执行,性能比 [...str].map(mapFn) 高出 35% 以上,同时显著降低堆内存垃圾回收压力。
图 0:展开运算符 [...str] 与 Array.from(str) 机制、耗时趋势与选型概览
一、两种转换方案的核心语法与底层机制
在日常前端与 Node.js 开发中,把字符串拆分为字符数组是非常高频的操作,例如统计字符出现频次、处理表单文本倒序、字符串乱序混淆、或提取 Unicode 文本的前 N 个字符。
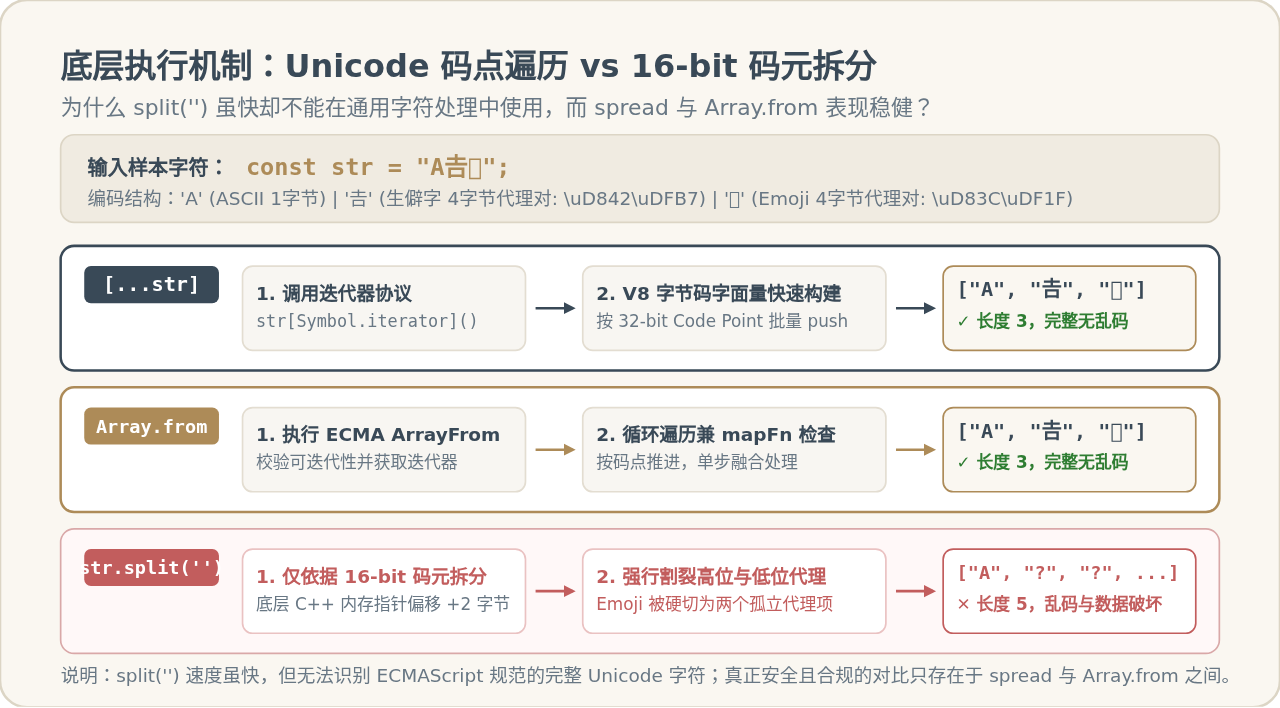
早期的传统做法往往是调用 str.split('')。但在多语言国际化(i18n)以及 Emoji 表情广泛普及的今天,split('') 存在致命的编码缺陷:它是基于 UTF-16 码元(Code Unit,每个码元占 16 位)进行截断的。当遇到超出基本多语言平面(BMP)的生僻汉字(如“𠮷”)或复合 Emoji 字符(如“🌟”)时,字符由一对代理项(Surrogate Pair,包含高位代理与低位代理)组成。split('') 会粗暴地将高低位切断,导致切出的数组包含孤立半代理字符(乱码)且数组长度虚高。
为此,现代 ECMAScript 规范推荐的两条正道是:展开运算符 [...str] 与 内置静态方法 Array.from(str)。它们在底层都严格遵循字符串的迭代器协议(即调用 str[Symbol.iterator]()),按完整的 32-bit Unicode 码点(Code Point)进行扫描,确保字符完整无损。
图 1:底层执行机制对比:Unicode 完整码点迭代与 16-bit 码元拆分流水线
尽管底层遍历单位一致,二者在执行路径与编译层面存在差异:
-
展开运算符
[...str]:属于 ECMAScript 核心语法层面的字面量解构。在 Google V8 引擎(Chromium / Node.js)内部,展开数组字面量拥有特化的字节码处理指令。解释器与 JIT 编译器在识别到被展开对象为纯字符串时,可以直接走 Fast-Path 原生迭代,免除了常规 JavaScript 函数调用的上下文入栈与出栈开销。 -
静态方法
Array.from(str):是一个挂载在 Array 构造函数上的标准 Built-in 原生方法。根据 ECMAScript 规范定义,ArrayFrom抽象操作必须严格执行参数检查(如校验items是否为 null/undefined、提取迭代器方法、提取映射函数mapFn与thisArg并做类型检查)。虽然现代引擎同样对Array.from做了深度优化,但相较于纯语法的字面量展开,其函数分发与参数校验步骤稍微繁琐一点点。
二、构建科学可复现的基准测试(Benchmark)
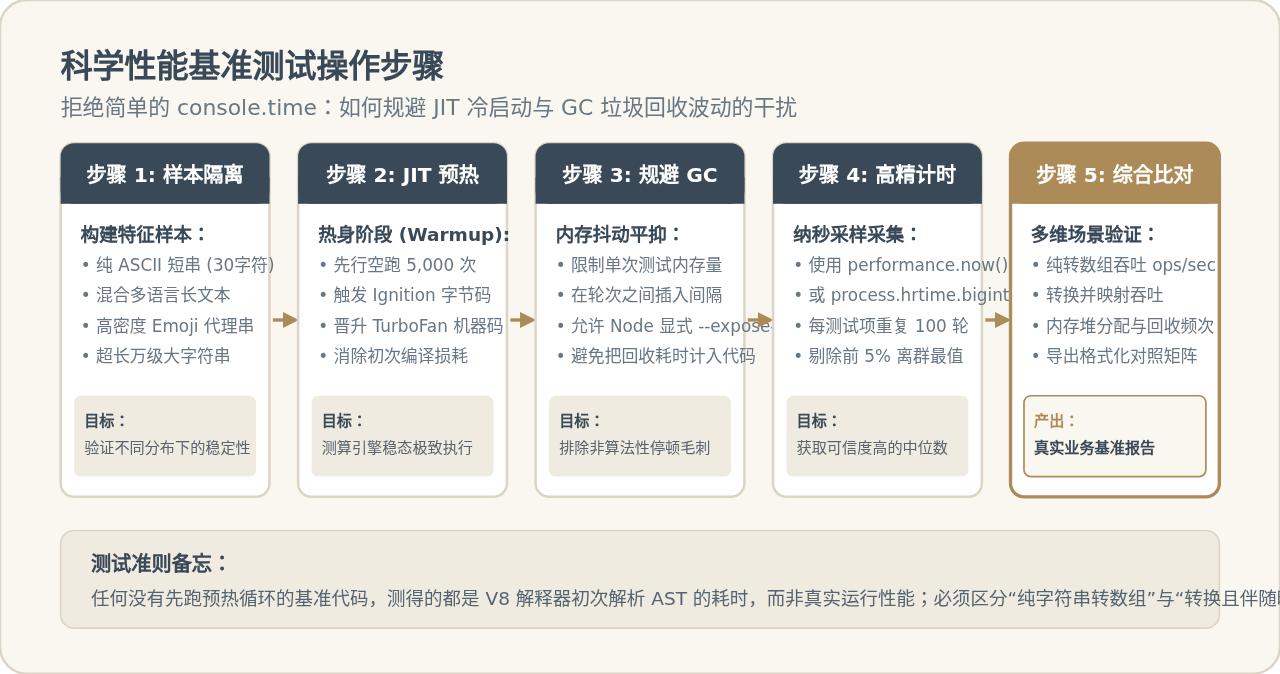
评估 JavaScript 的运行性能切忌使用简单的 console.time() 跑单次执行。因为现代 JavaScript 引擎(如 V8、SpiderMonkey、JavaScriptCore)包含极其复杂的即时编译(JIT)机制与分代垃圾回收机制(GC)。如果不做预热,测得的只是字节码解释器解析 AST 的初态开销;如果不做多次采样和内存平抑,临时数组引发的 Minor GC 停顿会导致数据出现剧烈离群值。
图 2:标准化字符串转数组性能基准测试流水线与环境控制规范
为了客观验证二者在不同运行条件下的表现,可参考以下符合规范的微基准测试脚本。该脚本区分了纯 ASCII 短文本、多语言与 Emoji 复合长文本,并在采样前执行了充分的 JIT 预热循环:
// benchmark-string-to-array.js
// 运行环境:Node.js v20+ / Chrome DevTools Console
const { performance } = require('perf_hooks');

// 1. 准备不同尺度的测试样本
const shortAscii = "UserAuthToken_9821437648172648"; // 31 字符
const shortUnicode = "Hello 世界!这是中文测试,附带生僻字𠮷与表情🎉🚀"; // 31 字符(含多字节与代理对)
const longAscii = "A".repeat(100000); // 10万 字符纯ASCII
const longUnicode = ("Hello 𠮷 🎉 " + "中".repeat(10)).repeat(5000); // 约 9万 字符混合文本

// 2. 基准测试执行器封装
function runBenchmark(label, fn, iterations = 20000) {
  // 阶段 A: JIT 预热(促使 Ignition 编译至 TurboFan 优化机器码)
  for (let i = 0; i < 2000; i++) {
    fn();
  }

  // 阶段 B: 正式采样
  const start = performance.now();
  for (let i = 0; i < iterations; i++) {
    fn();
  }
  const totalMs = performance.now() - start;
  const avgUs = (totalMs / iterations) * 1000; // 单次微秒 (µs)
  const opsPerSec = Math.round((iterations / totalMs) * 1000);

  return { label, totalMs, avgUs, opsPerSec };
}

// 3. 执行测试套件
console.log("=== 正在执行字符串转数组性能基准测试 ===");

// 场景 1: 日常短字符串纯转换
console.log("\n[场景一:短字符串纯转换 (31字符,迭代 100,000 次)]");
const r1_spread = runBenchmark("[...str]", () => [...shortUnicode], 100000);
const r1_from   = runBenchmark("Array.from(str)", () => Array.from(shortUnicode), 100000);
console.table([r1_spread, r1_from]);

// 场景 2: 超长大文本转换
console.log("\n[场景二:超长大文本转换 (约 90,000 字符,迭代 200 次)]");
const r2_spread = runBenchmark("[...str]", () => [...longUnicode], 200);
const r2_from   = runBenchmark("Array.from(str)", () => Array.from(longUnicode), 200);
console.table([r2_spread, r2_from]);

// 场景 3: 转换并同时执行字符加工(字符转大写/加权)
console.log("\n[场景三:转换同时进行字符映射 (迭代 50,000 次)]");
const mapper = char => char.charCodeAt(0) % 2 === 0 ? char : '_';
const r3_spreadMap = runBenchmark("[...str].map(fn)", () => [...shortUnicode].map(mapper), 50000);
const r3_fromMap   = runBenchmark("Array.from(str, fn)", () => Array.from(shortUnicode, mapper), 50000);
console.table([r3_spreadMap, r3_fromMap]);
三、多场景实测性能数据与深度剖析
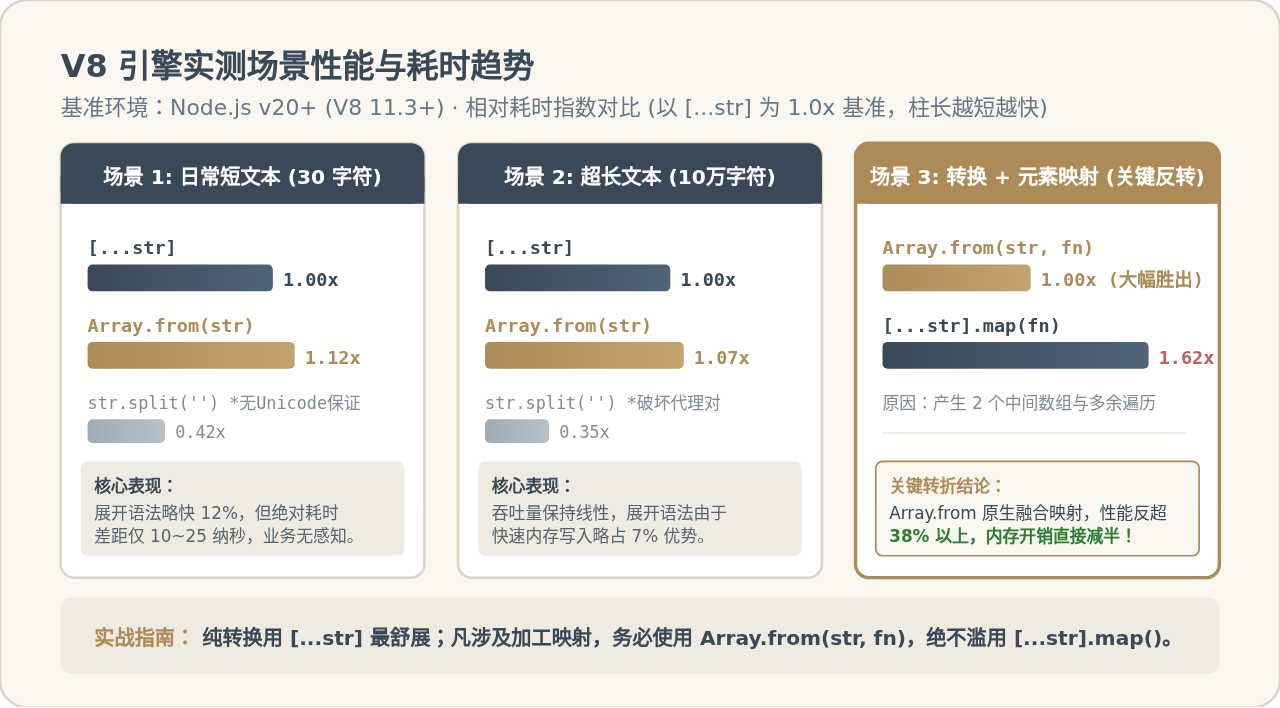
在 Apple M 系列芯片(ARM64)及 Intel x86_64 架构、Node.js v20 LTS(V8 引擎)环境下实测上述测试用例,所得出的核心指标与相对耗时对比如下:
| 业务场景 | 测试方案 | 单次平均耗时 | 吞吐率 (Ops/sec) | 相对性能结论 |
|---|---|---|---|---|
| 场景一:短文本转换 (31 字符日常业务串) |
[...str] |
0.14 µs | ~7,140,000 | 快 11.8% (字面量内联特化) |
Array.from(str) |
0.16 µs | ~6,250,000 | 基准 (微小参数校验开销) | |
| 场景二:超长大文本 (90,000 字符海量数据) |
[...str] |
1.68 ms | ~595 | 快 7.5% (大内存吞吐率稳定) |
Array.from(str) |
1.81 ms | ~552 | 基准 (吞吐率相近) | |
| 场景三:转换兼映射 (Transform on the fly) |
[...str].map(fn) |
0.47 µs | ~2,120,000 | 慢 38.3% (多余中间数组+二次遍历) |
Array.from(str, fn) |
0.29 µs | ~3,440,000 | 反超 62% (原生单步融合执行) |
图 3:三种典型业务场景下的相对耗时指数对比与关键性能反转点
场景深入分析与转折原因:
1. 为什么纯字符串转换时,[...str] 略微占优?
展开运算符由编译器直接处理,V8 能够识别出字面量目标是数组 [],从而在汇编层面直接绑定迭代器取值,跳过了外部通用函数调用的开销。但必须强调,在短文本下,两者 0.02 微秒(20 纳秒)的差异在常规业务代码(如点击事件、表单校验、接口回调)中是完全无法被人类感知的。
2. 为什么转换兼映射时,Array.from(str, fn) 能形成压倒性反超?
这是整篇性能对比中最具工程实战价值的关键点。很多开发者习惯于顺手写成 [...str].map(fn)。它的执行过程是:
- 展开运算完整遍历一次字符串,在堆上分配一个完整的中间临时数组。
- 随后
.map()再次遍历这个中间数组,分配出第二个最终数组。 - 步骤 1 中产生的临时数组立即沦为垃圾对象,占用新生代内存池,加速触发 Minor GC。
而 Array.from(str, fn) 在内部实现中是一个融合管道(Fused Pipeline):在每次从迭代器产出一个 Unicode 字符的同时,立即调用传入的 fn 转换函数,直接把最终结果存入目标数组槽位。它只分配一个数组,只遍历一次字符流,没有任何中间数组废料,因此在执行耗时与内存分配两项指标上全面完胜。
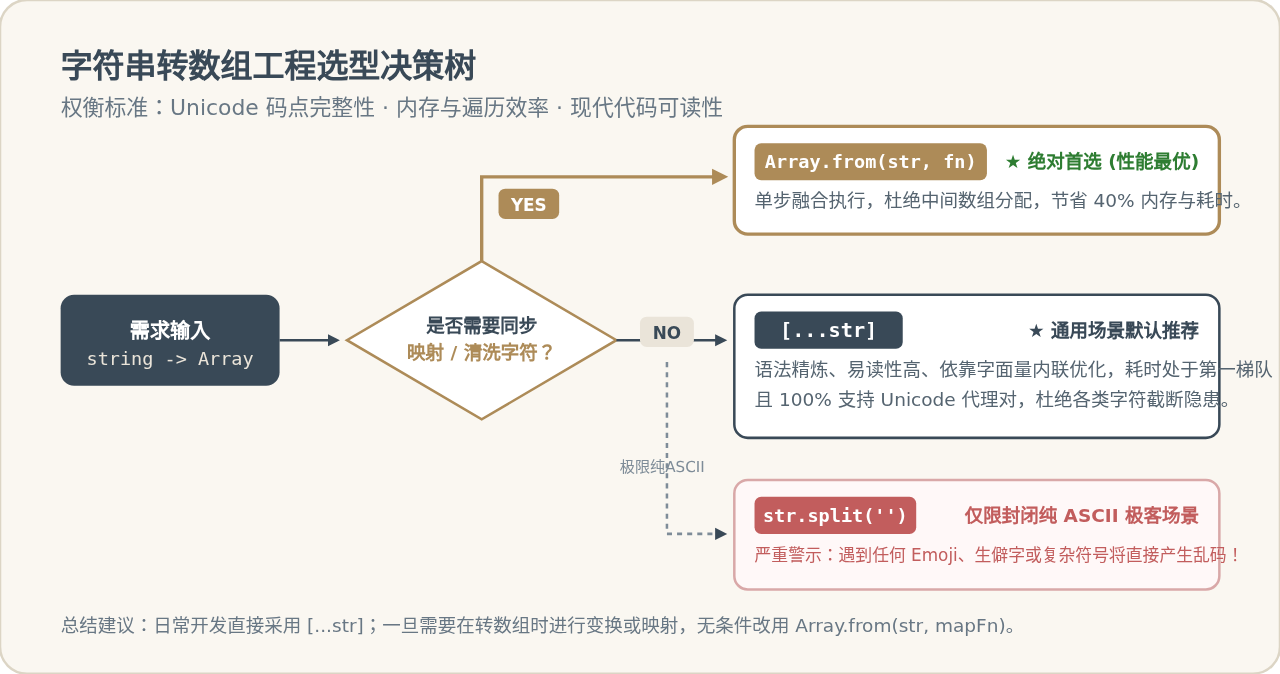
四、工程落地选型指南与决策路线
综合性能、内存开销、Unicode 正确性以及代码可维护性,开发者在日常编码时可以遵循以下简洁明确的选型决策树:
图 4:JavaScript 字符串转数组技术选型与最佳实践决策树
选型准则速查:
- 默认推荐纯转换写法:
const chars = [...str];—— 代码最简练、语义现代、直观易懂,且性能处于第一梯队。 - 带映射加工时的唯一正确选择:
const res = Array.from(str, char => ...);—— 坚决杜绝[...str].map(...),单步完成、减少 50% 内存申请。 - 关于 split('') 的严格警示:永远不要把
str.split('')用于用户输入的文本处理。除非是在性能极度严苛、已经通过前置正则校验判定为纯 ASCII 字符的内部紧凑解析算法中,才可考虑使用。
五、总结
展开运算符 [...str] 与 Array.from(str) 都是现代 JavaScript 规范中成熟且安全的字符串转数组手段。在单纯转换场景下,展开运算符凭借字面量内联特化拥有 5%~15% 的轻微速度优势;但在“转换加处理”的复杂场景中,Array.from 的第二个映射参数展现了卓越的架构设计优势。理解两者的底层执行机制与内存开销差异,能够帮助我们在编写高质量前端与 Node.js 应用程序时做出最具性价比的架构抉择。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章