
深入对比 JavaScript 中 parseInt 与 Number() 在字符串转整数时的核心机制差异,包括逐字符解析与严格类型转换、特殊边界值、浮点数截断陷阱与最佳编码实践。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串转整数:parseInt与Number()的核心区别
作者:百宝袋
时间:2026-11-12
浏览:362
文章目录
在 JavaScript 中,将字符串转为整数最直接的两种方式是 parseInt() 与 Number()。虽然面对纯数字如 "42" 时两者都能得到预期结果,但它们的底层设计完全不同:parseInt() 是一个逐字符容错解析器(Parser),负责从字符串开头提取合法整数字符直至遇到非法字符;而 Number() 是一个严格类型转换器(Type Converter),执行规范层面的全量转换,只要出现任何非纯数字格式字符便整体失效返回 NaN。理解两者的这种本质差异,是避免线上隐蔽类型 Bug 的关键。
一、解析机制差异:逐字符提取 vs 严格全量转换
parseInt() 的工作方式是“能解析多少就解析多少”。它会首先忽略字符串开头的空白字符,接着检查可选的正负号,然后开始逐位读取字符。只要读取到的字符属于指定进制下的有效数字字符,就会持续累加计算;一旦遇到第一个非数字字符(例如 "px"、"kg" 或小数点 "."),它就会立即停止扫描,并将前面已经成功识别的部分转换为整数返回。只有当第一个非空字符本身就不是有效数字时,才会输出 NaN。
相比之下,Number() 调用的是 ECMAScript 规范内置的 ToNumber 抽象操作。它要求传入的值整体必须是一个合法的数值字面量格式。如果字符串中混杂了任何非数字字符(除有效符号、前后空格、十六进制/二进制前缀以及科学计数法指数符号外),整个转换过程就会判定失败,直接返回 NaN。
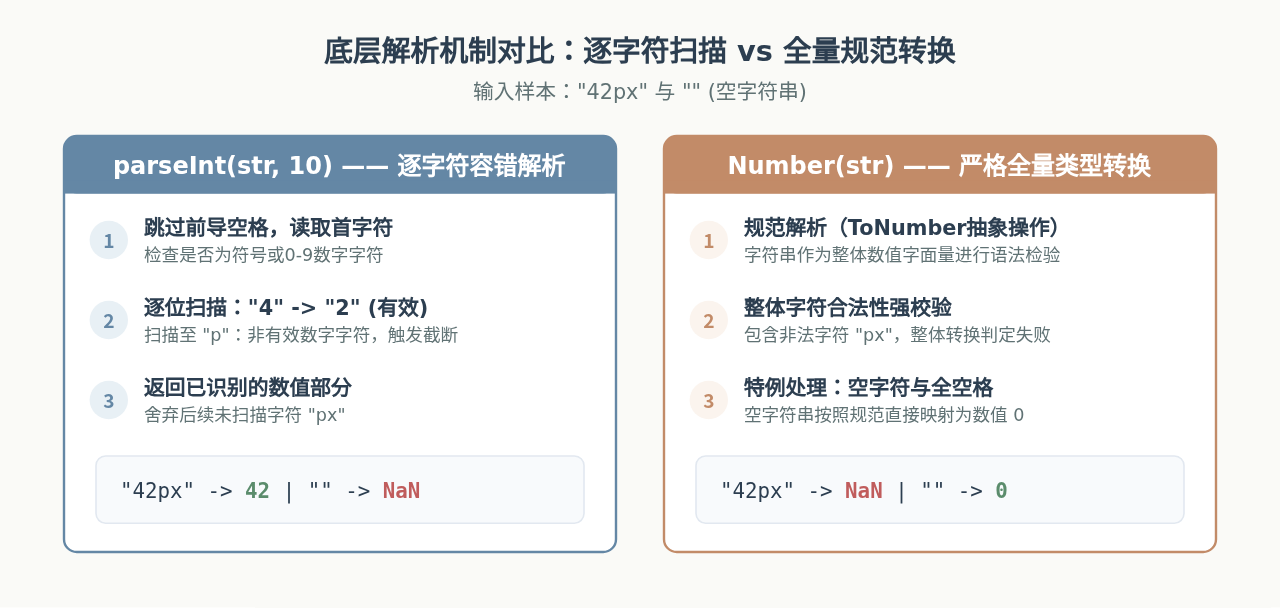
通过下方代码示例可以更直观地观察两者的行为反差:
// 1. 尾随非数字字符(如CSS像素、单位)
parseInt("100px", 10); // 100 (容错提取)
Number("100px");       // NaN (整体校验失败)

// 2. 字符串中间包含非数字
parseInt("10a20", 10); // 10  (遇到 'a' 立即停止)
Number("10a20");       // NaN

// 3. 开头即为非数字字符
parseInt("v2.0", 10);  // NaN (首个有效字符为 'v')
Number("v2.0");        // NaN
二、边界值与非数值类型的处理陷阱
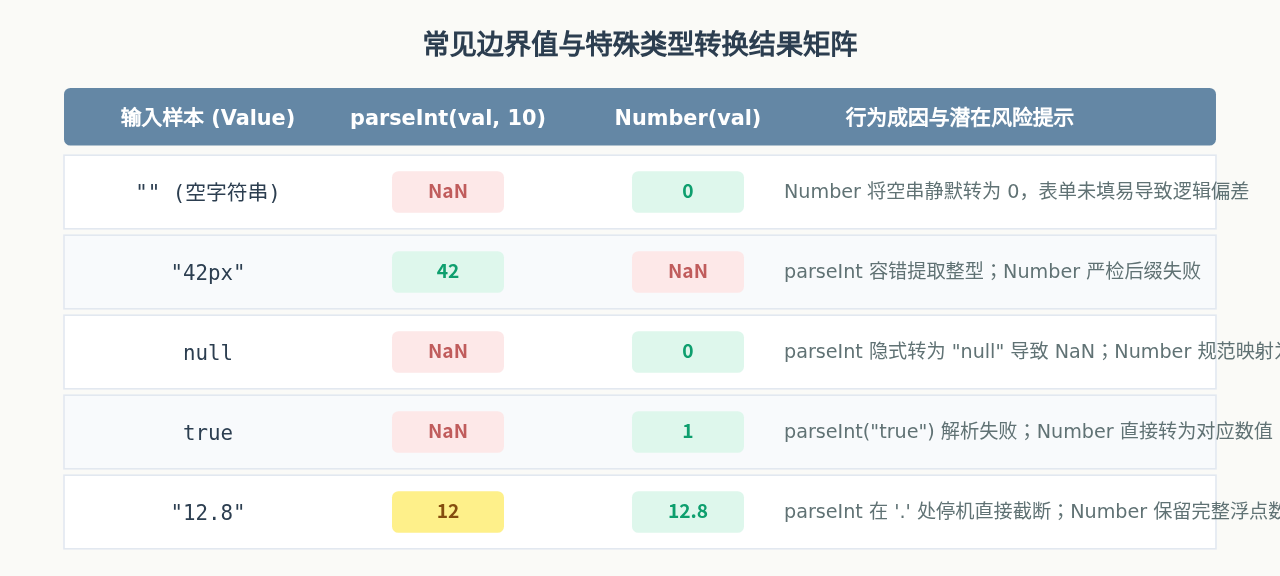
在实际业务中,输入数据不仅包含带单位的字符串,还常常出现空字符串、布尔值、null 或 undefined。面对这些边界情况,parseInt() 与 Number() 的差异极易引发隐藏 Bug。
1. 空字符串与纯空格字符串
这是前端表单校验最常见的坑点之一。当输入框为空("")或仅包含空格(" ")时:
parseInt("")返回NaN:因为在跳过前导空格后,没有找到任何可识别的数字字符。Number("")返回0:规范规定空字符串对应数值 0。如果未做前置判断直接使用Number()处理空表单项,空值就会被静默当成 0 进入计算。
2. null 与 undefined
parseInt() 的入参规范要求首先将入参隐式转换为字符串(执行 ToString),然后再进行解析:
- 对于
null,parseInt(null)实际上等同于parseInt("null", 10)。由于首字符"n"不是有效数字,输出NaN。而Number(null)按照原生类型映射规则,被转换为数值0。 - 对于
undefined,parseInt(undefined)会转化为parseInt("undefined", 10),输出NaN;而Number(undefined)规范定义结果亦为NaN。
三、浮点数处理与科学计数法的隐藏陷阱
本文的核心主题是“转整数”。在这点上,两者的行为逻辑再次出现分流:
-
浮点数字符串处理:
对字符串
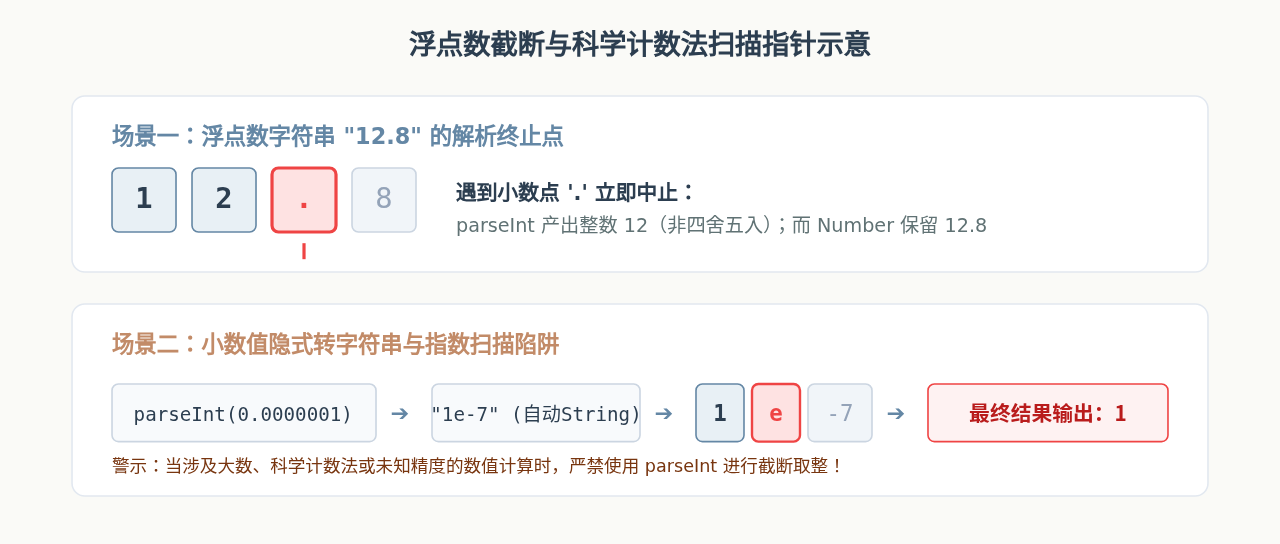
"12.34",parseInt("12.34", 10)读取到小数点"."时,判定其为非数字字符,立即停止读取,从而直接返回整数12。注意,这种截断属于直接向下截断(向零取整),并非四舍五入。而Number("12.34")会保留小数位输出12.34,如果要获得整数,还必须额外调用Math.trunc()或Math.floor()。 -
科学计数法的致命陷阱:
对于带有科学计数法的数值或超大/超小数值,
parseInt()存在极为著名的语言机制陷阱。
深度解析:为什么 parseInt(0.0000001) 会返回 1?
在 JavaScript 中,当数值小于
1e-6 时,其默认的 toString() 操作会自动转为科学计数法格式,即 String(0.0000001) 的结果是 "1e-7"。当执行 parseInt(0.0000001, 10) 时,它实际是在执行 parseInt("1e-7", 10)。扫描器读取到 '1' 后遇到 'e'(在十进制下不是合法数字),立刻停止扫描,直接返回 1!同理,parseInt("1e21", 10) 也会返回 1,而不是期待的一万亿亿。
四、进制解析(Radix)与前缀规则
parseInt() 的签名中包含第二个参数 radix(基数,范围为 2 到 36)。这是 Number() 所不具备的能力。
// parseInt 支持自定义任意 2~36 进制转换
parseInt("1010", 2);  // 10 (二进制转十进制)
parseInt("77", 8);    // 63 (八进制转十进制)
parseInt("2F", 16);   // 47 (十六进制转十进制)
为什么必须显式传递 radix=10?
如果不传 radix,JavaScript 会依据字符串特征进行自动推测:
- 若以
"0x"或"0X"开头,自动判定为十六进制:parseInt("0x10") === 16。 - 在早期 ECMAScript 规范中,以
"0"开头的字符串常被推断为八进制(如parseInt("070") === 56),虽然现代标准默认按十进制处理,但在不同运行环境或旧浏览器中极易造成不一致。因此,在任何情况下使用parseInt,都应养成显式声明parseInt(str, 10)的习惯。
而 Number() 虽然不支持传入指定 radix,但支持现代标准前缀语法:Number("0x10")(十六进制,结果 16)、Number("0b1010")(二进制,结果 10)、Number("0o77")(八进制,结果 63)。如果字符串不带标准前缀,则只能按十进制整体转换。
五、综合选型决策与最佳实践
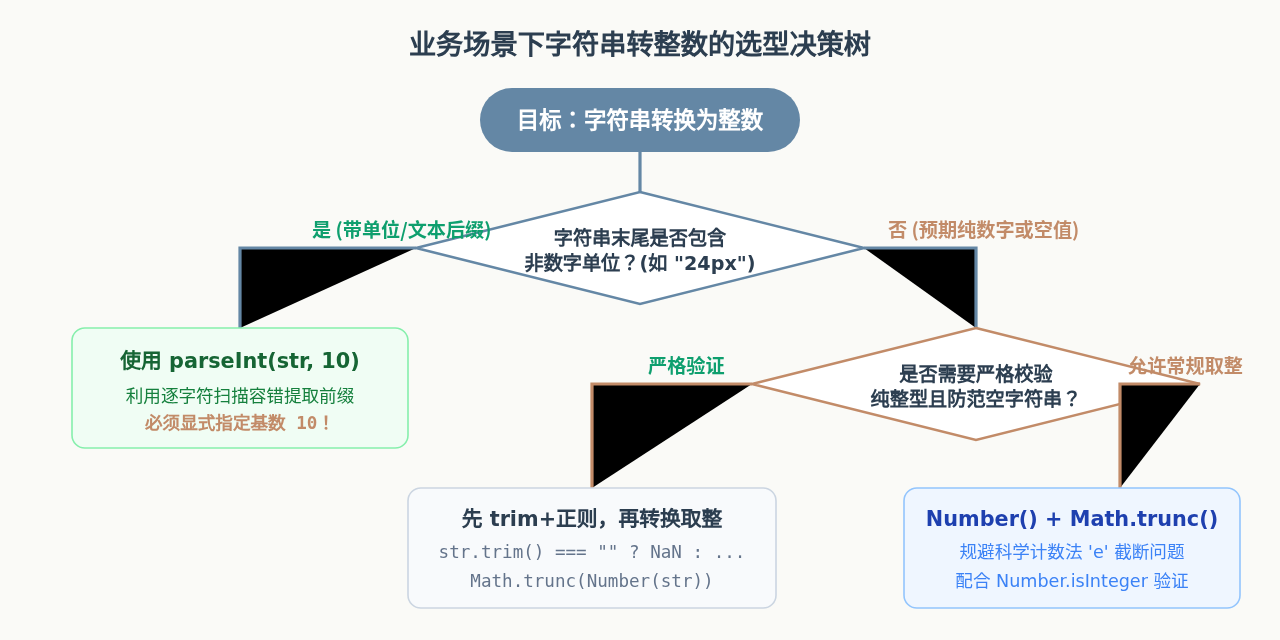
在实际项目开发中,选择 parseInt(str, 10) 还是 Number(),取决于业务对“容错性”和“严格性”的需求。
选型总结清单
-
提取 CSS 或字符串中的前置数值:优先选
parseInt(str, 10)。
如处理"32px"、"100ms"、"1.5rem"(转整),利用其遇到非数字停机的机制最为简洁。务必时刻携带第二个参数10。 -
接口通信、URL 参数与表单输入:优先考虑非空校验 +
Number()+ 截整函数。
因为表单若误输入"123a",parseInt会误将其当作123保存,从而掩盖用户的输入错误;而Number("123a")能立即暴露出NaN,便于提示用户格式非法。同时必须谨记:在调用Number()之前先排查空字符串,避免""被错误解析为0。 -
浮点数直接截整:避免直接使用
parseInt处理数值型入参。
若变量本身已经是数值(如let x = 12.8),转整数应当使用标准数学函数Math.trunc(x)(向零取整)或Math.floor(x)(向下取整),切忌套用parseInt(x),以防触发微小数值转换为科学计数法字符串后的解析事故。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章