
详细讲解在JavaScript中格式化HTML时如何完整保留script和style标签内容的两种核心方案:占位隔离法与工具库原生配置法。包含完整代码示例、执行步骤、SVG流程图示及常见避坑指南。

当前位置:首页 > JavaScript 代码规范与重构 > 正文
JS格式化HTML时怎么保留script和style标签内容
作者:百宝袋
时间:2026-11-12
浏览:151
文章目录
在 JavaScript 中格式化 HTML 字符串时,直接按普通 HTML 标签拆分缩进会导致
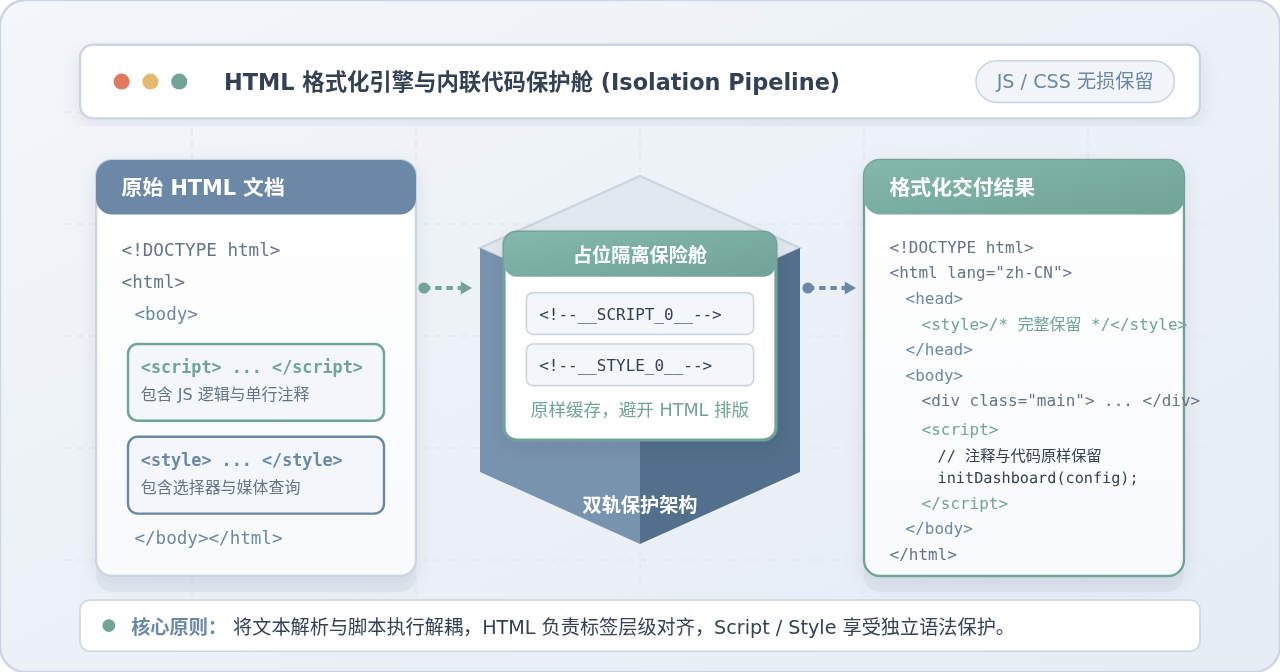
<script> 和 <style> 内部的代码语法受损。最可靠且通用的解决路径是“占位隔离还原法”:在格式化前提取两者的原始代码块并替换为安全的注释占位符,完成 HTML 骨架缩进后再逆向回填;若已引入成熟格式化库(如 js-beautify),则可通过配置 content_unformatted: ['script', 'style'] 直接跳过内部排版。本文将详细讲解这一问题的根源、两种解决方式的具体实现与边界陷阱。
一、为什么 script 和 style 标签内容容易被格式化破坏
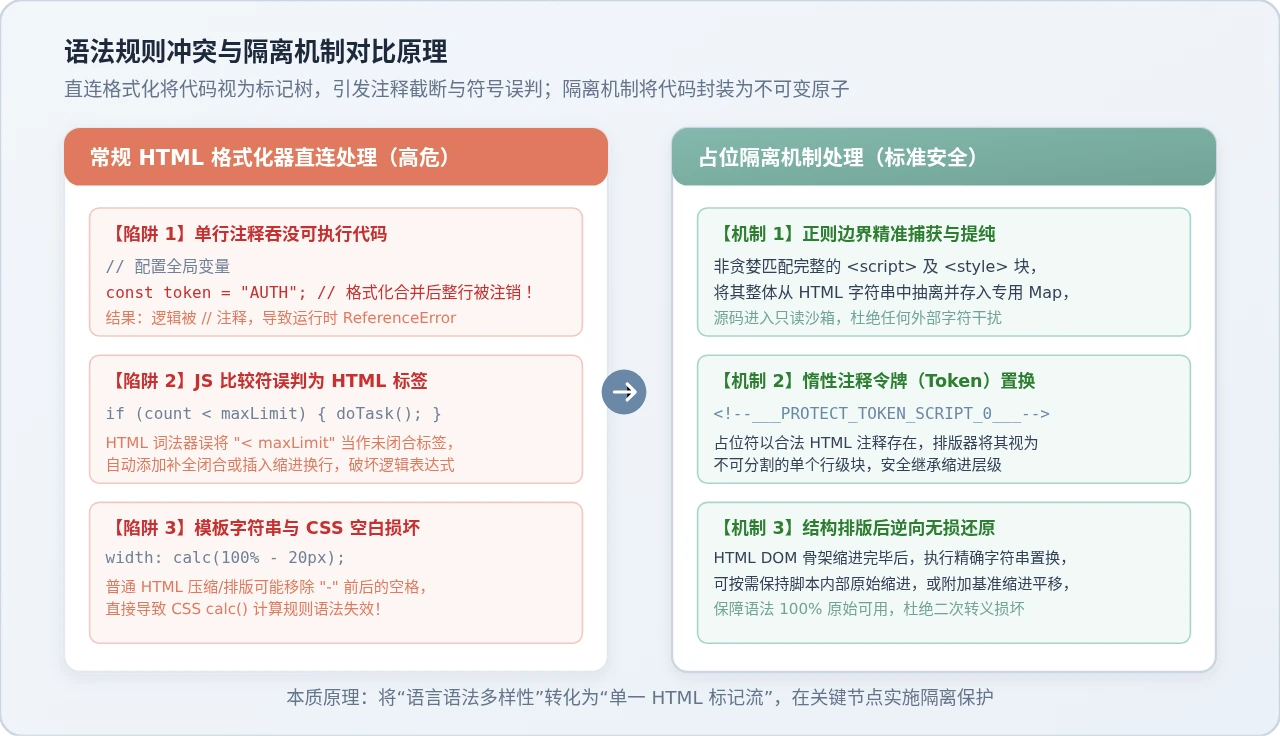
HTML 属于标记语言(Markup Language),而 <script> 内部包裹的是 JavaScript 编程逻辑,<style> 内部包裹的是 CSS 规则集。常规的 HTML 格式化器基于 DOM 树或标签配对算法工作,它们预设所有标签内部的内容都是普通的文本节点或子元素节点,因此会执行统一的去空格、换行、折叠和首尾缩进。这种统一处理会导致三类致命破坏:
- 单行注释破坏执行逻辑:在 JavaScript 中,
//单行注释依赖换行符作为结束边界。如果格式化算法简单地将代码行与前后标签合并或缩进折叠,单行注释就会直接把后续的关键可执行语句注释掉,产生致命的语法或逻辑失效。 - 比较符号误判为 HTML 标签:JavaScript 中的条件判断常包含小于号
<(如if (index < length))。许多基于简单正则或无状态状态机的 HTML 格式化器会误将< length当作一个未完成的标签起始符,擅自添加闭合标记或强行截断分行。 - CSS 表达式与空白敏感性损坏:CSS 的
calc()计算公式要求运算符两侧必须严格保留单个空格(例如calc(100% - 20px)中的减号)。若 HTML 美化工具对内部字符串实施贪婪空白清理,去掉减号两边的空格,该样式在浏览器解析时将直接失效。
二、核心方案:占位隔离还原法(自研无依赖实现)
占位隔离法是处理多语法嵌套排版时最经典的工程解法。它的核心逻辑非常直接:在进入 HTML 格式化流水线之前,先把所有异质语言代码“打包封存”,替换为无害的临时令牌;待 HTML 标签排好版之后,再开箱将代码精准放回原处。
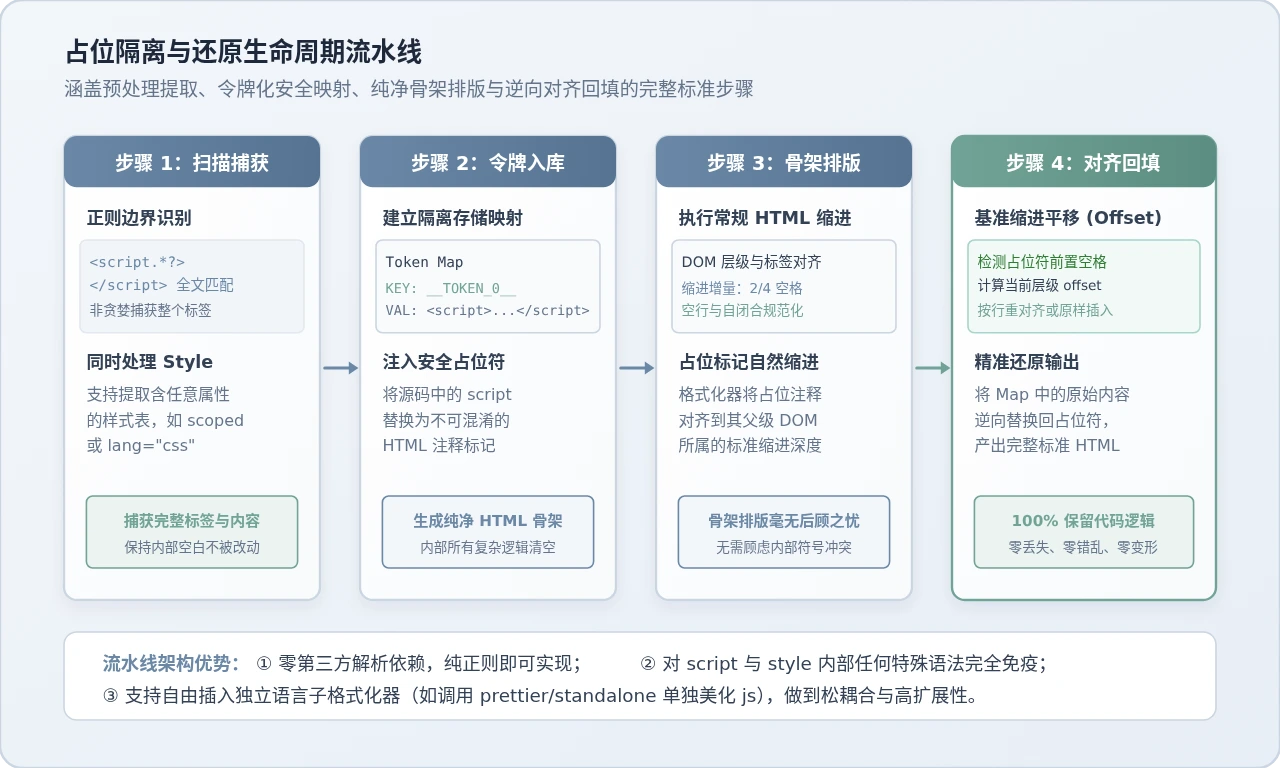
1. 四步处理生命周期
- 正则扫描与匹配捕获:利用非贪婪正则表达式同时匹配
<script>和<style>的完整标签及内部全部字符。 - 令牌注册与占位注入:以哈希或递增索引生成唯一的 HTML 注释标记(例如
<!--___TOKEN_SCRIPT_0___-->),将原始内容存入映射字典(Map),并将原文相应位置替换为占位标记。 - 骨架安全格式化:对替换后的纯 HTML 字符串执行缩进、换行与层级规整。此时由于没有复杂的脚本符号干扰,格式化器可以安全快速地完成任务。
- 基准缩进计算与逆向回填:遍历回填占位符。在回填时,既可原样保留内部原有格式,也可以根据占位符当前所在的前置空格数,使内部代码统一整体平移对齐。
2. 完整 JavaScript 实现代码
下面是一个可以直接运行的原生 JavaScript 函数实现。它不仅支持完整保留 <script> 和 <style>,还提供了基础的 HTML 骨架缩进对齐引擎,不依赖任何第三方 npm 包:
/**
 * 格式化 HTML 字符串并完整保留 script 与 style 内部字符
 * @param {string} htmlString 原始未经格式化的 HTML
 * @param {number} indentSize 缩进空格数量,默认 2
 * @returns {string} 格式化完成的 HTML
 */
function formatHtmlPreservingBlocks(htmlString, indentSize = 2) {
  if (!htmlString || typeof htmlString !== 'string') {
    return '';
  }

  const storageMap = new Map();
  let tokenCounter = 0;

  // 正则:精准匹配 <script>...</script> 和 <style>...</style>
  //  确保匹配合法标签名,[^>]* 匹配任意标签属性,[\s\S]*? 非贪婪捕获内容
  const blockRegex = /<(script|style)[^>]*>[\s\S]*?<\/>/gi;

  // 步骤 1 & 2:提取代码块,写入 Map 并替换为安全占位符
  const maskedHtml = htmlString.replace(blockRegex, (matchedBlock) => {
    const token = `<!--___TOKEN_BLOCK_${tokenCounter++}___-->`;
    storageMap.set(token, matchedBlock);
    return token;
  });

  // 步骤 3:对纯 HTML 骨架进行标签层级缩进格式化
  const formattedSkeleton = formatHtmlSkeleton(maskedHtml, indentSize);

  // 步骤 4:逆向回填,将占位符恢复为原始完整块
  let finalResult = formattedSkeleton;
  for (const [token, originalBlock] of storageMap.entries()) {
    // 获取占位符在当前行所在的前置缩进,确保回填后闭合标签自然对齐
    finalResult = finalResult.replace(token, () => originalBlock);
  }

  return finalResult;
}

/**
 * 辅助函数:针对纯 HTML 骨架(含占位注释)的规整缩进引擎
 */
function formatHtmlSkeleton(html, indentSize) {
  const indentStr = ' '.repeat(indentSize);
  let formatted = '';
  let indentLevel = 0;

  // 将标签、注释与普通文本拆分为独立词元
  const tokens = html.replace(/(>)([\s]*)(<)/g, '$1
$3').split('
');

  // 自闭合与单标签列表(不增加缩进深度)
  const voidTags = /^(area|base|br|col|embed|hr|img|input|link|meta|param|source|track|wbr)$/i;

  for (let line of tokens) {
    line = line.trim();
    if (!line) continue;

    // 闭合标签 </div>:先减少缩进
    if (/^<\/([a-zA-Z0-9\-]+)/.test(line)) {
      if (indentLevel > 0) indentLevel--;
    }

    formatted += indentStr.repeat(indentLevel) + line + '
';

    // 起始标签(非自闭合、非注释):增加下一行缩进
    const startTagMatch = /^<([a-zA-Z0-9\-]+)[^>]*>/.test(line);
    const isClosing = /^<\//.test(line);
    const isSelfClosing = /<[^\/>]+\/>$/.test(line);
    const isComment = /^<!--/.test(line);
    const matchedTagName = line.match(/^<([a-zA-Z0-9\-]+)/);

    if (startTagMatch && !isClosing && !isSelfClosing && !isComment) {
      if (matchedTagName && !voidTags.test(matchedTagName[1])) {
        // 如果当前行不是单行闭合如 <p>text</p>
        if (!/<\/[a-zA-Z0-9\-]+>$/.test(line)) {
          indentLevel++;
        }
      }
    }
  }

  return formatted.trim();
}
代码验证要点
使用上述函数对包含 if (i < 10)、// 单行注释 以及 CSS calc(100% - 10px) 的混合 HTML 进行格式化,外部的 <div> 和 <p> 标签会获得规范的递进缩进,而 <script> 和 <style> 标签内的每一个字符、换行与空格均保持 100% 原汁原味。
三、方案二:基于主流格式化工具的原生配置
在大型工程化项目或使用了构建工具(Webpack、Vite、Rollup)的场景下,通常会引入经过充分测试的格式化工具库。此时无需手动编写正则提取,只要明确配置即可保留 script 和 style。
1. 使用 js-beautify 的 content_unformatted 配置
js-beautify 是社区最广泛使用的 HTML 格式化库之一。它原生提供了一个名为 content_unformatted 的配置数组,用于指定哪些标签内部的内容严禁触碰,必须按字符原样保留:
const beautifyHtml = require('js-beautify').html;

const rawHtml = `
<div class="container"><h1>数据报表</h1>
<style>
  .box { margin: 0 auto; width: calc(100% - 24px); }
</style>
<script>
  // 敏感单行注释:严禁被压缩
  const limit = 50;
  for (let i = 0; i < limit; i++) {
    console.log("Count: " + i);
  }
</script>
</div>`;

const options = {
  indent_size: 2,
  indent_char: ' ',
  max_preserve_newlines: 1,
  // 核心配置:完全不碰 script 和 style 标签内部的内容
  content_unformatted: ['script', 'style'],
  // 备选配置:unformatted 用于完全不格式化整个标签(含外部标签本身)
  // unformatted: ['code', 'pre']
};

const result = beautifyHtml(rawHtml, options);
console.log(result);
content_unformatted vs unformatted 区别
content_unformatted 会对 <script> 和 <style> 外层的标签本身执行正常的 HTML 缩进对齐,仅将其内部包裹的文本视作黑盒;而 unformatted 则是把整个标签连同外壳一律当作内联行内元素不执行换行缩进。因此保留代码通常必须使用 content_unformatted。
2. Prettier 的内嵌 AST 协同策略
如果项目采用 prettier 进行排版,Prettier 本身不支持“完全跳过内部并保留混乱格式”,但它的解析器具备多语言协同(Embedded Language Formatting)能力。Prettier 默认会调用内置的 Babel 解析器美化内嵌 JS,调用 PostCSS 解析器美化内嵌 CSS。如果需要阻止 Prettier 格式化内嵌代码,可以在标签上方显式添加注释标记:
<!-- prettier-ignore -->
<script>
  // 这里面的任何代码 Prettier 将完全跳过,100% 保持原样
  let a=1;    let b=2;
</script>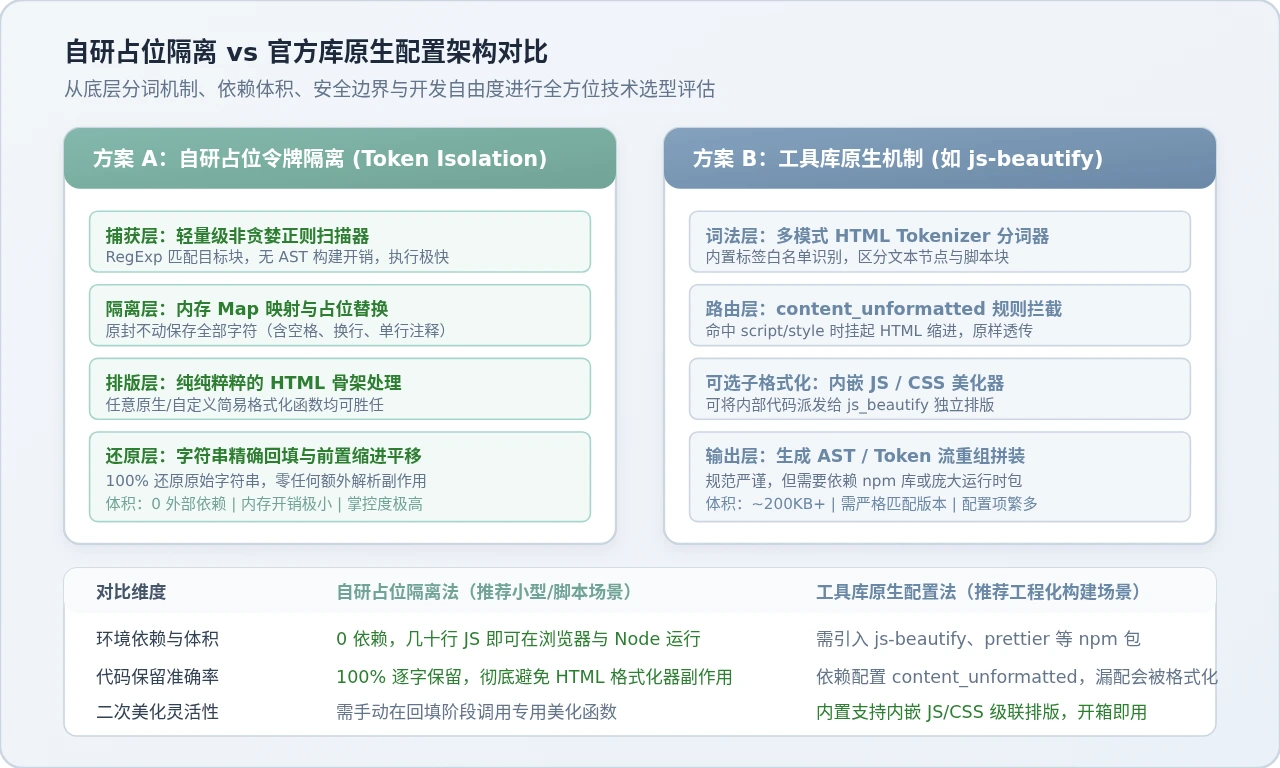
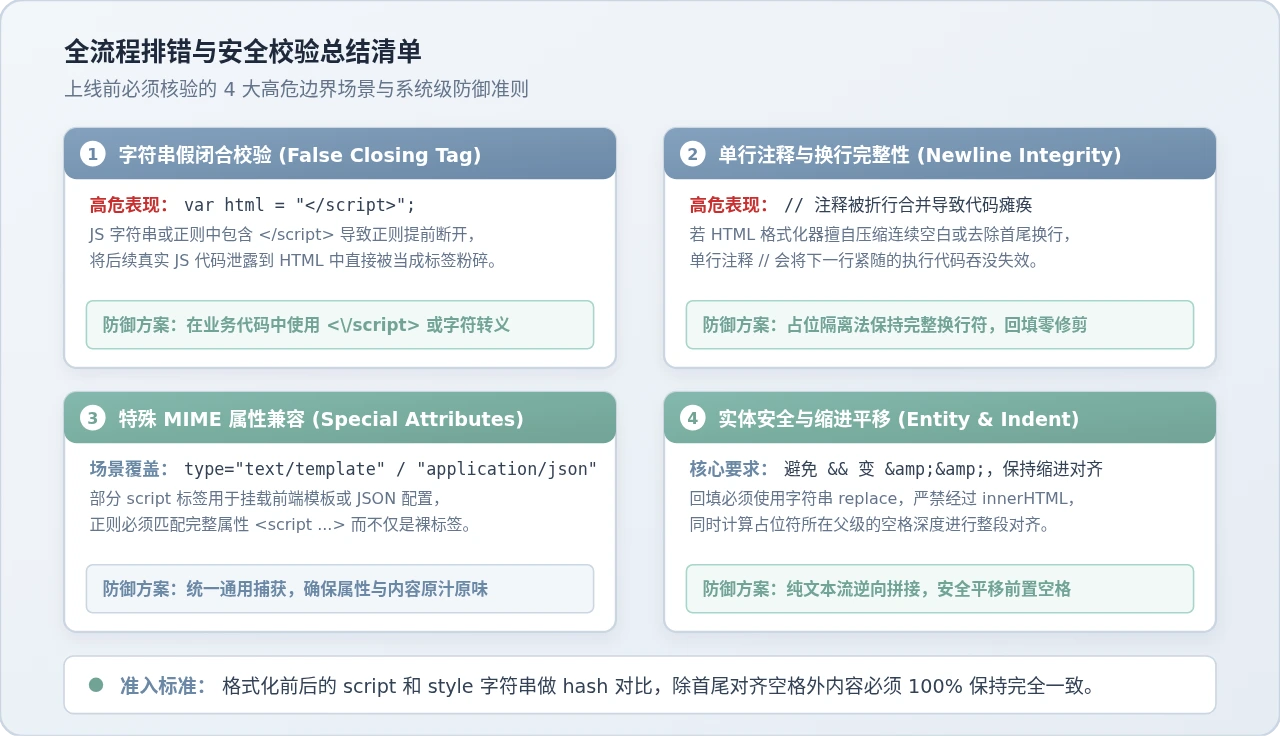
四、生产环境必须处理的 4 个边界陷阱
在实际项目中,页面结构往往比演示用例复杂得多。如果在实现或使用时忽略了以下边界情况,仍有可能引发线上故障:
1. JS 字符串中包含 </script> 导致的假闭合
当 JavaScript 脚本内部动态拼接 HTML 模板时,常会出现形如 const tpl = "<script src='app.js'></script>"; 的语句。正则表达式的非贪婪匹配 [\s\S]*?<\/script> 会在字符串中的第一个 </script> 处立刻终止,导致该位置后面的真实代码被当成普通 HTML 文本暴露在外面。
避坑方案:在业务代码编写端,规范内嵌字符串的闭合写法为 <\/script> 或 '</' + 'script>';在自研提取工具端,建议结合简单的词法上下文跳过带引号的字符串常量。
2. 非标准 MIME 类型的模板脚本
很多老旧系统或微前端框架使用带有特定属性的 script 标签传递数据或 HTML 模板,例如 <script type="text/html"> 或 <script type="application/json">。如果将 type="text/html" 的内部模板也直接当成 JS 隔离,其内部原本需要美化的 HTML 就无法被缩进;反之如果强行美化,又可能损坏里面的前端插值表达式。
避坑方案:在正则表达式或分词器中检查 type 属性。默认将无 type、type="module"、type="text/javascript" 以及 <style> 视作隔离对象;针对模板脚本,提供明确的配置开关允许用户决定是否级联格式化。
3. 回填时的基准缩进平移(Base Indentation Offset)
如果直接将原始脚本块放回占位符,会出现脚本内容与外部标签缩进不齐的情况。例如 <script> 缩进了 4 个空格,但其内部代码依然靠在第 0 列。
避坑方案:如果需要让内部代码视觉上与外层标签协调,可以在回填时检测占位符所在行前置的空白字符串(Indent Offset),对内部每一行代码统一加上该前置空白;若追求字节级绝对安全(例如避免改变 ES6 模板字符串内的多行对齐),则应严格选择原样原位回填。
4. 严防字符实体二次转义(HTML Entity Escaping)
部分开发者试图利用浏览器的 DOMParser 或 document.createElement('div') 的 innerHTML 来实现格式化。这种做法极度危险:浏览器在序列化 innerHTML 时,会将代码中的 && 强制转义为 &&,将双引号转义为 ",导致直接损坏 JavaScript 逻辑运算。
避坑方案:格式化和回填全流程必须始终在纯字符串或词法 Token 层面操作,绝对不能借由浏览器的 DOM 序列化 API 作为中间媒介。
五、方案选型与校验核对清单
为了便于在实际开发中快速抉择和验收,下表整理了针对不同场景的技术方案建议与核心指标对比:
| 评估指标 | 自研占位隔离还原法 | js-beautify (content_unformatted) | Prettier (prettier-ignore) |
|---|---|---|---|
| 实现与依赖成本 | 极低(纯原生 JS,零依赖) | 中等(需安装 npm 依赖包) | 较高(完整构建工具链) |
| 内部代码保真度 | 100% 逐字保留,绝对无损 | 按配置保留,需确保正确声明数组 | 需在 HTML 中显式写 ignore 注释 |
| 适用运行环境 | Node.js、浏览器端、小程序、Web Worker | Node.js、打包后的前端 bundle | Node.js CLI、IDE 插件、CI 校验流水线 |
| 内嵌代码二次美化 | 需按需手动调用子语言格式化器 | 支持直接配置针对 js/css 的格式化子选项 | 原生自带多语言 AST 深度美化 |
| 性能开销 | 毫秒级(简单正则与字符串替换) | 百毫秒级(完整状态机词法扫描) | 秒级(全量 AST 生成与重排) |
上线验收准则
在自动化测试或上线交付前,建议对格式化前后的 <script> 和 <style> 代码块做哈希校验(如 MD5 或去掉外部首尾纯缩进后的比较)。只有保证内部代码逻辑字节级完全一致,才能确保格式化操作既提升了 HTML 的排版可读性,又不会引入任何潜在的生产环境逻辑缺陷。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章