
深入解析JavaScript中字符串转换为UTF-8后出现乱码的根本原因,详细剖析Latin-1误解与GBK错位机制,并提供浏览器与Node.js环境下的现代标准修复方案。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串转UTF-8后乱码的原因及修复
作者:开源拾贝
时间:2026-11-12
浏览:163
文章目录
字符编码治理
运行环境:Browser / Node.js
标准方案:TextEncoder & TextDecoder
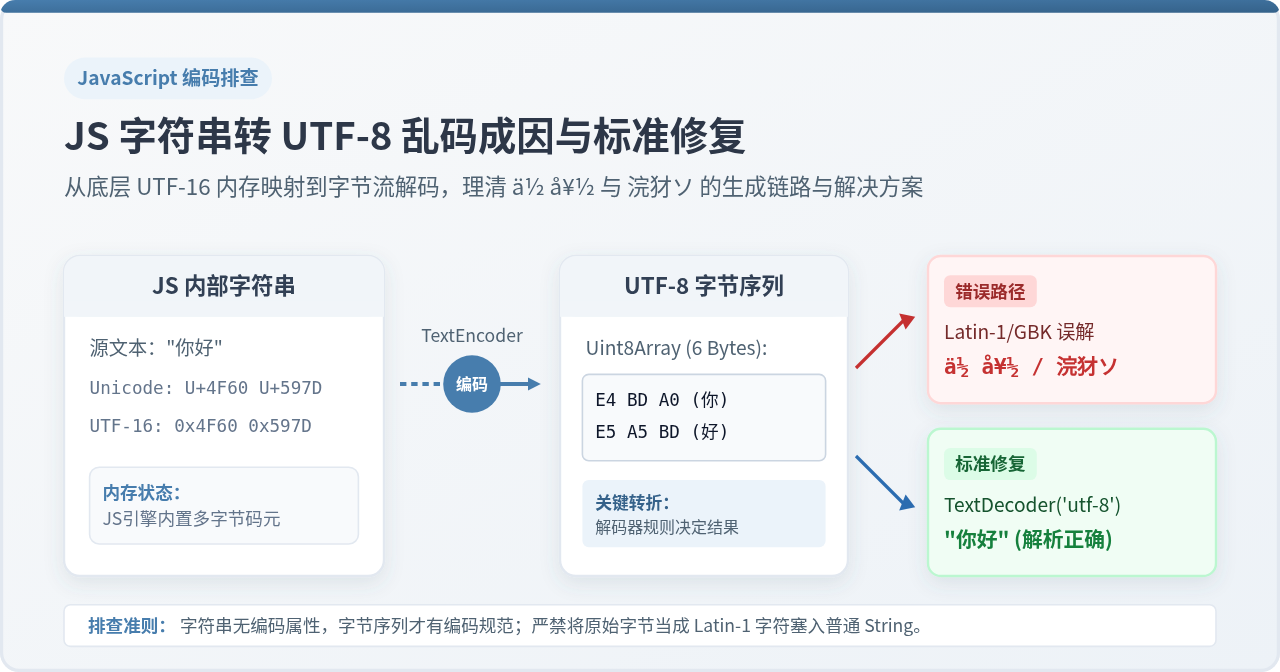
JavaScript 内部的所有字符串均基于 Unicode 字符集并以 UTF-16 码元在内存中管理。当我们讨论“字符串转 UTF-8”时,物理上发生的操作并不是“把一段文字变成另一段文字”,而是把抽象字符转换为物理字节序列(Uint8Array 或 Buffer)。所谓“转后乱码”,其本质从来不是 UTF-8 编码算法损坏了数据,而是开发者把这组多字节的二进制序列错误地当成了 Latin-1(ISO-8859-1)或 GBK 等其他字符集重新解码,或者因管道切断导致高位字节缺失。解决乱码的关键在于严格分离“字符”与“物理字节”,并在所有流转节点中建立显式的编码契约。
一、常见乱码形态与成因判定依据
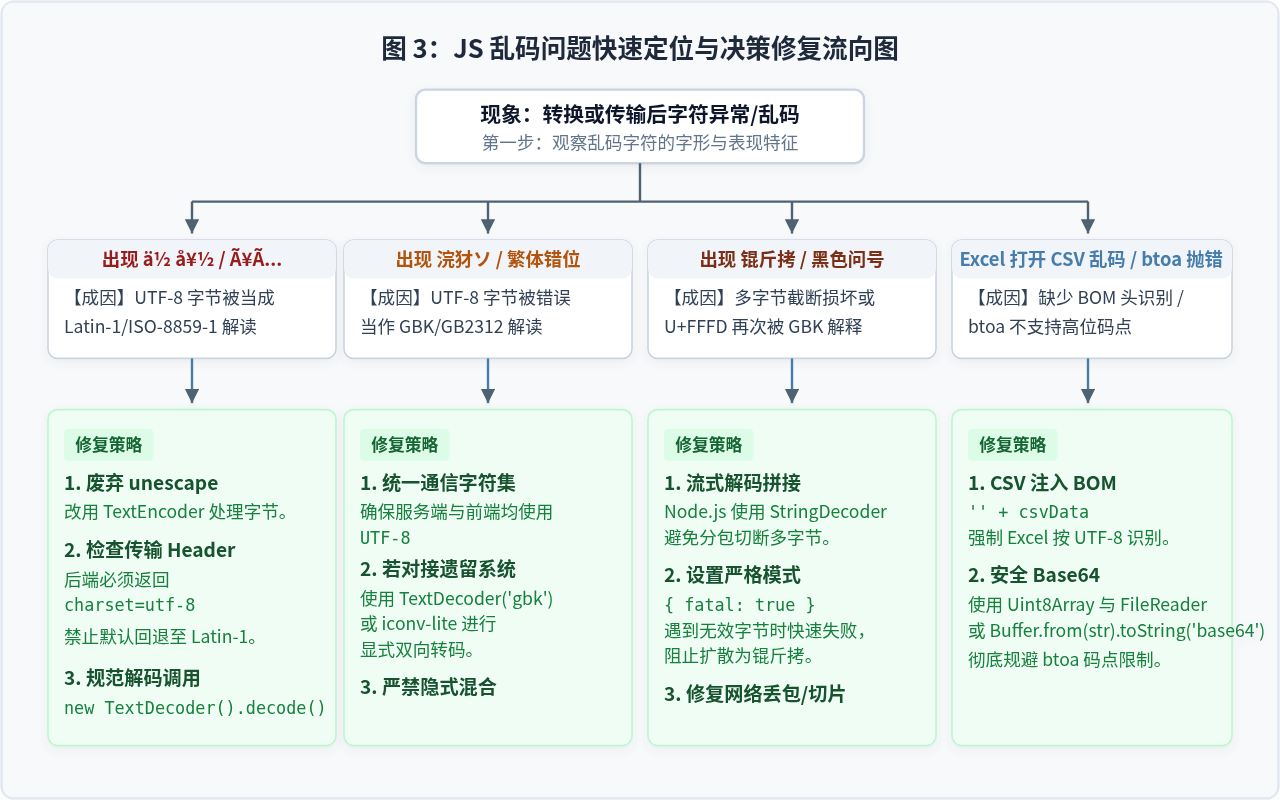
排查字符编码问题时,最直观的线索就是乱码所呈现出来的字形特征。由于不同字符集解析字节的步长和码表完全不同,乱码表现具有强烈的规律性。在动手改动代码前,通过观察乱码形式,通常就能直接定位出是哪一个处理环节的解码器配置出现了偏差。
| 乱码典型表现 | 示例(以“你好”为例) | 底层故障原因 | 主要出险场景 |
|---|---|---|---|
| 西欧重音字符与特殊符号堆叠 | ä½ å¥½ 或 ä½ ... |
UTF-8 多字节被错误当成单字节 Latin-1 (ISO-8859-1) 逐字节还原 | 使用了历史黑魔法 unescape;网络传输未设 charset=utf-8 被服务端默认以 Latin-1 解析 |
| 生僻汉字与日文片假名交错 | 浣犲ソ |
UTF-8 的 3 字节汉字被硬性按照双字节 GBK/GB2312 码表两两合并 | Windows 系统默认本地编码对接;老旧 SQL 数据库表字符集设为 GBK;终端输出未设 UTF-8 |
| 黑色实心问号或特定替换词 | 锟斤拷 |
网络流传输被分片切断导致字节不完整,或使用了 new TextDecoder() 的非严格容错替换符 U+FFFD 后二次转码 |
分块传输(Chunked Stream)中间切断了 UTF-8 连续多字节;跨系统混合转码多次损坏 |
| Unicode 转义或十六进制实体暴露 | \u00e4\u00bd\u00a0 |
Latin-1 解码结果被 JSON 序列化器再次进行了十六进制转义 | 前后端 API 传递时进行了重复的序列化或未反解析二进制字符串 |
为了深入理解这种映射关系,我们需要观察一个中文字符在内存中的实际物理字节流是如何在解码环节发生偏离的。
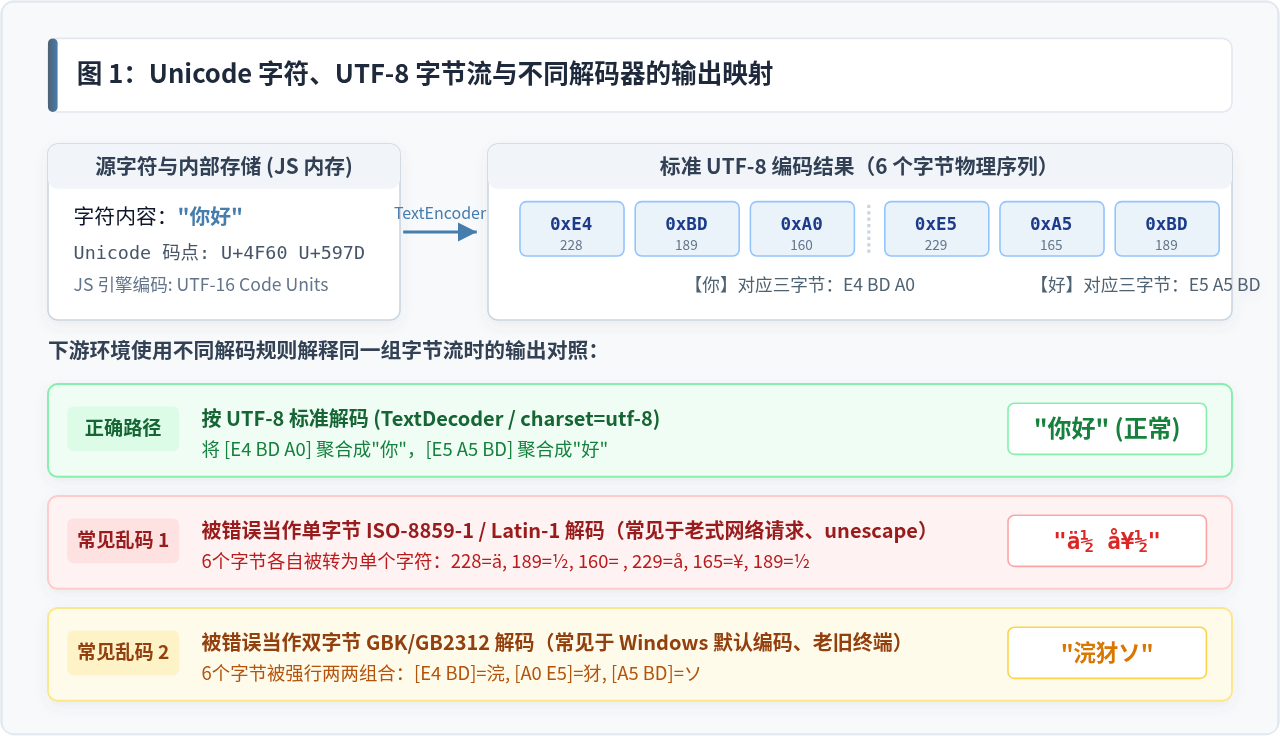
从图 1 可以看出,汉字“你”在 Unicode 中的码点为 U+4F60,经过 UTF-8 规则编码后展开为 3 个连续字节:0xE4、0xBD、0xA0。如果目标环境知道这是 UTF-8,它会将这 3 个字节重新拼合成一个完整的汉字;但如果接收方按照 ISO-8859-1 规范处理,这 3 个字节会被逐一映射为 ASCII 扩展字符,分别变成了 ä (228)、½ (189) 和不间断空格 (160)。这就是绝大多数前端开发者经常撞见的 ä½ å¥½ 乱码的物理起源。
二、产生乱码的常见代码陷阱
在实际工程开发中,乱码很少自发产生,往往是由于采用了陈旧的解决方案或忽略了环境之间的编码协商机制。
1. 误用历史遗留方法模拟 UTF-8
在早期浏览器尚未支持 TextEncoder 的年代,网络上流传着一种利用 encodeURIComponent 与 unescape 将字符串转成“UTF-8 格式”的技巧:
// 危险写法:历史黑魔法,现代严禁使用
function badUtf8Encode(str) {
return unescape(encodeURIComponent(str));
}
const result = badUtf8Encode("你好");
console.log(result); // 输出 "ä½ å¥½"
这段代码的运行逻辑是:encodeURIComponent 先将字符转为百分比编码 %E4%BD%A0%E5%A5%BD,随后 unescape 将每个 %XX 强制视作 \u00XX 字符单元填入字符串中。最终得到的 result 并不是一个纯净的二进制流,而是一个伪装成字符串的“二进制字符串”(Binary String)。一旦这个伪字符串被通过 JSON.stringify() 上传、写入数据库或参与字符串截取,就会引发永久性的数据损坏。
重要禁忌:
escape() 和 unescape() 早已被 ECMAScript 标准正式废弃(Annex B 遗留特性)。严禁使用它们来处理二进制或字符编码转换。
2. 使用 String.fromCharCode 强转字节序列
另一个常见错误是试图把 TextEncoder 生成的 Uint8Array 强行转回普通字符串时,错误地调用了 String.fromCharCode:
const uint8 = new TextEncoder().encode("你好"); // 6 个字节
// 错误做法:String.fromCharCode 逐字节解析
const garbled = String.fromCharCode(...uint8);
console.log(garbled); // 同样输出 "ä½ å¥½"
String.fromCharCode 接收的是 UTF-16 码元数值,它完全不知道多字节序列的组合规则。将 0xE4 传入该函数,只会直接构造出码点为 0x00E4 的拉丁字符 ä。
3. 导出文件未声明 BOM 或 MIME 字符集
前端生成 CSV 或纯文本下载时,如果仅仅使用 new Blob([content], { type: 'text/csv' }),在许多 Windows 版本的 Microsoft Excel 中打开时会全部显示为乱码。这是因为 Excel 打开 CSV 默认依据当前操作系统的 ANSI 编码(中文 Windows 下通常是 GBK)。缺少 UTF-8 BOM 签名头时,Excel 无法自动识别该文件为 UTF-8 编码,进而引发大面积显示错乱。
三、现代标准环境下的正确修复方案
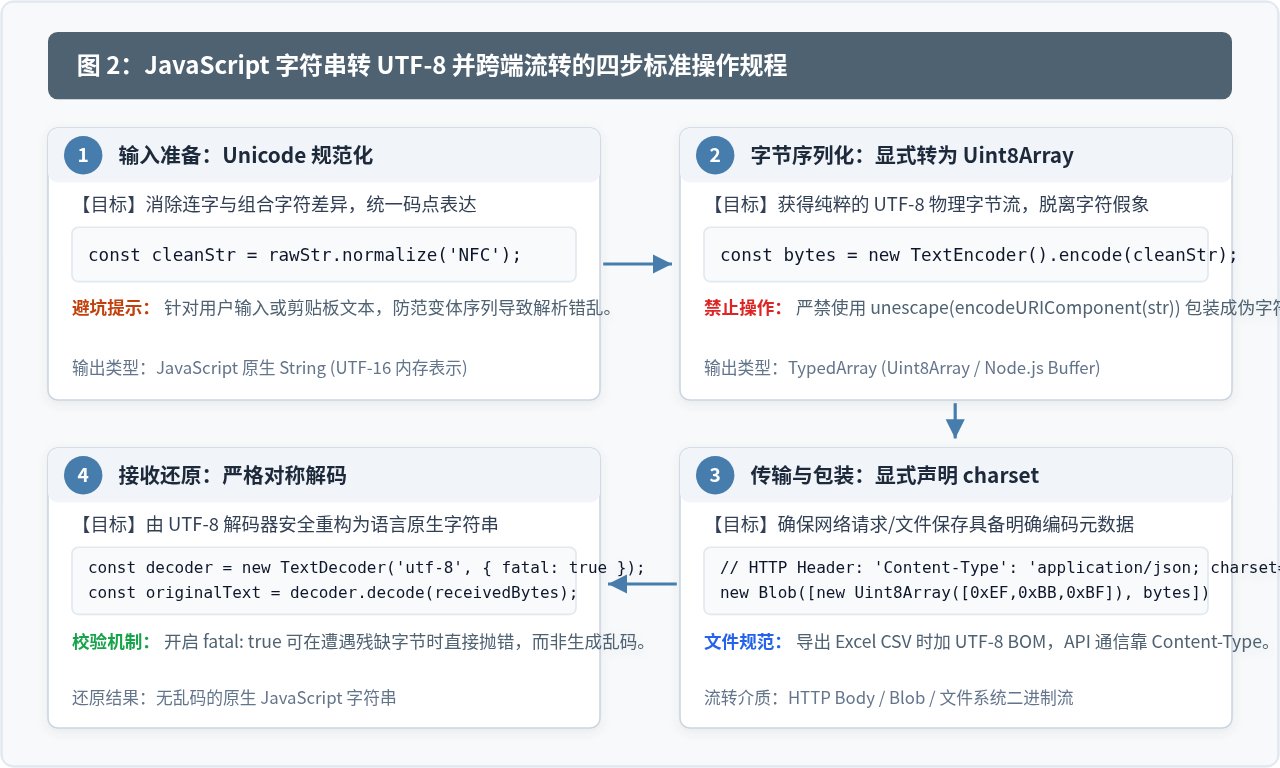
解决编码问题的核心思想非常明确:让字符归字符,让字节归字节。无论在浏览器端还是 Node.js 环境,均应使用平台提供的原生二进制抽象,并在边界处使用成对的标准 API。
方案 1:浏览器环境标准方案(TextEncoder & TextDecoder)
所有现代主流浏览器均原生内置了 TextEncoder 与 TextDecoder,它们是 W3C 编码规范推荐的标准工具。TextEncoder 固定输出 UTF-8 格式的 Uint8Array,而 TextDecoder 支持显式指定字符集反向还原字符串。
// 1. 字符串转 UTF-8 字节序列 (Uint8Array)
function stringToUtf8ByteArray(text) {
  const encoder = new TextEncoder();
  return encoder.encode(text);
}

// 2. UTF-8 字节序列安全还原为字符串
function utf8ByteArrayToString(bytes, strict = true) {
  // 开启 fatal: true 时,遭遇非法字节序列将抛出 TypeError,避免隐式生成黑色问号
  const decoder = new TextDecoder('utf-8', { fatal: strict });
  return decoder.decode(bytes);
}

// 验证测试
const original = "JavaScript 编码规范测试:你好,世界!";
const utf8Bytes = stringToUtf8ByteArray(original);
const recovered = utf8ByteArrayToString(utf8Bytes);

console.log(utf8Bytes instanceof Uint8Array); // true
console.log(recovered === original);          // true
方案 2:Node.js 服务端环境标准方案(Buffer)
在 Node.js 环境中,直接使用底层的 Buffer API 进行转换,其执行效率极高且内建了完善的编码支持。如果需要处理网络流(Stream),应当搭配 string_decoder 模块以防止数据包切片截断汉字。
import { Buffer } from 'node:buffer';
import { StringDecoder } from 'node:string_decoder';

// 基础转换
const text = "Node.js 服务端 UTF-8 示例";
const buf = Buffer.from(text, 'utf-8'); // 获得物理字节流
const restored = buf.toString('utf-8');   // 对称安全解码

// 流式拆包防截断:处理分包时多字节被截半的问题
const streamDecoder = new StringDecoder('utf-8');
function onDataChunkReceived(chunk) {
  // 如果单个汉字的 3 个字节恰好跨越了两个 chunk,write 会暂存残字节直至凑齐
  const safeTextChunk = streamDecoder.write(chunk);
  process.stdout.write(safeTextChunk);
}
方案 3:Base64 与 UTF-8 互转的安全修复
原生 window.btoa() 仅支持 ASCII / Latin-1 范围内的字符。如果直接传入包含中文的字符串,会抛出 InvalidCharacterError。许多人因此误用 unescape 配合 btoa,从而将乱码带入 Base64。正确且标准的方式是直接基于 UTF-8 字节流构建 Base64:
// 现代浏览器:通过 Uint8Array 与 fromCodePoint 安全转换
function utf8ToBase64(str) {
  const bytes = new TextEncoder().encode(str);
  const binString = Array.from(bytes, (byte) => String.fromCodePoint(byte)).join("");
  return btoa(binString);
}

function base64ToUtf8(base64) {
  const binString = atob(base64);
  const bytes = Uint8Array.from(binString, (m) => m.codePointAt(0));
  return new TextDecoder().decode(bytes);
}

// Node.js:直接利用原生 Buffer 转换
const nodeBase64 = Buffer.from("你好世界", 'utf-8').toString('base64');
const nodeText = Buffer.from(nodeBase64, 'base64').toString('utf-8');
方案 4:文件下载导出时的 BOM 头补全
针对 Excel 打开 CSV 乱码的顽疾,在生成 Blob 对象时,于字节流起始处显式填充 UTF-8 的 BOM(Byte Order Mark)头字节 0xEF, 0xBB, 0xBF(在 JavaScript 中可以用字符 \uFEFF 表示),即可强制办公软件使用 UTF-8 码表读取。
function exportCsvFile(csvContent, fileName = 'export.csv') {
  // 关键步骤:在内容首部加入 UTF-8 BOM 签名头
  const bomHeader = new Uint8Array([0xEF, 0xBB, 0xBF]);
  const contentBytes = new TextEncoder().encode(csvContent);

  const blob = new Blob([bomHeader, contentBytes], {
    type: 'text/csv;charset=utf-8;'
  });

  const link = document.createElement('a');
  link.href = URL.createObjectURL(blob);
  link.download = fileName;
  link.click();
  URL.revokeObjectURL(link.href);
}
四、边界场景验证与测试清单
为了确保编码修复方案在生产环境中坚不可摧,不能仅测试基础的一级常用汉字,还必须覆盖 Emoji、增补平面生僻字以及容易引发切分的边界用例。
| 测试字符类型 | 典型代表字符 | Unicode 码点 | UTF-8 物理长度 | UTF-16 内存占用 | 验证关注点 |
|---|---|---|---|---|---|
| 标准 ASCII | A, 9, ~ |
U+0041 ~ U+007E | 1 字节 | 1 个单元 (16-bit) | 与 Latin-1 严格重合,最容易掩盖编码配置缺失 |
| 基本多语言平面常用汉字 | 你, 好, 文 |
U+4E00 ~ U+9FFF | 3 字节 | 1 个单元 (16-bit) | 验证单字节 Latin-1 误解与双字节 GBK 错位 |
| SIP 增补平面生僻字 | 𠮷 (吉的异体字) |
U+20BB7 | 4 字节 | 2 个单元 (代理对) | 检查是否误用 charAt 劈裂代理对导致截断乱码 |
| 复合表情符号 (Emoji) | 👨👩👧👦 |
多码点组合序列 (ZWJ) | 25 字节 | 11 个单元 | 验证零宽连字 (Zero-Width Joiner) 在流式解码时的完整性 |
| 非中文字符集重音符号 | é, ñ |
U+00E9, U+00F1 | 2 字节 | 1 个单元 (16-bit) | 测试 str.normalize('NFC') 是否能合并分解形式 |
下面是一个包含全量测试用例的自动化校验函数,可以在单元测试中直接调用以验证系统环境的编码健壮性:
function verifyEncodingIntegrity() {
const testCases = [
"Hello World!",
"你好,世界",
"生僻字测试:𠮷野家",
"表情测试:👨👩👧👦🚀🔥",
"混合符号:©®™ 100€ — äöü"
];
const encoder = new TextEncoder();
const decoder = new TextDecoder('utf-8', { fatal: true });
for (const original of testCases) {
// 1. 标准化
const normalized = original.normalize('NFC');
// 2. 转字节
const bytes = encoder.encode(normalized);
// 3. 严格还原
const output = decoder.decode(bytes);
if (output !== normalized) {
throw new Error(`编码校验失败: ${original} !== ${output}`);
}
}
console.log("所有边界编码测试全部通过,环境链路安全。");
}
verifyEncodingIntegrity();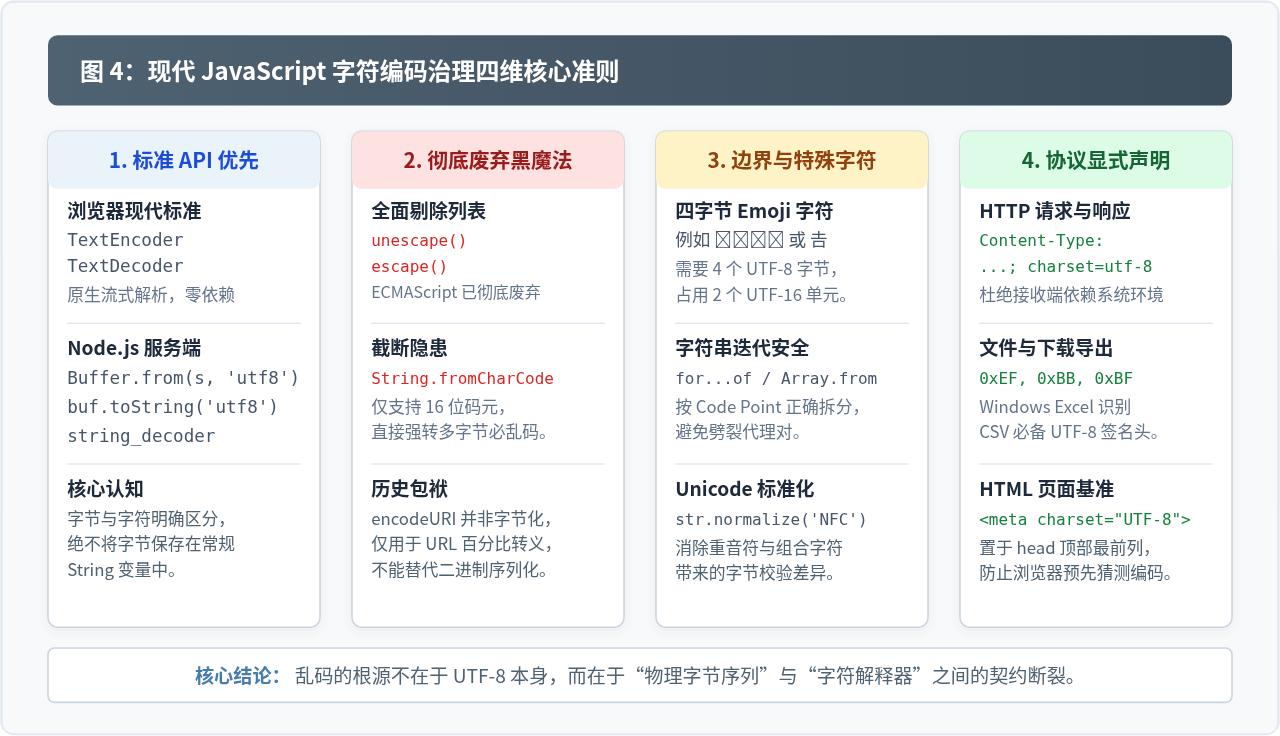
五、总结与工程落地建议
解决“JS 字符串转 UTF-8 后乱码”的关键,不在于尝试各种花哨的字符串替换正则,而在于树立清晰的底层认知:字符串是抽象的字符概念,只有当它需要存储或通过网络传输时,才存在编码为特定字节序列的必要。
- 内存中保持纯粹:在 JavaScript 逻辑执行层,统一使用原生 String 表达文本,不要自己搞任何模拟的二进制字符串。
- I/O 边界显式转换:需要把数据送入文件、Socket 或自定义网络协议时,使用
new TextEncoder().encode()输出Uint8Array,绝不向下兼容使用unescape等过时 API。 - 协议元数据对齐:所有的 HTTP 响应头、数据库连接串、文件写入选项,都必须显式指定
charset=utf-8,不给任何第三方中间件“猜测”并回退到 Latin-1 或 GBK 的机会。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章