
在JavaScript中合并包含相同ID的对象数组时,核心在于明确业务合并策略并使用Map实现O(N)线性时间复杂度的合并。本文详细讲解覆盖合并、属性浅合并、数值累加、深层递归合并的具体实现与边界避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS合并对象数组时怎么处理相同ID的数据
作者:霁月
时间:2026-11-12
浏览:168
文章目录
技术教程
类型:数组与数据结构处理
适用环境:Node.js / 现代浏览器 (ES6+)
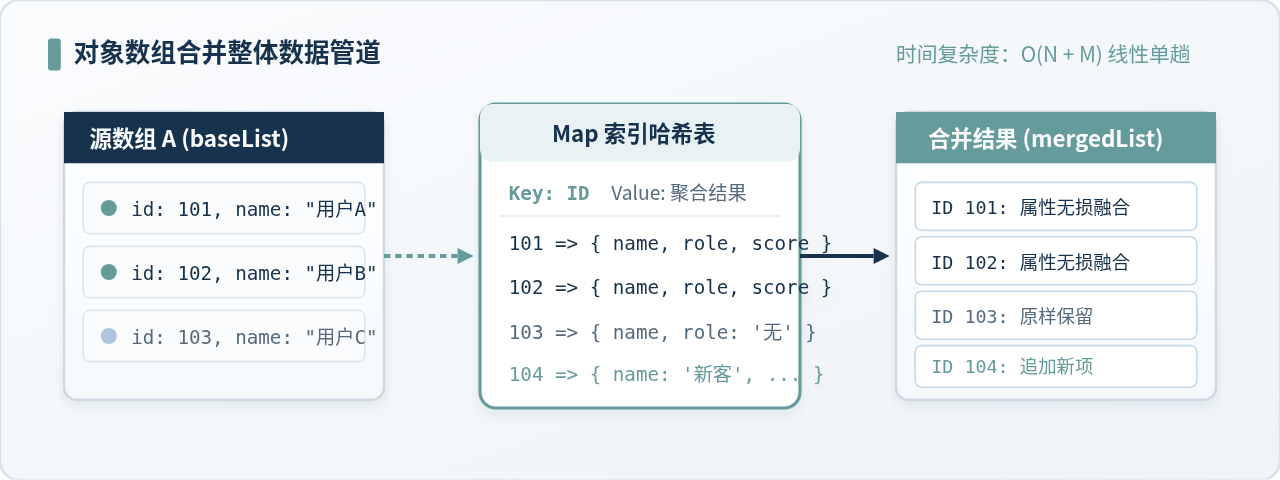
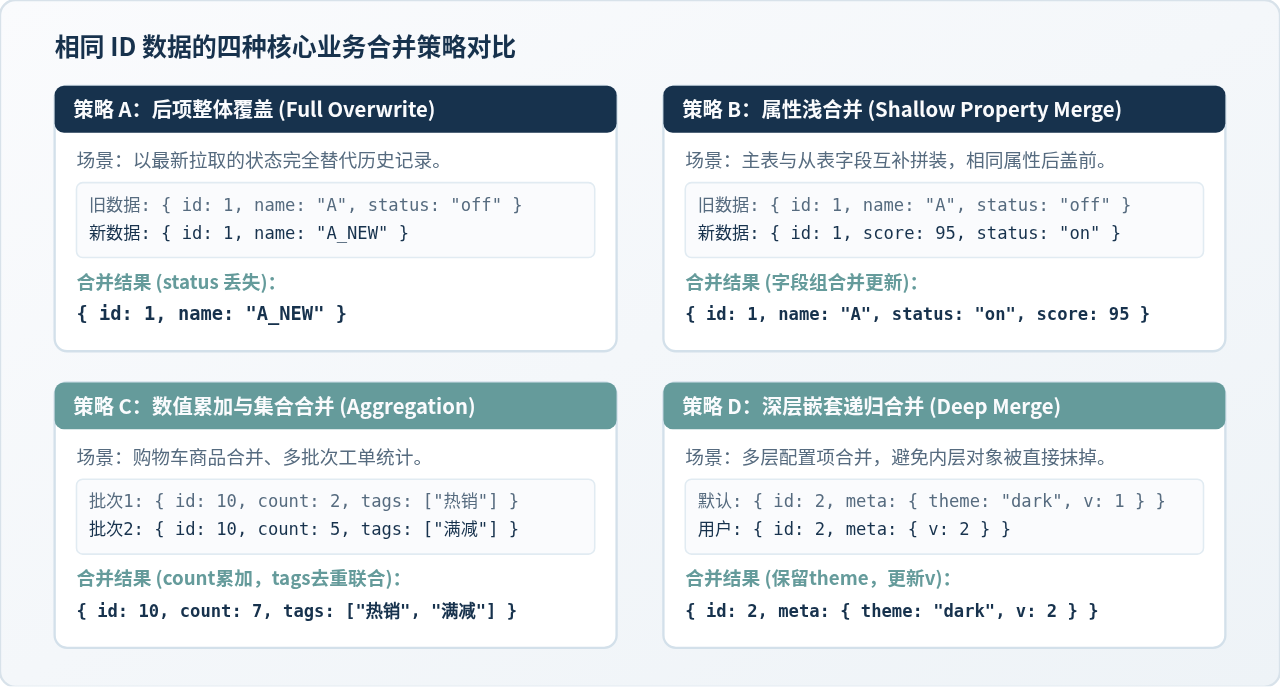
在 JavaScript 中合并具有相同 ID 的对象数组,核心做法是先根据业务要求选择匹配策略(后值完全覆盖、属性浅合并、数值聚合累加或深层递归合并),随后使用
Map 结构以 ID 为键进行单次遍历,将时间复杂度从低效的嵌套查找 \(O(N imes M)\) 优化至线性 \(O(N + M)\)。本文将逐一讲解这些常用处理方案、执行步骤与潜在的引用污染陷阱。
一、为什么不能用简单的双层循环查找
在初学阶段,许多开发者容易写出使用 forEach 嵌套 find 或 filter 的合并代码:
// 不推荐:时间复杂度 O(N * M)
const result = listA.map(itemA => {
  const match = listB.find(itemB => itemB.id === itemA.id);
  return match ? { ...itemA, ...match } : itemA;
});
当数据量只有数十条时,这种写法察觉不出延迟。但当 listA 和 listB 分别达到 10,000 条数据时,嵌套的 find 操作将导致高达 1 亿次的比较运算,直接造成浏览器主线程卡死或 Node.js 服务响应剧烈超时。
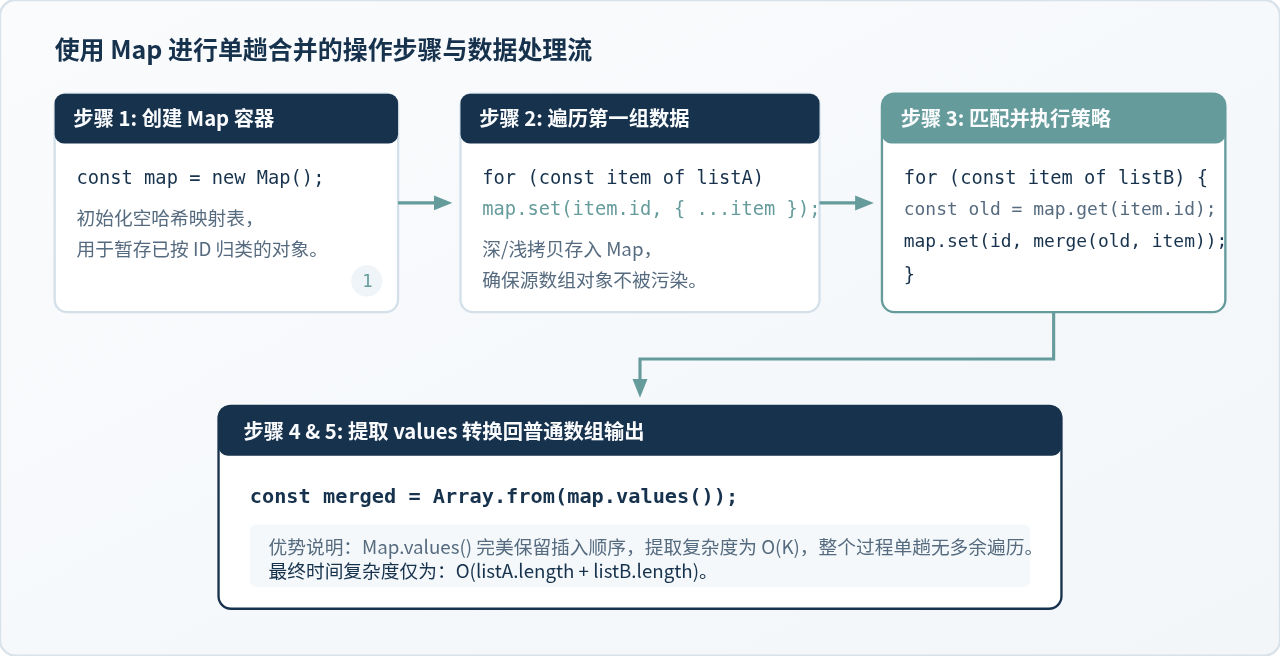
标准且高效的解法是使用 ES6 的 Map 对象。Map 的键值查找时间复杂度为近乎常数的 \(O(1)\)。通过一次性建立索引,无论数据量是几十条还是数十万条,都能在单个处理周期内完成合并。
二、四种常见业务合并策略的具体实现
在处理相同 ID 的数据时,所谓“合并”在实际业务中含义截然不同。我们需要根据具体场景选择合适的合并逻辑。
1. 属性浅合并(最常用模式)
当两个数组包含同一实体的不同字段信息时,我们希望通过对象展开运算符 ... 将字段拼装在一起。如果字段同名,则由后一个数组的值覆盖前一个。
/**
 * 按 ID 浅合并两个对象数组
 * @param {Array} listA - 基础数组
 * @param {Array} listB - 补充或更新数组
 * @returns {Array} 合并后的新数组
 */
function mergeShallowById(listA, listB) {
  const map = new Map();

  // 先存入第一个数组
  for (const item of listA) {
    if (item && item.id != null) {
      map.set(item.id, { ...item });
    }
  }

  // 合并第二个数组
  for (const item of listB) {
    if (!item || item.id == null) continue;
    const existing = map.get(item.id);
    if (existing) {
      // 关键:浅合并属性,相同 key 以后者为准
      map.set(item.id, { ...existing, ...item });
    } else {
      map.set(item.id, { ...item });
    }
  }

  return Array.from(map.values());
}

// 示例验证
const users = [
  { id: 101, name: "张三", department: "技术部" },
  { id: 102, name: "李四", department: "运营部" }
];

const roles = [
  { id: 101, role: "管理员" },
  { id: 103, name: "王五", role: "访客" }
];

const mergedUsers = mergeShallowById(users, roles);
console.log(mergedUsers);
// 输出:
// [
//   { id: 101, name: "张三", department: "技术部", role: "管理员" },
//   { id: 102, name: "李四", department: "运营部" },
//   { id: 103, name: "王五", role: "访客" }
// ]
2. 累加与归并模式(针对数量、金额或子数组)
在电商购物车、报表统计等业务场景中,具有相同 ID 的记录不能单纯覆盖,而需要将数量 quantity 相加,或者将分类标签数组进行联合去重:
/**
 * 合并相同商品记录,数量累加,标签数组合并去重
 */
function mergeCartItems(baseItems, addItems) {
  const map = new Map();

  // 统一遍历两个数组的合并流水线
  for (const item of [...baseItems, ...addItems]) {
    if (!map.has(item.id)) {
      map.set(item.id, {
        ...item,
        tags: Array.isArray(item.tags) ? [...item.tags] : []
      });
    } else {
      const target = map.get(item.id);
      target.count = (target.count || 0) + (item.count || 0);

      // 合并标签数组并利用 Set 去重
      if (Array.isArray(item.tags)) {
        target.tags = Array.from(new Set([...target.tags, ...item.tags]));
      }
      // 价格或最新配置以最新一条记录为准
      if (item.price !== undefined) target.price = item.price;
    }
  }

  return Array.from(map.values());
}
3. 递归深度合并模式(应对嵌套对象)
如果对象内部含有深层子对象(如 config.style.color),浅合并 { ...existing, ...item } 会直接用后者的 config 替换前者的整个 config,导致深层未声明的默认字段被抹杀。此时需要进行递归合并:
function isObject(val) {
  return val !== null && typeof val === "object" && !Array.isArray(val);
}

function deepMergeObject(target, source) {
  const output = { ...target };
  for (const key of Object.keys(source)) {
    if (isObject(target[key]) && isObject(source[key])) {
      output[key] = deepMergeObject(target[key], source[key]);
    } else {
      output[key] = source[key];
    }
  }
  return output;
}
三、必须小心的关键陷阱与边界处理
1. ID 类型的隐式转换问题
在许多业务系统中,一个接口返回的 ID 是字符串 "1001",而另一个接口返回的则是数值 1001。在 JavaScript 的 Map 中,键的比对是基于 SameValueZero 规则:
const map = new Map();
map.set(1001, { id: 1001, name: "A" });
map.set("1001", { id: "1001", name: "B" });

console.log(map.size); // 输出 2!两个 ID 被视作不同的键
解决办法:在放入 Map 前,统一将 ID 转换为字符串(例如 String(item.id))作为哈希键,确保跨来源数据能精准命中同一个实体。
2. 避免空值属性覆盖有效属性
如果第二个数组中的对象包含 { id: 101, name: undefined },简单的展开 { ...oldItem, ...newItem } 会把原本有效的 name 覆盖为 undefined。如果业务要求“只合并非空字段”,需要进行属性过滤:
function mergeNonNullProps(target, source) {
  const result = { ...target };
  for (const [key, value] of Object.entries(source)) {
    if (value !== undefined && value !== null) {
      result[key] = value;
    }
  }
  return result;
}
四、通用工程级方案:支持合并任意多个数组
实际项目中往往不止合并两个数组,而是可能需要合并 3 个乃至 10 个数据源(如用户主数据、工单数据、考勤数据、绩效数据)。以下是一个工业级通用的多数组按指定标识合并函数:
/**
 * 通用多数组唯一标识合并器
 * @param {string} keyId - 作为唯一标识的键名,例如 'id' 或 'code'
 * @param {Function} [customMerger] - 自定义合并规则回调函数 (prev, curr) => merged
 * @param  {...Array} arrays - 待合并的一到多个对象数组
 * @returns {Array} 聚合合并后的新数组
 */
function mergeMultipleArrays(keyId, customMerger, ...arrays) {
  const map = new Map();

  // 默认浅合并策略
  const defaultMerge = (prev, curr) => ({ ...prev, ...curr });
  const merger = typeof customMerger === "function" ? customMerger : defaultMerge;

  for (const arr of arrays) {
    if (!Array.isArray(arr)) continue;
    for (const item of arr) {
      if (!item || item[keyId] == null) continue;

      const idKey = String(item[keyId]);
      if (map.has(idKey)) {
        map.set(idKey, merger(map.get(idKey), item));
      } else {
        map.set(idKey, { ...item });
      }
    }
  }

  return Array.from(map.values());
}
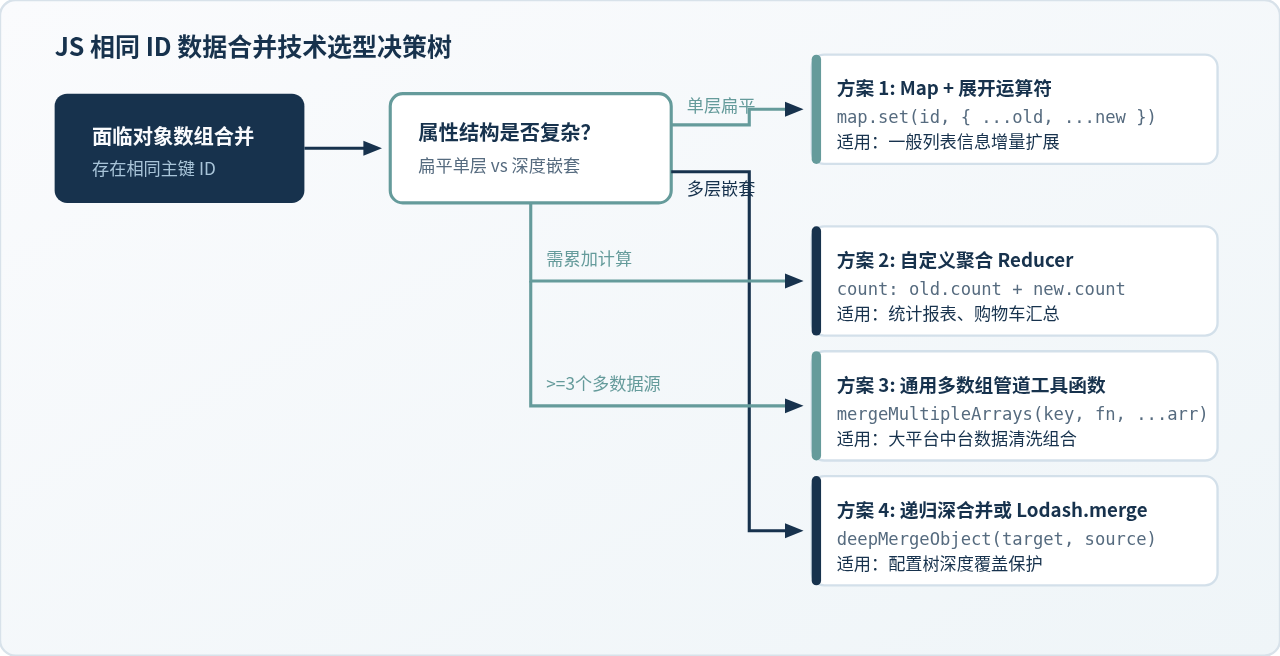
五、各实现方案的特性横向评估
| 处理方式 | 时间复杂度 | 适用场景 | 注意事项 |
|---|---|---|---|
| Map + 展开运算符 | \(O(N + M)\) | 扁平对象合并、属性补全覆盖(最推荐) | 浅拷贝只能保护第一层对象引用 |
| Reduce + 累加逻辑 | \(O(N + M)\) | 购物车、报表统计等需要字段数值累加或数组联合 | 需在累加前预先处理 null 或 undefined 默认值 |
| 递归深层合并 | \(O((N + M) imes D)\) | 树形或深层嵌套配置项 | 注意避免循环引用导致的堆栈溢出 |
| 双重循环 (filter/find) | \(O(N imes M)\) | 仅极小规模临时脚本(< 50条) | 严禁在生产级大数据量接口中使用 |
六、总结与开发备忘
在实际工程中处理相同 ID 的对象数组,牢记以下三条原则:
- 拒绝双重循环嵌套:统一使用
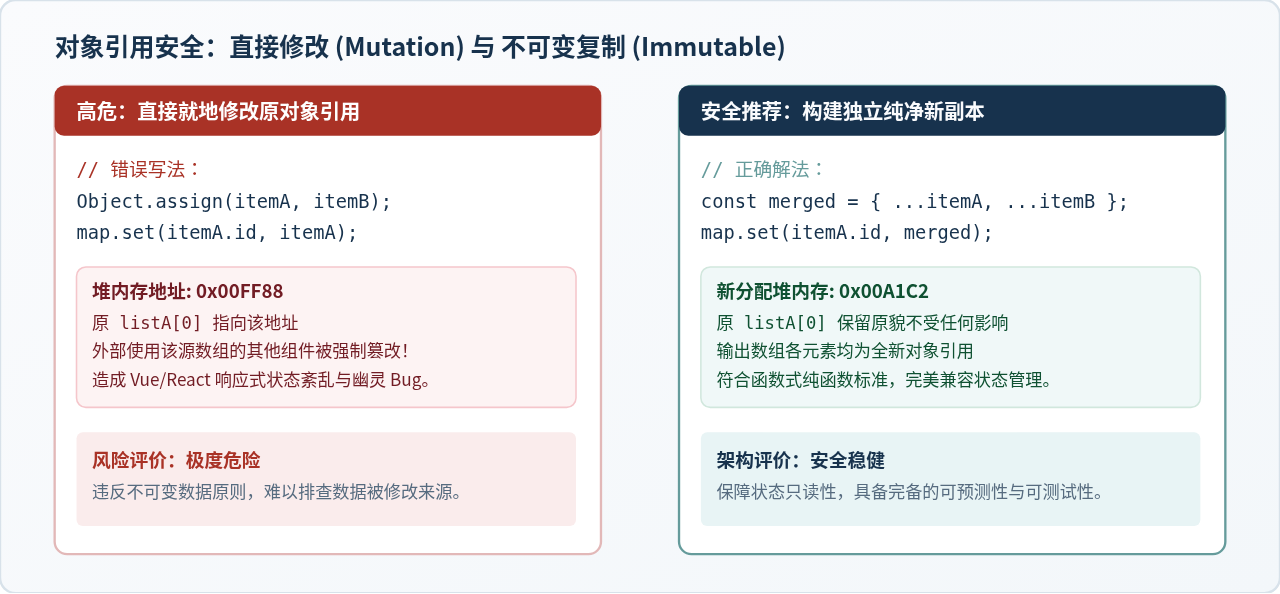
Map替代find查找,确保数据规模扩张时响应时间保持线性稳定。 - 防御式副本创建:杜绝直接对源对象使用修改式赋参(如
Object.assign(itemA, itemB)),务必通过展开语法或纯函数返回新对象,保障外部状态不被污染。 - 类型一致性校验:以
String(id)统一键名类型,防止因数据来源不同产生的隐式类型判断失误。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章