
深入解析在 JavaScript 字符串指定位置插入字符的核心原理与实用方案。从字符串不可变性机制讲起,详细演示 slice() 切片四步拼接法、边界与负数索引防御、Emoji 及特殊字符处理,并提供可直接复用的通用工具函数。

当前位置:首页 > JavaScript 基础 > 正文
怎么在JS字符串指定位置插入字符
作者:拾光
时间:2026-11-12
浏览:456
文章目录
JAVASCRIPT 核心操作指南
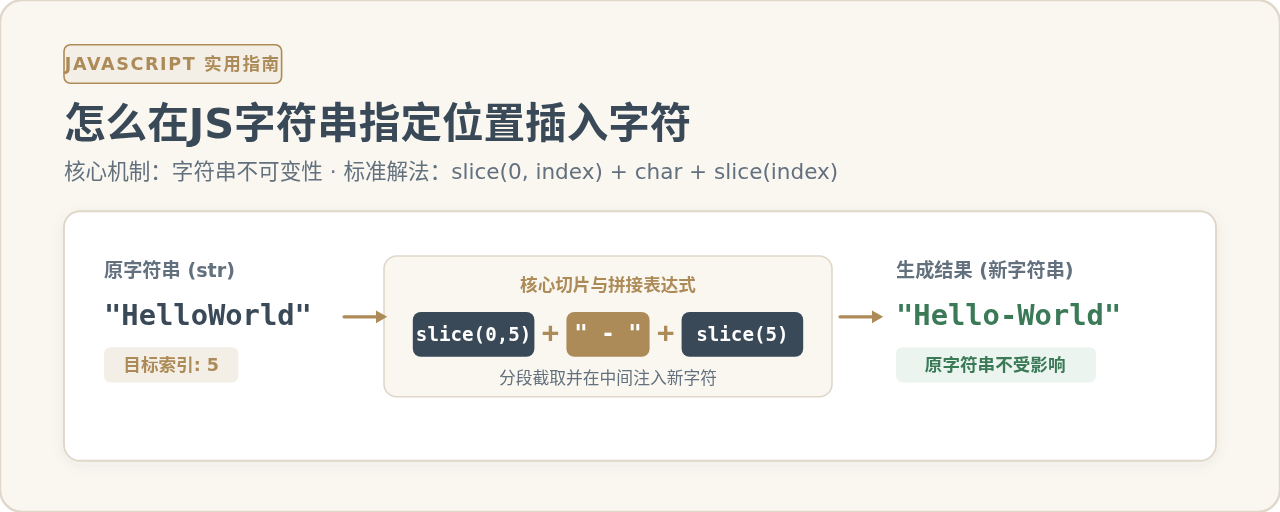
在 JavaScript 中,字符串是基本数据类型,具备不可变性(Immutability)。这意味着语言本身并没有提供像数组
splice() 那样的原生修改方法,直接对索引赋值(如 str[2] = 'x')也不会生效。要在指定位置插入字符,最直接、标准且性能优异的做法是以目标索引为分割界限,利用 slice() 将原字符串拆分成前后两半,再将待插入字符与这两部分拼接生成一个全新的字符串。
一、理解核心前提:为什么不能就地修改字符串
初学 JavaScript 的开发者常常会尝试像操作普通数组那样,直接使用方括号索引给字符串的某个位置赋值,例如:
let text = "HelloWorld";
text[5] = "-"; // 试图把第 5 个位置改成连字符

console.log(text); // 示例输出:HelloWorld(完全没有变化)
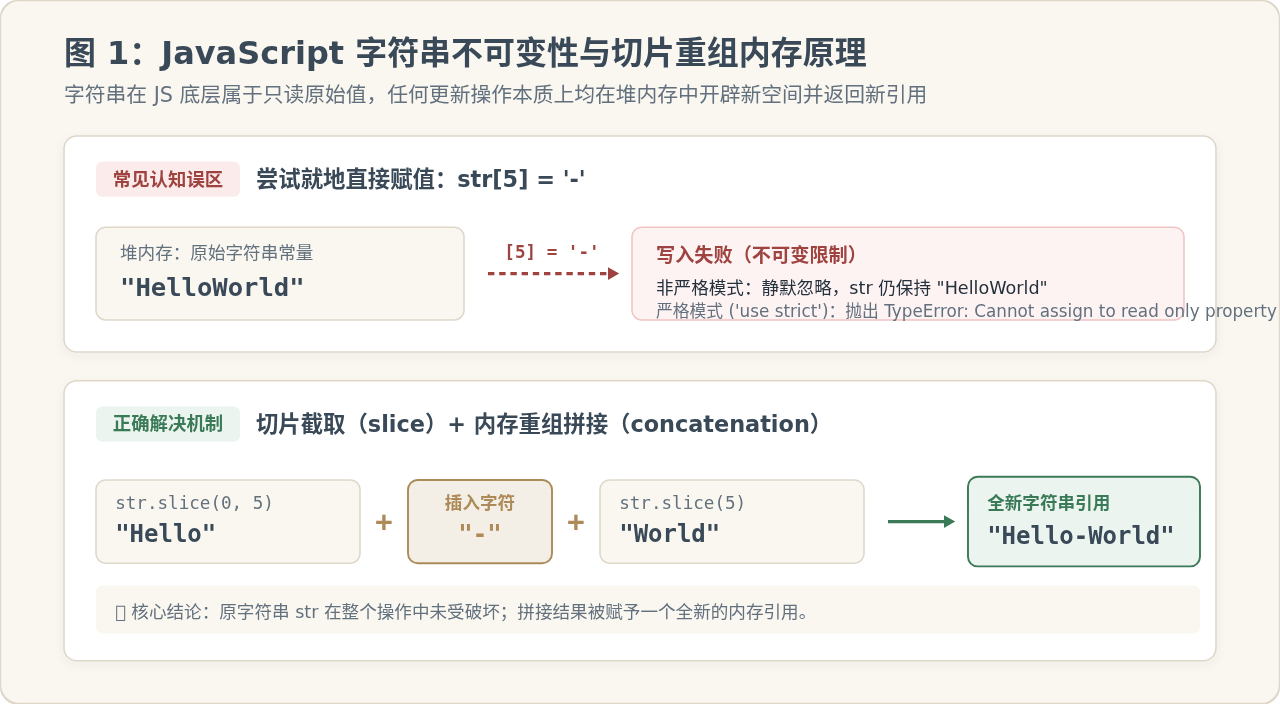
在默认的非严格模式下,这行赋值语句会静默失效;如果开启了严格模式("use strict"),运行时环境则会直接抛出类型错误:TypeError: Cannot assign to read only property '5' of string 'HelloWorld'。
产生这种现象的根本原因在于:JavaScript 的字符串属于原始值(Primitive Values)。在 V8 等现代 JavaScript 引擎的内存模型中,字符串常量一经创建就存放在只读内存段中,其字符序列是绝对不可修改的。因此,无论是“在中间插入字符”、“替换字符”还是“删除字符”,本质上都无法直接修改原有那块内存,必须通过读取原字符序列的某些片段,结合新字符,申请一块新的内存空间来创建全新字符串。
二、标准解法:使用 slice() 的四步插入流程
在所有截取子串的原生方法中,slice() 是完成该任务的最佳选择。相比于老旧的 substring() 和已被废弃的 substr(),slice() 具备明确的参数语义,并能自然支持负数倒数索引。
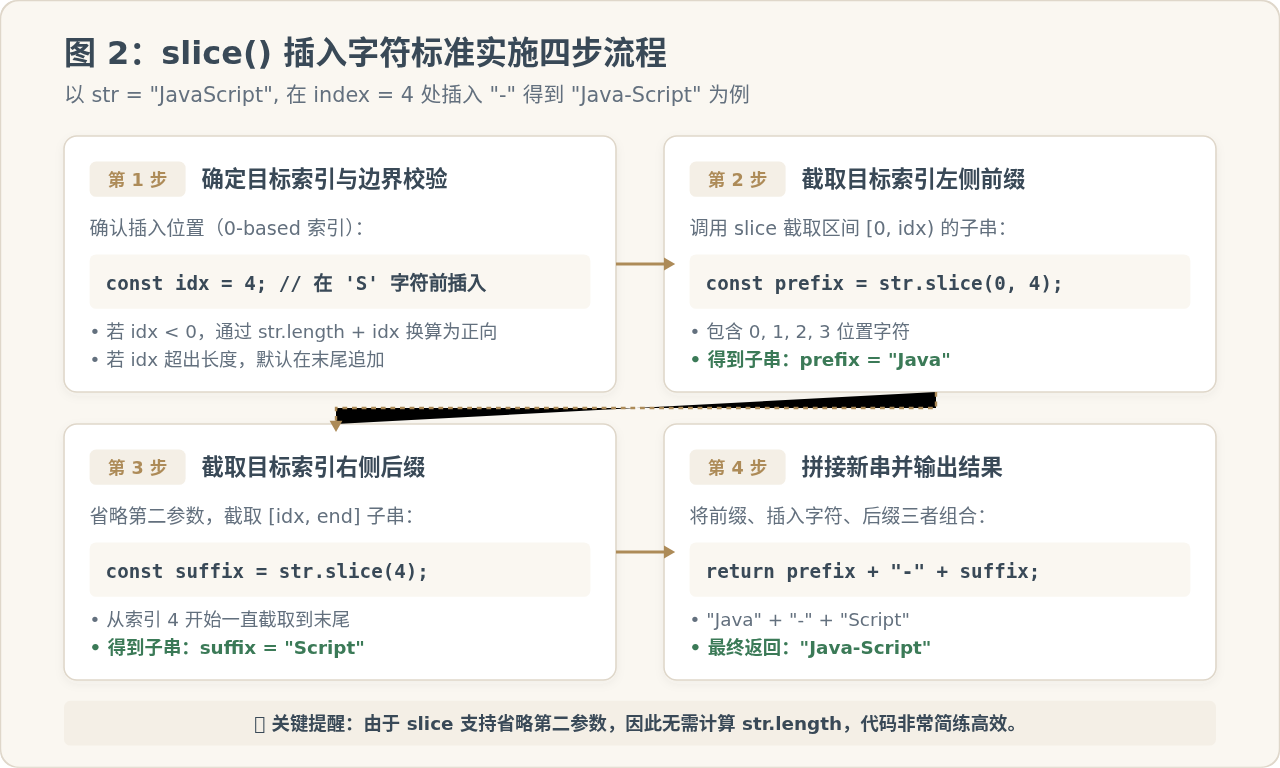
整个插入流程可以系统化地拆解为四个步骤:
- 确定目标插入索引与边界:确认新字符要插入在哪个字符之前(JavaScript 中索引从 0 开始计数)。
- 截取目标索引左侧前缀:调用
str.slice(0, index),截取左闭右开区间[0, index)内的全部字符。 - 截取目标索引右侧后缀:调用
str.slice(index),省略第二参数时将从index开始一直截取到字符串末尾。 - 组合三段内容并返回新串:使用加号运算符
+或模板字符串`${prefix}${char}${suffix}`完成组装。
下面是一个清晰易懂的基础实现范例:
// 基础切片插入示例
const originalStr = "JavaScript";
const targetIndex = 4;
const insertChar = "-";

// 截取前缀与后缀并拼接
const resultStr = originalStr.slice(0, targetIndex) + insertChar + originalStr.slice(targetIndex);

console.log(resultStr);
// 示例输出:"Java-Script"

console.log(originalStr);
// 示例输出:"JavaScript"(原字符串保持不变)
💡 为什么 slice(index) 可以省略第二个参数?
slice(startIndex, endIndex) 规定当省略 endIndex 时,默认截取至原字符串的最后一个字符。因此右半段完全不需要显式传入 originalStr.length,这样既保持了代码简明,也避免了多余的方法属性寻址开销。
三、通用工具函数封装与边界防御
在实际生产环境中,外部传入的索引参数往往可能超出常规预期:比如传入负数索引、传入超出字符串长度的数值,或者传入小数与空字符串。如果直接盲目切片,可能会导致逻辑偏差。
为此,我们需要封装一个防御性的通用函数 insertAt(),统一处理以下边界条件:
- 负数索引规范化:支持 Python 风格的倒数索引。例如
-1表示在倒数第一个字符前插入;若负数绝对值超过字符串长度,则夹取为0(在头部插入)。 - 超出长度夹取:如果传入的索引大于当前字符串长度,则自动限制在末尾处追加。
- 类型转换兜底:确保输入值被正确转换为字符串与整型数值。
/**
 * 在字符串指定索引位置插入字符或子串
 * @param {string} str - 原始字符串
 * @param {number} index - 插入位置索引(支持正数与负数)
 * @param {string} char - 待插入的字符或子字符串
 * @returns {string} 插入后的全新字符串
 */
function insertAt(str, index, char) {
  // 确保入参转换为字符串
  const source = String(str);
  const insertContent = String(char);
  const len = source.length;

  // 转换为整数索引
  let targetIndex = Math.trunc(index) || 0;

  // 负数索引处理:从尾部倒数,最小夹取为 0
  if (targetIndex < 0) {
    targetIndex = Math.max(0, len + targetIndex);
  }

  // 超过长度处理:最大夹取为当前字符串长度
  if (targetIndex > len) {
    targetIndex = len;
  }

  // 切片并返回拼接结果
  return source.slice(0, targetIndex) + insertContent + source.slice(targetIndex);
}
我们可以通过多组实际测试用例来验证该工具函数的鲁棒性:
// 边界测试用例与执行效果
const testString = "abcdef";

// 1. 中间正常插入
console.log(insertAt(testString, 3, "---"));
// 示例输出:"abc---def"

// 2. 头部插入 (索引 0)
console.log(insertAt(testString, 0, "START-"));
// 示例输出:"START-abcdef"

// 3. 尾部插入 (超出长度自动追加)
console.log(insertAt(testString, 999, "-END"));
// 示例输出:"abcdef-END"

// 4. 负数倒数插入 (-1 表示在最后一个字符 'f' 前插入)
console.log(insertAt(testString, -1, "[INSERT]"));
// 示例输出:"abcde[INSERT]f"

// 5. 极端负数 (超过长度则夹取在最前面)
console.log(insertAt(testString, -50, "HEAD-"));
// 示例输出:"HEAD-abcdef"
四、特殊场景:Unicode 代理对与 Emoji 防乱码
对于常规 ASCII 码和常用中文汉字,直接使用 slice() 已经足够安全。但在现代移动端或社交交互场景中,输入内容频繁出现 Emoji 表情符号(如 😀、🎉、👩💻)或生僻字(如“𠮷”)。
JavaScript 诞生初期采用 UTF-16 编码单元存储字符。基本的英文字符和常用汉字位于**基本多语言平面(BMP)**,只占 1 个 16 位的代码单元(Code Unit),length 为 1;而很多 Emoji 和生僻字位于辅助平面,由两个 16 位单元构成的**代理对(Surrogate Pair)**表示,其 length 实际上等于 2。
⚠️ 切裂 Emoji 代理对的乱码风险
如果原字符串中含有 "😀",它的内部由 \uD83D 和 \uDE00 两个单元拼成。如果恰好在两段代理对中间切片(例如 slice(0, 1)),就会切出一个孤立代理(Lone Surrogate),浏览器会显示为无法识别的乱码菱形问号 ""。
解决方案:使用 Array.from() 转换为码点数组
ES6 的 Array.from() 内部具备 Unicode 码点感知能力(利用迭代器协议),能够将由代理对组成的字符视作一个完整单元。我们可以借助数组的 splice() 完成插入后再 join(''):
/**
 * 支持 Unicode 码点的安全字符串插入函数
 */
function insertAtUnicode(str, index, char) {
  // 将字符串按完整 Unicode 码点解析为数组
  const charArray = Array.from(str);

  // 利用数组的 splice 就地插入内容
  charArray.splice(index, 0, char);

  // 重新合并为字符串
  return charArray.join('');
}

// 验证 Emoji 插入
const emojiStr = "Hi😀World"; // 视觉上包含 8 个字符(Hi + 😀 + World)
console.log(insertAtUnicode(emojiStr, 3, "[TEST]"));
// 示例输出:"Hi😀[TEST]World"(Emoji 保持完好,不会损坏)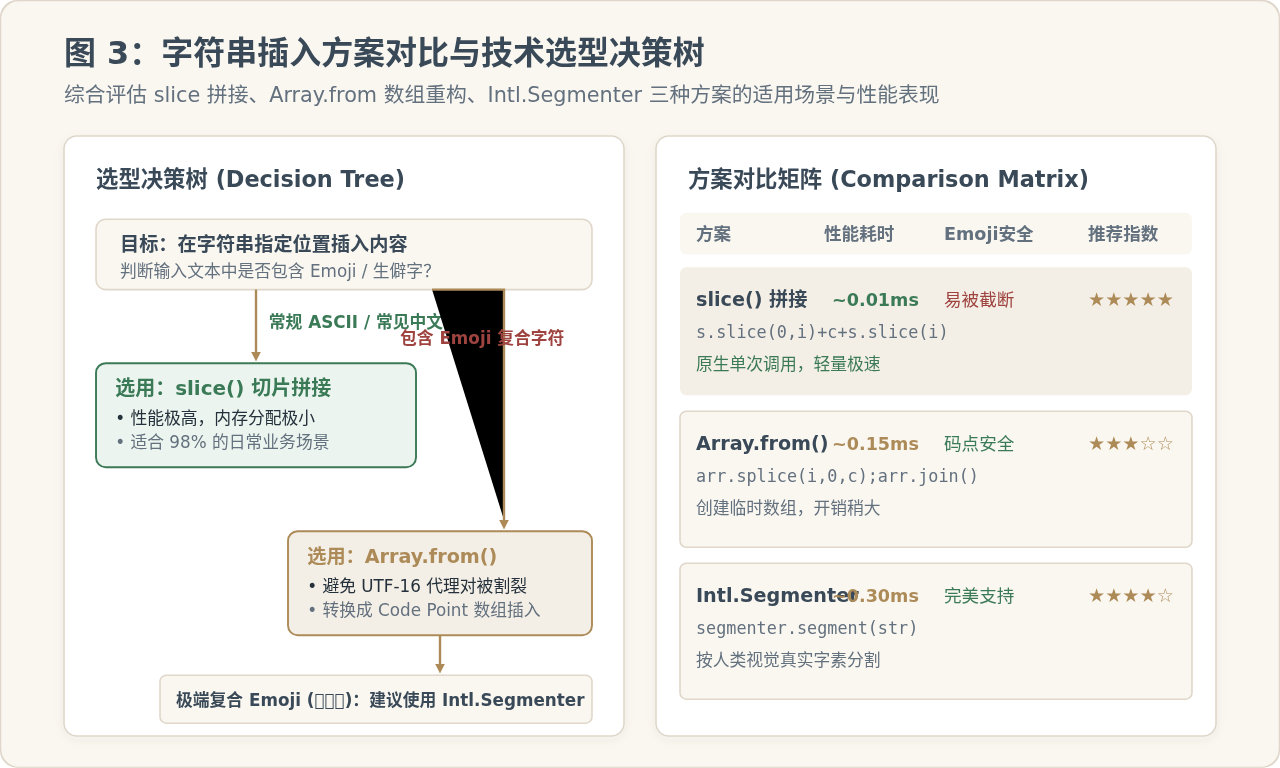
五、高频多次插入的性能陷阱与优化
如果只需要在字符串中的某一个位置插入一次内容,slice() 拼接是性能最极致的方案(耗时仅在微秒/纳秒级别)。但在实际开发中,有时需要在**多个不同位置连续插入字符**(例如对长串数字格式化、文本高亮标记包裹、代码代码高亮语法树还原等)。
如果直接在循环中多次调用 str = str.slice(0, i) + ... + str.slice(i),会引发两个致命问题:
- 索引位移错乱:每次前置插入都会改变后续字符的真实索引位置,导致后面的插入点全部产生偏移。
- 频繁内存垃圾(GC 压力):字符串在循环中被重复创建与丢弃,时间复杂度退化至 \(O(N^2)\)。
优化方案:倒序切片或片段数组收集
针对多点插入场景,推荐采用“倒序插入”策略:将所有插入点按照索引从大到小(自后向前)排序后再执行切片插入。因为在后面位置插入内容,完全不会影响前面字符的索引偏移:
/**
 * 批量在多个位置插入内容的高性能安全方案
 * @param {string} str - 原字符串
 * @param {Array<{index: number, text: string}>} insertions - 插入点数组
 */
function batchInsert(str, insertions) {
  // 1. 按照索引从大到小(倒序)排序
  const sorted = [...insertions].sort((a, b) => b.index - a.index);

  let result = str;
  // 2. 自后向前依次插入,前部索引始终保持稳定
  for (const item of sorted) {
    result = result.slice(0, item.index) + item.text + result.slice(item.index);
  }

  return result;
}

// 示例:将手机号 13800138000 格式化为 138-0013-8000
const phone = "13800138000";
const formatted = batchInsert(phone, [
  { index: 3, text: "-" },
  { index: 7, text: "-" }
]);
console.log(formatted);
// 示例输出:"138-0013-8000"
六、方案全景对比与易错清单复盘
为了在实际开发中快速选用最合适的语法结构,我们将常用的三种方案汇总成下述对比表格:
| 实现方案 | 核心调用语法 | 执行效率 | 多字节字符支持 | 最佳适用场景 |
|---|---|---|---|---|
| slice() 切片拼接 | s.slice(0, i) + c + s.slice(i) |
极快(单次切片重组) | 标准 ASCII / 常见汉字 | 单次插入首选(覆盖95%以上业务) |
| Array.from() 数组法 | Array.from(s).splice(...) |
中等(需分配临时数组) | 支持单码点 Emoji / 复杂字符 | 用户富文本、社交表情符号安全插入 |
| Intl.Segmenter | new Intl.Segmenter().segment() |
较慢(多语言词法分词) | 完全支持所有复杂复合字素簇 | 极其复杂的合体表情、多语言文本排版 |
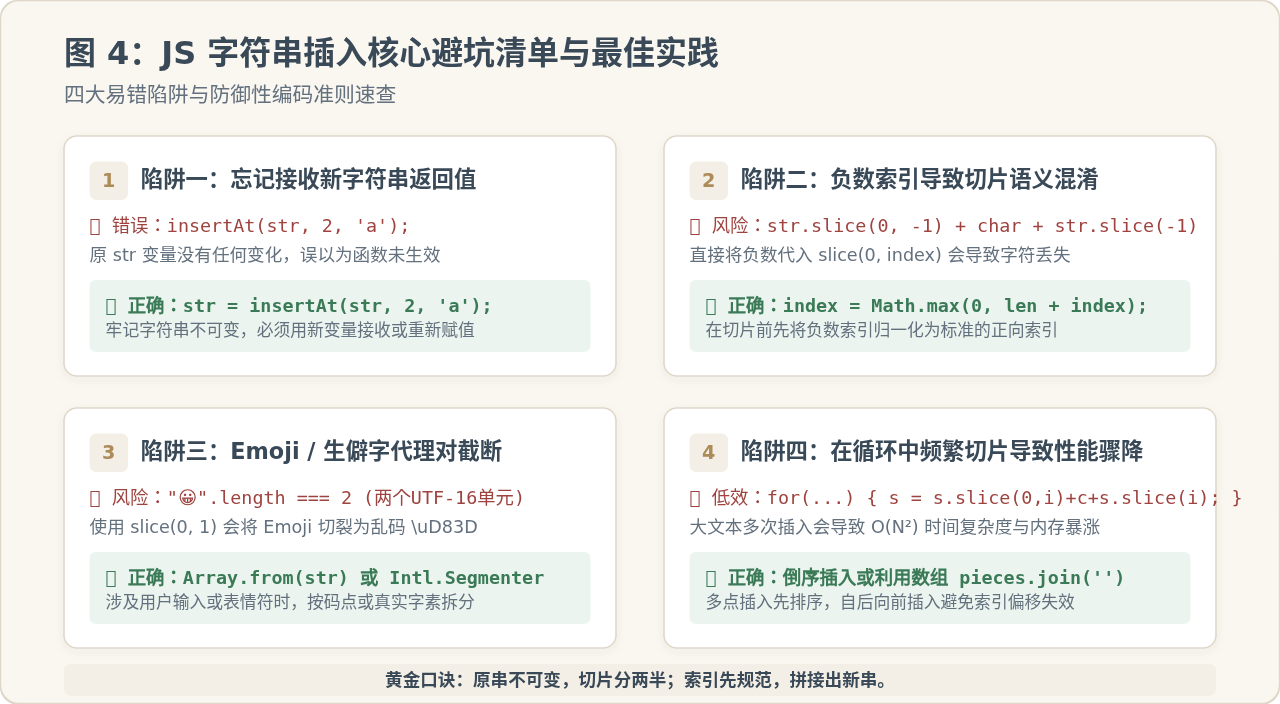
最后,总结牢记以下四项核心注意点:
- 原值永不改变:始终记得使用变量接收新生成的返回值,永远不要指望任何方法会就地修改原字符串。
- 首选原生 slice:没有特殊需求时直接使用
str.slice(0, index) + char + str.slice(index),无需引入任何外部依赖。 - 负数索引先换算:切片前将负数统一转换为
Math.max(0, len + index),避免参数传递过程中的语义割裂。 - 多点插入自后向前:多位置插入务必先按索引降序排列,自后向前插入,彻底杜绝索引漂移问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章