
深入剖析JavaScript中使用双按位非(~~)和按位或0(|0)实现数值取整的底层规范原理、ECMAScript ToInt32转换机制、与Math.trunc/Math.floor的本质差异,以及32位整数溢出、特殊值处理等关键工程局限。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript中使用位运算(~~或|0)取整的原理与局限
作者:沉舟
时间:2026-11-12
浏览:454
文章目录
ECMAScript 规范深度剖析
底层机制与性能考量
阅读时长:约 10 分钟
规范参照:ECMA-262 ToInt32
在 JavaScript 开发中,x | 0(按位或零)与 ~~x(双重按位非)常作为快速去除数值小数部分的简写技巧出现。这种用法的核心机制并不是 JavaScript 单独设计了某种取整符号,而是 ECMAScript 规范中所有的 32 位按位运算符在执行计算前,都会强制对其操作数调用 ToInt32 抽象操作,将 IEEE 754 双精度 64 位浮点数转换为 32 位有符号二进制补码整数。在合法的 32 位整数范围内,这种转换产生的效果恰好等同于“向零截断”(即 Math.trunc())。然而,正是这种底层的 32 位整型转换,带来了极其严苛的数值安全边界、负数取整方向差异以及特殊值的静默归零陷阱。理解其底层规范与工程局限,是编写高可靠数值计算代码的基础。
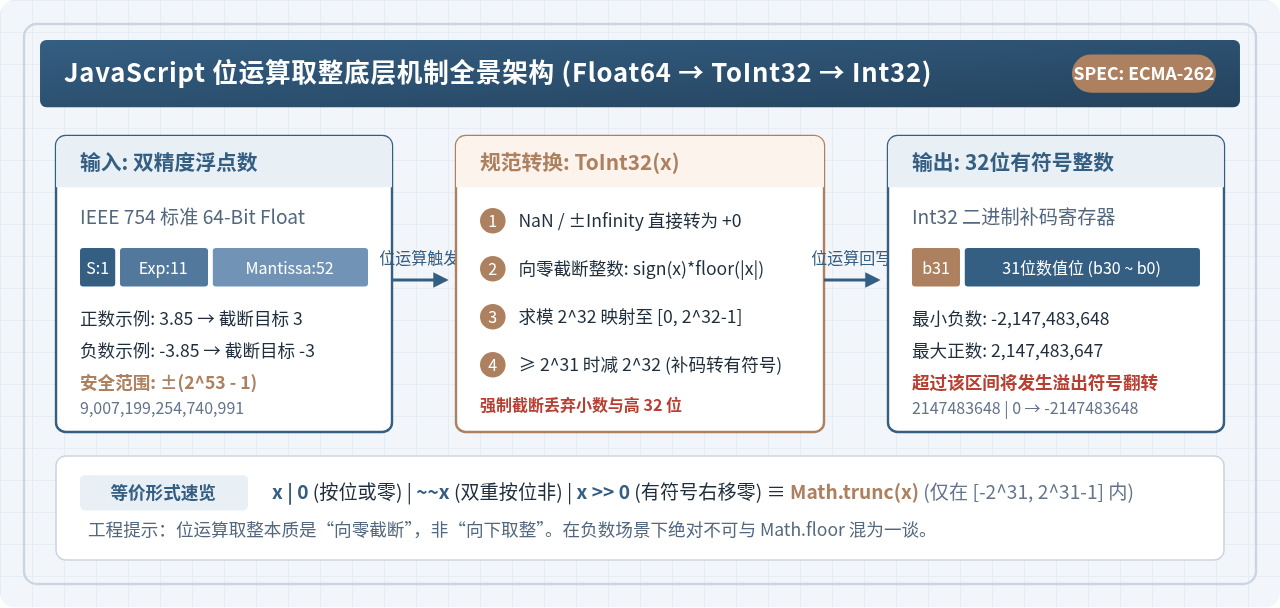
一、底层运行机制:ECMAScript 中的 ToInt32 抽象操作
在 JavaScript 中,所有的基本数值类型(Number)在底层均遵循 IEEE 754 标准,采用 64 位双精度浮点数表示。标准浮点数包含 1 位符号位(Sign)、11 位指数位(Exponent)以及 52 位有效数字尾数(Mantissa)。这意味着 JavaScript 在语言层面并没有独立的整型物理内存类型,所有的整数计算在概念上都是双精度浮点数。
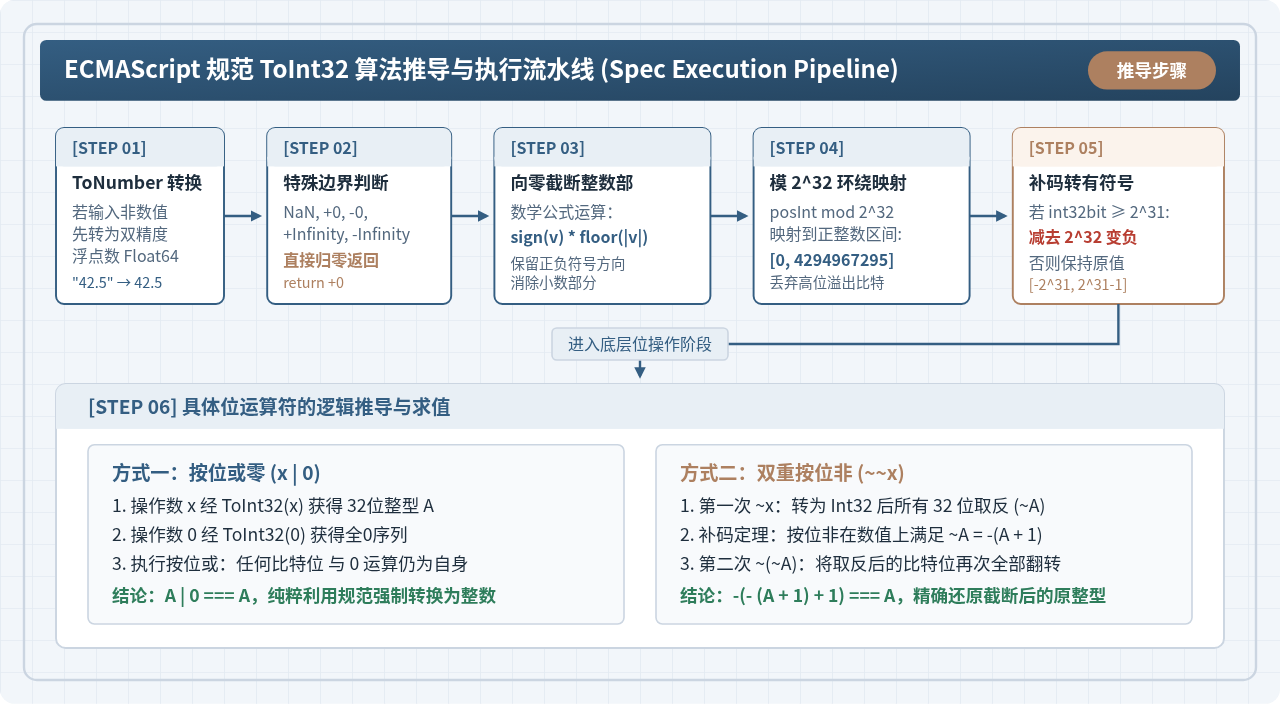
当代码中执行按位与(&)、按位或(|)、按位异或(^)、按位非(~)或移位运算(<<、>>)时,处理器需要直接对二进制比特位进行门电路级别的布尔运算。因此,根据 ECMAScript 规范(ECMA-262)第 7.1.6 节规定,引擎必须先将操作数转为 32 位整数。该抽象转换过程被形式化定义为 ToInt32(argument),其核心计算步骤如下:
- 数值预处理:首先对输入参数调用
ToNumber(),将其解析为 Number 类型; - 特殊浮点值过滤:若数值为
NaN、+0、-0、+Infinity或-Infinity,算法直接中止并返回+0; - 向零截断小数:计算数值的整数部分,公式为
posInt = sign(number) * floor(abs(number)),直接丢弃所有小数点后的位数; - 高位模运算:计算
int32bit = posInt mod 2^32,通过对 $2^32$ 取模,将任意可能的大整数严格约束在 $[0, 2^32 - 1]$ 的无符号 32 位整数区间,超出 32 位的更高比特位被全部截断抛弃; - 补码符号还原:若
int32bit ≥ 2^31,则返回int32bit - 2^32,将其映射为 $[-2^31, 2^31 - 1]$ 区间内的 32 位有符号负数;否则直接返回int32bit。
二、~~ 与 | 0 的具体运算细节
明确了 ToInt32 抽象操作的存在后,便能很容易推导为什么 | 0 与 ~~ 能够产生取整效果:
1. 按位或零(x | 0)
对于双目位运算符 |,规范要求对左侧操作数执行 ToInt32(x) 得到 32 位整数 $A$,对右侧操作数执行 ToInt32(0) 得到 32 位的全零序列。根据布尔代数法则,任何二进制位与 0 进行按位或运算,结果均保持原位不变(即 $bit \lor 0 = bit$)。因此,$A \lor 0 = A$。运算本身的位操作是恒等映射,取整效果纯粹来自于前置的 ToInt32 规范转换。
2. 双重按位非(~~x)
按位非运算符 ~ 是单目运算符。根据规范,~x 执行时首先将 $x$ 转换为 32 位有符号整数 $A$,然后对 $A$ 的全部 32 个二进制位逐位取反。在补码计算机系统中,对一个整数按位取反满足恒等式:
// 补码系统中的按位非数学定理
~A === -(A + 1)
例如,若 $A = 5$,则 ~5 === -6;若 $A = -6$,则 ~(-6) === 5。当连续应用两次按位非时:
// 双重按位非的求值展开
~~A === ~(~A) === -((-(A + 1)) + 1) === -(-A - 1 + 1) === A
第二次运算将所有被反转的比特位完整还原,最终得到经过 ToInt32 截断后的一模一样的整数 $A$。
三、取整行为辨析:向零截断与 Math.floor 的本质区别
在许多日常开发讨论中,常有人将位运算取整误认为是 Math.floor() 的简写。这一认知在处理正数时看似成立,但在负数场景下会导致严重的逻辑偏差。位运算的取整模式严格属于向零截断(Truncation towards zero),与 ES6 引入的 Math.trunc() 完全一致,而与 Math.floor() 存在本质差异。
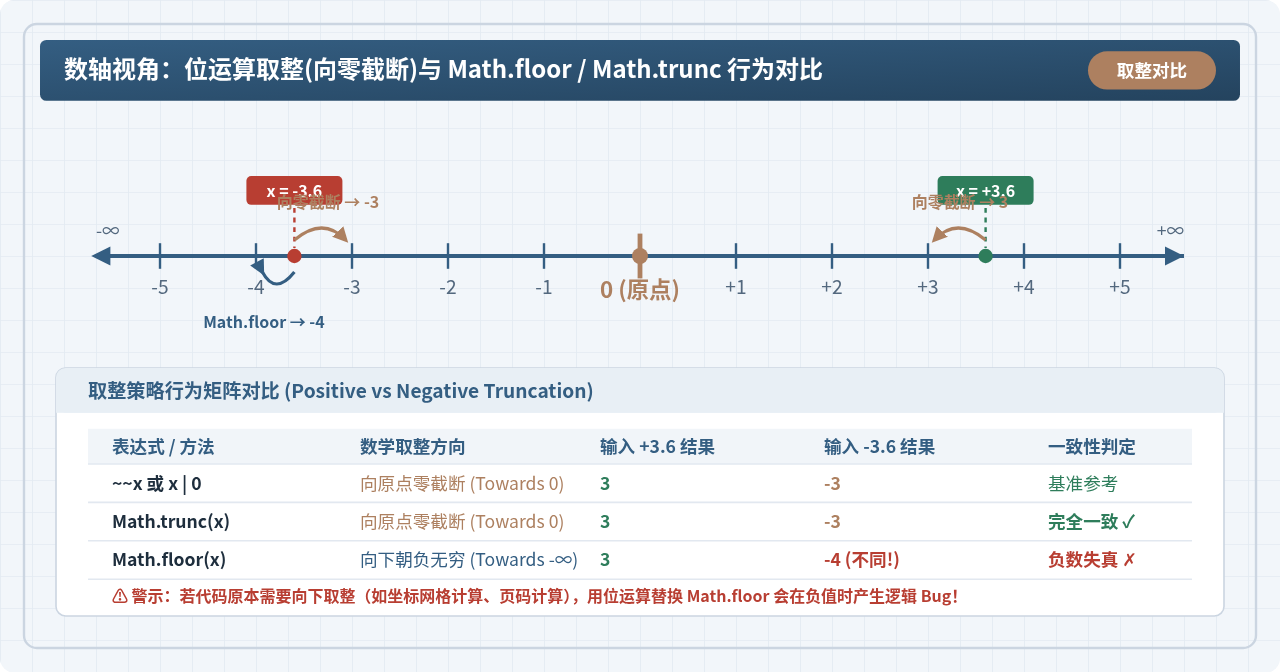
观察实数轴上的移动方向:
Math.floor(x)(向下取整):取不大于 $x$ 的最大整数。在数轴上始终向左(即向 $-\infty$ 方向)寻找最近的整数。对于正数Math.floor(3.7)得到3;但对于负数Math.floor(-3.7),向左靠拢得到的是-4。~~x与x | 0(向零截断):直接抹去浮点数后方的小数尾数,在数轴上始终朝坐标原点 $0$ 靠拢。对于正数~~3.7得到3;而对于负数~~(-3.7),向原点靠拢得到的是-3。Math.trunc(x)(标准向零截断):语义与位运算取整保持一致,无论正负数,均丢弃小数部分,正数趋向于0,负数同样趋向于0。
| 测试输入 | x | 0 / ~~x |
Math.trunc(x) |
Math.floor(x) |
Math.ceil(x) |
|---|---|---|---|---|
4.8 |
4 |
4 |
4 |
5 |
4.2 |
4 |
4 |
4 |
5 |
-4.2 |
-4 |
-4 |
-5 | -4 |
-4.8 |
-4 |
-4 |
-5 | -4 |
⚠️ 潜在逻辑 Bug 提醒
如果在实现分页计算(如计算偏移量)、网格坐标转换或向下对齐算法时,原本需要使用 Math.floor(),却轻率地用 | 0 或 ~~ 代替,一旦遇到负值坐标,计算结果就会发生 1 个单位的偏差(例如 -3.1 被算成 -3 而非 -4),从而引发难以排查的越界错误。
四、致命局限一:32 位有符号整数的数值范围与越界陷阱
位运算取整最危险的局限性,在于其强制将操作数截断在 32 位有符号整型范围内。JavaScript 标准 Number 类型能够安全无损表示的整数范围为 $[-(2^53 - 1), 2^53 - 1]$(即 Number.MIN_SAFE_INTEGER 至 Number.MAX_SAFE_INTEGER,上限高达约 $9 imes 10^15$)。然而,32 位有符号整数的表示范围仅仅为:
// 32位有符号整数的安全范围(两端闭区间)
[-2147483648, 2147483647]  // [-2^31, 2^31 - 1]
一旦输入的数值绝对值超过了 $2^31 - 1$(即 $2,147,483,647$),ToInt32 的模 $2^32$ 算法就会切断高位比特,并将第 31 位直接视作负数符号位。这会导致两个灾难性后果:数值严重失真与符号位意外翻转。
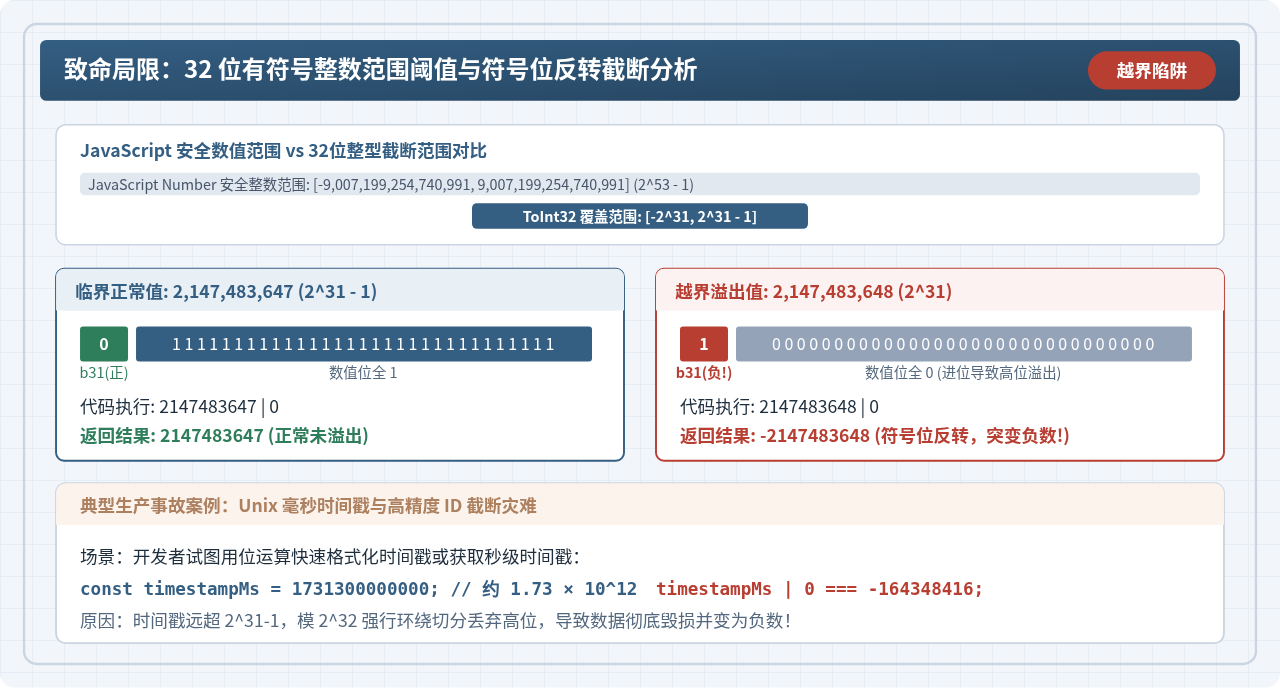
1. 临界点溢出实验
// 在安全边界内正常运作
const safeMax = 2147483647;
console.log(safeMax | 0);   // 输出: 2147483647 (正常)

// 超过最大正整数仅 1 个单位
const overflowVal = 2147483648; // 2^31
console.log(overflowVal | 0);   // 输出: -2147483648 (瞬间变为负数最小值!)
console.log(~~overflowVal);     // 输出: -2147483648 (同样崩塌)
console.log(Math.trunc(overflowVal)); // 输出: 2147483648 (标准方法安然无恙)
2. 生产环境高频踩坑场景
在日常业务开发中,开发者很容易在以下场景不慎触碰 32 位溢出红线:
- Unix 毫秒时间戳:当前随手获取的毫秒时间戳
Date.now()约为 $1.73 imes 10^12$,远超 $2.14 imes 10^9$。若对时间戳使用Date.now() | 0,将得到负数废值(例如-164348416),导致时间差计算、定时器比对彻底崩溃。 - 数据库分布式 ID(雪花算法 Snowflake):后端返回的 64 位整型 ID 经常达到 18~19 位十进制数,若前端在处理前误用了位运算取整,高位数据直接蒸发,导致请求发送错误的关联主键。
- 文件体积与大容量统计:以字节(Byte)计算的现代存储容量,超过 2GB($2 imes 1024^3 = 2,147,483,648$ 字节)即跨越溢出临界线,位运算处理会导致文件大小显示为负值。
五、致命局限二:非数值与特殊浮点值的静默归零风险
由于 ToInt32 算法严格规定对 NaN 与无限大浮点数直接返回 +0,这使得位运算具有强大的“静默容错”特性。在某些脚本编写中,有人故意利用这一点将异常值快捷归零,但这恰恰是工程维护中的隐形杀手。
// 特殊浮点值的静默转换表现
console.log(NaN | 0);          // 0
console.log(~~Infinity);       // 0
console.log(~~null);           // 0 (先 ToNumber 转为 0)
console.log(~~undefined);      // 0 (先 ToNumber 转为 NaN,再变为 0)
console.log(~~"abc");          // 0
对比标准函数的行为:
Math.trunc(NaN)返回NaN;Math.trunc(Infinity)返回Infinity;Math.trunc(undefined)返回NaN。
在严肃的数据处理链路中,NaN 通常意味着前置公式发生了除以零、非法字段解析或无效参数传递等严重逻辑错误。标准函数保留 NaN,可以让错误沿调用栈向上传递,便于监控系统及时捕获告警;而位运算将所有非法输入静默转化为合法的有效数字 0,掩盖了深层逻辑缺陷,使得脏数据长驱直入写入持久化数据库。
🚨 现代类型系统与 BigInt 冲突
ES2020 引入了原生的 BigInt 类型。在 JavaScript 中,任何试图混合 BigInt 与 Number 进行隐式转换的操作都会直接抛出 TypeError: Cannot mix BigInt and other types, use explicit conversions。如果代码期望通用处理可能为 BigInt 的大整数,直接调用 v | 0 会直接导致程序崩溃,而无法像显式类型判断那样安全回退。
六、现代 JavaScript 引擎下的性能现实与工程选型规范
为什么位运算取整在历史上如此流行?在早期的 IE 浏览器和早期 V8 引擎(ES5 时代及以前)中,标准库方法 Math.floor() 作为外部函数调用,存在微小的函数调用开销(Function Call Overhead)以及浮点数寄存器切换损耗。在当时,使用单个字节的 | 0 往往能直接被解释器映射为底层单条指令,因而在高频动画循环中带来了可观测的微秒级优势。
但在现代主流浏览器与 Node.js 运行时中,这一历史背景已经彻底改变:
- 标准取整函数的 JIT 内联(Inlining):现代 V8、JavaScriptCore 和 SpiderMonkey 引擎配备了高度智能的自适应即时编译器(如 TurboFan)。对于
Math.trunc()和Math.floor(),JIT 编译器会在编译流水线中识别模式,直接内联生成针对 x86-64 架构的专用 CPU 截断指令(例如cvttsd2si)或 ARM64 架构的fcvtzs指令。在基准测试中,常规代码中Math.trunc()与| 0的执行耗时已经处于同一数量级,性能差距通常在统计学误差范围内。 - 语义自解释与代码审查成本:代码的第一读者是人类开发者。
Math.trunc(val)具有极其明确的代码语义(意为“对浮点数向零截断”),无需读者猜测作者意图;而~~val或val | 0属于黑魔法简写,降低了代码可读性,对初中级工程师并不友好,容易被团队成员在重构时不慎误改为Math.floor()或误删。
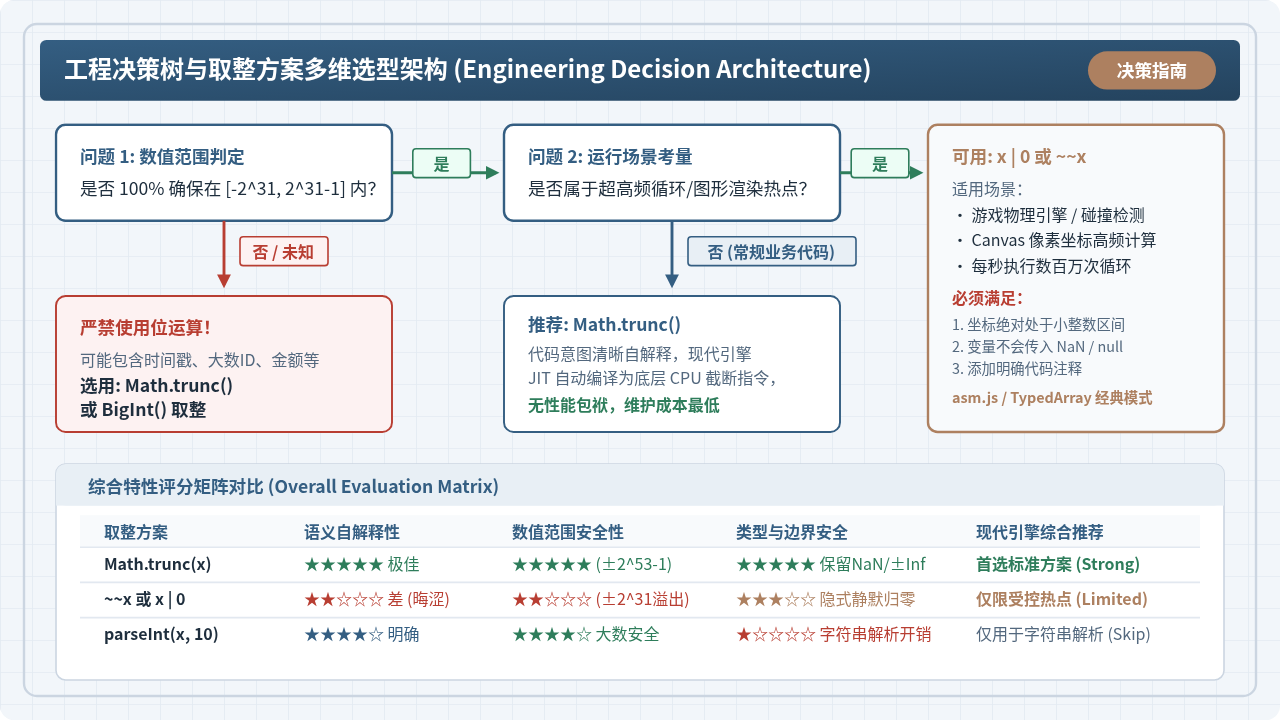
七、工程实践总结与代码选型清单
为了在实际团队开发中规范数值取整代码,建议遵循以下清晰的工程决策准则:
- 默认优先原则:在所有常规业务逻辑、接口响应处理、数据统计和通用前端组件中,一律使用标准
Math.trunc()(向零截断)或Math.floor()(明确需要向下取整时)。保持代码自解释性与最大安全数值范围; - 严禁使用位运算的红线场景:凡是涉及时间戳(毫秒/微秒)、数据库主键 ID、加密哈希、文件字节大小、大额金融交易金额等可能跨越或接近 32 位整数边界(21 亿)的场景,严格禁止使用
| 0或~~; - 允许微优化的受控场景:仅在游戏核心循环、物理碰撞模拟引擎、HTML5 Canvas 像素数组离线图像处理或 WebGL 着色器顶点坐标转换等每秒运算数百万次的超热点循环中,且百分之百确定数值为 $[0, 4096]$ 等受控小整数时,可使用
| 0或~~进行微量性能调优,并务必在代码上方添加注释注明取值范围保证; - 解析字符串场景:若输入为字符串形式的数字,切勿依赖位运算的隐式转换,应显式采用
Number.parseInt(str, 10),避免类型歧义。
通过遵循上述规范,开发者既能在关键计算场景中规避底层溢出造成的灾难性线上故障,又能产出清晰、健壮且易于长期维护的高质量 JavaScript 代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章