
详细讲解在JavaScript中使用CryptoJS库将字符串编码为16进制(Hex)的方法、核心原理、双向转换代码示例以及处理中文UTF-8编码时的关键细节与避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
CryptoJS库怎么实现字符串到16进制的编码
作者:闭包旅人
时间:2026-11-11
浏览:165
文章目录
在 JavaScript 前后端开发中,使用 CryptoJS 将普通字符串转换为十六进制(Hex)编码的核心路径是:先通过
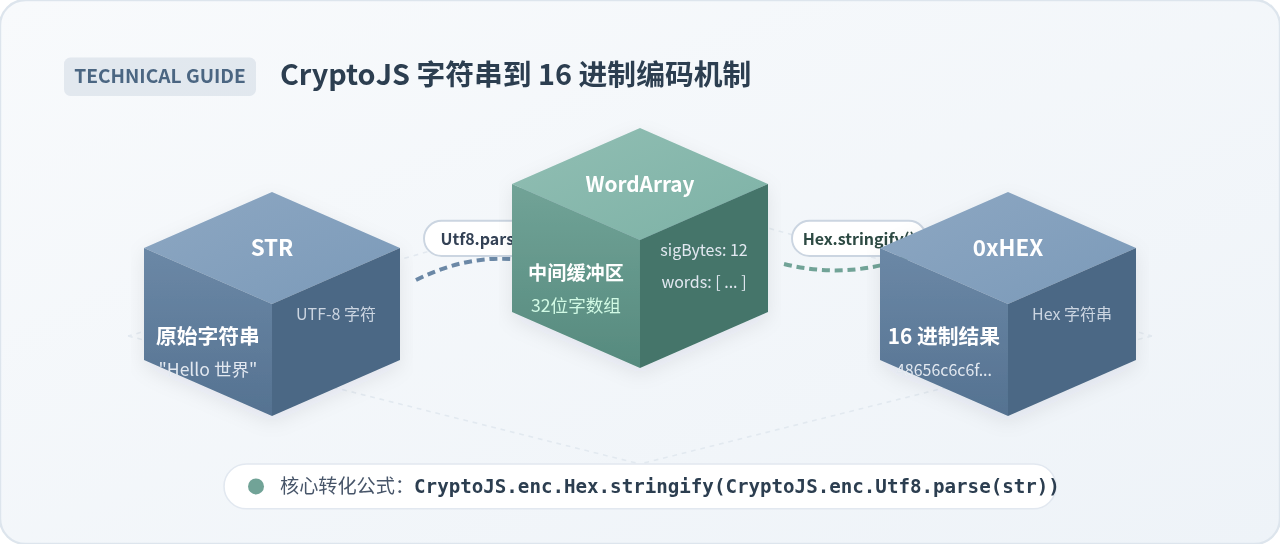
CryptoJS.enc.Utf8.parse() 将字符串解析为库内部通用的 WordArray 二进制缓冲对象,再通过 CryptoJS.enc.Hex.stringify() 将其格式化为十六进制字符串。本文将系统拆解该转换的具体代码实现、双向编解码原理、中文字符处理细节以及常见工程踩坑点。
一、核心结论与单行快捷写法
很多刚接触 CryptoJS 的开发者会直觉性地寻找形如 CryptoJS.toHex(str) 这样的快捷函数,但该库并未提供此类顶层直接转换方法。在 CryptoJS 的类型设计中,所有编码转换都围绕中间容器 WordArray 展开。
实现字符串到 16 进制编码的标准单行代码如下:
// 最推荐的标准写法
const hexString = CryptoJS.enc.Hex.stringify(CryptoJS.enc.Utf8.parse("待编码的文本"));
此外,WordArray 实例本身提供了 toString() 方法,其默认入参编码器恰好就是 CryptoJS.enc.Hex,因此以下简写在功能上与上面完全等价:
// 基于 toString 默认参数的简写方式
const wordArray = CryptoJS.enc.Utf8.parse("待编码的文本");
const hexString = wordArray.toString(); // 默认即按 Hex 输出
二、核心机制解析:为什么要经过 WordArray
理解 CryptoJS 编码逻辑的关键,在于明白它为什么需要引入 WordArray 这个中间层。CryptoJS 是一个专注密码学计算的库(包含 MD5、SHA256、AES、DES 等)。在底层计算时,算法处理的都是 32 位(4 字节)字构成的二进制块。
JavaScript 运行时的原生字符串是字符序列,而不同的字符集(如 ASCII、UTF-8、GBK)下字符对应的字节数并不相同。CryptoJS 无法直接把字符串当做加密或编码输入,必须先通过编码器(Encoder)将文本明确解构为字节流,并打包存放在 CryptoJS.lib.WordArray 对象中。
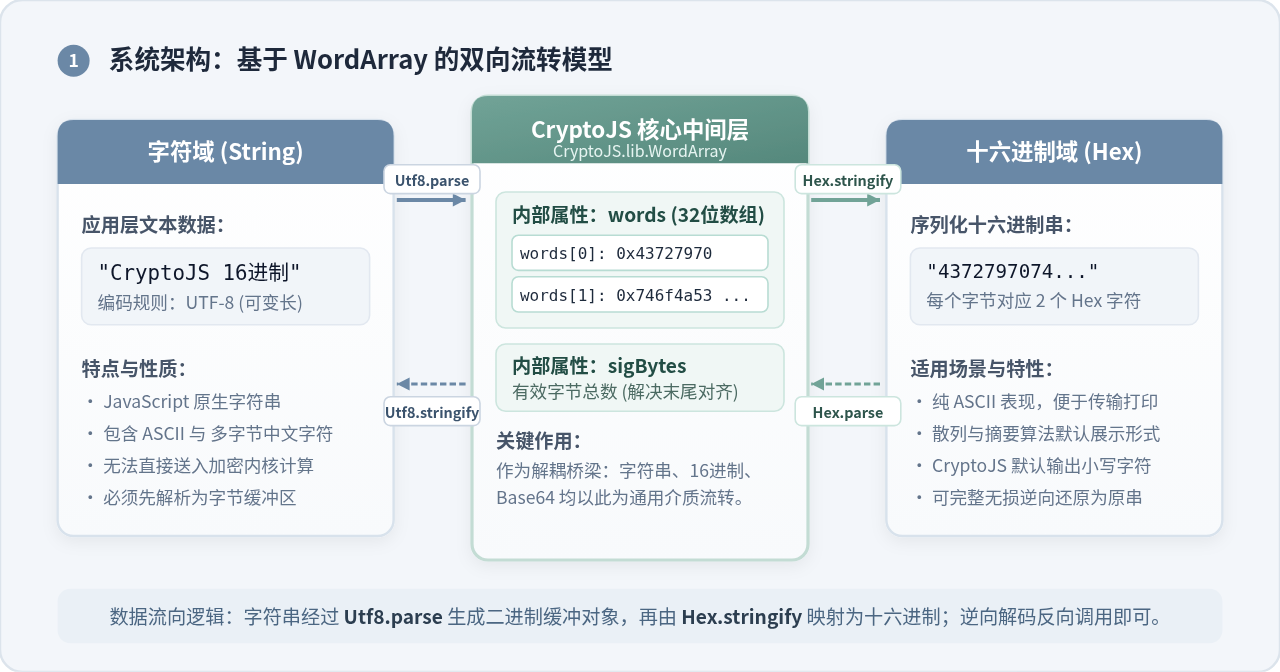
WordArray 主要包含两个内部属性:
words:一个 32 位有符号整数数组,每个元素容纳 4 个连续的字节。sigBytes:有效字节总数。因为words数组是以 4 字节为单位对齐的,当待转换文本的字节总数不是 4 的倍数时,最后一个整数高位填充了数据,而sigBytes准确标明了实际有效的字节边界,防止格式化输出时出现末尾冗余数据。
三、分步实操:完整代码实现与逆向验证
下面按照实际项目开发的规范步骤,演示如何在 Node.js 或浏览器环境中导入库、完成字符串到 16 进制的编码,并进行逆向解码验证。
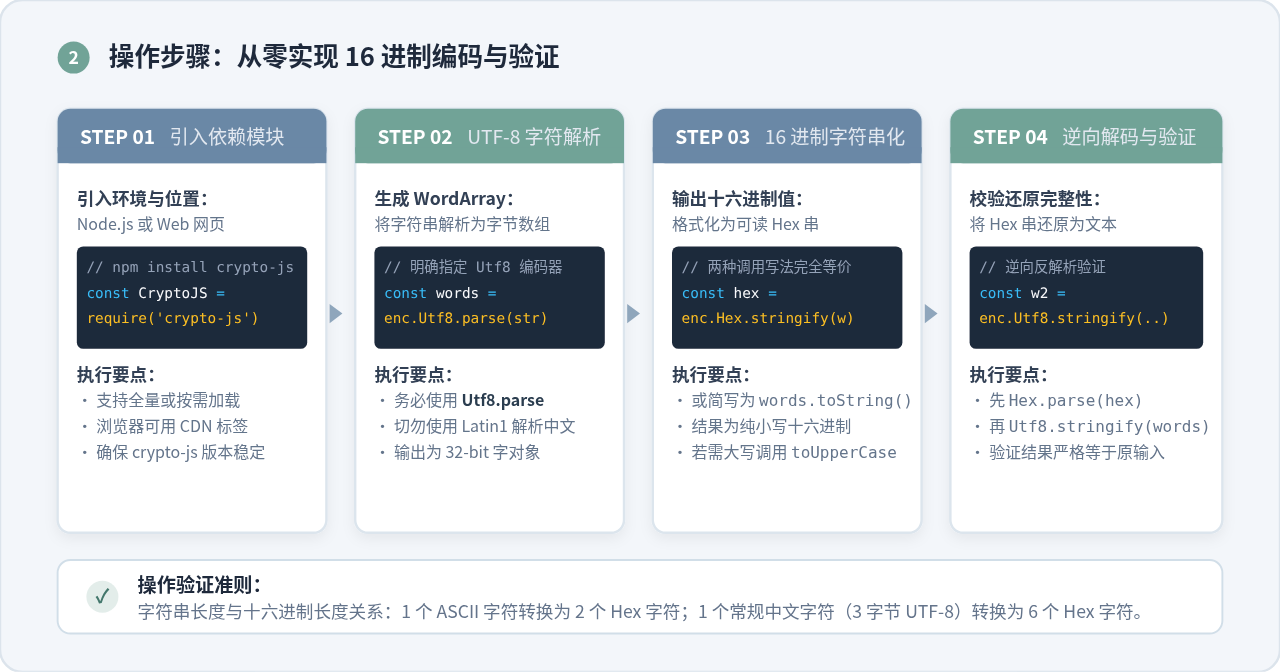
1. 引入 CryptoJS 库
在 Node.js 环境中通过 npm 安装并导入:
# 安装依赖
npm install crypto-js
// CommonJS 规范导入
const CryptoJS = require("crypto-js");
// 或 ES Module 规范导入
// import CryptoJS from "crypto-js";如果在浏览器端使用,可通过 CDN 引入脚本:
<!-- 浏览器端通过 CDN 标签直接引入 -->
<script src="https://cdnjs.cloudflare.com/ajax/libs/crypto-js/4.2.0/crypto-js.min.js"></script>
2. 编写正向转换与反向验证代码
以下是完整的可执行示例,包含了 ASCII 字符和中文字符的编码与解码:
const CryptoJS = require("crypto-js");

// 待编码的原始字符串
const originalText = "Hello, CryptoJS! 中文测试";

// 步骤一:将 UTF-8 字符串解析为 WordArray
const wordArray = CryptoJS.enc.Utf8.parse(originalText);

// 步骤二:将 WordArray 格式化为 16 进制字符串
const hexResult = CryptoJS.enc.Hex.stringify(wordArray);

console.log("原始文本:", originalText);
console.log("16进制编码结果:", hexResult);

// 步骤三:逆向反解析(Hex -> WordArray -> UTF-8 文本)
const parsedWords = CryptoJS.enc.Hex.parse(hexResult);
const decodedText = CryptoJS.enc.Utf8.stringify(parsedWords);

console.log("逆向还原文本:", decodedText);
console.log("还原是否一致:", originalText === decodedText);
3. 示例输出结果
# 控制台运行输出示例
原始文本: Hello, CryptoJS! 中文测试
16进制编码结果: 48656c6c6f2c2043727970746f4a532120e4b8ade69687e6b58be8af95
逆向还原文本: Hello, CryptoJS! 中文测试
还原是否一致: true
四、字节深度剖析:ASCII 与中文的 Hex 映射差异
在十六进制编码中,每个字节(8 位二进制)由两个十六进制字符(高 4 位与低 4 位,即半字节 Nibble)表示。因此,转换后的 16 进制字符串长度必然是原字节数的两倍。
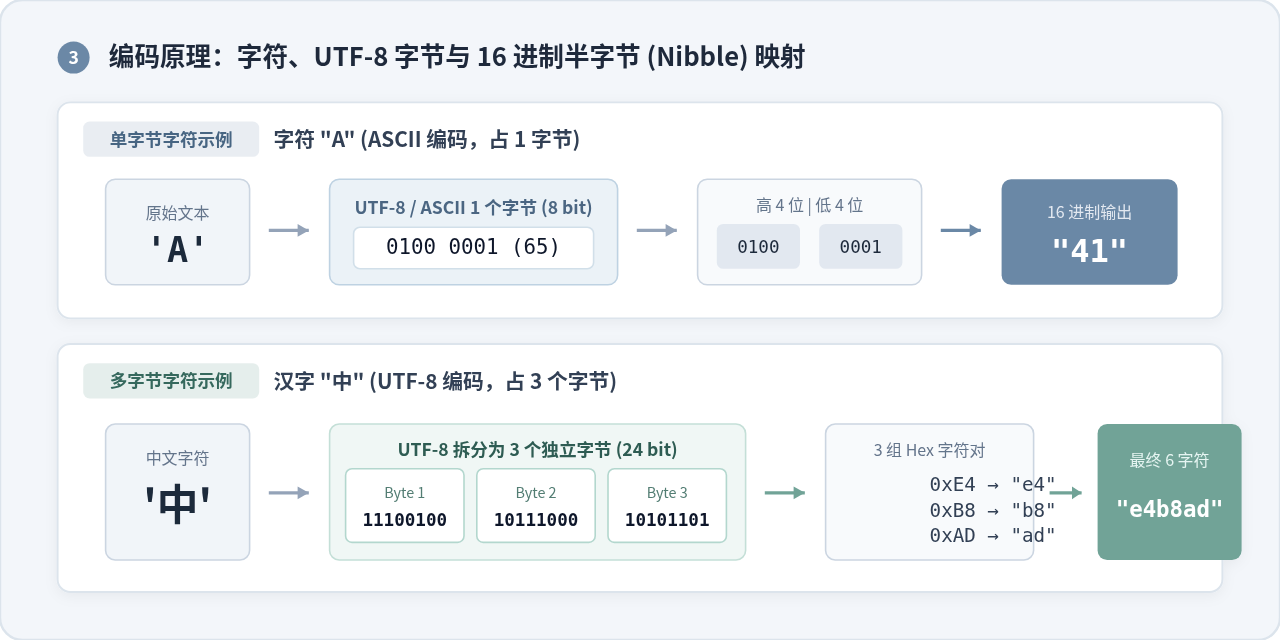
针对不同类型的字符,字节和 Hex 映射规则如下:
| 字符类型 | 示例字符 | UTF-8 字节数 | 十六进制字节值 | 最终 Hex 串 | Hex 字符长度 |
|---|---|---|---|---|---|
| 标准 ASCII 字母 | 'A' | 1 字节 | 0x41 | "41" | 2 字符 |
| 标准 ASCII 标点 | '!' | 1 字节 | 0x21 | "21" | 2 字符 |
| 常用中文字符 | '中' | 3 字节 | 0xE4, 0xB8, 0xAD | "e4b8ad" | 6 字符 |
| 复杂中文 / 汉字 | '测' | 3 字节 | 0xE6, 0xB5, 0x8B | "e6b58b" | 6 字符 |
| Emoji 表情 | '😊' | 4 字节 | 0xF0, 0x9F, 0x98, 0x8A | "f09f988a" | 8 字符 |
重要警示:避免使用 Latin1 解析中文
CryptoJS 还提供了 CryptoJS.enc.Latin1。Latin1(ISO-8859-1)是单字节编码,它在处理字符时直接丢弃高位字节,只保留字符码点低 8 位。如果使用 CryptoJS.enc.Latin1.parse() 处理中文字符,将导致严重的数据截断与不可逆的乱码,务必全程保持使用 CryptoJS.enc.Utf8。
五、工程实践与避坑要点
在实际生产环境(例如对接支付接口、密码学验签、自定义硬件通信协议)中,使用 16 进制编码时需特别注意以下几点:
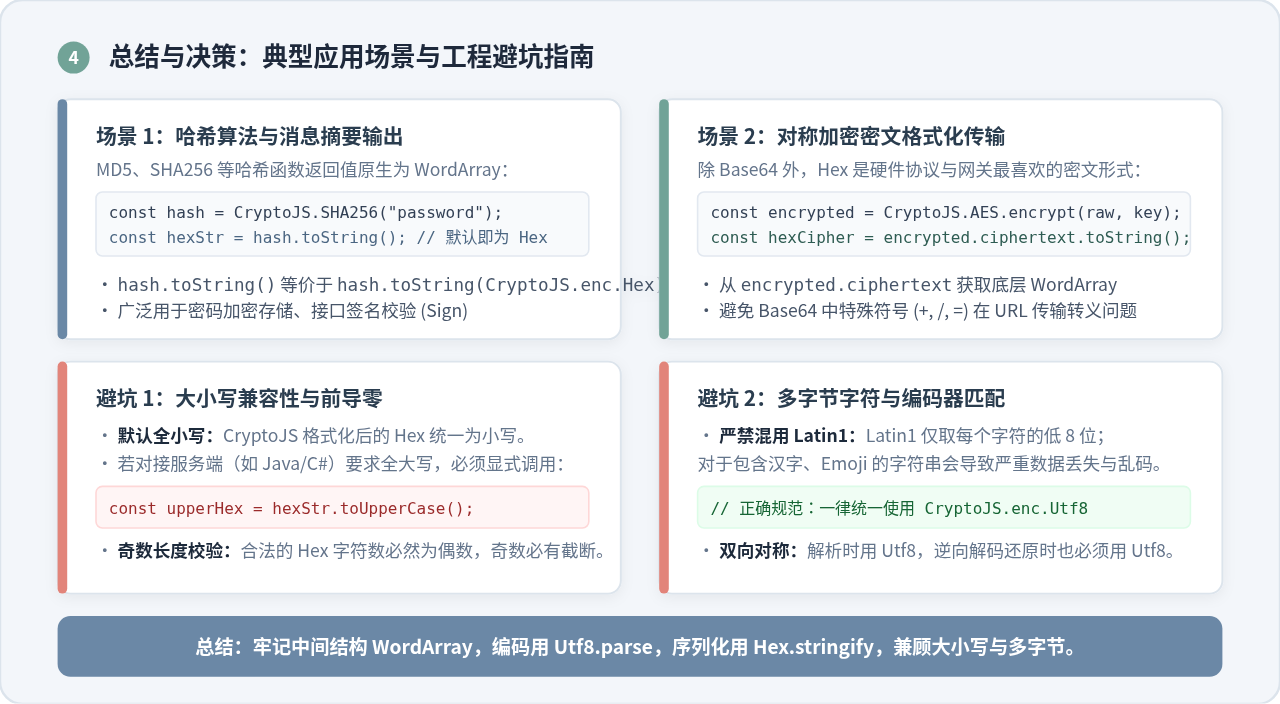
1. 大小写敏感性与对接系统兼容
CryptoJS.enc.Hex.stringify() 默认生成的是全小写的十六进制字母(如 "e4b8ad")。
然而在 Java(如 Hex.encodeHexString() 某些实现)、C# 或某些旧版银行网关中,接口规范可能强制要求大写字母(如 "E4B8AD")。如果后端比对时采用了大小写敏感匹配,会导致签名或验签失败。
// 如服务端要求大写,前端显式调用 toUpperCase()
const upperHex = CryptoJS.enc.Hex.stringify(wordArray).toUpperCase();
2. 哈希算法的默认 Hex 输出特性
很多开发者使用 16 进制编码是为了格式化哈希结果。在 CryptoJS 中,CryptoJS.MD5()、CryptoJS.SHA256() 等函数执行后返回的也是 WordArray 对象。
这意味着直接对哈希结果调用 .toString() 就是标准的十六进制字符串,无需多加一层 Utf8.parse:
// 正确:哈希结果直接转为 16 进制字符串
const hashResult = CryptoJS.SHA256("my_secret").toString();

// 错误做法:切勿对已经经过哈希的 WordArray 再次做 Utf8.parse
3. 对称加密(AES/DES)输出 Hex 密文
CryptoJS.AES.encrypt() 返回的 CipherParams 对象默认序列化输出为 Base64 字符串。如果项目通信协议要求传输 16 进制密文,正确的做法是从其 ciphertext 属性获取底层 WordArray 并转为 Hex:
const encrypted = CryptoJS.AES.encrypt("核心数据", "密钥");

// 获取 16 进制格式的密文
const hexCipher = encrypted.ciphertext.toString(CryptoJS.enc.Hex);
调试技巧:验证十六进制合法性
一个合法的 Hex 编码字符串必须满足:长度为偶数(hexStr.length % 2 === 0),且只包含十六进制字符(正则表达式 /^[0-9a-fA-F]+$/)。在调用 CryptoJS.enc.Hex.parse() 解析外部传入的数据前进行该校验,可以有效拦截因数据截断或网络传输丢包引发的异常。
总结
CryptoJS 中实现字符串到 16 进制的编码并不复杂,核心在于理解其以 WordArray 为数据中枢的架构逻辑。只要遵循 “输入通过 CryptoJS.enc.Utf8.parse() 解构为字数组,输出通过 CryptoJS.enc.Hex.stringify() 序列化为 Hex” 这一范式,并注意大小写和非 ASCII 字符的编码一致性,即可在各种加解密与通信场景中安全、稳定地使用十六进制编码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章