
深入对比 JavaScript 中两大主流函数式编程库 Ramda 与 Lodash FP 的底层设计哲学、参数元数机制、不可变透镜更新、打包体积与工程化选型决策指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
Ramda 与 Lodash FP 在 JavaScript 中的区别与选择
作者:闭包旅人
时间:2026-11-07
浏览:285
文章目录
在现代 JavaScript 开发中,Ramda 和 Lodash FP(
lodash/fp)是两个最常被对比的函数式编程实用库。两者都支持“函数优先、数据最后”(Data-last)与“自动柯里化”(Auto-currying),旨在帮助开发者通过纯函数管道消除中间变量与命令式状态变更。然而,它们在底层架构理念、参数元数截断、透镜(Lens)支持、代数规范与工程化生态上存在本质区别。本文将直入主题,详细剖析两者行为差异,提供可执行的代码对比,并给出清晰明确的团队技术选型路径。
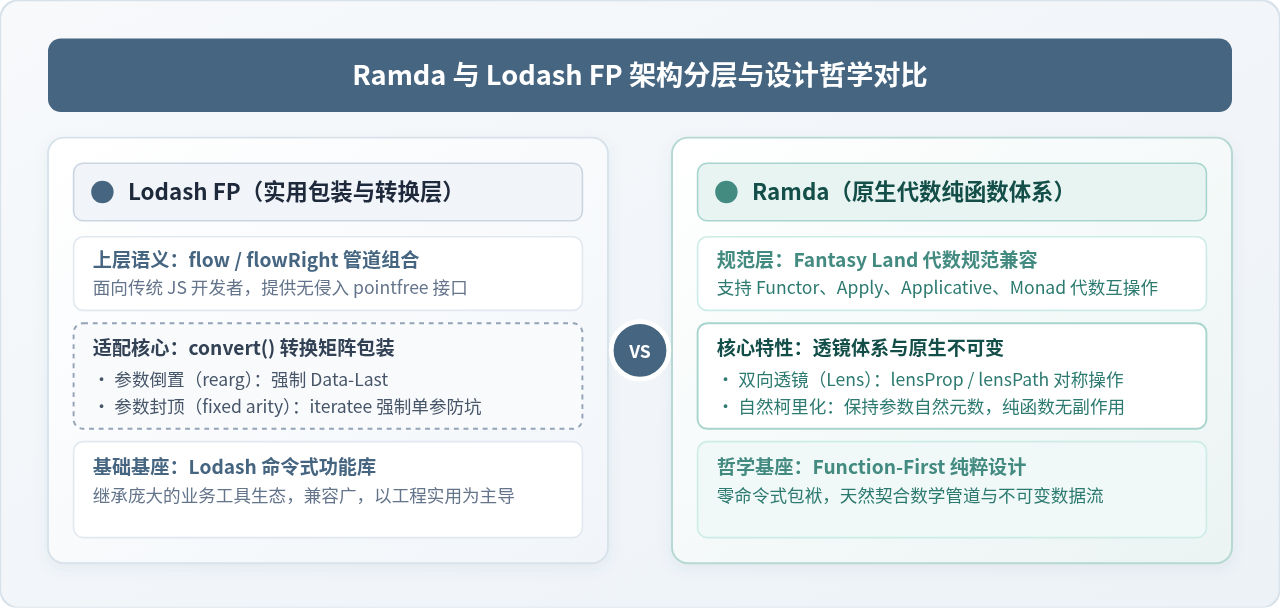
图 1:Ramda 与 Lodash FP 的架构分层与设计哲学对比示意图
一、核心定位与设计哲学差异
要理解 Ramda 与 Lodash FP 的行为分歧,首先必须看清两者的来源与定位目标:
- Lodash FP(实用主义包装器):Lodash 本质上是一个庞大的命令式工具集。为了顺应函数式编程潮流,Lodash 推出了
lodash/fp模块。该模块并非重写代码,而是通过内置的convert()转换矩阵,自动将原有函数包装为“参数倒置(rearg)”和“固定柯里化”版本。它的首要目标是让熟悉 Lodash 的开发者以极低的学习成本无缝使用函数组合(flow)。 - Ramda(纯粹原生函数式体系):Ramda 诞生之初就彻底确立了“Function-First”设计哲学。它的所有 API 从零开始编写,严格保证参数为 Data-last,无条件保持不可变性,杜绝任何隐式环境猜测与命令式副作用。更为关键的是,Ramda 深度遵循 JavaScript 函数式代数规范(Fantasy Land),天然契合 Monad、Functor 等高阶代数结构。
核心哲学提炼
Lodash FP 是“将命令式工具库改造成函数式风格”,重在通用与实用;Ramda 则是“从数学与范畴论规范出发构建函数式生态”,重在严谨、纯粹与可代数组合。
二、关键技术机制与行为差异深度解析
虽然两者在简单调用时看起来极为相似,但在复杂的实际业务管道中,以下几个核心机制决定了代码的健壮度与行为表现。
1. 柯里化与参数元数截断机制(Fixed Arity vs Natural Arity)
在函数式编程中,柯里化(Currying)要求函数必须明确知道自己总共接收几个参数才能决定何时执行。JavaScript 函数往往允许可变参数(Variadic Arguments),这直接导致柯里化无法自动确定终止时机。
两者的解决策略截然不同:
- Lodash FP 的固定封顶(Capped Arity):Lodash FP 对每一个函数都强制指定了固定的参数元数,并默认启用了
cap: true。例如在fp.map(fn, list)中,迭代函数fn只会被传入 1 个参数(即当前元素),原生的index和array参数被强制抛弃。这种设计的初衷是规避 JavaScript 经典的['1', '2', '3'].map(parseInt)(因 parseInt 接收第二个 radix 参数而导致解析错误)陷阱,但在需要根据索引进行计算时,必须显式调用fp.map.convert({ cap: false })进行解封。 - Ramda 的自然元数与单一职责:Ramda 在柯里化时严格保留函数的自然参数量。在 Ramda 的世界里,
R.map同样只传递单个元素给回调,但这是基于其一元映射的数学语义;若开发者需要索引,Ramda 提供了独立专职的工具函数R.addIndex(例如R.addIndex(R.map)((val, idx) => ...))。这种通过显式组合而非隐式截断的做法,使得函数行为始终透明可控。
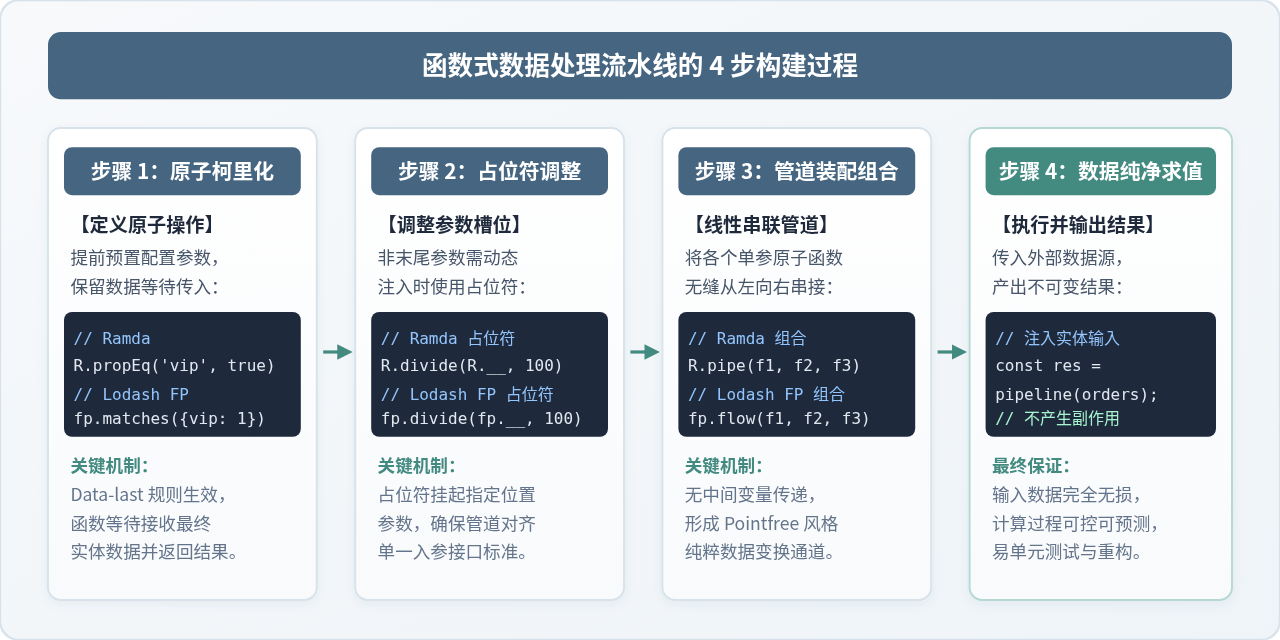
图 2:基于 Data-last 与柯里化装配数据处理流水线的 4 个关键步骤
2. 占位符机制(Placeholders)
当我们要把数据插入到柯里化函数的非末尾参数槽位时,需要使用参数占位符:
- Ramda:使用全局唯一的
R.__符号。例如除法操作R.divide(R.__, 10)会返回一个“将传入值除以 10”的函数。 - Lodash FP:使用
fp.placeholder或fp.__。功能类似,但在某些深度复合场景下,Lodash FP 对多层占位符的展开推断相对脆弱。
3. 管道组合方向语义
在数据流管道组合上,两者命名的语义偏好反映了工程与学术的不同倾向:
// 从左向右(先执行 f1,再执行 f2,符合人眼自上而下的阅读顺序):
const rPipeline  = R.pipe(f1, f2, f3);
const fpPipeline = fp.flow(f1, f2, f3);

// 从右向左(数学复合函数 f3(f2(f1(x))) 的标准映射顺序):
const rCompose  = R.compose(f3, f2, f1);
const fpCompose = fp.flowRight(f3, f2, f1);
4. 深层不可变数据操作:Ramda Lens vs Lodash FP 路径修改
在管理复杂前端状态(如 Redux 或大型配置对象)时,深层嵌套对象的只读更新是最高频的操作之一。
Lodash FP 延续了路径字符串的命令式思路:通过 fp.get('a.b.c')、fp.set('a.b.c', value)、fp.update('a.b.c', fn) 完成更新。这种方式上手极快,但路径与操作是分离的。
Ramda 则完整实现了函数式编程中的核心抽象——透镜(Lens)。Lens 是一种聚焦在数据结构特定局部的一等公民对象,具备读写对称性:
// 声明一个聚焦在 user.profile.address.city 的透镜对象
const cityLens = R.lensPath(['user', 'profile', 'address', 'city']);

// 同一个透镜,既可用于安全读取(view),也可用于纯函数更新(set/over)
const currentCity = R.view(cityLens, state);
const updatedState = R.set(cityLens, '上海', state);
const upperState   = R.over(cityLens, s => s.toUpperCase(), state);
由于 Lens 是独立值,它可以被传递、组装并在多个不同的业务逻辑间复用,彻底规避了路径硬编码散落在各处的维护隐患。
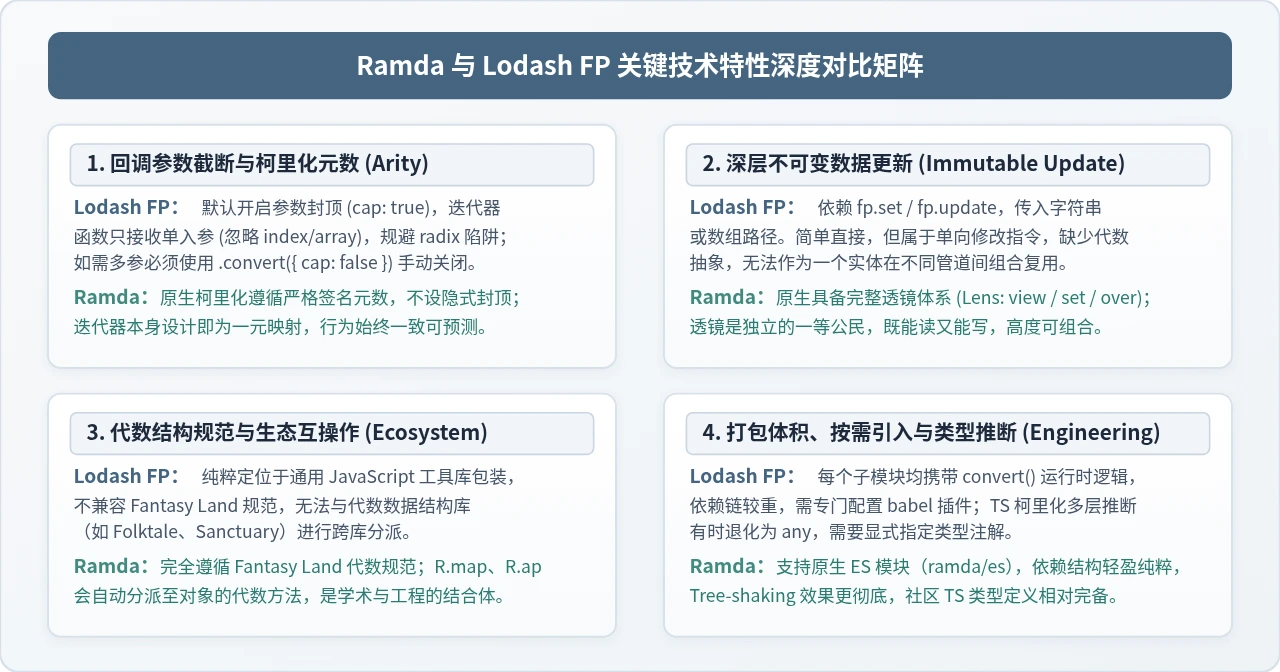
图 3:Ramda 与 Lodash FP 在 4 大核心技术维度上的深度对比矩阵
三、典型业务场景代码实操对比
下面通过具体业务场景,展示在真实开发中两者的编码体验与差异。
场景 1:电商订单数据管道清洗与统计
业务需求:输入一组订单列表,过滤出已支付订单(status === 'PAID'),提取会员折扣后的有效金额,计算总额并格式化为带货币符号的字符串输出。
Lodash FP 实现方式:
import fp from 'lodash/fp';

const rawOrders = [
  { id: 101, status: 'PAID', amount: 280, isVip: true },
  { id: 102, status: 'PENDING', amount: 150, isVip: false },
  { id: 103, status: 'PAID', amount: 500, isVip: false },
  { id: 104, status: 'PAID', amount: 120, isVip: true },
];

// 计算实际支付金额:VIP 享 9 折
const getEffectivePrice = order =>
  order.isVip ? order.amount * 0.9 : order.amount;

// 使用 fp.flow 组装不可变数据流
const calculatePaidTotal = fp.flow([
  fp.filter(order => order.status === 'PAID'),
  fp.map(getEffectivePrice),
  fp.sum,
  total => `¥${total.toFixed(2)}`
]);

console.log(calculatePaidTotal(rawOrders)); // 示例输出: "¥860.00"
Ramda 实现方式:
import * as R from 'ramda';

// 借助 Ramda 内置高阶谓词,以完全 Pointfree 方式声明单项规则
const getEffectivePriceR = R.ifElse(
  R.propEq(true, 'isVip'),
  order => R.multiply(order.amount, 0.9),
  R.prop('amount')
);

const calculatePaidTotalR = R.pipe(
  R.filter(R.propEq('PAID', 'status')),
  R.map(getEffectivePriceR),
  R.sum,
  total => `¥${total.toFixed(2)}`
);

console.log(calculatePaidTotalR(rawOrders)); // 示例输出: "¥860.00"
从以上对比可以看出,Lodash FP 偏向于将已有函数塞入 flow 容器;而 Ramda 提供了极其丰富的原子断言函数(如 R.propEq、R.ifElse),能轻易写出完全脱离临时形参变量的高阶 Pointfree 代码。
场景 2:Lodash FP 默认封顶截断参数造成的潜在陷阱
import fp from 'lodash/fp';
import * as R from 'ramda';

const list = ['apple', 'banana', 'cherry'];

// 开发者期望输出带索引的序号:"0: apple", "1: banana" ...
// 【错误陷阱】:由于 fp.map 默认封顶,index 永远为 undefined!
const badFpMap = fp.map((item, index) => `${index}: ${item}`);
console.log(badFpMap(list));
// 实际示例输出: ["undefined: apple", "undefined: banana", "undefined: cherry"]

// 【正确修复方式 1 (Lodash FP)】:显式解除 cap 限制
const fixedFpMap = fp.map.convert({ cap: false })((item, index) => `${index}: ${item}`);

// 【正确编写方式 2 (Ramda)】:使用显式组合子 R.addIndex
const mapIndexed = R.addIndex(R.map);
const rMapResult = mapIndexed((item, index) => `${index}: ${item}`, list);
console.log(rMapResult);
// 示例输出: ["0: apple", "1: banana", "2: cherry"]
四、工程化考量:打包体积、Tree-Shaking 与 TypeScript 支持
| 评估维度 | Lodash FP (lodash/fp) | Ramda |
|---|---|---|
| 默认打包体积 (Minified + Gzip) | 若全量引入约 24 KB;单函数引入需经过 convert 依赖,约 4~8 KB | 全量引入约 10 KB;原生模块单函数引入约 1~3 KB |
| Tree-Shaking 支持 | 需依赖特定路径导入(如 lodash/fp/map)或 babel-plugin-lodash |
天然支持 ES Module(ramda/es),现代打包工具自动摇树精简 |
| TypeScript 类型推断体验 | 柯里化多层嵌套后泛型推断易退化为 any,需手动补足签名注解 |
官方及 @types/ramda 对 pipe/compose 推断较好,深层柯里化支持更稳健 |
| 规范兼容性 (Fantasy Land) | 不兼容;仅适用于原生 JS 基础类型 | 完全遵循代数规范;可无缝衔接 Sanctuary / Folktale / Fluture |
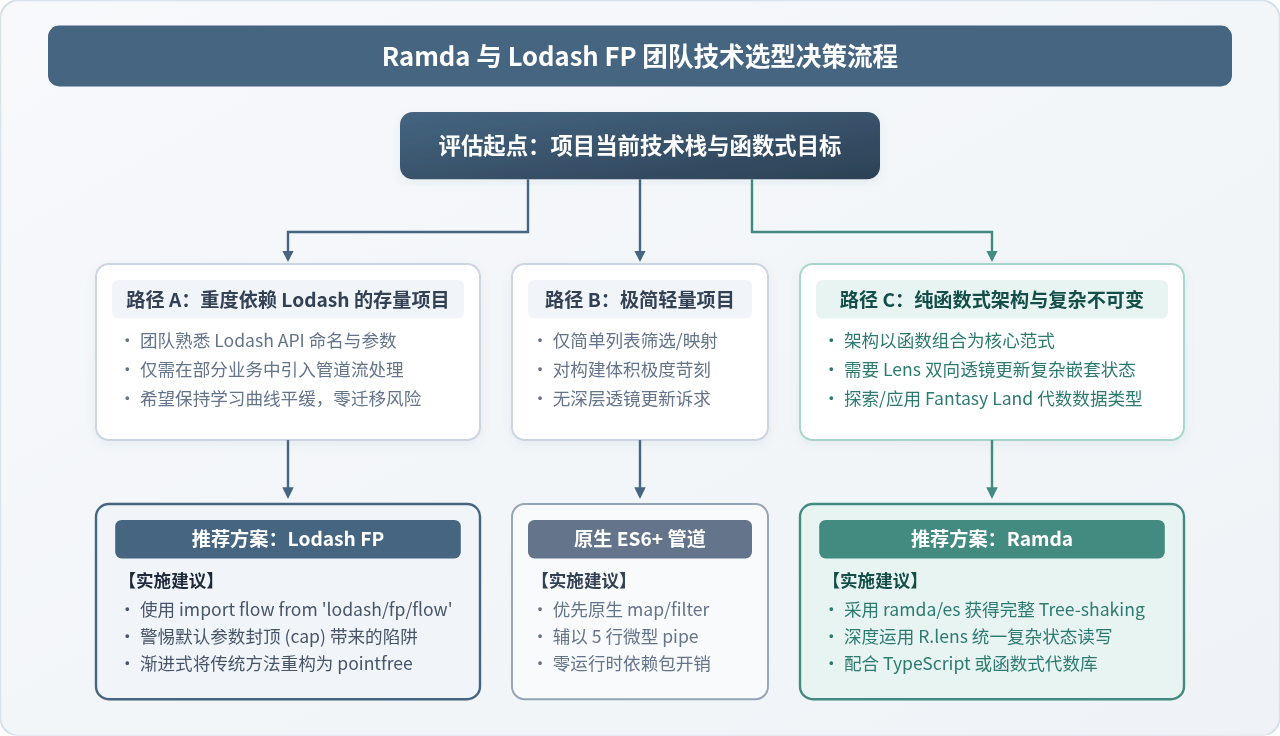
图 4:团队与项目技术选型决策路径图
五、团队选型决策依据与平滑落地建议
面对具体业务与团队背景,选型决策应遵循以下具体依据:
1. 优先选择 Lodash FP 的典型场景
- 存量项目已有重度 Lodash 依赖:若现有系统已广泛安装
lodash,直接引入import flow from 'lodash/fp/flow'是边际成本最低的做法,无需额外引入外部大型包。 - 团队处于函数式编程过渡初期:团队成员习惯了 Lodash 的方法命名(如
fp.groupBy,fp.flatten),希望以最平缓的学习曲线在特定数据转换模块尝试管道式流式写法。 - 只需常规数据结构变换:仅涉及数组简单过滤、对象浅层提取,不需要透镜(Lens)和复杂的代数抽象。
2. 优先选择 Ramda 的典型场景
- 全栈以纯函数式为核心架构设计:例如前端状态机、复杂的金融规则计算引擎或基于 Redux 不可变范式的大型应用,Ramda 的无副作用与一元原则能极大保障计算的确定性。
- 需要处理复杂嵌套数据的更新与读取:业务中存在深层树形结构、嵌套表单或复杂配置,使用 Ramda 的 Lens 体系可以构建出极度优雅、高复用的状态切片操作器。
- 对前端打包体积极其敏感:Ramda 代码结构精简,支持
ramda/es纯 ES 模块,Tree-shaking 消除未引用代码更为彻底。 - 计划构建代数类型安全生态:与
Sanctuary、fp-ts等严格函数式类型系统结合时,Ramda 的规范契合度明显优于 Lodash FP。
六、常见问题与注意事项(FAQ)
Q1: 是否可以在同一个项目中同时使用 Ramda 和普通 Lodash?
技术上完全可行,但不建议混用。Ramda 是 Data-last(数据最后),而普通 Lodash 是 Data-first(数据最前)。混用会导致团队在编写回调参数时频繁发生思维混乱,严重破坏代码一致性。若需渐进过渡,建议统一收敛到统一的工具隔离层。
Q2: 自动柯里化(Currying)在大型项目中会有性能瓶颈吗?
在常规 Web 应用、页面交互或常规数据表单处理中,柯里化创建闭包带来的微秒级开销完全可以忽略,清晰的声明式代码远比微观性能优化重要。但如果处于每秒需要处理数万次高频渲染的图形计算、高频图表或大数据量密集循环(如千万级数组)场景,函数调用栈与闭包分配会产生一定损耗,应选用低层命令式循环或原生 typed array 处理。
Q3: ES6+ 普及后(可选链 ?. 与原生解构),还有必要使用函数式工具库吗?
原生语法解决了基础的“安全属性读取”与“浅层解构”,但无法替代“声明式函数组合(pipe/flow)”、“参数部分应用(柯里化)”以及“深层不可变透镜更新(Lens)”。现代函数式库的核心价值在于将数据变换过程本身组织成无状态、高阶可复用的计算管道,这一抽象层级依然显著高于语言层面的语法糖。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章