
深入对比 JavaScript 中 Map 与普通 Object 在遍历机制、迭代顺序、键类型保真度、原型链安全及性能开销等方面的核心区别,提供实用代码示例与选型重构指导。

当前位置:首页 > JavaScript 对象与原型 > 正文
JS Map遍历与普通Object遍历有什么区别
作者:闭包旅人
时间:2026-11-05
浏览:84
文章目录
JavaScript进阶
数据结构对比
遍历与性能
阅读时长约 8 分钟
在 JavaScript 中,遍历
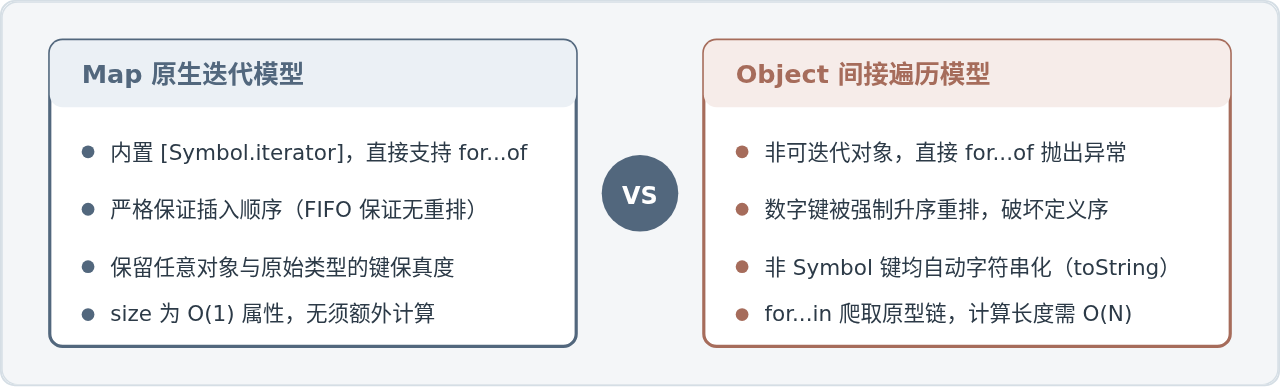
Map 与普通 Object 最核心的区别在于迭代协议的原生支持、键的类型保真度以及顺序保证机制。Map 天生实现了可迭代协议([Symbol.iterator]),可通过 for...of、.forEach() 按元素写入的绝对先后顺序直接取值,且支持任意类型的键;而普通 Object 本身不可直接迭代,需借助 Object.entries() 等方法生成瞬时数组快照或使用 for...in 沿原型链检索,且其键名不仅被强制转换为字符串或 Symbol,在遍历时还会遵循非负整数优先升序重排的特殊规则。
一、核心机制差异:原生迭代协议与反射式遍历
在日常开发中,许多开发者初次尝试用 for (const item of obj) 遍历普通对象时,都会遭遇终端抛出的经典错误:TypeError: obj is not iterable。这正是两者在底层设计上的第一道分水岭。
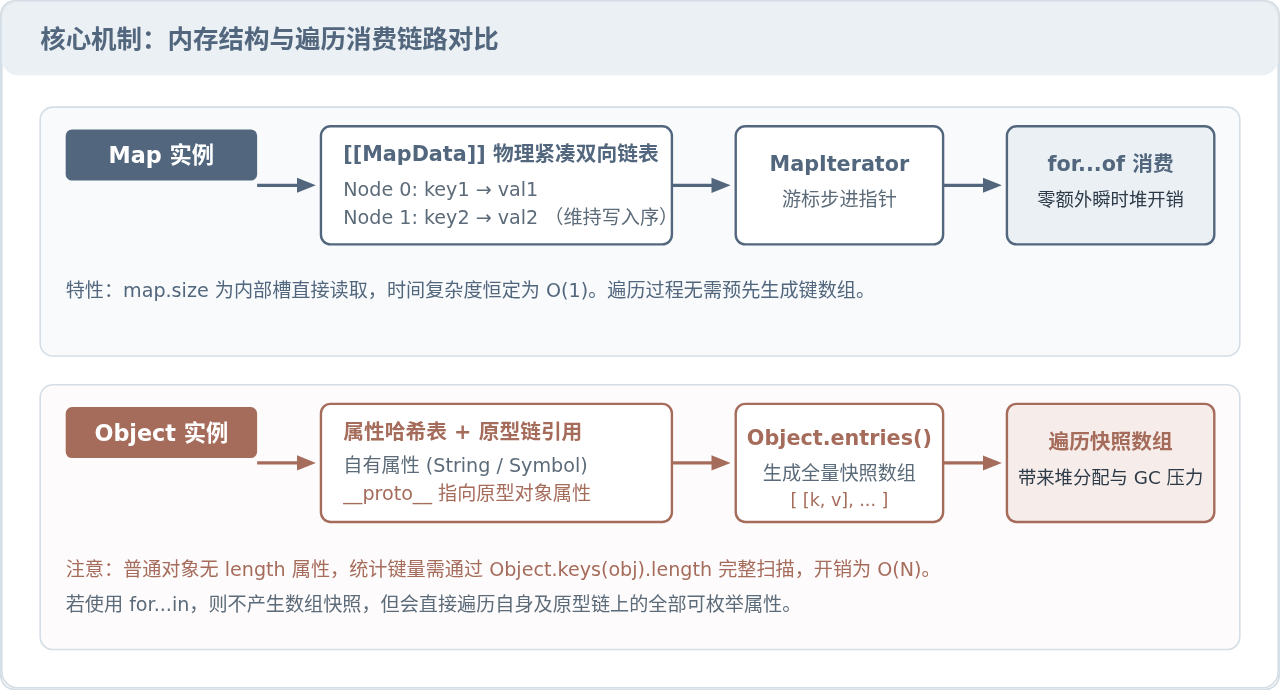
ECMAScript 规范为“集合迭代”定义了一套统一的迭代器协议(Iteration Protocols)。一个对象要支持直接被 for...of、展开运算符(...)或 Array.from() 消费,其原型链上必须部署一个名为 Symbol.iterator 的方法。Map 原生实现了这一协议,它的默认迭代器等同于 map.entries(),内部维护着指向数据节点的有序游标。
而普通 Object 的本质是一个面向通用属性访问的哈希映射表,它没有内置 Symbol.iterator。遍历普通对象必须借由间接手段:要么使用上古时期的 for...in 语句进行属性枚举,要么调用 Object.keys()、Object.values()、Object.entries() 这类反射式 API。这些静态方法在执行时,会在堆内存中即时分配一个全新的数组来装载键值快照。
// 1. Map 的原生直接遍历
const taskMap = new Map([
  ['deploy', 'pending'],
  ['test', 'success']
]);

// 直接使用 for...of 解构,零多余内存分配
for (const [key, value] of taskMap) {
  console.log(`任务: ${key}, 状态: ${value}`);
}

// 2. Object 的间接快照遍历
const taskObj = {
  deploy: 'pending',
  test: 'success'
};

// 错误示范:抛出 TypeError: taskObj is not iterable
// for (const item of taskObj) { ... }

// 正确做法:分配临时二维数组进行消费
for (const [key, value] of Object.entries(taskObj)) {
  console.log(`任务: ${key}, 状态: ${value}`);
}
二、遍历顺序规则:绝对插入序与整数优先排序陷阱
“遍历键的顺序是否确定”是两者的另一个核心差别。在排查业务 bug 时,我们常会遇到因依赖对象键顺序而引发的奇特失序现象。
Map 的规则简单且直观:规范明确要求 Map 必须以严格的元素插入先后顺序(FIFO)遍历键值对。无论你插入的是字符串、数字、对象还是负数,哪怕中途删除了某个键后重新插入,它都会精确追加到迭代序列的末尾。
普通 Object 的遍历顺序则受 ES2015 内部方法 [[OwnPropertyKeys]] 的分层排序规范制约:
- 整数索引优先:所有属于非负整数索引的键(如
"0"、"1"、"100"),不论书写顺序如何,都会被统一提取出来并按照数值从小到大升序排序先进行遍历; - 常规字符串随后:其余常规字符串键,按照最初添加进对象的先后顺序遍历;
- Symbol 键最后:所有 Symbol 类型的键最后按添加顺序遍历。
这意味着,当你试图在普通对象中存储带有数字特征的编号(如状态码、用户等级、时间戳段落)时,只要遍历对象,原本精心安排的业务顺序就会被宿主环境强制打乱。
// 观察数字键在 Object 中的自动升序重排
const httpCodesObj = {
  '500': 'Server Error',
  '200': 'OK',
  '302': 'Found',
  'prefix': 'HTTP'
};

// 遍历输出顺序已被重新排序:200 -> 302 -> 500 -> prefix
console.log(Object.keys(httpCodesObj));
// 示例输出: [ '200', '302', '500', 'prefix' ]

// 对比 Map 的严格插入保序行为
const httpCodesMap = new Map();
httpCodesMap.set('500', 'Server Error');
httpCodesMap.set('200', 'OK');
httpCodesMap.set('302', 'Found');
httpCodesMap.set('prefix', 'HTTP');

// 遍历输出绝对与写入顺序一致:500 -> 200 -> 302 -> prefix
console.log([...httpCodesMap.keys()]);
// 示例输出: [ '500', '200', '302', 'prefix' ]
三、键类型保真度与原型安全防线
在遍历键值对时,你拿到的 key 究竟是什么类型,也会直接决定后续处理逻辑的健壮性。
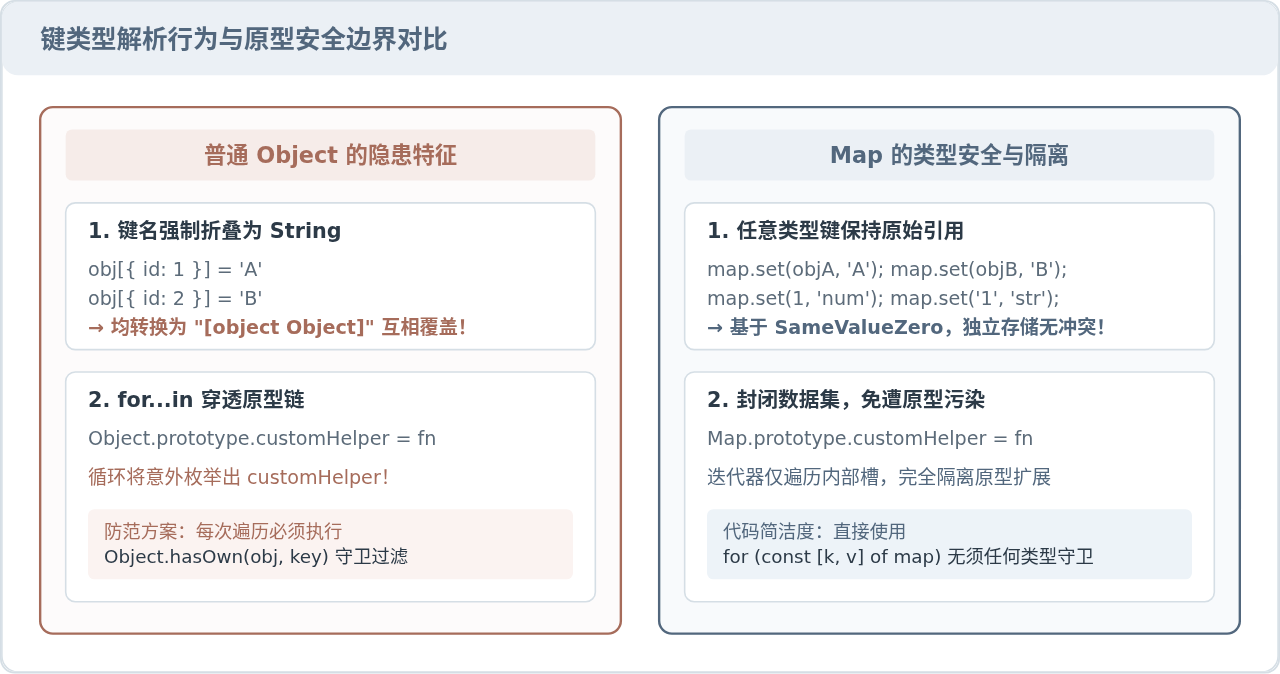
1. 键名强制类型转换与覆盖折叠
普通 Object 的键实质上只支持两种类型:字符串(String)与符号(Symbol)。当开发者将数字、布尔值或普通对象用作对象的键时,引擎会隐式调用其 toString() 方法实施强制类型转换。
如果使用两个不同的 DOM 节点或配置对象充当 Object 的键,它们最终都会被强制解析为相同的字符串键 "[object Object]",导致后写入的值无声无息地覆盖先写入的值。而在 Map 中,键的比较遵循 SameValueZero 算法,引用类型按内存指针地址进行判定,数值 1 与字符串 "1" 也被严格视作两个完全独立的键。在遍历时,Map 解构出来的 key 完整保留其原始数据类型与对象引用。
2. 原型链属性泄漏与循环污染
如果使用 for...in 遍历普通对象,该语句会递归向上攀爬原型链,将原型上所有 enumerable: true 的扩展属性通通遍历出来。而在大型项目或引入第三方 polyfill 时,全局 Object.prototype 被意外扩充属性的情况屡见不鲜。
为了在 Object 遍历中避免原型污染,代码中不得不繁琐地包裹一层 Object.hasOwn(obj, key) 防护。相比之下,Map 内部将数据实体维护在私有的内部槽中,map.entries() 只单纯枚举容器内注册的键值,绝不会混入 Map.prototype 上定义的任何原型方法,天然免疫原型污染。
四、性能与内存开销:O(1) 长度探测与垃圾回收压力
在涉及数据量较大或高频渲染的循环体中,两者的遍历开销会有肉眼可见的差距。
1. 集合大小感知的复杂度差距
在遍历前后,我们经常需要判断集合中到底有多少个元素。Map 内部原生包含一个内部槽计数器,读取 map.size 仅仅是一次内存指针属性访问,其复杂度是恒定的 O(1)。
普通 Object 并不具备长度属性。若要获取对象的属性总数,必须先调用 Object.keys(obj)。该操作必须完整遍历对象内部所有的自有属性,不仅耗费 O(N) 的时间,还必须在堆内存中完整实例化一个长度为 N 的字符串数组。如果在一个紧凑的高频循环体中多次执行 Object.keys(obj).length,将会给引擎带来巨大的无效运算负担。
2. 瞬时分配对垃圾回收(GC)的影响
当我们使用 Object.entries(obj) 进行解构遍历时:
// 每次循环调用都会分配:1 个外层大数组 + N 个微型双元素数组 [key, value]
for (const [key, value] of Object.entries(largeObject)) {
  // 业务运算
}
假设 largeObject 包含 10,000 个键值对,那么单次 Object.entries() 调用就会即时在 V8 堆内存的“新生代空间(New Space)”中分配 1 个装载指针的主数组以及 10,000 个 [key, value] 的临时元组数组。一旦遍历结束,这 10,001 个临时数组立刻变为垃圾内存,引发频繁的新生代 Scavenge 垃圾回收周期,造成主线程微卡顿。
而 Map 迭代器是在内部紧凑链表上直接向前步进移动游标,按需 yield 产生输出,其内存占用近乎为零瞬时增量,在处理高频或大规模数据集合遍历时表现更为稳定平滑。
五、遍历选型与代码重构步骤
在实际项目重构或技术选型时,无需盲目将所有 Object 替换为 Map,而是应当根据数据契约的生命周期与遍历模式做出明晰判定。以下是标准的操作判定步骤:
选型快速判定法则
静态结构、字段固定、需要直接作为 JSON 传输的实体,使用 Object 更轻便直观;具有动态增删、未知键名、需保顺序或非字符串键的字典类集合,果断选择 Map。
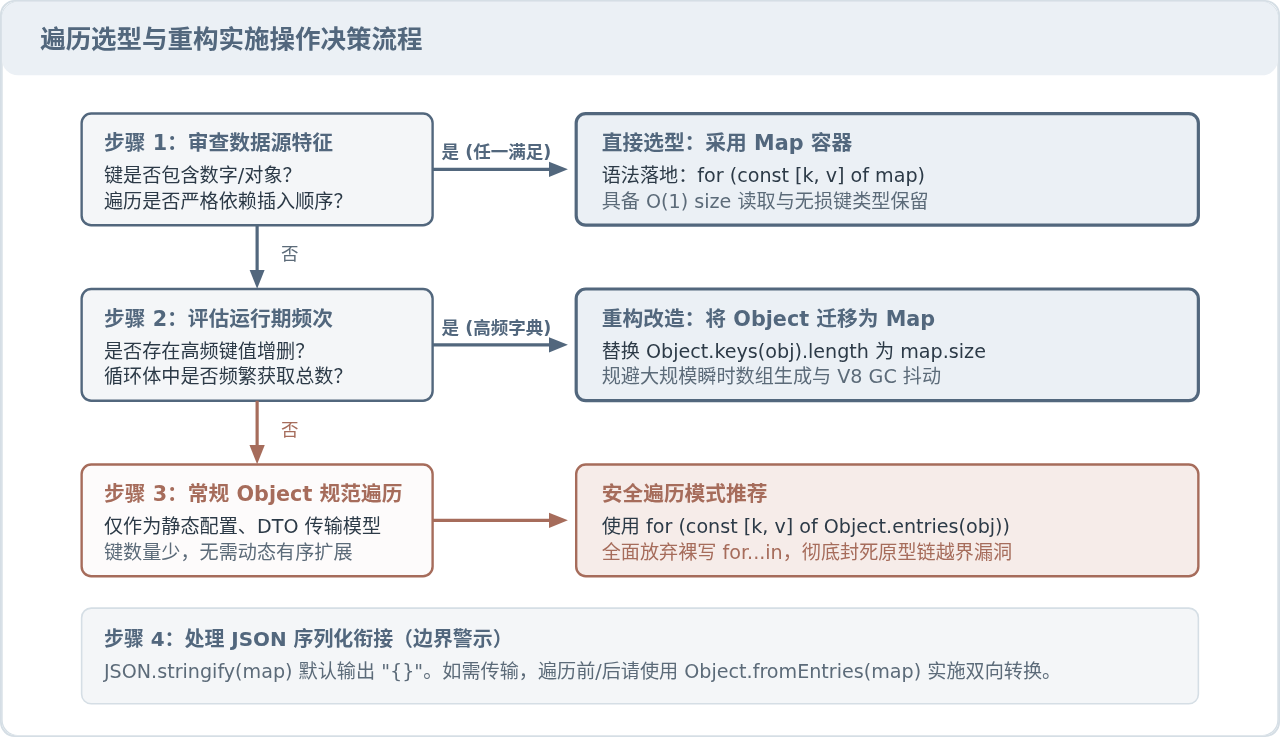
在确定选择后,以下是工程中标准的重构落地代码对比:
// 场景:需要对一组表单项按提交顺序逐一校验

// 【重构前】普通 Object 模式:易失序、产生垃圾快照
const legacyForm = {
  '10': '验证码',
  '1': '手机号',
  'name': '真实姓名'
};

// 遍历顺序变成了:1 -> 10 -> name(原本期望的输入顺序被破坏)
for (const [fieldId, label] of Object.entries(legacyForm)) {
  console.log(`校验字段 [${fieldId}]: ${label}`);
}

// 【重构后】Map 模式:顺序稳固、原生迭代、性能优异
const formQueue = new Map([
  ['10', '验证码'],
  ['1', '手机号'],
  ['name', '真实姓名']
]);

// 严格按 '10' -> '1' -> 'name' 执行,零临时数组分配
for (const [fieldId, label] of formQueue) {
  console.log(`校验字段 [${fieldId}]: ${label}`);
}

// 如需与服务端进行 JSON 交互:
const payload = JSON.stringify(Object.fromEntries(formQueue));
六、全维度对比与总结速查
为了在技术方案评审或面试中建立完整的系统认知,我们将 Map 遍历与普通 Object 遍历的关键区别归纳整理为如下速查表:
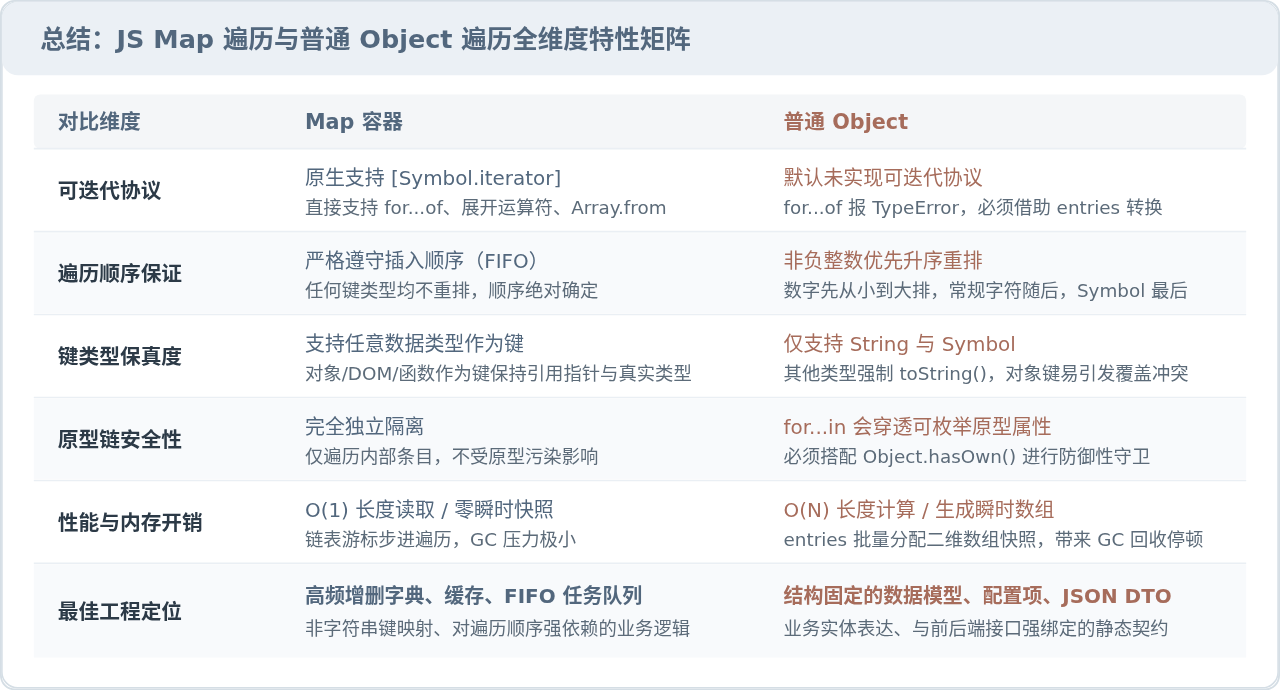
总的来说,Map 是为“键值对集合存储与高效遍历”量身打造的专业数据结构,赋予了开发者对顺序、类型与性能的全面控制权;而普通 Object 的首要定位是“描述结构化实体与面向对象契约”。在涉及需要频繁遍历、依赖绝对插入序或处理非字符串键的场景下,使用 Map 能够从源头上规避隐蔽的重排缺陷与原型泄漏风险;在常规轻量业务传参和结构体定义中,使用 Object.entries() 依然是足够简便通用的选择。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章