
深入解析JavaScript中slice、substring和substr截取字符串的参数语义、负数索引计算规则、底层执行推导及现代工程选型建议。

当前位置:首页 > JavaScript 基础 > 正文
JS中slice、substring和substr截取字符串的区别与选用
作者:闭包旅人
时间:2026-11-06
浏览:537
文章目录
在日常 JavaScript 开发中,如果需要截取字符串,最清晰、最不易出错的选型结论是:现代代码统一使用
slice()。虽然 slice()、substring() 和 substr() 都能返回子字符串,但它们在参数含义(“位置区间”与“截取长度”)、负数与颠倒参数的内部处理规则,以及在 ECMAScript 规范生命周期中的地位存在本质区别。其中 substr() 已被官方附录 B 标记为废弃,substring() 存在负数归零与静默调换参数的副作用,而 slice() 具备一致的负索引倒数支持与无副作用特性。本文将从参数模型、引擎执行逻辑、典型实战场景以及重构选型四个维度展开详细讲解。
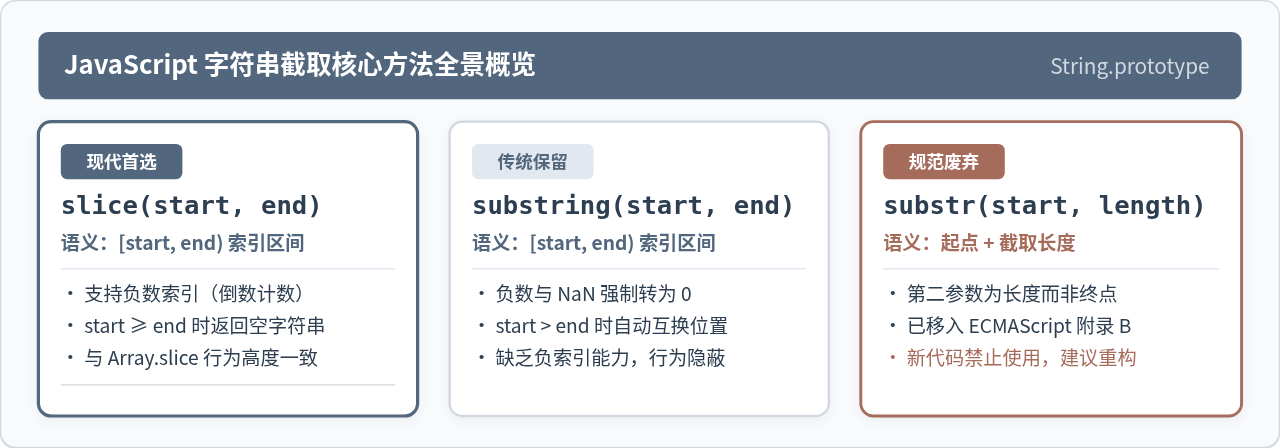
一、参数模型的本质区别:区间截取 vs 长度截取
理解这三个方法的第一步,是看清它们的第二个参数到底代表什么。很多初学者混淆它们,主要是因为在最普通的正向截取场景中,它们经常碰巧输出相同的结果,从而掩盖了参数定义的差异。
slice(start, end) 与 substring(start, end) 均采用区间模型。它们的两个参数代表的是字符串的字符边界索引,截取范围遵循计算机科学中经典的左闭右开约定,即包含索引为 start 的字符,但不包含索引为 end 的字符,截取出来的字符串长度恒为 end - start(在参数合法正序的前提下)。
与前两者不同,substr(start, length) 采用的是起点加计数模型。它的第一个参数是截取的起始索引,而第二个参数则是从该位置向后需要截取的字符总数(长度),而非结束索引。
const str = "JavaScript";

// 区间截取:从索引 4 截取到索引 10(不含 10)
console.log(str.slice(4, 10));     // "Script" (长度为 10 - 4 = 6)
console.log(str.substring(4, 10)); // "Script" (长度为 10 - 4 = 6)

// 长度截取:从索引 4 开始向后取 6 个字符
console.log(str.substr(4, 6));     // "Script" (参数 6 表示提取 6 个字符)

// 注意:如果第二参数相同,但语义不同就会出现偏差
console.log(str.slice(0, 4));      // "Java"   (区间 [0, 4))
console.log(str.substr(0, 4));     // "Java"   (从 0 开始取 4 个字符,恰好也是 "Java")
console.log(str.substr(2, 4));     // "vaSc"   (从索引 2 开始取 4 个字符)
console.log(str.slice(2, 4));      // "va"     (区间 [2, 4),只有 2 个字符)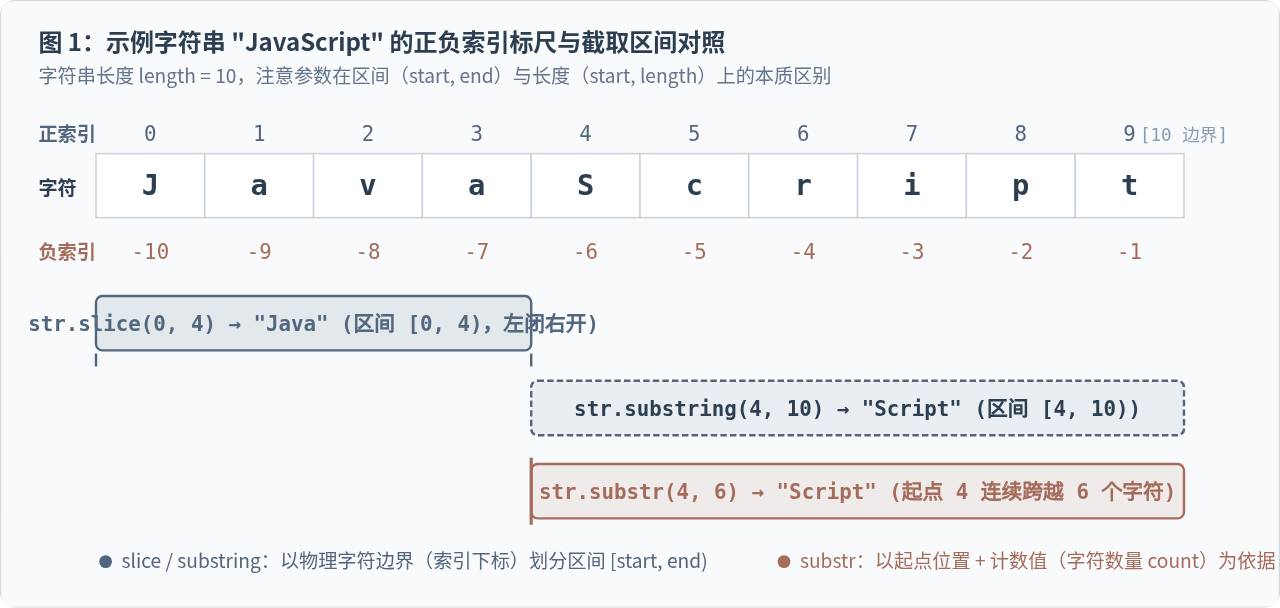
当省略第二个参数时,三者的行为是一致的:都是从指定的 start 索引一直截取到字符串的末尾(相当于默认截取到 str.length)。这一简写在提取后缀或切割前缀时非常常用。
二、负数与参数颠倒:底层归一化推导
如果说在正整数参数下三者还算直观,那么当传入负数、非数值或出现 start > end 的逆序情况时,三者的处理机制则截然不同。JavaScript 引擎在正式提取字符前,会对入参进行标准化(Normalization)换算。
1. 负数索引的处理逻辑
slice(start, end):将负数解释为“从字符串末尾倒数计数”。在规范中,引擎会自动将其换算为str.length + index。例如对于长度为 10 的字符串,索引-3等价于10 + (-3) = 7。如果负数绝对值大于字符串长度,则被限制归零。这使得slice()具备了极佳的尾部截取能力。substring(start, end):不支持负数倒数。在substring的规范中,任何小于 0 的数值或NaN都会被强制当成0处理。这一容错设计虽然避免了抛出异常,但经常会导致意料之外的截取行为。substr(start, length):现代标准中其起始位置start支持负数倒数(换算为str.length + start),但其第二参数length如果为负数或NaN,则会被当作 0 处理,直接返回空字符串""。
2. 起止位置大小颠倒时的行为(start > end)
slice()严格不调换:若计算后的起始索引大于或等于结束索引,slice()认为这是一个无效的区间,直接返回空字符串""。它绝不会私自调换参数顺序。substring()自动互换:当start > end时,substring()会在内部默默执行[start, end] = [end, start],把较小的数作为起始索引,较大的数作为结束索引。例如str.substring(7, 2)会被自动转换成str.substring(2, 7)执行。
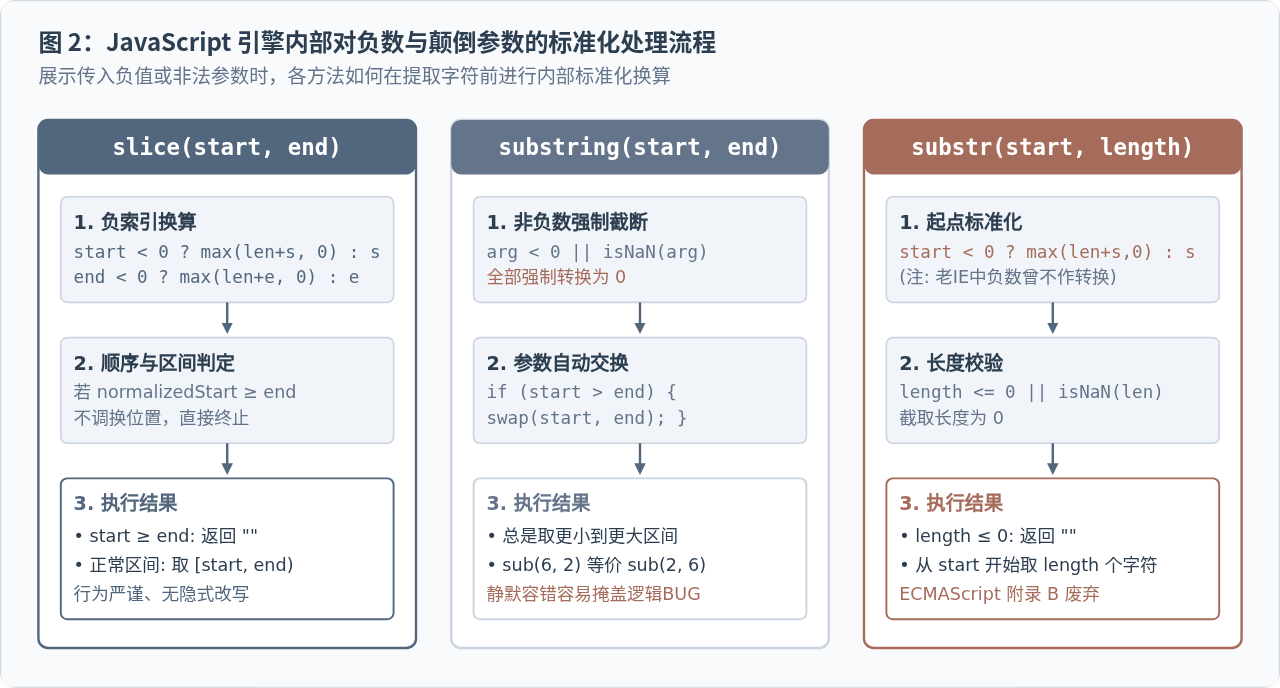
下面的代码清晰展示了不同边界参数下的实际差异:
const text = "ECMAScript"; // length = 10

// 场景 A: 使用负数作为参数
console.log(text.slice(-6));        // "Script"    (-6 转换为 10 - 6 = 4,从 4 截到末尾)
console.log(text.substring(-6));    // "ECMAScript" (-6 强制转为 0,相当于 substring(0))
console.log(text.slice(0, -6));     // "ECMA"      (-6 转换为 4,相当于 slice(0, 4))
console.log(text.substring(0, -6)); // ""          (-6 转为 0,substring(0, 0) 为空)

// 场景 B: start 大于 end
console.log(text.slice(6, 2));        // ""          (6 > 2,不符合区间规则,返回空串)
console.log(text.substring(6, 2));    // "MASc"      (自动调换为 substring(2, 6))

// 场景 C: 负数且大小倒置
console.log(text.substring(4, -3));   // "ECMA"      (-3 转为 0,变成 (4, 0),再调换为 (0, 4))
console.log(text.slice(4, -3));       // "Sc"        (-3 换算为 7,即 slice(4, 7))
注意:
substring(4, -3) 返回 "ECMA" 这一现象充分展示了其副作用:它先将 -3 变成 0,随后发现 4 > 0,又静默互换为 substring(0, 4)。这种多次隐式改写往往会掩盖前端业务计算中的逻辑错误,导致问题排查变得十分困难。
三、为什么应彻底停止使用 substr
在阅读维护老项目代码时,我们依然能够看到 substr() 的身影。然而,在任何新项目以及代码重构中,都不应该再书写 substr()。
最核心的原因在于规范演进:String.prototype.substr 在 ECMAScript 规范中已被正式弃用(Deprecated),并被移至规范的 Annex B(Web 浏览器的额外内置特性)。附录 B 收录的是为了向后兼容旧版浏览器而保留的陈旧特性(如 escape、unescape 以及 HTML 包装方法等)。ECMAScript 规范官方明确建议开发者不要在新编写的代码中使用附录 B 中列出的任何特性。
此外,substr() 存在历史遗留的不一致性问题。在极早期的 Internet Explorer 浏览器中(IE 8 及更早版本),substr() 并不支持负数 start 索引,传入负数会被直接视作 0。尽管现代浏览器在附录 B 的约束下统一了负数行为,但各种静态检查工具(如 ESLint 的 unicorn/prefer-string-slice 等规则)均已将其列为必须消除的废弃 API。
老代码快速重构方案:将
str.substr(start, length) 改写为 str.slice(start, start + length)。若省略了 length,则直接替换为 str.slice(start)。
四、典型实战场景的操作与切片步骤
掌握了理论后,我们来看看日常业务中最典型的三个字符串提取场景,以及为什么使用 slice() 能够写出最简洁、最具表现力的代码。
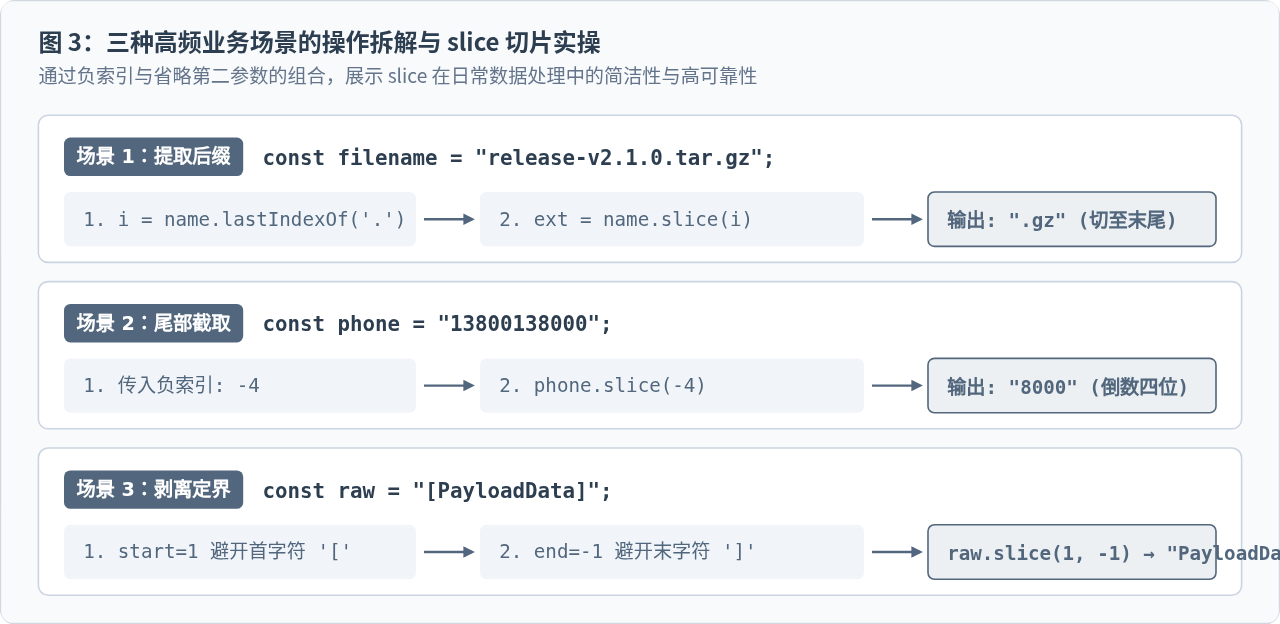
场景 1:提取文件名后缀(扩展名)
在处理文件上传或资源路径时,提取最后一个点号之后的扩展名是高频需求。结合 lastIndexOf() 与 slice() 仅需两行代码:
function getFileExtension(filename) {
  const dotIndex = filename.lastIndexOf('.');
  // 未找到点号或点号在首位(隐藏文件)时返回空
  if (dotIndex <= 0) return '';
  // 从点号位置直接截取至末尾
  return filename.slice(dotIndex);
}

console.log(getFileExtension("bundle.min.js")); // ".js"
console.log(getFileExtension("avatar.png"));    // ".png"
场景 2:截取尾部倒数固定位数(敏感数据脱敏)
在展示手机号、银行卡号或身份证时,通常需要保留后四位数字。由于 slice() 原生支持负数索引,完全不需要先去计算 str.length - 4:
const phone = "13800138000";

// 优雅实现:slice 传入 -4 直接取末尾 4 位
const lastFour = phone.slice(-4); // "8000"
const maskedPhone = phone.slice(0, 3) + "****" + lastFour;
console.log(maskedPhone); // "138****8000"

// 对比:如果使用 substring,必须手动计算长度
const fallback = phone.substring(phone.length - 4);
场景 3:剥离首尾定界符或包装标记
在解析模板字符串、JSON 片段或自定义标记时,经常需要剥除两端的符号(例如去除字符串前后的中括号 [ ] 或引号)。slice(1, -1) 提供了极具可读性的正负双向收拢方式:
const rawToken = "[UserDataPayload]";

// 起始索引 1 避开首字符 '[',结束索引 -1 避开末字符 ']'
const cleanToken = rawToken.slice(1, -1);
console.log(cleanToken); // "UserDataPayload"

// 对比:substring 无法传入 -1(会被转为 0 导致返回空),必须写成:
const subResult = rawToken.substring(1, rawToken.length - 1);
五、综合选型建议与速查对照
为了在实际团队开发中达成统一共识,我们可以通过下述决策模型来进行方法选用与代码维护:
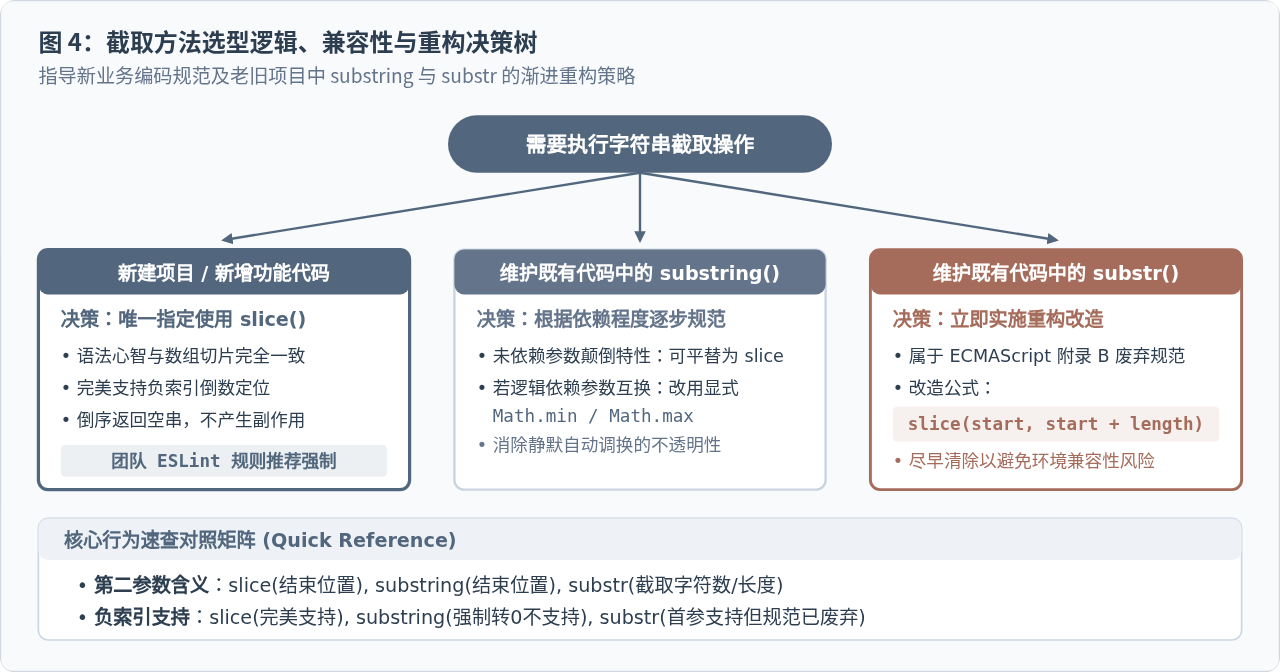
| 特性维度 | slice(start, end) |
substring(start, end) |
substr(start, length) |
|---|---|---|---|
| 第二参数含义 | 结束位置索引(不包含) | 结束位置索引(不包含) | 截取的字符总数(长度) |
| 支持负数索引 | 完美支持(倒数计数) | 不支持(强制当作 0) | 首参数支持,长度不支持 |
| 参数逆序处理 (start > end) | 不调换,安全返回 "" |
自动静默互换两参数 | 不适用(第二参数是长度) |
| 与 Array.slice API 统一性 | 完全统一,减少心智负担 | 数组无对应方法 | 数组无对应方法 |
| ECMAScript 规范状态 | 标准推荐核心方法 | 标准保留方法 | Annex B 废弃特性 |
| 推荐使用级别 | 强烈推荐(默认首选) | 仅维护既有老代码时使用 | 禁止新用,建议重构 |
综上所述,在现代前端及 Node.js 工程中,应当无脑默认选用 String.prototype.slice()。它不仅提供了完整的正负索引支持与严谨的区间语义,而且与 Array.prototype.slice() 保持了统一的操作心智,极大降低了开发者的记忆成本与维护风险。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章