
深入解答Node.js是否适合高并发,全面剖析其异步非阻塞I/O核心机制、libuv底层架构、请求处理生命周期、认知误区辨析及生产环境选型实践。

当前位置:首页 > Node.js 性能优化 > 正文
Node.js适合处理高并发吗?异步非阻塞机制详解
作者:慢半拍
时间:2026-11-11
浏览:506
文章目录
架构与性能
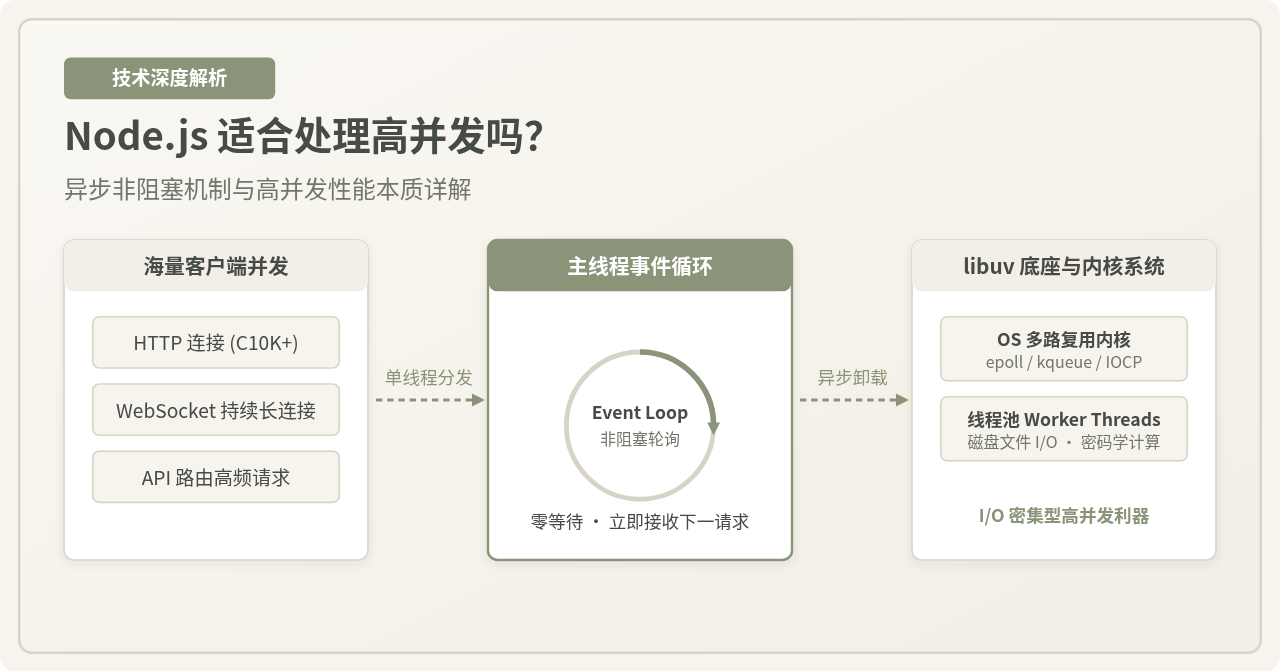
缩略导览:Node.js 异步非阻塞核心架构与高并发能力边界
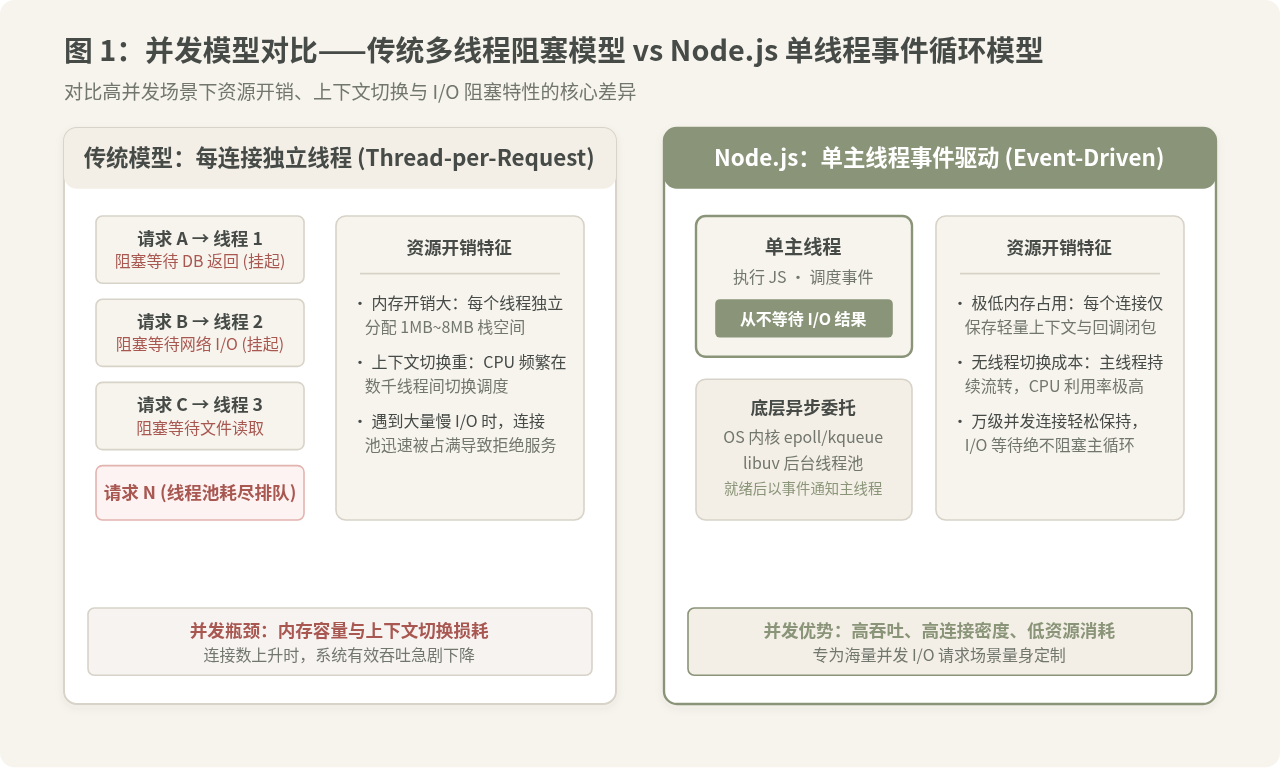
图 1:传统多线程阻塞模型与 Node.js 单线程事件循环模型在高并发下的资源机制对比
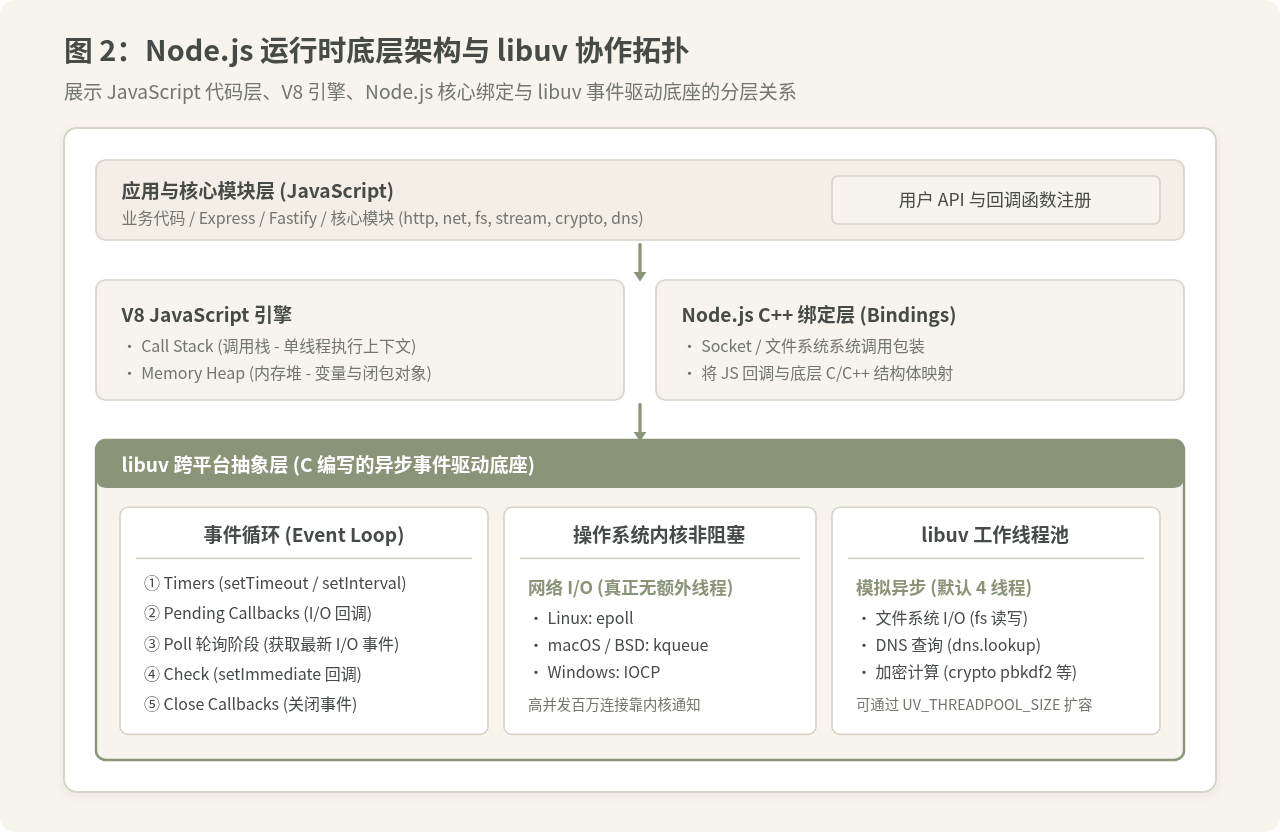
图 2:Node.js 分层架构——JavaScript 模块、V8 调用栈、C++ 绑定与 libuv 事件驱动底座
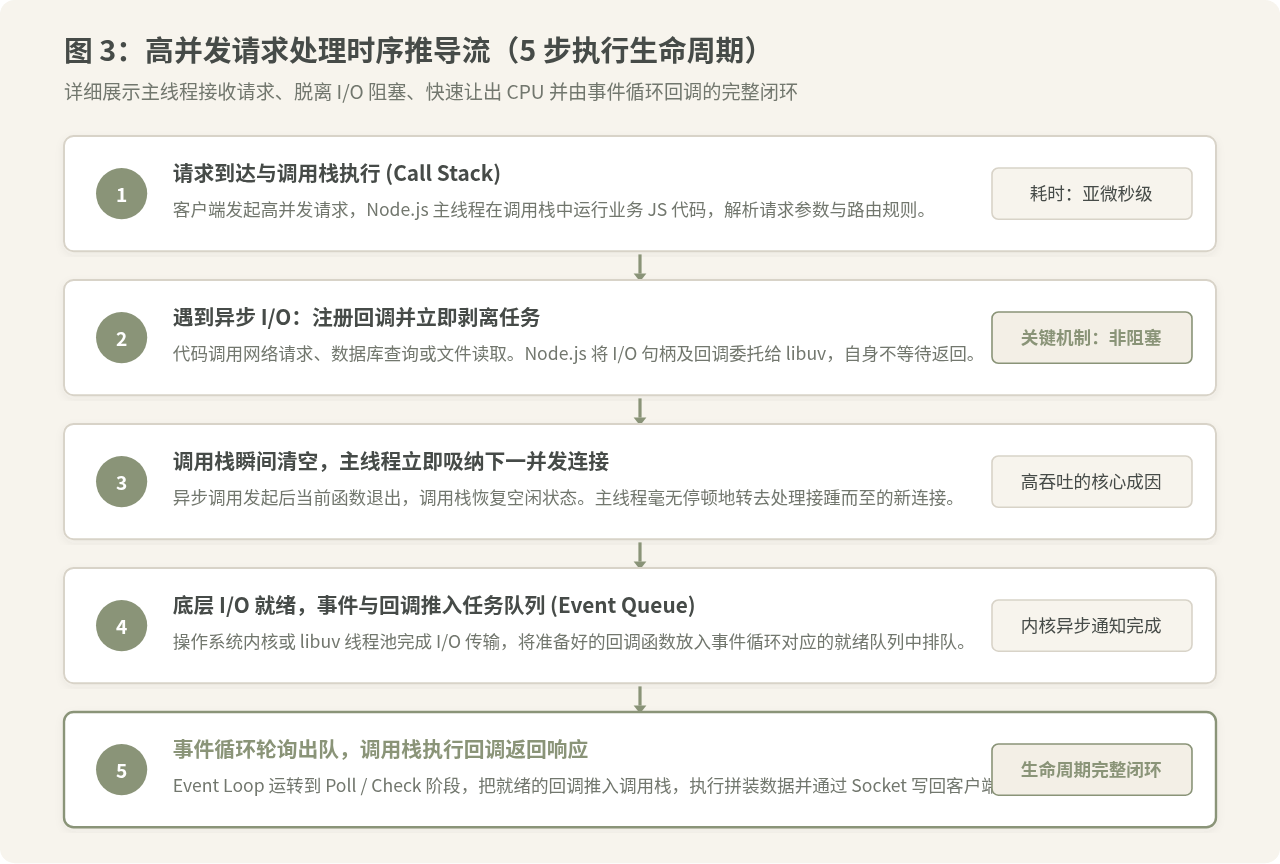
图 3:Node.js 高并发请求 5 步执行生命周期推导流
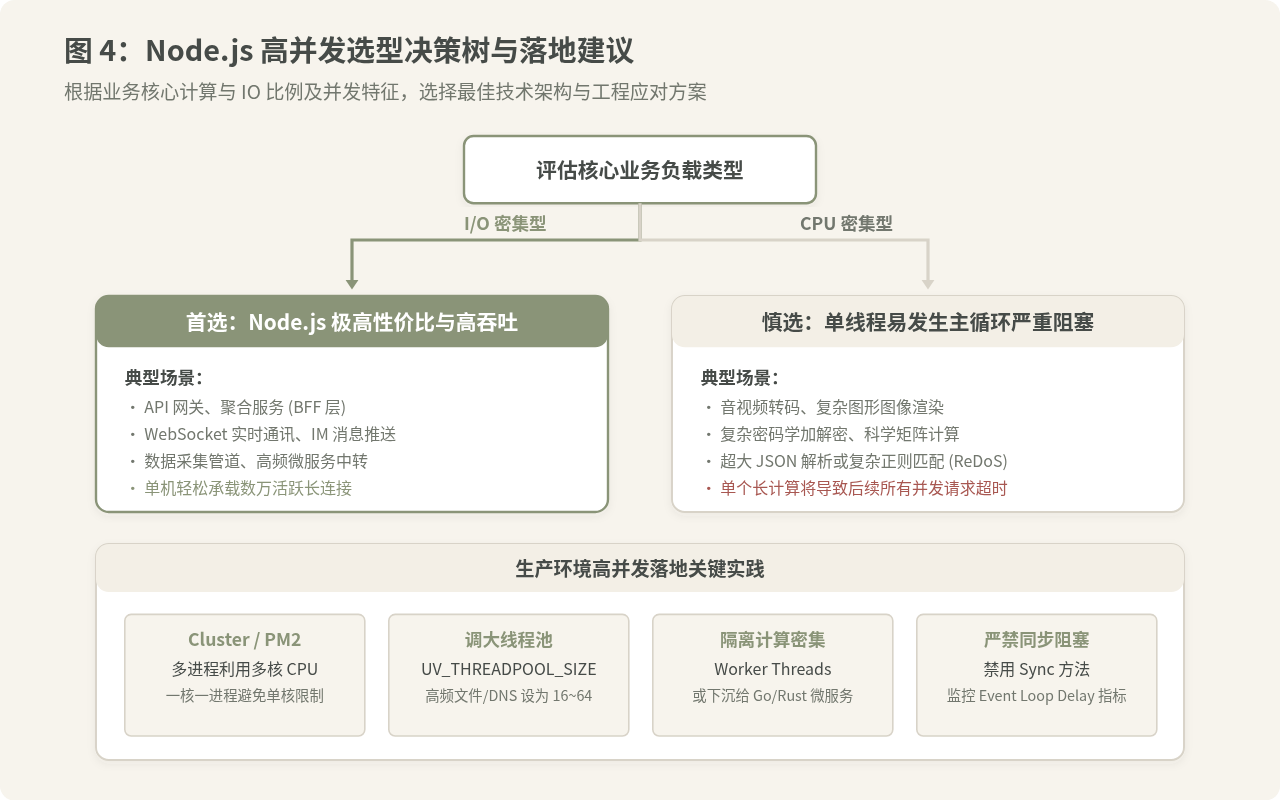
图 4:Node.js 高并发业务场景选型判定树与生产环境工程实践矩阵
核心结论:Node.js 非常适合高并发,但严格限定于“I/O 密集型”场景;在“CPU 密集型”场景下则需要架构解耦。
核心答案:Node.js 非常适合处理高并发,但它擅长的是“I/O 密集型”高并发(如 API 聚合、高频查询、长连接网关、实时推送),而在“CPU 密集型”高并发(如音视频转码、复杂离线加解密、大图渲染、深度数据分析)中表现乏力。理解这一结论的关键,在于掌握其底层的“单线程事件循环(Event Loop)”与基于 libuv 的“异步非阻塞 I/O”协同工作机制。
一、高并发下的并发模型对比:线程与事件驱动
在 Web 服务领域,“并发”(Concurrency)衡量的是系统在同一时间段内同时接纳并处理多个请求的能力。评判一个运行时是否适合高并发,核心看它在面对成千上万个并发连接时,所付出的内存资源开销和 CPU 调度代价。
传统的 Web 服务器(如 Apache HTTP Server 或早期的 Tomcat)通常采用每连接一线程(Thread-per-Request)模型。当客户端发起 HTTP 请求时,服务器从线程池中分配一个专属工作线程负责该连接的全生命周期。如果该请求需要查询数据库 50 毫秒,该线程就会陷入阻塞状态等待 50 毫秒。在高并发阶段,这种机制存在两个严重的物理瓶颈:
- 内存栈开销沉重:操作系统中每个线程通常需要预分配 1MB 到 8MB 的栈内存。维持 10,000 个空闲或慢连接,仅线程栈内存就会消耗 10GB~80GB,极易发生 OOM(Out Of Memory)。
- CPU 上下文切换消耗:当系统存在数千个活跃线程时,操作系统内核调度器需要频繁保存和恢复寄存器状态与 CPU 缓存,大量 CPU 算力被浪费在上下文切换(Context Switch)上,有效计算吞吐急剧恶化。
Node.js 则反其道而行之:它在主执行环境中只保留单个主线程运行 JavaScript 代码,借助事件循环(Event Loop)配合操作系统内核的多路复用技术(epoll、kqueue),以事件驱动的方式统一调度所有请求。主线程接收到请求后,一旦遇到需要等待的网络或磁盘 I/O,便将任务下派并立即释放,毫不停歇地继续接收下一个请求。维持一个连接仅需要轻量的套接字文件描述符和极小的 JavaScript 上下文对象。
二、深入底层:异步、非阻塞与 libuv 的协作机制
在讨论 Node.js 时,“异步”(Asynchronous)和“非阻塞”(Non-blocking)常被当作同义词混用,但在底层操作系统层面,它们是不同维度的概念:
- 阻塞与非阻塞(状态表现):关注的是进程在发起系统调用后是否会挂起等待。在非阻塞模式下,若内核数据尚未就绪,系统调用会立即返回错误码(如
EWOULDBLOCK或EAGAIN),进程不被挂起,可继续执行其他指令。 - 同步与异步(通知机制):关注的是由谁来负责获取最终结果。同步需要调用方主动检查或轮询结果;异步则是调用方注册一个回调,由被调用方或操作系统在数据就绪后通过信号或事件主动通知调用方。
Node.js 的底层引擎底座:libuv
很多人误以为 Node.js 的高并发完全来自 Google 的 V8 引擎,但实际上 V8 仅负责解析和执行 JavaScript 语法本身,处理高并发的真正功臣是底层的 C 语言跨平台抽象库——libuv。
Node.js 运行时将 I/O 操作划分为两大类,并采取了截然不同的实现策略:
- 网络 I/O(真正无额外线程):现代操作系统提供了成熟的 I/O 多路复用机制(Linux 下的
epoll、macOS 下的kqueue、Windows 下的IOCP)。单个线程即可同时监听数万个网络 Socket 的读写就绪事件。Node.js 的网络并发完全建立在这些系统级多路复用之上,不需要任何后台线程介入等待。 - 文件系统 I/O 与部分计算(线程池模拟):由于大部分主流操作系统内核并没有提供高效、跨平台且行为一致的非阻塞文件操作接口(如 Linux 的 AIO 存在较多限制),且 DNS 域名解析(
getaddrinfo)本身是阻塞式的,libuv 维护了一个固定大小的工作线程池(Worker Thread Pool),默认包含 4 个工作线程。文件读写与密码学运算被派遣到这些子线程中阻塞执行,完成后再将结果以事件形式发回主线程。
三、请求生命周期:异步非阻塞机制的 5 步推导
为了具体展示高并发请求在 Node.js 中是如何被处理的,我们以一个典型的 Web 场景为例:客户端请求到达服务器,服务器向数据库查询数据并将结果返回给客户端。整个生命周期可拆解为 5 个明确步骤:
- 步骤 1:请求接入与进入调用栈(Call Stack): 客户端建立 TCP 连接并发送 HTTP 请求,操作系统内核将网络数据通知主线程。主线程调用栈执行入口 JavaScript 代码,例如解析路由与鉴权中间件。此阶段耗时极短(通常在微秒级别)。
-
步骤 2:发起异步 I/O 并剥离任务:
代码执行到异步数据库查询调用(如
db.query(sql, callback))。Node.js 将该 I/O 操作以及对应的回调函数指针打包注册到 libuv 的监听事件中。 - 步骤 3:调用栈清空,主线程立即吸纳下一请求: 发起异步 I/O 的方法瞬间执行完毕并返回。此时主线程的 Call Stack 恢复为空,主线程绝对不等待数据库网络响应,而是立即转向处理事件队列中其他已到达的 HTTP 连接。这正是 Node.js 能在高并发下保持极高请求接入率的核心秘密。
- 步骤 4:底层 I/O 就绪,推入事件就绪队列: 数十毫秒后,数据库返回了查询数据。操作系统内核触发网络事件,libuv 捕获该数据,并将此前注册的回调函数连同返回数据一起封装为待处理任务,推入事件循环的 Poll / Pending 队列 中等待调度。
-
步骤 5:事件循环将回调推入栈中执行响应:
主线程完成当前同步代码后,Event Loop 运转到对应阶段,发现队列中存在就绪的回调,将其推入 Call Stack 执行。回调函数组装 JSON 数据并调用
res.end(data),经由非阻塞 Socket 发送回客户端。
四、代码实测对比:非阻塞 vs 阻塞主线程的连锁反应
为了让原理具象化,我们编写两个简短的 Node.js HTTP 接口。通过对比可以直观看到为什么一旦破坏“非阻塞”约定,Node.js 的并发优势就会瞬间崩溃。
1. 正确姿势:异步非阻塞处理并发 I/O
// server_async.js
const http = require('http');
const fs = require('fs/promises');

const server = http.createServer(async (req, res) => {
  if (req.url === '/data') {
    try {
      // 异步读取:主线程发出指令后立即让出 CPU
      const content = await fs.readFile('./data.json', 'utf8');
      res.writeHead(200, { 'Content-Type': 'application/json' });
      res.end(content);
    } catch (err) {
      res.writeHead(500);
      res.end('Server Error');
    }
  } else {
    res.writeHead(200);
    res.end('PONG');
  }
});

server.listen(3000, () => {
  console.log('Async Server running on http://127.0.0.1:3000');
});
在上述代码中,当数百个并发请求同时访问 /data 时,fs.readFile 将读取任务委托给 libuv 线程池,主线程毫秒不顿地继续响应其他 /ping 请求,接口响应延迟稳定在极低水平。
2. 致命陷阱:在主线程中执行阻塞式长任务
// server_blocked.js
const http = require('http');

function blockCpuForSeconds(seconds) {
  const end = Date.now() + seconds * 1000;
  while (Date.now() < end) {
    // 纯同步循环,死死霸占主线程 CPU
  }
}

const server = http.createServer((req, res) => {
  if (req.url === '/compute') {
    // 模拟耗时 5 秒的密集计算(如暴力哈希、大数组排序、大 JSON 同步解析)
    blockCpuForSeconds(5);
    res.writeHead(200);
    res.end('Compute Done');
  } else {
    res.writeHead(200);
    res.end('Fast PONG');
  }
});

server.listen(3001);
现象与警示:
如果有一个用户向 http://127.0.0.1:3001/compute 发起请求,在接下来长达 5 秒钟内,任何其他用户哪怕只是请求轻量的 /fast 静态内容,都会完全挂起无响应。因为此时唯一的 JavaScript 主线程正困在 while 死循环中,根本无法回到事件循环去处理新的网络连接。
五、容易混淆的认知误区深入辨析
在技术社区关于 Node.js 并发能力的讨论中,常常存在几个似是而非的论断。我们来逐一分析其合理与偏差之处:
误区一:“Node.js 只有单线程,所以完全无法利用现代多核 CPU 的算力”
合理之处:默认情况下,启动一个 Node.js 脚本确实只会占用一个 CPU 核心执行 JavaScript 字节码。如果不做任何额外配置,8 核或 64 核的高性能服务器有绝大部分算力会处于闲置状态。
修正说明:这一限制在工程架构上早已被轻松化解。Node.js 官方内置了 node:cluster 模块,允许主进程通过 fork() 依据 CPU 核心数衍生出多个工作进程,每个子进程运行独立的事件循环与 V8 实例,并由操作系统内核在多个子进程之间自动实现套接字负载均衡(Round-Robin)。配合工业级进程管理工具(如 PM2),只需一条命令 pm2 start app.js -i max 即可瞬间榨干服务器的所有 CPU 核心。
误区二:“Node.js 绝不会阻塞,所以并发吞吐必然比 Java / Go 更高”
合理之处:在单纯的“高并发、慢网络 I/O”(例如等待微服务网络调用返回、等待慢数据库查询)场景中,Node.js 因其极其轻量的事件闭包和零线程上下文切换,吞吐量往往显著优于传统的 Java 同步阻塞模型,单机可维持数万活跃长连接。
修正说明:这一优势在现代编程语言演进中是有严格前提条件的:
- Go 语言原生内置了基于 CSP 模型的 GMP 协程调度器,单个 Goroutine 初始仅需 2KB 内存,且天然在多核上并发执行,在综合吞吐和语言级并发掌控上非常强大。
- 现代 Java(JDK 21+)引入了 Project Loom 虚拟线程(Virtual Threads),使开发者可以用传统的同步编码风格获得类似异步非阻塞的吞吐效果。
- 一旦业务中夹杂哪怕微量的计算操作(如每秒解析数千个超大 JSON 报文),Node.js 的单线程事件循环延迟(Event Loop Lag)就会陡增,吞吐量会急剧下滑。
误区三:“Node.js 底层完全没有线程,全是异步事件”
合理之处:对外暴露的 JavaScript API 绝大部分是基于异步回调或 Promise/async-await 的事件驱动形式。
修正说明:正如前面架构图所示,Node.js 底层的 libuv 拥有明确的C 语言线程池。对于文件操作(fs)、加密(crypto.pbkdf2)、压缩(zlib)以及 DNS 解析,底层依然依赖真实的工作线程。如果短时间内发起了成百上千个高频文件读写操作,由于默认线程池只有 4 个线程,后续任务依然会在 libuv 内部排队等待。
六、高并发场景选型决策树与工程落地清单
基于以上机制解析,我们总结出 Node.js 在高并发架构下的选型决策树与关键实践方案:
| 业务类型 | 典型场景 | Node.js 适用度 | 核心原因与应对策略 |
|---|---|---|---|
| 高并发 I/O 密集型 | API 网关、BFF 层、WebSocket 聊天室、实时数据推送、IoT 遥测收集 | 极佳(强烈推荐) | 主线程只负责路由中转与事件分发,内存利用率极高,单机轻松抗住数万高频连接。 |
| 计算与 I/O 混合型 | 电商下单业务(涉及轻量库存扣减与复杂优惠券规则计算) | 良好(需架构防护) | 合理控制单次运算复杂度;利用 worker_threads 隔离运算逻辑,防止主循环抖动。 |
| 深度 CPU 密集型 | 音视频实时转码、图片滤镜合成、复杂机器学习推断、离线海量报表生成 | 不适合(不建议作为核心) | 单线程严重阻塞后续所有排队请求。建议采用 Go、Rust、C++ 或 Python 封装为微服务,Node.js 仅作为调度入口。 |
生产环境构建高并发 Node.js 服务的 4 条铁律
- 开启 Cluster 多进程集群: 在多核 CPU 服务器上,务必使用 Cluster 模式或 PM2 启动与 CPU 核心数相等的进程副本,消除单主线程对多核算力的浪费。
-
合理调整 libuv 线程池大小:
如果业务中存在大量并发磁盘文件读写或高频 DNS 域名查询,必须在应用启动前调大线程池环境变量(最大支持 1024,通常建议设为 16 至 64):
# 启动命令前设置环境变量 UV_THREADPOOL_SIZE=64 node server.js -
坚决杜绝同步阻塞 API:
在生产代码中,严禁在请求处理链路上调用
fs.readFileSync()、crypto.pbkdf2Sync()等同步方法;警惕未限制长度的正则表达式导致的 ReDoS(正则回溯灾难)。 - 实施 Event Loop 延迟监控: 将事件循环延迟(Event Loop Lag)作为核心健康检查指标。当 Lag 超过 100ms 时,意味着主线程已发生积压,应触发报警或熔断限流,保护服务不被击穿。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章