
针对JavaScript函数中因data参数处理不当导致死循环的问题,深入分析递归环状引用、队列未缩减、响应式原位修改及异步游标停滞等核心诱因,并提供实用的防御方案与代码规范。

当前位置:首页 > JavaScript 函数与作用域 > 正文
js函数里面的data参数写出死循环怎么避免
作者:函数茶馆
时间:2026-11-08
浏览:539
文章目录
JavaScript 故障排查与程序健壮性
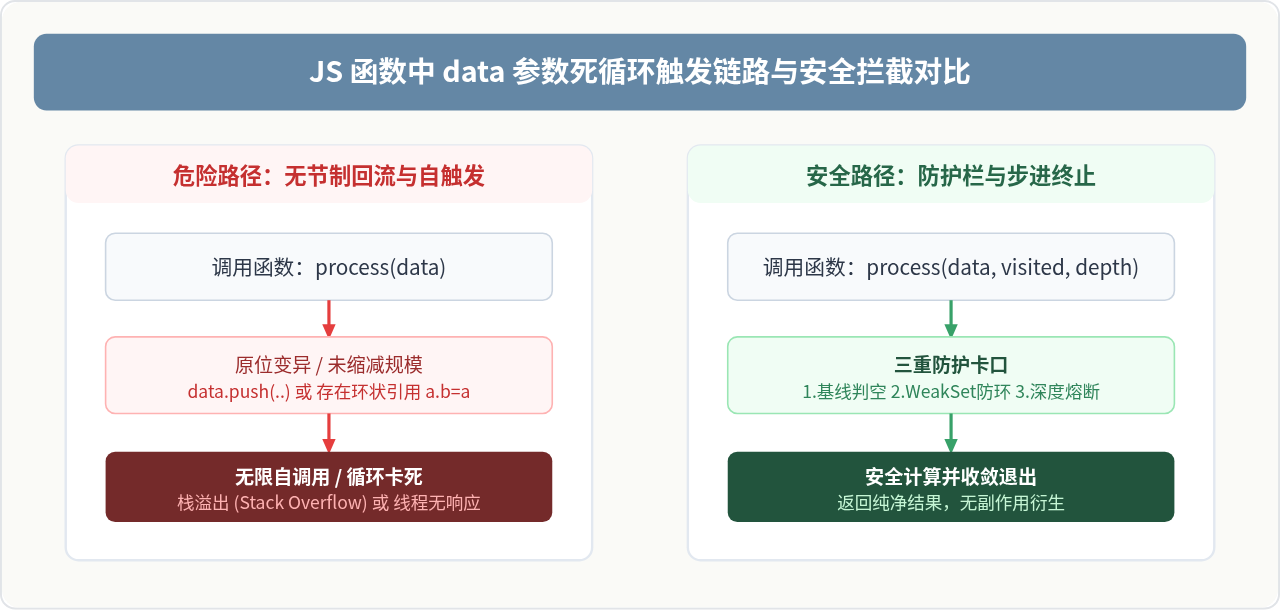
图 1:data 参数在未经防护与配备防护机制下的执行走向对比
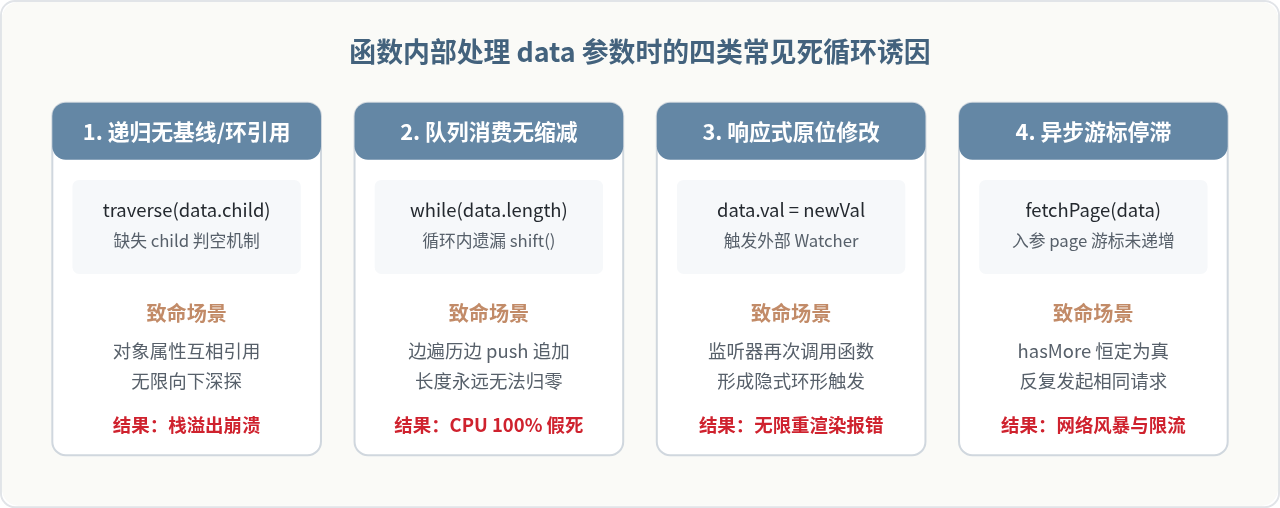
图 2:针对 data 参数编写函数时的四类常见死循环诱因及其具体后果
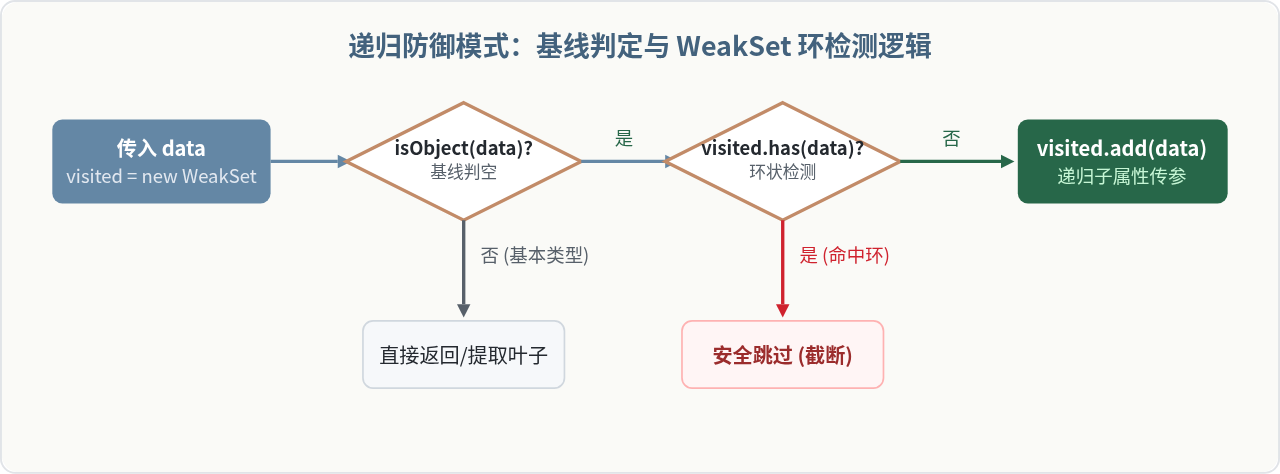
图 3:递归函数中利用 WeakSet 阻断环状引用的判定机制
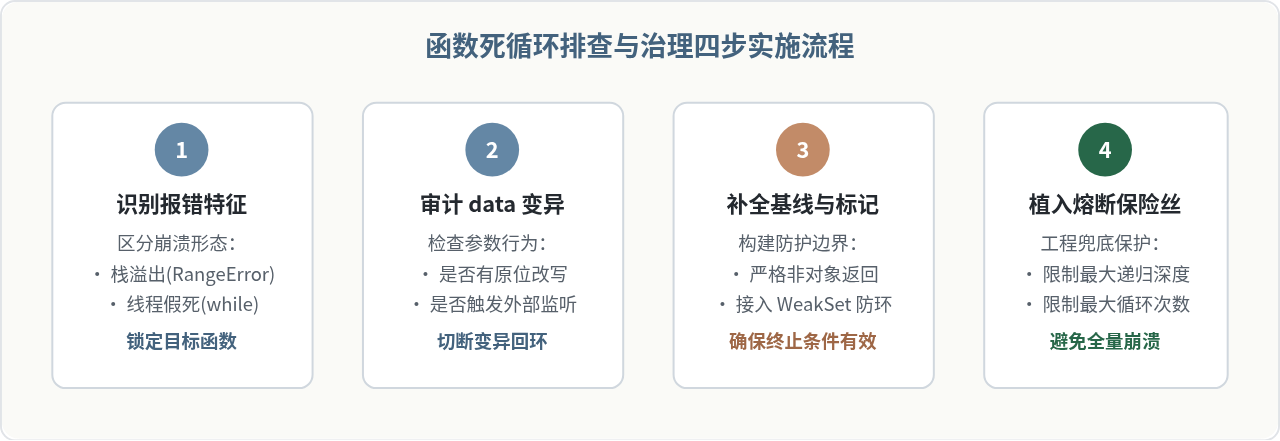
图 4:定位与彻底规避 data 参数死循环的标准排查路径
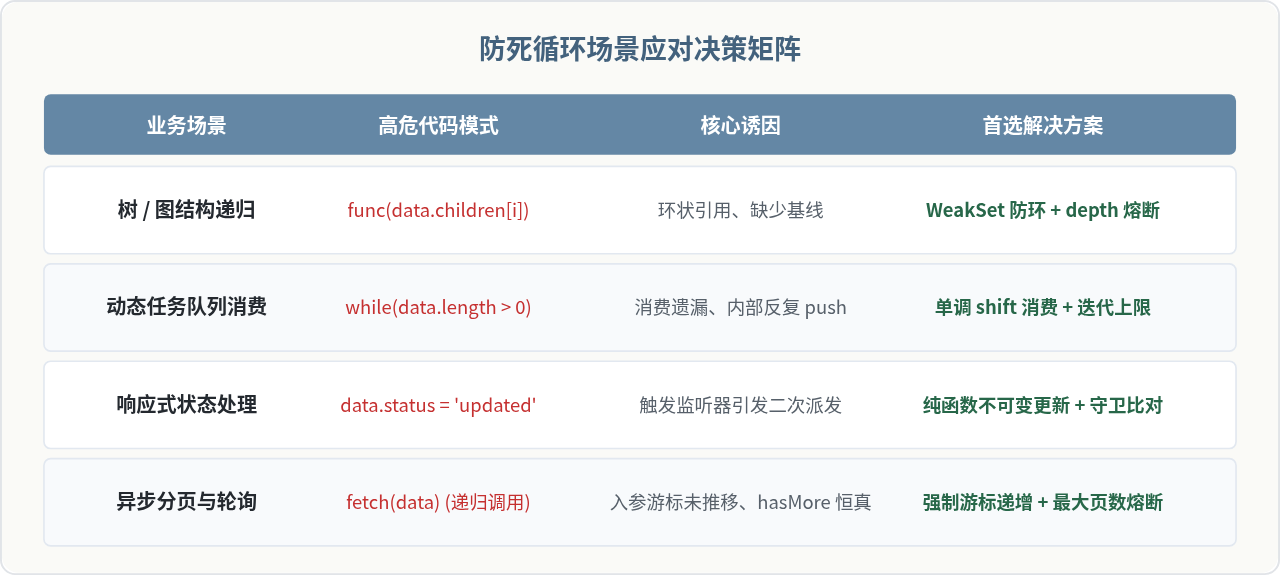
图 5:各业务场景下 data 参数死循环的诱因与首选解决方案速查
在 JavaScript 函数中,data 参数引发死循环的核心原因通常不是语法错误,而是递归时缺少有效的基线条件与防环机制、迭代时未单向缩减待处理集合、或者在函数内原位修改了 data 进而触发外部监听回环。避免死循环的关键在于遵循三项规则:将 data 视为只读输入并采用不可变更新、在递归处理对象或树形结构时使用 WeakSet 记录访问标记、以及在动态消费队列或异步分页时设立不可绕过的递增步进与熔断阈值。
一、为什么 data 参数容易引发死循环
在实际业务开发中,命名为 data 的参数往往承载着复合型数据,例如后端返回的嵌套树、由事件派发的状态包、或是批处理队列。由于 JavaScript 采用弱类型且对象默认按引用传递(Pass by Reference),开发者一旦在处理 data 时混淆了“读取”、“消费”与“变异”的边界,就极易诱发死循环。
死循环在运行态通常分为两种具体表现:
- 调用栈溢出(Synchronous Stack Overflow):通常伴随控制台报错
RangeError: Maximum call stack size exceeded。这发生在同步递归调用中,每次递归都向栈中推入新的执行上下文,由于没有在合适时机命中终止条件,或者data中存在相互引用的属性,导致栈空间瞬间耗尽。 - 主线程假死与无响应(Event Loop Freeze):浏览器页面卡死或 Node.js 进程 CPU 占用达到 100%。多发生在
while或for循环中,循环体未能有效修改data的判定标识,或是由于异步任务、微任务不断产生无休止的级联派发。
二、场景一:递归处理 data 时的环状引用与基线缺失
递归是处理多层嵌套结构(如树形菜单、组织架构、评论回复列表)最自然的手段。但在编写以 data 为入参的递归函数时,最常见的失误有两个:未声明有效的退出条件(Base Case),以及未防范对象内部的环状引用(Circular Reference)。
1. 错误模式:缺失基线条件与环状引用
观察以下代码,函数假设只要有子节点就一直向下递归。如果传入的 data 没有终结标识,或者由于后端脏数据、DOM 节点树结构中存在父子相互引用(如 node.parent.children 循环指向),调用栈将立刻被打爆:
// 错误示范:缺乏环检测与严密边界判定的递归
function extractKeys(data) {
  const keys = [];

  // 潜在问题 1:如果 data 传 null 或非对象,直接报错;如果对象为空,缺少收敛处理
  for (const key in data) {
    keys.push(key);
    // 潜在问题 2:如果 data[key] 重新引用了外层的 data,此处会无限自我递归
    if (typeof data[key] === 'object' && data[key] !== null) {
      keys.push(...extractKeys(data[key]));
    }
  }

  return keys;
}

// 模拟循环引用场景
const badData = { id: 1, name: 'root' };
badData.self = badData; // 自己引用自己
extractKeys(badData); // Uncaught RangeError: Maximum call stack size exceeded
2. 防御方案:基线判空与 WeakSet 防环
解决此问题的根本方法是在函数签名中增加一个内部传递的缓存容器。推荐使用 WeakSet,因为它保存的是对象的弱引用,不会阻碍垃圾回收(GC),而且能在 $O(1)$ 时间复杂度内检测当前对象是否已经被遍历过。
// 正确示范:基线验证 + WeakSet 防环 + 递归深度熔断
function safeExtractKeys(data, visited = new WeakSet(), currentDepth = 0, maxDepth = 100) {
  // 1. 基线条件 1:非对象或 null,无需继续递归,直接终止
  if (data === null || typeof data !== 'object') {
    return [];
  }

  // 2. 防御性深度熔断:防止超深嵌套打爆调用栈
  if (currentDepth > maxDepth) {
    console.warn(`[安全警告] 达到最大递归深度限制 ${maxDepth},强制停止继续深探`);
    return [];
  }

  // 3. 基线条件 2:检测当前引用是否已经在上层递归中被访问过
  if (visited.has(data)) {
    // 命中环状引用,直接返回空数组,阻断死循环
    return [];
  }

  // 4. 将当前节点引用记录到已访问集合中
  visited.add(data);

  const keys = [];
  for (const key of Object.keys(data)) {
    keys.push(key);
    const value = data[key];
    if (value !== null && typeof value === 'object') {
      // 透传已访问集合与递增的深度
      keys.push(...safeExtractKeys(value, visited, currentDepth + 1, maxDepth));
    }
  }

  return keys;
}

// 验证测试:处理带环对象安全返回
const complexData = { id: 1, info: { title: 'test' } };
complexData.circle = complexData;
const result = safeExtractKeys(complexData);
console.log(result); // 成功输出: ['id', 'info', 'circle', 'title'],无任何异常
三、场景二:循环消费 data 时的变异与条件停滞
在批量任务处理或队列消费函数中,开发者通常习惯传入一个数组类型的 data,并使用 while (data.length > 0) 逐步消费任务。这类函数引发死循环的典型原因是在循环体内忘记缩减 data,或者在处理过程中无意间将新元素重新 push 进 data。
避坑警示:不要在 while 迭代中既读取原数组又修改原数组
直接修改由外部传入的 data 参数(例如调用 data.shift())会产生破坏性副作用,导致外部调用方的源数据被清空。更危险的是,若因 try...catch 或分支 continue 跳过了移除步骤,循环将陷入永久阻塞。
消费型循环的最佳实践模式
编写以 data 为队列的消费函数时,应始终在函数内部构建独立队列副本,并绑定严格的单调递减步进或安全迭代计数器:
// 健壮的队列消费模式:局部浅拷贝 + 严格消费 + 熔断保护
function processTaskQueue(data) {
  if (!Array.isArray(data) || data.length === 0) {
    return { processedCount: 0, errors: [] };
  }

  // 1. 隔离外部数据:浅拷贝出局部工作队列,不污染调用方传入的原 data
  const queue = [...data];
  let processedCount = 0;

  // 2. 设置安全保险丝:最大允许迭代次数,避免无限循环
  const MAX_ITERATIONS = 10000;
  let iteration = 0;

  while (queue.length > 0) {
    iteration++;
    if (iteration > MAX_ITERATIONS) {
      throw new Error(`[安全熔断] 队列消费超出最大迭代上限 (${MAX_ITERATIONS}),已强制终止。`);
    }

    // 3. 关键动作:必须确保每轮迭代都有且仅有一次无条件的弹出
    const currentItem = queue.shift();

    try {
      // 执行业务处理
      handleItem(currentItem);
      processedCount++;
    } catch (err) {
      console.error(`处理元素失败:`, currentItem, err);
      // 即使失败,由于 shift() 已经执行,队列长度单调递减,绝不会无限重复卡在当前项
    }
  }

  return { processedCount, completed: true };
}
四、场景三:响应式与状态管理中的 data 变异回环
在 Vue、React 或自定义发布-订阅事件流中,函数的 data 参数如果代表着响应式状态(Reactive State),直接在函数体内对 data 的属性进行赋值(In-place Mutation)极易引发链式反应:
- 外部状态变化,触发回调函数并传入当前状态
data; - 回调函数内部执行
data.status = 'done'或data.count++; - 响应式追踪引擎(Proxy / Object.defineProperty)捕获到属性写入操作;
- 响应式引擎立即派发变更通知,再次触发该回调函数;
- 形成 更新 -> 派发 -> 执行 -> 再更新 的闭环,导致浏览器界面卡顿崩溃并抛出重渲染超限错误。
黄金准则:纯函数(Pure Function)与相等性守卫(Guard Check)
函数接收 data 后,如需派发新状态,应当始终通过返回新对象的形式传递,并在派发前执行相等性比对。如果计算出的新数据与当前数据实质相同,坚决不触发状态更新。
// 错误做法:在处理 data 时原位修改,触发 Watcher/Effect 无限循环
function onDataReceived(data) {
  // 危险:直接变异响应式数据对象
  data.lastUpdated = Date.now();
  // 如果外部对 data.lastUpdated 做了监听,此处将无止境自调用
}

// 正确做法:守卫检查 + 不可变返回
function safeDataTransformer(data, nextStatus) {
  // 1. 守卫检查:新旧值一致时立即退出,斩断触发链
  if (data.status === nextStatus) {
    return data;
  }

  // 2. 不可变更新:不破坏入参 data,返回结构完全独立的浅拷贝对象
  return {
    ...data,
    status: nextStatus,
    updatedAt: Date.now()
  };
}
五、场景四:异步轮询与递归拉取中的参数停滞
在需要分页全量拉取数据或轮询任务状态的场景中,异步递归函数通常将查询凭据或分页上下文封装在 data 中,例如 { page: 1, pageSize: 20, hasMore: true }。
当接口返回的数据格式异常,或者开发者在 then / await 后传递了未修改的 data,函数就会陷入无休止发起相同网络请求的死循环,瞬间造成服务端接口超载和客户端卡死。
// 健壮的异步分页拉取模式:参数步进自增 + 强制熔断器
async function fetchAllRecords(queryData, maxAllowedPages = 50) {
  const allRecords = [];

  // 1. 拷贝初始入参,确保分页游标独立维护
  let currentQuery = { ...queryData, page: queryData.page || 1 };
  let pagesFetched = 0;

  while (true) {
    pagesFetched++;

    // 2. 熔断判定 1:超出安全分页限制直接终止
    if (pagesFetched > maxAllowedPages) {
      console.warn(`[安全提示] 分页拉取达到上限 ${maxAllowedPages} 页,主动中止请求。`);
      break;
    }

    const response = await fetchApiRecords(currentQuery);

    // 3. 熔断判定 2:响应数据不合规或无新增项时立即退出
    if (!response || !Array.isArray(response.list) || response.list.length === 0) {
      break;
    }

    allRecords.push(...response.list);

    // 4. 熔断判定 3:后端返回明确的终止信号
    if (!response.hasMore) {
      break;
    }

    // 5. 关键动作:显式推进游标,保证每次迭代参数不同
    currentQuery = {
      ...currentQuery,
      page: currentQuery.page + 1
    };
  }

  return allRecords;
}
六、排查与规避死循环的四步操作流程
当系统在运行中出现卡死或抛出栈溢出异常时,可以按照以下四个具体步骤进行定位与重构:
- 步骤一:通过崩溃特征定位问题类型。如果是
Maximum call stack size exceeded,立刻排查递归调用链路;如果是页面毫无反应、界面冻结且无任何报错输出,直接搜索代码中的while或for循环,检查终止条件是否被悬挂。 - 步骤二:审计函数对 data 参数的读写行为。搜索函数内部是否存在
data.xxx = ...、data.push(...)或data.splice(...)。如果有,将其重构成不可变数据形式(例如[...data]或{ ...data }),消除由副作用引发的间接死循环。 - 步骤三:补充显式基线条件与防环记录器。对于树或图结构,检查第一行是否明确判定了数据有效性;在遍历子属性前,通过
WeakSet.has(data)判断当前节点是否已被访问过。 - 步骤四:为复杂循环挂载“熔断保险丝”。无论多确信逻辑正确,在处理不信任的动态数据源(如用户自定义配置、动态接口)时,都应预留
maxDepth(推荐默认 50-100)或maxIterations(推荐默认 1000-50000),当超出预设上限时记录警告并强行break,确保单点数据异常不拖垮整个系统。
七、总结与场景决策速查
在 JavaScript 开发中,彻底根除 data 参数引发死循环的核心思路,是将数据规模的缩减与退出条件变成一种单向不可逆的确定性行为。下表归纳了不同业务场景下的排查重点与防御手段:
| 维度 | 高危写法(死循环隐患) | 工程规范(安全防御) |
|---|---|---|
| 数据修改 | 直接对 data.prop 进行原位赋值或原地增删元素 |
将入参视为只读输入,使用解构赋值 { ...data } 产生新对象 |
| 递归控制 | 仅根据属性是否存在盲目调用自身,忽略引用关系 | 首部显式校验基线,使用 WeakSet 拦截已经遍历过的对象引用 |
| 循环条件 | 依赖动态变化的外部状态,且无明确步进操作 | 每轮迭代必须有且仅有一次确定的数据规模缩减(如 shift 或 page++) |
| 异常防御 | 完全信任业务数据与外部返回格式 | 必须为递归与大循环预留 maxDepth / maxIterations 兜底保险丝 |
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章