
深入剖析 JavaScript Set 无法直接对对象数组去重的底层原理,从内存引用与 SameValueZero 算法切入,提供基于唯一键与内容哈希的高效去重实践方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
为什么JS Set无法直接对对象数组去重
作者:小括号
时间:2026-11-06
浏览:73
文章目录
在 JavaScript 中,
Set 无法直接对对象数组去重,根本原因在于其内部采用 ECMAScript 规范定义的 SameValueZero 算法进行唯一性校验。对于对象等引用类型,该算法比较的是它们在堆内存中的引用地址(指针),而不是对象内部包含的属性键值对。由于字面量对象每次声明都会在堆中分配全新的内存空间,即便内容一模一样,其指针也不相同,因此 Set 会将其判定为不同实体。
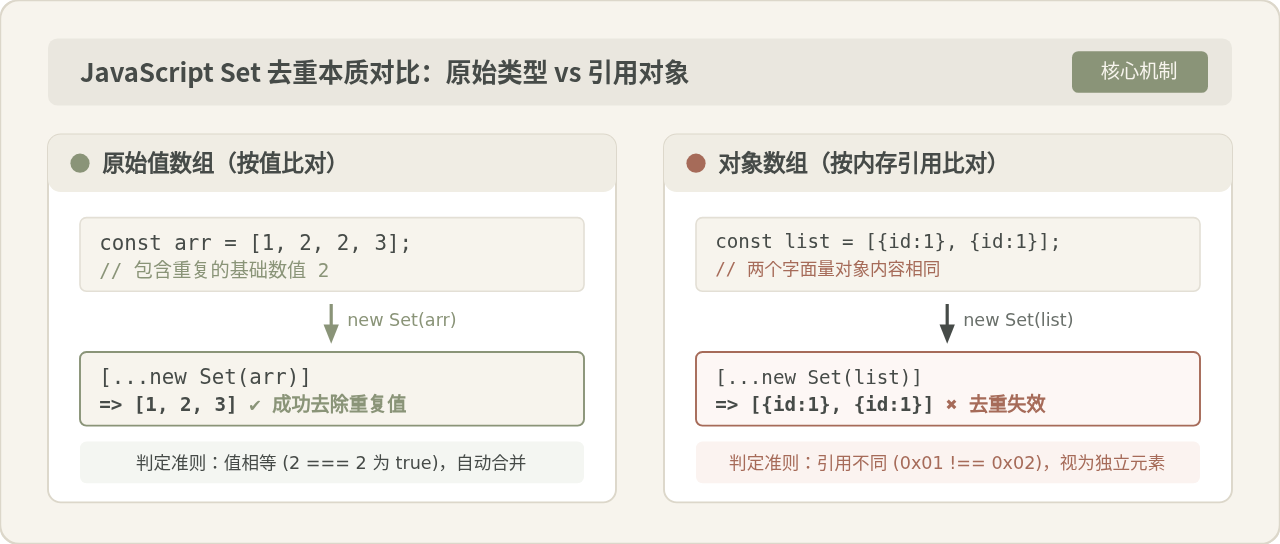
图 0:Set 对基础类型按值判等,对对象按内存指针引用的行为差异
一、直观现象:基础类型生效,对象数组“失灵”
在日常开发中,利用扩展运算符与 Set 是对基础类型数组去重最简洁的方式。很多初学者在处理数字或字符串时体验良好,便自然而然地将其套用到对象数组上:
// 1. 基础类型数组去重:完全符合预期
const numbers = [1, 2, 2, 3];
console.log([...new Set(numbers)]);
// 输出: [1, 2, 3]

// 2. 对象数组去重:去重失效
const users = [
  { id: 1, name: "张三" },
  { id: 1, name: "张三" }
];
console.log([...new Set(users)]);
// 输出: [{ id: 1, name: "张三" }, { id: 1, name: "张三" }]
// 两个对象依然同时存在,并没有被去重
很多开发者初次遇到该现象时,往往会误以为 Set 存在 Bug,或者认为 Set 会像人类肉眼观察数据那样递归比对 id 和 name。然而在 JavaScript 引擎层面,Set 从来不对对象内容做任何“深层扫描”。
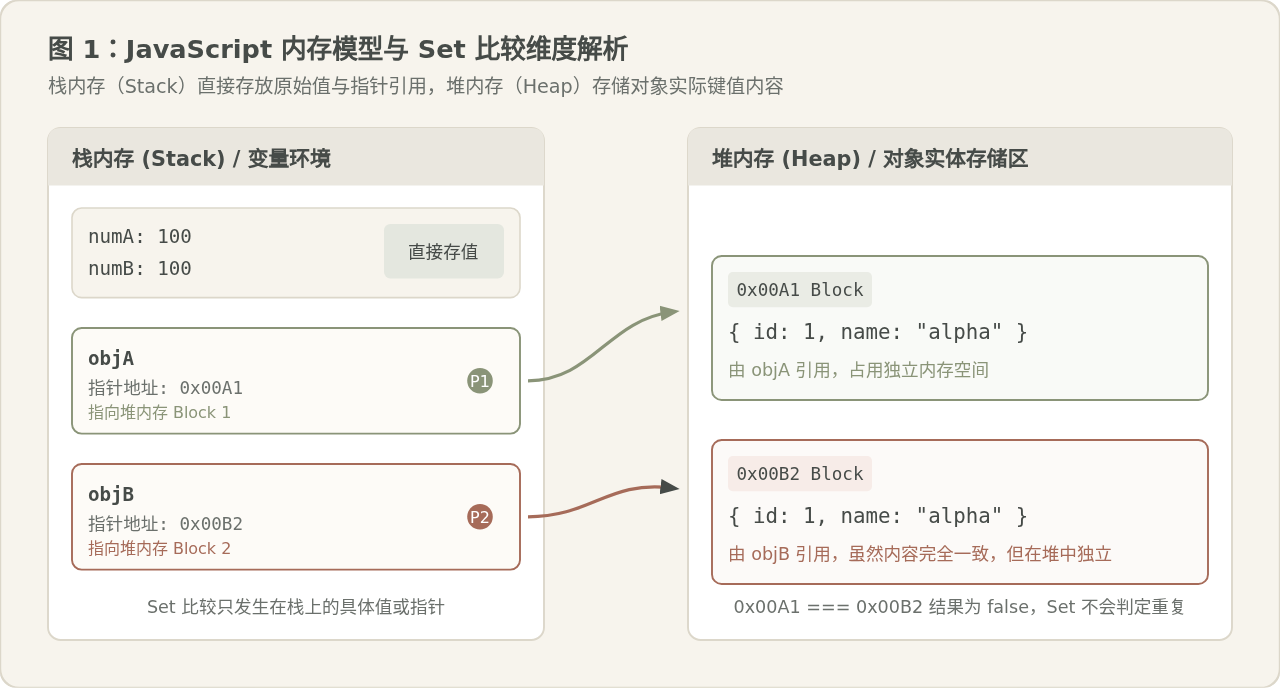
图 1:JavaScript 内存模型与 Set 比较机制(栈中按值与指针比较,堆中存放对象实体)
二、底层原理解析:内存引用与 SameValueZero 算法
1. 栈内存与堆内存的存储分工
JavaScript 将数据划分为原始类型(Primitive Types,如 Number, String, Boolean, Symbol 等)和引用类型(Reference Types,即 Object, Array, Function 等)。
- 原始类型:数据体积轻量且固定,直接按值(Value)存放在执行栈内存(Stack)中。当比对两个数值
2 === 2时,比对的是具体数值本身。 - 引用类型:对象属性结构灵活且体积不确定,实体数据存放在堆内存(Heap)中。在栈内存中,变量保存的仅仅是指向该堆内存区块的指针地址(十六进制地址,如
0x00A1)。
当执行 [{ id: 1 }, { id: 1 }] 时,代码中出现了两个对象字面量,JavaScript 引擎在堆内存中独立开辟了两块存储空间,分别分配了不同的指针(例如 0x00A1 与 0x00B2)。
2. ECMAScript 规范中的 SameValueZero 判等算法
根据 ECMAScript 语言规范,Set.prototype.add 以及 new Set(iterable) 在底层使用 SameValueZero(x, y) 算法判定两项是否相同。
该算法与严格全等运算符 === 非常接近,唯一的关键差别在于处理 NaN:在 === 规则下 NaN === NaN 返回 false,而在 SameValueZero 中,NaN 与 NaN 被视为相同的值(因此 Set 中只能存在一个 NaN)。对于对象类型,两者行为完全一致:
// 伪代码表示 SameValueZero 的对象判断部分:
function sameValueZero(x, y) {
  if (typeof x !== typeof y) return false;
  if (typeof x === 'number') {
    if (Number.isNaN(x) && Number.isNaN(y)) return true;
    return x === y;
  }
  // 对于引用类型,完全等价于引用指针的全等比对
  return x === y;
}
关键概念辨析:Set 并非“无法去重对象”,而是“只去重相同引用的对象”
若多个变量指向内存中的同一引用实例,放入
若多个变量指向内存中的同一引用实例,放入
Set 是能够正常去重的:
const sharedUser = { id: 1, name: "李四" };
const list = [sharedUser, sharedUser];
console.log([...new Set(list)]);
// 输出: [{ id: 1, name: "李四" }] —— 引用相同,成功去重!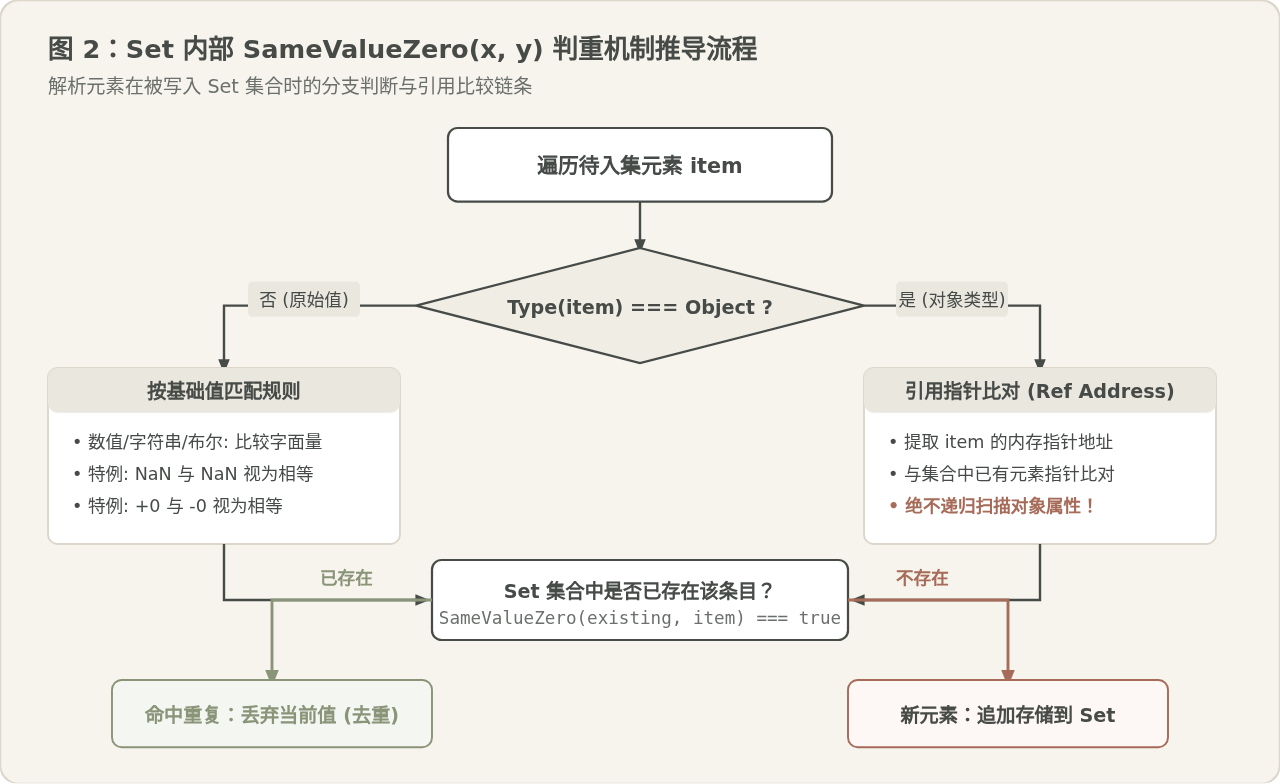
图 2:Set 内部 SameValueZero(x, y) 判重逻辑推导流程图
三、业务场景中的正确去重方案与实现
在实际工程中,对象数组去重主要分为两种需求:一种是根据单一业务唯一键(如 id 或 userId)去重,另一种是根据全部字段内容深度一致去重。针对不同场景,推荐采用不同的处理策略。
方案一:按业务唯一键去重(Map 映射法,推荐工程首选)
在后台数据接口中,业务对象通常具备唯一的主键标识(如 id)。利用 ES6 Map 的键天然唯一的特性,可以以 O(n) 的时间复杂度完成高效去重:
/**
 * 根据指定键对对象数组进行去重
 * @param {Array} arr 待去重的对象数组
 * @param {string} key 作为唯一标识的属性名
 * @returns {Array} 去重后的对象数组
 */
function deduplicateByKey(arr, key) {
  const map = new Map();
  // 利用 forEach 遍历,遇到相同 key 会覆盖前值;若想保留首个出现的值,可先判断 !map.has(item[key])
  for (const item of arr) {
    const idVal = item[key];
    if (!map.has(idVal)) {
      map.set(idVal, item); // 保留首次出现的对象项
    }
  }
  return Array.from(map.values());
}

// 验证示例
const rawList = [
  { id: 1, name: "Alice", role: "admin" },
  { id: 2, name: "Bob", role: "member" },
  { id: 1, name: "Alice_Updated", role: "admin" },
  { id: 3, name: "Charlie", role: "guest" }
];

console.log(deduplicateByKey(rawList, 'id'));
// 得到包含 id 为 1, 2, 3 的 3 条记录,耗时为 O(n)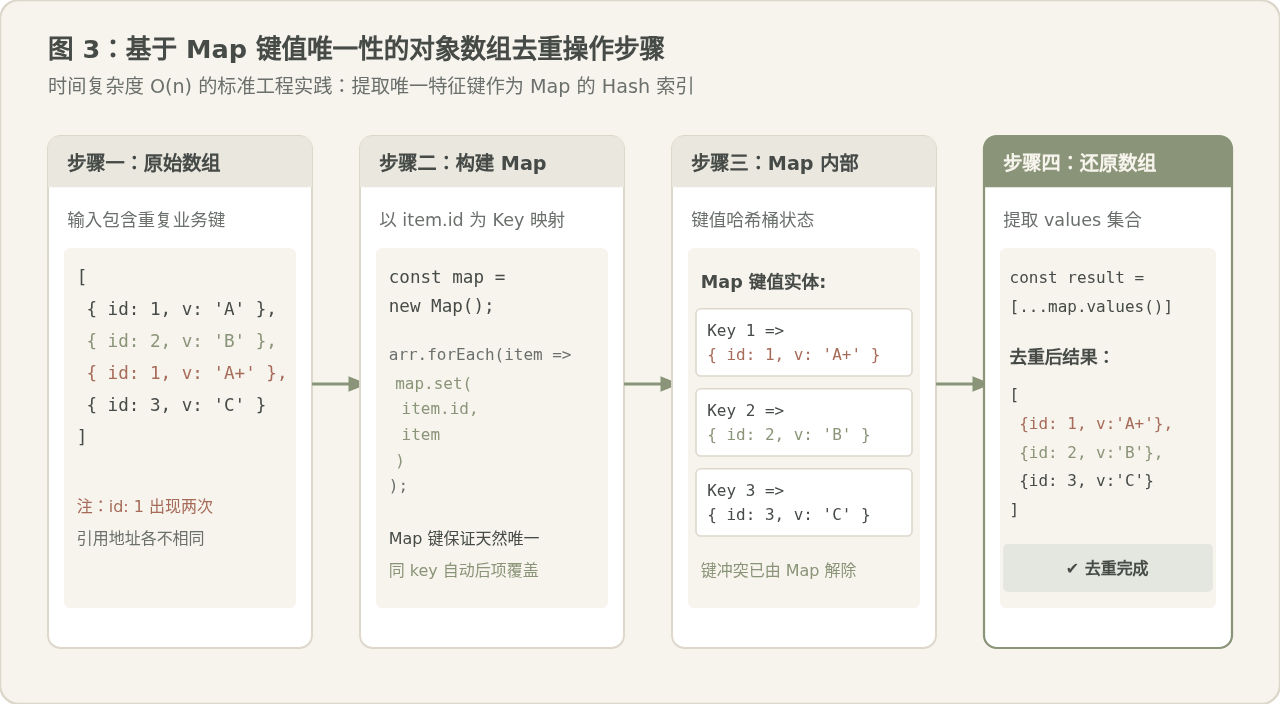
图 3:基于 Map 键值唯一性的对象数组去重操作步骤
如果追求单行书写风格,也可以结合 filter 与一个临时的 Set:
const seen = new Set();
const uniqueList = rawList.filter(item => {
  if (seen.has(item.id)) return false;
  seen.add(item.id);
  return true;
});
方案二:按对象全部内容深度去重
如果对象没有单独的主键,必须每个属性都完全相等才算重复,则需要进行内容比对。
方法 A:基于规范化 JSON 序列化哈希(适用结构扁平、数据纯净场景)
直接使用 JSON.stringify 去重存在一个致命陷阱:JavaScript 对象的属性顺序不确定。{ a: 1, b: 2 } 与 { b: 2, a: 1 } 序列化后的字符串不相等。因此需要先对键名进行排序规范化:
function deduplicateByContent(arr) {
  const seenJson = new Set();
  return arr.filter(item => {
    // 递归对对象的所有 Key 进行排序,保证序列化字符串一致
    const sortedJson = JSON.stringify(item, Object.keys(item).sort());
    if (seenJson.has(sortedJson)) {
      return false;
    }
    seenJson.add(sortedJson);
    return true;
  });
}
JSON.stringify 去重方案的边界限制与注意事项:
- 属性值为
undefined、函数或Symbol时,在序列化过程中会被忽略或转换为null,导致误判; - 若对象中包含
Date对象,序列化后会变成 ISO 字符串;包含RegExp会退化为空对象; - 存在循环引用的对象调用
JSON.stringify会直接抛出TypeError: Converting circular structure to JSON。
方法 B:深度遍历比对(适合无 ID 且属性复杂的场景)
对于包含复杂嵌套或特殊类型的对象,可以使用深度比较函数(如 Lodash 的 isEqual,或自定义深度比对):
function deepEqual(objA, objB) {
  if (objA === objB) return true;
  if (typeof objA !== 'object' || objA === null ||
      typeof objB !== 'object' || objB === null) return false;

  const keysA = Object.keys(objA);
  const keysB = Object.keys(objB);
  if (keysA.length !== keysB.length) return false;

  for (const key of keysA) {
    if (!keysB.includes(key) || !deepEqual(objA[key], objB[key])) {
      return false;
    }
  }
  return true;
}

function deduplicateDeep(arr) {
  return arr.reduce((acc, current) => {
    const exists = acc.some(item => deepEqual(item, current));
    if (!exists) acc.push(current);
    return acc;
  }, []);
}
四、方案对比与技术选型总结
在实际项目架构中,不同方案在执行效率与适用范围上存在显著差异:
| 方案名称 | 实现依据 | 时间复杂度 | 空间复杂度 | 适用业务场景 |
|---|---|---|---|---|
| 原生 Set 直接转换 | 内存指针 | O(n) | O(n) | 仅限基础类型数组;对象数组去重失效 |
| Map / Set 键索引法 | 业务唯一字段 (id) | O(n) | O(n) | 推荐首选,绝大部分列表、表格与接口数据清洗 |
| 规范化 JSON 哈希法 | JSON 字符串键排序 | O(n · m log m) | O(n) | 无唯一 ID,纯字面量无函数嵌套的中小型数据 |
| 递归 deepEqual 遍历 | 全属性深度比对 | O(n²) | O(n) | 数据结构复杂且必须完全比对,但数据量极小 (<500条) |
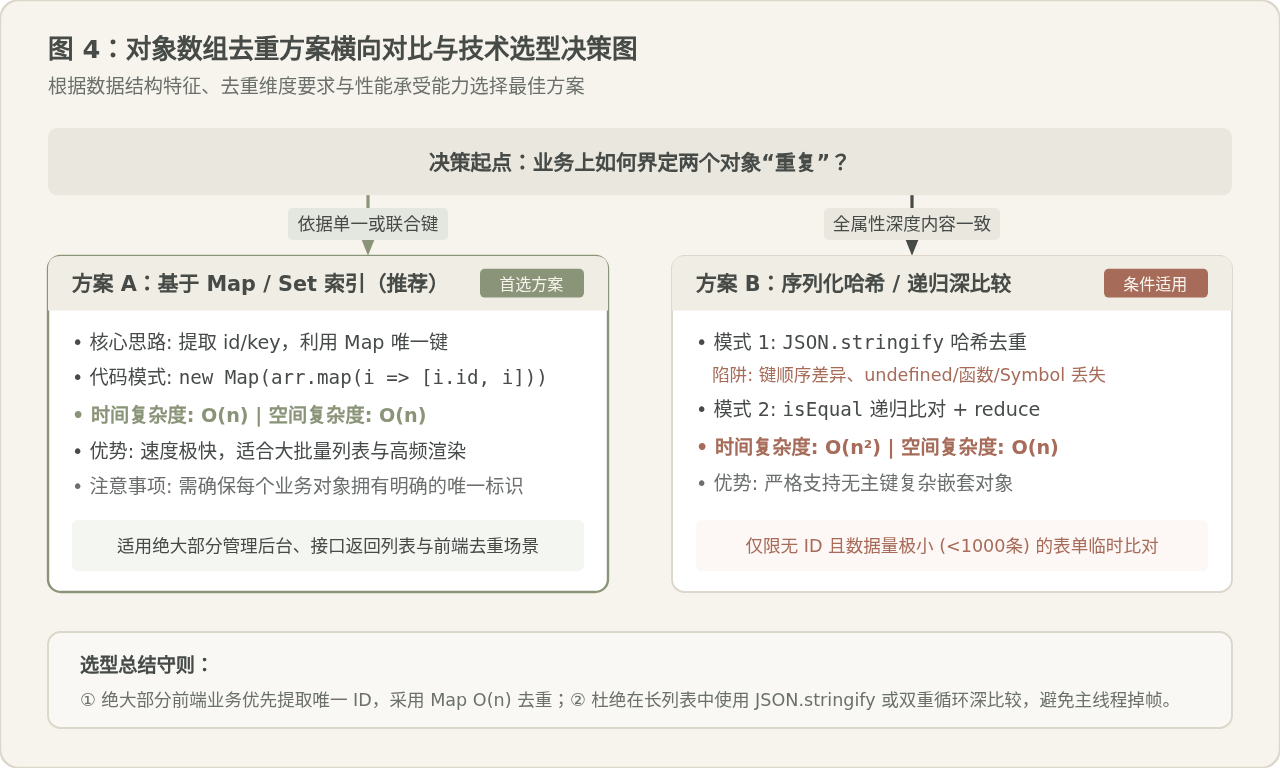
图 4:对象数组去重方案横向对比与技术选型决策图
核心结论:Set 无法直接对对象数组去重,是 JavaScript 内存引用模型与 SameValueZero 规范的必然结果。开发中切勿在包含对象字面量的数组上盲目调用 [...new Set(arr)];在存在主键字段时,优先采用 Map 收集键值映射,兼顾代码可读性与 $O(n)$ 顶级性能表现。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章