
深入解析JavaScript拖拽排序后保存顺序的核心方案:从DOM视图变动到前端数据模型同步,对比全量更新、浮点数间隔与双向链表三种后端持久化方案,并附带完整的乐观更新与前后端交互代码示例。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS拖拽排序后怎么保存顺序?前端数据同步与后端交互示例
作者:小括号
时间:2026-11-05
浏览:538
文章目录
在前端实现拖拽排序时,界面的移动仅仅是 DOM 节点位置的变化,并不代表数据已完成重排。保存排序的核心链路分为两步:首先在拖拽松开(Drop)时获取元素的新索引,将变化同步给前端内存中的数据列表;随后根据业务规模选择全量重排、浮点数插入或链表关联策略,把最新的唯一排序凭证通过网络请求持久化到后端数据库中。
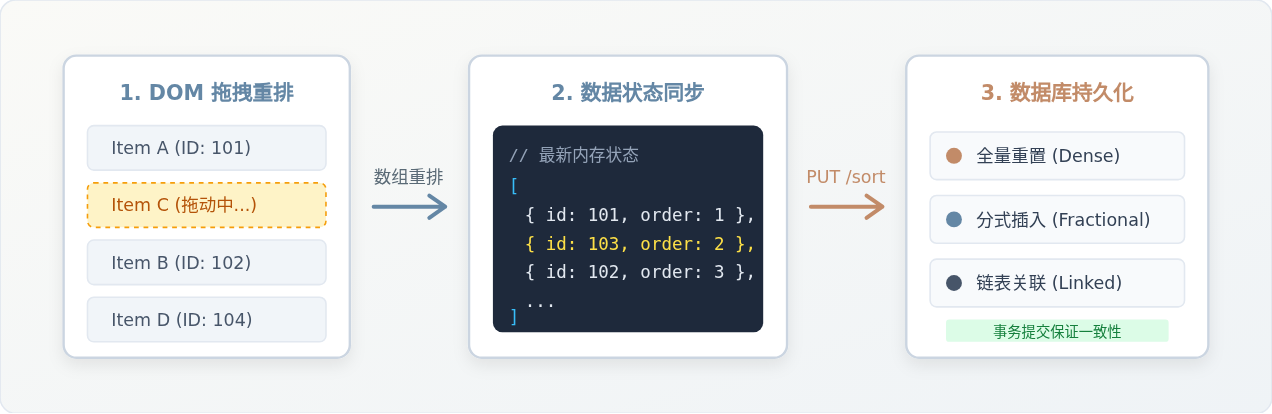
一、为什么仅靠 DOM 拖拽无法真正保存顺序?
不管是利用 HTML5 原生 draggable 接口,还是借由成熟的 SortableJS 等库,拖拽组件主要做的事情是监听鼠标或触摸手势,通过 DOM 操作(例如 insertBefore 或 appendChild)改变节点在文档流中的几何位置。
这种改变完全发生在浏览器的渲染进程中。如果不进行任何数据层面的提取,只要页面刷新,浏览器根据初始服务端数据或静态 HTML 重新渲染,列表就会瞬间恢复原样。
因此,保存排序必须解决两个关键矛盾:
- 视图层与数据层的脱钩:DOM 重新排列后,挂载在内存中的 JavaScript 数组(如 Vue 的
reactive items、React 的state或原生全局数组)仍然保持着拖拽前的顺序。 - 客户端状态与数据库的隔离:即使前端内存数组完成了重排,也必须挑选一个合理的网络传输格式与数据库模型,以尽可能低的系统开销完成落盘。
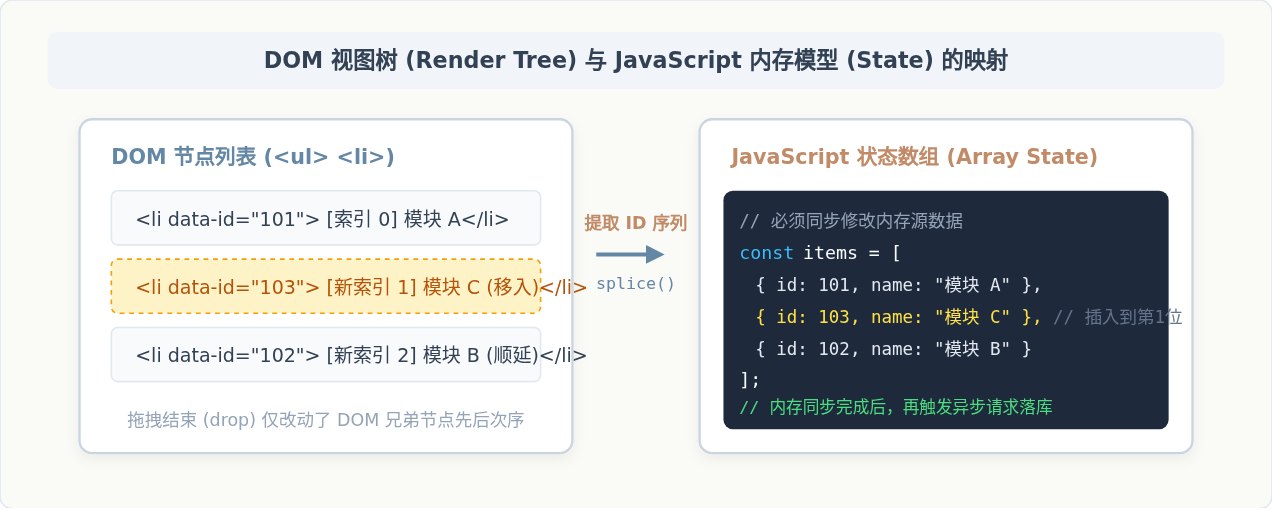
二、前端如何捕获并同步重排后的数据?
要实现前端数据同步,核心任务是在拖拽动作结束的一瞬间,获得两样数据:被移动项的原始下标(oldIndex)与被放置的目标下标(newIndex)。
1. 原生 JavaScript 的数据同步思路
在原生 HTML5 拖拽 API 中,我们可以通过 data-id 属性标记每个元素的主键,在 dragstart 阶段记录被拖拽元素,在 drop 事件中计算其相对于父级节点子集的新位置:
// 假设当前列表数据存储在数组中
let dataList = [
  { id: 101, title: '设计登录页面', sort_order: 1 },
  { id: 102, title: '编写API接口', sort_order: 2 },
  { id: 103, title: '数据库迁移测试', sort_order: 3 }
];

function handleDrop(oldIndex, newIndex) {
  if (oldIndex === newIndex) return;

  // 1. 使用 splice 移除被拖动的元素
  const [movedItem] = dataList.splice(oldIndex, 1);

  // 2. 将元素插入至新的目标位置
  dataList.splice(newIndex, 0, movedItem);

  // 3. 重新校准内存中的 sort_order 属性(根据需要)
  dataList.forEach((item, index) => {
    item.sort_order = index + 1;
  });

  console.log('内存数据已同步:', dataList);
}
⚠️ 注意事项
直接遍历 DOM 提取 Array.from(list.children).map(el => el.dataset.id) 虽然简单,但如果在现代框架(如 React/Vue)中直接修改 DOM 树而未同步更新响应式数组,下一次框架重新渲染(Re-render)时将产生严重的 DOM 混乱或节点复用 Bug。始终保持“手势 → 算索引 → 变数据 → 框架接管渲染”的原则。
三、后端保存排序的三种主流设计方案对比
前端排好序后,应该给后端发送什么样的数据?后端数据库又该如何设计字段?这是很多开发者在实际项目中权衡最多的部分。通常有以下三种方案:
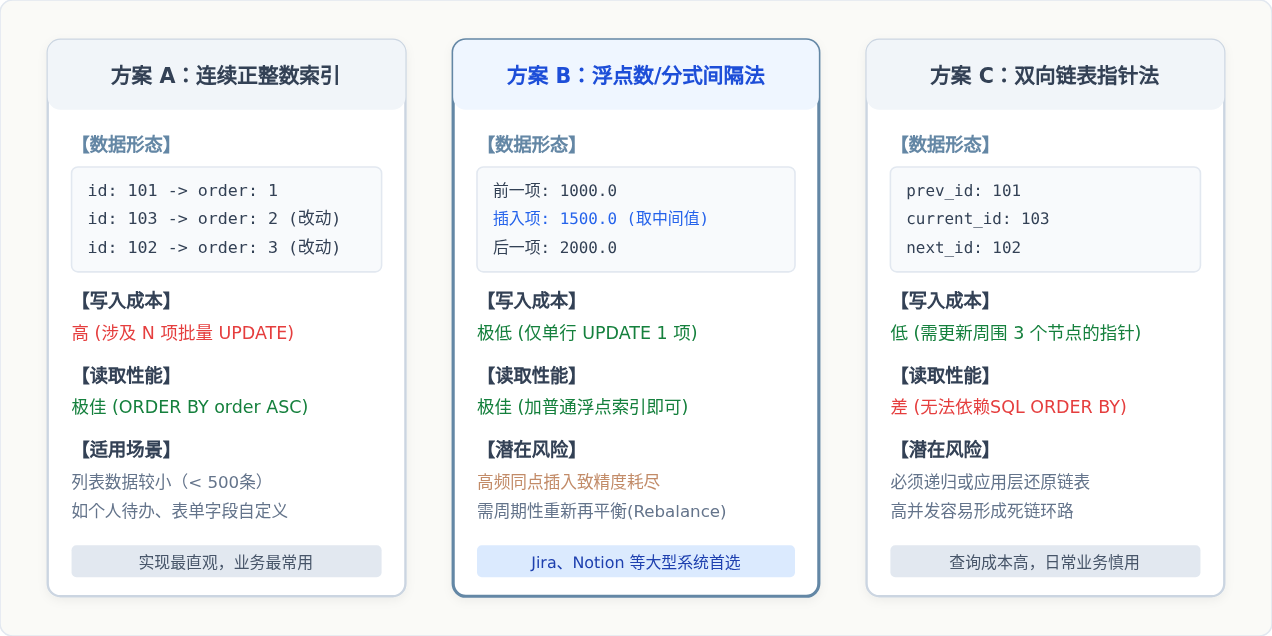
1. 方案 A:全量/批量覆盖索引(连续正整数)
这是最符合直觉的做法。每个条目在表中拥有一列 sort_order INT。拖拽完成后,前端把完整的 ID 顺序列表打包发送给后端(例如 { ids: [101, 103, 102, 104] }),后端在数据库事务中通过一条 CASE 语句或批量更新完成写入。
优点:概念清晰,查询极其高效(SELECT * FROM tasks ORDER BY sort_order ASC),容错性高。
缺点:若列表有上万条数据,拖拽一次可能导致成千上万行数据被加锁重写,数据库写入 I/O 压力大。
2. 方案 B:浮点数中值插入法(Fractional Indexing)
在创建数据时,赋予每条数据一个间隔较大的权值(如 1000、2000、3000)。当将一项拖动到 1000 与 2000 之间时,前端仅需将其权值计算为两者均值 (1000 + 2000) / 2 = 1500。
优点:每次拖拽无论数据量有多大,始终只更新 1 行数据,网络数据包极小,并发吞吐量极佳。
缺点:连续在同一位置插入多次后,小数位数会迅速激增,受限于浮点数精度限制,系统必须引入周期性的“重平衡机制”(Rebalance),在特定阈值下自动将所有权重重新拉开为整数。
3. 方案 C:前后指针法(链表设计)
每条记录保存 prev_id 和 next_id。移动节点时,只需断开原位置两端指针、重新缝合新位置两侧的节点指针。
缺点:数据库端无法方便地进行分页和常规 ORDER BY 排序,读取时要么需要递归 CTE 查询,要么需要将全部记录加载至后端内存中拼接成链表,开发和运维心智负担较高。
四、前后端网络交互与容错体验
在真实业务环境中,网络可能会抖动或请求失败。如果用户频繁快速拖拽,每一帧都发送 HTTP 请求,不仅会造成接口雪崩,还会引发“后发请求先到”的竞态条件。
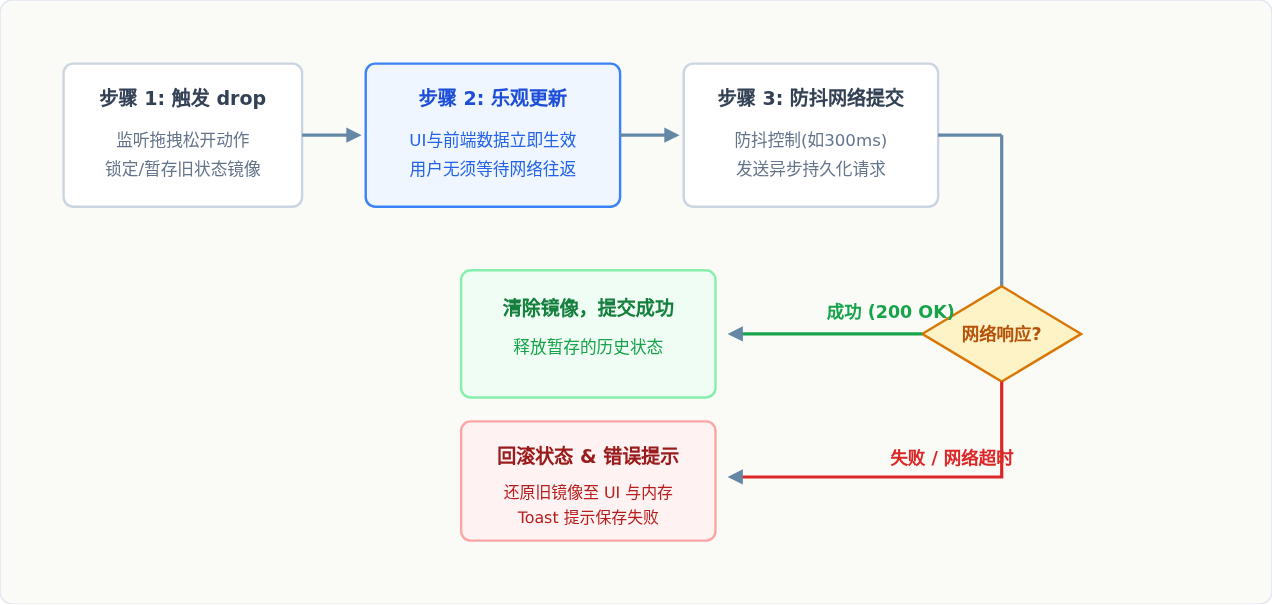
关键交互原则:
- 使用“乐观更新”(Optimistic Updates):不要等网络请求返回成功后再挪动 DOM。拖拽动作本身具有极强的即时物理反馈,用户松手时界面应瞬间就位,后台默默发送请求。
- 必须保留快照以供回滚:在触发更新前,深拷贝一份排序前的状态
const backupState = [...dataList]。一旦接口抛出 500 或网络断开,立即用备份数据还原 DOM 与内存状态,并弹出提示告知用户“保存失败已还原”。 - 利用防抖(Debounce)合并快速操作:如果用户在 2 秒内接连调整了多次顺序,只需以最后一次松手为准发送请求,大幅减轻服务端压力。
五、完整代码示例:原生 JS + Node.js 落地实现
下面提供一个完整、可独立运行的示例。前端采用原生 HTML5 Drag & Drop API 实现流畅拖拽与内存同步,后端使用 Node.js (Express) 演示事务性批量更新接口。
1. 前端实现:包含拖拽事件、数据重排与网络保存
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <style>
    .drag-list { list-style: none; padding: 0; width: 320px; }
    .drag-item {
      padding: 12px 16px;
      margin-bottom: 8px;
      background: #f8fafc;
      border: 1px solid #cbd5e1;
      border-radius: 6px;
      cursor: grab;
      user-select: none;
      transition: background 0.2s, transform 0.2s;
    }
    .drag-item.dragging {
      opacity: 0.5;
      background: #fef3c7;
      border: 1px dashed #d97706;
    }
    .drag-item.over {
      border-top: 2px solid #3b82f6;
    }
  </style>
</head>
<body>
  <ul id="list" class="drag-list"></ul>

  <script>
    // 1. 初始化数据模型
    let items = [
      { id: '101', name: '需求评审与分析' },
      { id: '102', name: 'UI原型与交互设计' },
      { id: '103', name: '前端拖拽组件联调' },
      { id: '104', name: '后端排序接口验证' }
    ];

    const listContainer = document.getElementById('list');
    let draggedElement = null;
    let originalIndex = -1;
    let backupItems = [];

    // 2. 渲染视图函数
    function render() {
      listContainer.innerHTML = '';
      items.forEach((item, index) => {
        const li = document.createElement('li');
        li.className = 'drag-item';
        li.draggable = true;
        li.dataset.id = item.id;
        li.dataset.index = index;
        li.textContent = `${index + 1}. ${item.name}`;

        // 绑定原生拖拽事件
        li.addEventListener('dragstart', handleDragStart);
        li.addEventListener('dragover', handleDragOver);
        li.addEventListener('dragleave', handleDragLeave);
        li.addEventListener('drop', handleDrop);
        li.addEventListener('dragend', handleDragEnd);

        listContainer.appendChild(li);
      });
    }

    function handleDragStart(e) {
      draggedElement = this;
      originalIndex = Number(this.dataset.index);
      this.classList.add('dragging');
      // 备份当前状态用于网络异常时回滚
      backupItems = JSON.parse(JSON.stringify(items));
      e.dataTransfer.effectAllowed = 'move';
    }

    function handleDragOver(e) {
      e.preventDefault();
      e.dataTransfer.dropEffect = 'move';
      this.classList.add('over');
    }

    function handleDragLeave() {
      this.classList.remove('over');
    }

    function handleDrop(e) {
      e.preventDefault();
      this.classList.remove('over');
      const targetIndex = Number(this.dataset.index);

      if (originalIndex === targetIndex || isNaN(targetIndex)) return;

      // 3. 内存数组同步重排
      const [movedItem] = items.splice(originalIndex, 1);
      items.splice(targetIndex, 0, movedItem);

      // 4. 乐观渲染更新视图
      render();

      // 5. 触发持久化保存
      saveOrderToBackend();
    }

    function handleDragEnd() {
      this.classList.remove('dragging');
      draggedElement = null;
    }

    // 6. 防抖提交至后端
    let saveTimer = null;
    function saveOrderToBackend() {
      clearTimeout(saveTimer);
      saveTimer = setTimeout(async () => {
        // 构造有序的 ID 数组
        const orderedIds = items.map(item => item.id);

        try {
          const res = await fetch('/api/tasks/reorder', {
            method: 'POST',
            headers: { 'Content-Type': 'application/json' },
            body: JSON.stringify({ orderedIds })
          });

          if (!res.ok) throw new Error('网络请求异常');
          console.log('✅ 排序保存成功');
        } catch (err) {
          console.error('❌ 保存失败,正在执行回滚:', err);
          // 回滚至拖拽前的备份状态
          items = backupItems;
          render();
          alert('网络异常,排序无法保存,已恢复至变动前状态。');
        }
      }, 300);
    }

    render();
  </script>
</body>
</html>
2. 后端实现:接收有序 ID 并批量持久化
// server.js (Node.js + Express 示例)
const express = require('express');
const app = express();
app.use(express.json());

// 模拟数据库表连接 pool.query
app.post('/api/tasks/reorder', async (req, res) => {
  const { orderedIds } = req.body;

  if (!Array.isArray(orderedIds) || orderedIds.length === 0) {
    return res.status(400).json({ error: '参数错误:必须提供有序的 ID 列表' });
  }

  /*
   * 采用 SQL CASE 语句单次执行批量更新:
   * UPDATE tasks
   * SET sort_order = CASE id
   *   WHEN '101' THEN 1
   *   WHEN '103' THEN 2
   *   WHEN '102' THEN 3
   * END
   * WHERE id IN ('101', '103', '102');
   */
  try {
    const cases = orderedIds.map((id, index) => `WHEN ? THEN ${index + 1}`).join(' ');
    const placeholders = orderedIds.map(() => '?').join(',');

    const sql = `
      UPDATE tasks
      SET sort_order = CASE id ${cases} END
      WHERE id IN (${placeholders})
    `;

    // 将 orderedIds 传入两次以满足 CASE 与 WHERE 条件
    const queryParams = [...orderedIds, ...orderedIds];

    // 假设在数据库事务中执行: await db.query(sql, queryParams);
    console.log('批量执行 SQL 更新成功,受影响行数:', orderedIds.length);

    res.json({ success: true, count: orderedIds.length });
  } catch (error) {
    console.error('更新排序失败:', error);
    res.status(500).json({ error: '数据库更新失败' });
  }
});

app.listen(3000, () => console.log('服务已启动在 3000 端口'));
六、核心决策与实战总结
为了在实际开发中快速做出最适合当前业务的选型,下表归纳了不同业务规模下的架构决策依据:
| 业务场景 | 推荐方案 | 前端交互模式 | 后端落库实现 |
|---|---|---|---|
| 后台管理表单配置、个人看板(列表 < 100 项) | 全量连续整数 | 拖拽后防抖自动保存,或挂载显式的“保存排序”按钮 | 全量接收 ID 数组,CASE WHEN 批量更新 |
| 高并发协作文档、看板卡片(列表 100 ~ 5,000 项) | 浮点数/分式间隔法 | 乐观更新 + 仅提交 { id, prev_order, next_order } |
单条记录更新计算均值,定时任务执行重平衡 |
| 海量无限滚动数据列表(列表 > 10,000 项) | 分组/分块间隔法 | 局部索引计算,分屏懒加载 | 父级分区下独立计数,隔离更新影响范围 |
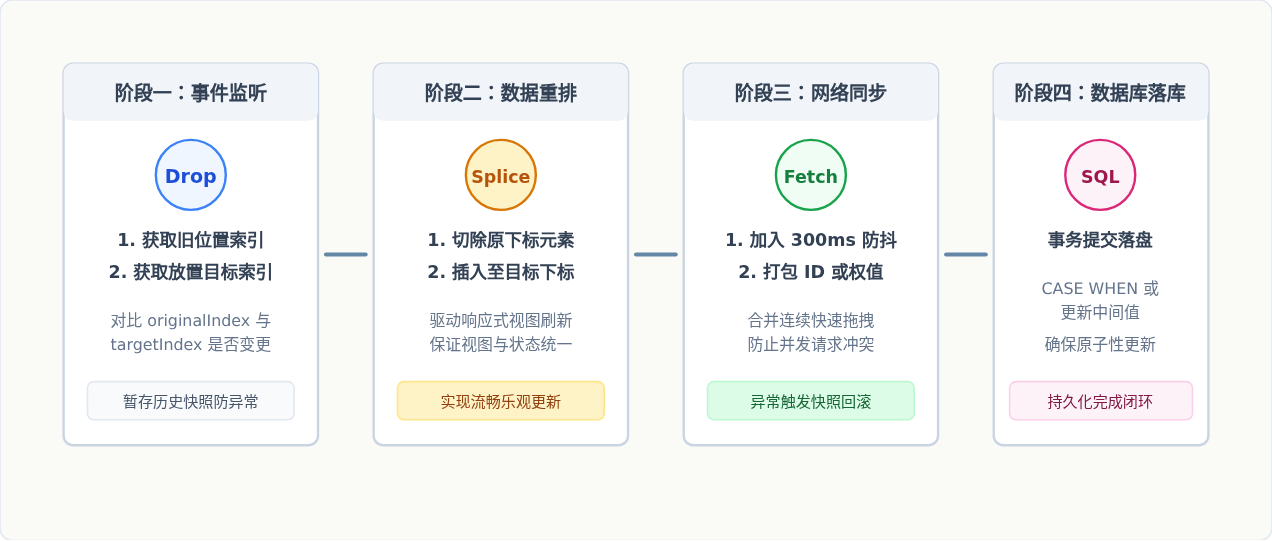
总结而言,在前端使用 JavaScript 处理拖拽排序,“界面展示”、“内存数据”与“服务端存储”必须形成严密的状态闭环。通过在 drop 时刻精准计算下标并使用 splice 维护内存数据,再配合带防抖与错误回滚的异步请求,便能实现既让用户感觉顺畅敏捷、又保证数据绝对一致的拖拽排序体验。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章