
深入解析JavaScript中数组indexOf方法的语法规范、执行机制、fromIndex检索起点、严格全等比较规则与常见边界特例,提供实用的查找与去重代码示例及方法选型建议。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组indexOf方法:根据值获取元素下标
作者:拾光
时间:2026-11-06
浏览:165
文章目录
JavaScript 教程
Array 原生方法
严格全等比对
ECMAScript 规范标准
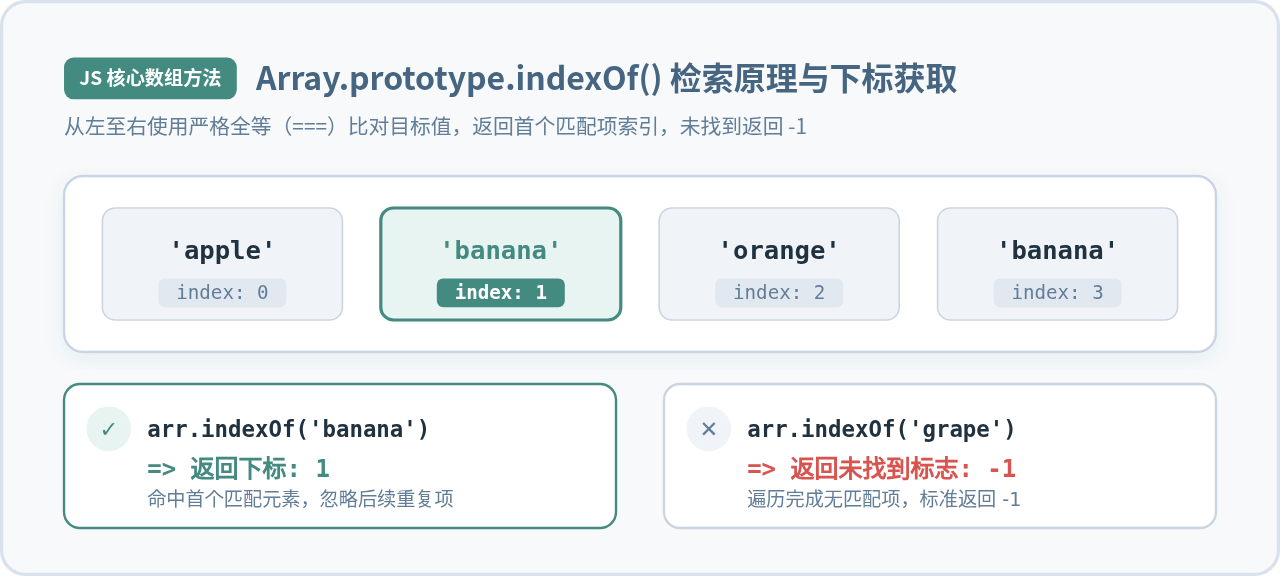
图 0:Array.prototype.indexOf 检索元素并返回下标的直观示意
在 JavaScript 开发中,若需要根据一个具体的元素值查明其在数组中的索引位置,最基础且高效的原生手段是使用 Array.prototype.indexOf()。该方法从数组的起始位置(或指定的偏移量)开始依次向后遍历,使用严格全等(===)比对每个元素;一旦匹配成功便立即返回该元素的第一个下标,若遍历完全部元素仍未找到则返回 -1。
一、indexOf 核心语法与参数定义
indexOf() 是定义在 Array.prototype 上的实例方法。标准语法格式如下:
const index = arr.indexOf(searchElement[, fromIndex]);该方法接受两个参数,其中第二个参数为可选参数:
-
searchElement(必需):要查找的目标元素。该值可以是任何数据类型(字符串、数字、布尔、对象、函数等)。 -
fromIndex(可选):开始查找的起始索引下标。默认为0,即从数组首项开始检索。支持传入正整数或负整数。
关于返回值,indexOf 的规则非常纯粹:
- 命中:返回目标值在数组中首次出现的数字下标(索引从
0开始)。 - 未命中:如果数组中不存在与
searchElement严格全等的元素,统一返回-1。
以下为最直接的代码示例:
const frameworks = ['Vue', 'React', 'Angular', 'Svelte'];

// 示例 1:成功命中首个匹配元素
const reactIndex = frameworks.indexOf('React');
console.log(reactIndex); // 示例输出: 1

// 示例 2:目标值在数组中不存在
const solidIndex = frameworks.indexOf('Solid');
console.log(solidIndex); // 示例输出: -1
二、indexOf 底层执行流程与检索机制
理解 indexOf 的底层执行时序,有助于在处理复杂数组时写出无歧义的代码。根据 ECMAScript 规范定义,indexOf 的运行可以分为参数规整、越界校验、循环遍历与短路返回四个连续阶段。
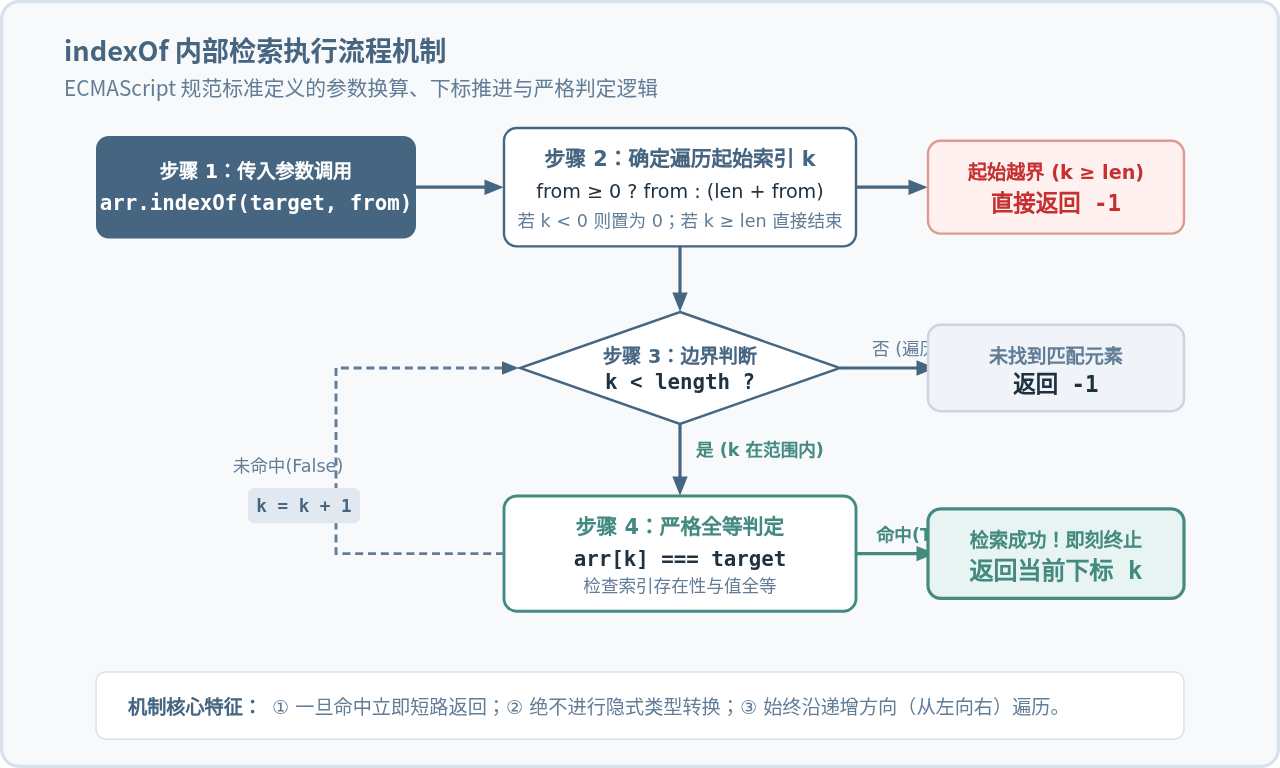
图 1:Array.prototype.indexOf 内部底层执行与判定流程图
具体执行步骤如下:
-
转换为对象并获取数组长度:引擎首先读取调用数组的
length属性,并将其转换为非负整数。若数组长度为0,直接返回-1。 -
计算实际扫描起始位置
k:- 如果未传
fromIndex,则k = 0。 - 如果
fromIndex >= 0,则k = fromIndex。若此时k >= length,说明搜索起点已超出数组右边界,引擎不执行任何遍历,立即返回-1。 - 如果
fromIndex < 0,则k = length + fromIndex。若计算出的k依然小于0,引擎会强制将k修正为0。
- 如果未传
-
循环迭代与严格匹配:指针
k从起始位置开始向右推进(k < length)。在每一次迭代中,引擎先确认数组下标k是否实际存在(检查稀疏数组空槽),随后执行严格全等比较arr[k] === searchElement。 -
短路退出:一旦全等条件为
true,算法立刻终止循环并返回当前下标k;若遍历到达数组末尾仍无匹配,则返回-1。
三、fromIndex 检索起点与偏移规则
很多开发者在需要跳过特定位置或二次定位重复元素时会使用 fromIndex,但对负数偏移和边界行为容易产生误解。关键在于:无论 fromIndex 是正是负,遍历的推进方向始终是从左至右(即下标递增),绝对不会逆向往前搜索。
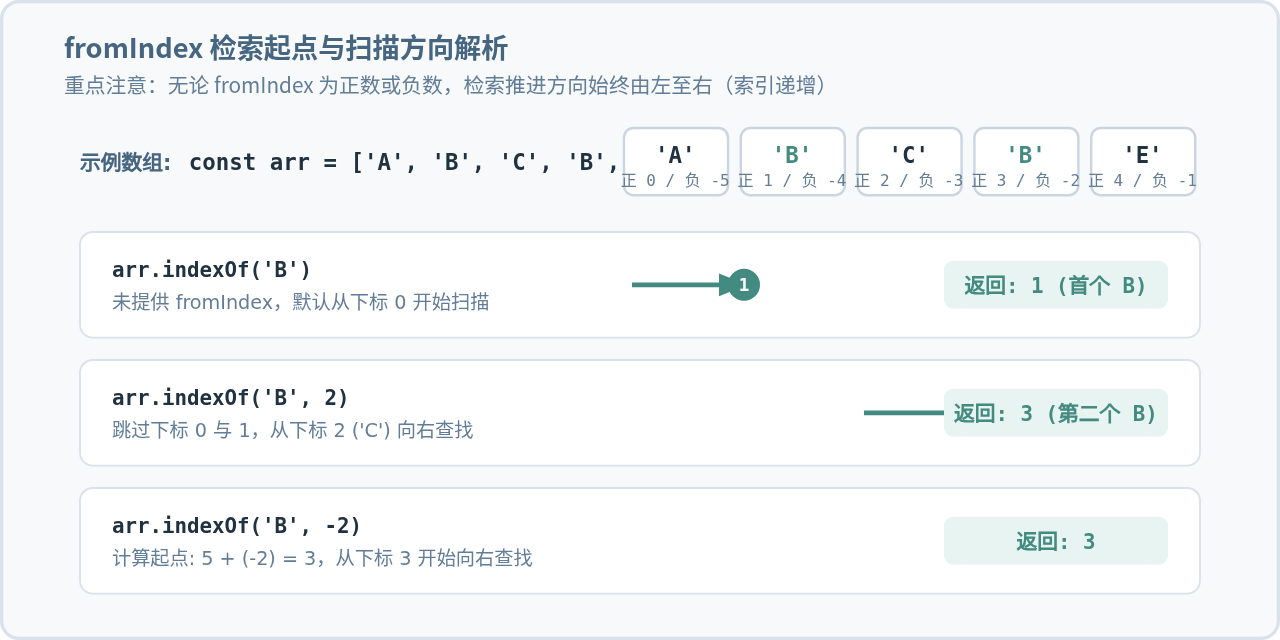
图 2:fromIndex 在正数、负数及默认场景下的检索起点计算与扫描方向
1. 正数索引与跳过匹配
当传入正数 fromIndex 时,数组将直接从该下标开始向后扫描,位于该下标之前的元素将被全部忽略。
const letters = ['A', 'B', 'C', 'B', 'E'];

// 从索引 0 开始找 'B',命中首个
console.log(letters.indexOf('B'));    // 示例输出: 1

// 从索引 2 开始向后找 'B',跳过了下标 1
console.log(letters.indexOf('B', 2)); // 示例输出: 3
2. 负数索引的偏移计算
当传入负数时,偏移量表示从数组末尾倒数计算起始位置,计算公式为 实际起点 = length + fromIndex。以长度为 5 的数组为例:
letters.indexOf('B', -2):实际起点为5 + (-2) = 3,引擎从下标3开始向后检索,直接在下标3命中'B'。letters.indexOf('B', -1):实际起点为5 + (-1) = 4,引擎从下标4(即元素'E')开始向后检索,未找到匹配项,返回-1。它不会倒回去查看下标1或3。
注意防范误区:如果需要“从后向前”逆向搜索元素,请使用原生方法
Array.prototype.lastIndexOf(),而非向 indexOf 传入负数。
四、严格全等(===)与常见边界特例
indexOf 内部执行的是标准规范中的“严格相等比对”(Strict Equality Comparison)。这意味着它不会进行任何隐式类型转换,同时保留了 JavaScript 在全等机制下的固有特例。
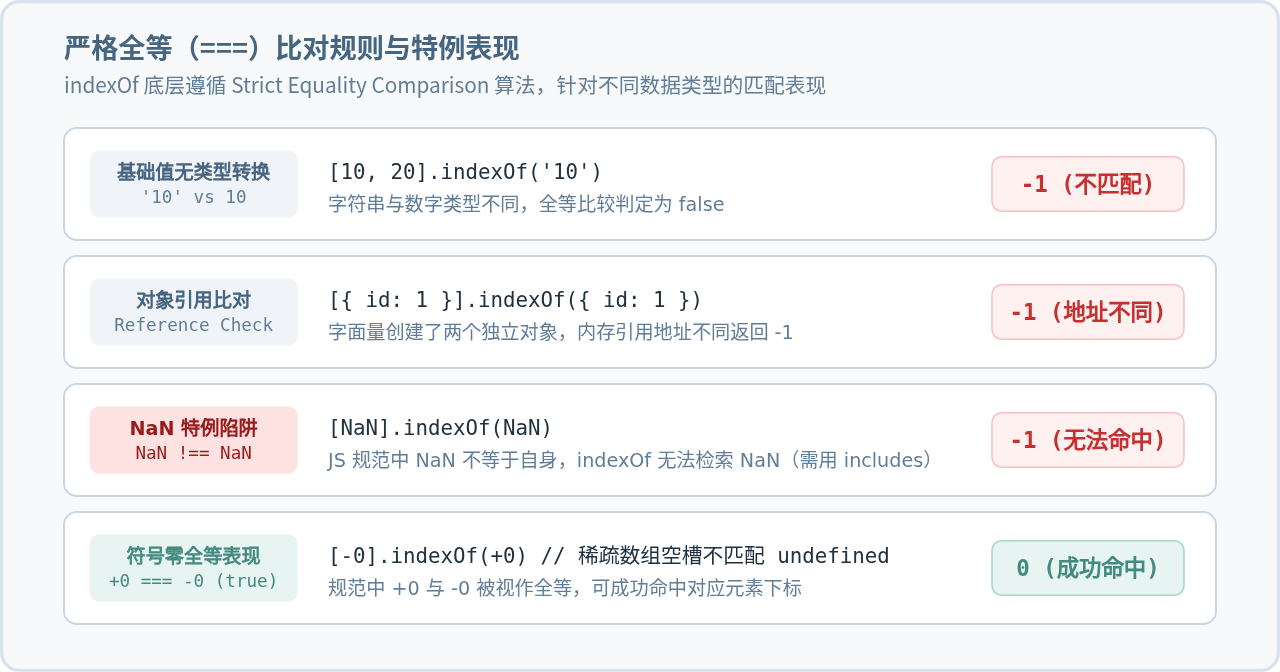
图 3:严格全等比对算法下常见数据类型的匹配与陷阱分析
1. 不会发生隐式类型转换
数字 10 与字符串 '10' 属于不同数据类型,全等比对恒为 false。
const scores = [10, 20, 30];
console.log(scores.indexOf('10')); // 示例输出: -1 (类型不一致)
console.log(scores.indexOf(10));   // 示例输出: 0
2. 引用类型的地址校验
对于对象、数组或函数等引用类型,只有两个变量指向同一个内存地址时,严格全等才成立。字面量创建的对象即使键值完全相同,也是两个互不相等的独立实例。
const users = [{ id: 1, name: 'Alice' }];

// 传入新的对象字面量,内存地址不同
console.log(users.indexOf({ id: 1, name: 'Alice' })); // 示例输出: -1

// 只有引用指向同一对象才能匹配
const bob = { id: 2, name: 'Bob' };
const list = [bob];
console.log(list.indexOf(bob)); // 示例输出: 0
3. NaN 特例陷阱
在 JavaScript 语言特性中,NaN === NaN 的结果为 false。因此,indexOf 永远无法查找到数组中的 NaN。
const arr = [1, NaN, 3];
console.log(arr.indexOf(NaN)); // 示例输出: -1 (无法通过 indexOf 检索)

// 正确检测 NaN 的现代方案:
console.log(arr.includes(NaN)); // 示例输出: true (includes 支持 NaN)
console.log(arr.findIndex(Number.isNaN)); // 示例输出: 1 (获取下标)
4. +0 与 -0 及稀疏数组空槽
在 ECMAScript 规范中,严格全等将 +0 与 -0 判定为相等。因此 [-0].indexOf(+0) 会返回下标 0。
此外,若数组中包含未赋值的空槽(Sparse Array),空槽并不是 undefined 值,indexOf(undefined) 不会命中空槽:
const sparse = [1, , 3]; // 索引 1 为空槽 (empty slot)
console.log(sparse.indexOf(undefined)); // 示例输出: -1 (空槽非实际 undefined)
五、高频实用开发场景与模式
场景 1:判断元素是否存在
在 ES2016 引入 includes 之前,indexOf 是判断数组是否包含某项的标准做法。常见的判断条件是与 -1 做对比:
const roles = ['admin', 'editor', 'viewer'];

// 规范写法:明确判断下标是否大于等于 0 或不等于 -1
const canEdit = roles.indexOf('editor') !== -1;
console.log(canEdit); // 示例输出: true

// 提示:不要直接使用 if (roles.indexOf('admin'))
// 因为 'admin' 下标为 0,在条件表达式中 0 会被隐式转换为 false,导致严重逻辑缺陷!
场景 2:找出元素出现的所有下标
由于 indexOf 仅返回首次命中的下标,若要收集重复元素在数组中的全部索引,可以结合 while 循环并在每次命中后将 fromIndex 递增 1:
function findAllIndices(arr, target) {
  const indices = [];
  let startIndex = 0;

  while ((startIndex = arr.indexOf(target, startIndex)) !== -1) {
    indices.push(startIndex);
    startIndex++; // 推进检索起点,防止陷入死循环
  }

  return indices;
}

const data = ['x', 'y', 'x', 'z', 'x'];
console.log(findAllIndices(data, 'x')); // 示例输出: [0, 2, 4]
场景 3:基础数组去重(与 filter 配合)
利用 indexOf 总是返回首个匹配下标的特性,当遍历到的元素下标等于 indexOf 返回的下标时,说明该项是第一次出现;否则为重复项。
const rawList = [1, 2, 3, 2, 1, 4];
const uniqueList = rawList.filter((item, index) => rawList.indexOf(item) === index);
console.log(uniqueList); // 示例输出: [1, 2, 3, 4]
性能说明:该去重方法时间复杂度为 O(n²),适合小型数组。在处理上万级大数据量时,建议优先使用 new Set(rawList),时间复杂度为 O(n)。
六、横向对比与技术选型决策
现代 JavaScript 原生提供了多种数组查找方法。在日常开发中,应根据检索目标类型、匹配逻辑复杂度及返回值期望进行合理选型。
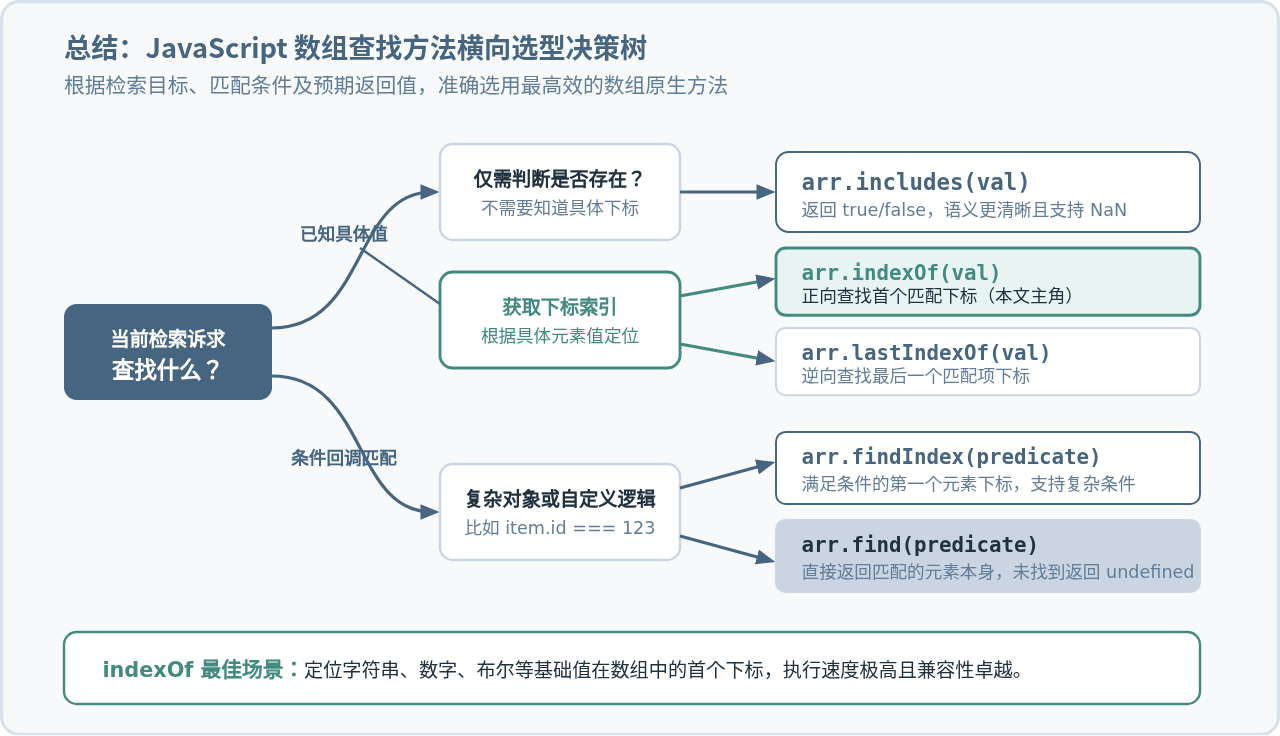
图 4:JavaScript 原生数组查找与定位方法选型决策树
| 方法名称 | 参数形式 | 返回值类型 | 检索方向 | 能否检索 NaN | 核心适用场景 |
|---|---|---|---|---|---|
| indexOf | (val, fromIndex) |
number (索引或 -1) |
正向 (0 → len) | 不能 | 获取简单基础值(字符串、数值)的首次出现下标 |
| lastIndexOf | (val, fromIndex) |
number (索引或 -1) |
逆向 (len → 0) | 不能 | 获取简单基础值的最后一次出现下标 |
| includes | (val, fromIndex) |
boolean |
正向 (0 → len) | 能 | 仅需要判断元素是否存在,代码语义更明确 |
| findIndex | (predicateFn) |
number (索引或 -1) |
正向 (0 → len) | 能 | 根据对象属性或自定义条件查找目标元素下标 |
| find | (predicateFn) |
元素本身 或 undefined |
正向 (0 → len) | 能 | 直接提取符合复杂条件的对象本身 |
七、总结与最佳实践准则
Array.prototype.indexOf 作为 JavaScript 标准库中最经典的数组查找工具,其优势在于执行速度极高、内存开销极低、且完全兼容所有浏览器与运行时环境。掌握以下核心准则即可在工程开发中避免常见陷阱:
- 查基础值首项下标用
indexOf:对于数字、字符串等原始类型,定位首个出现位置是其最标准用法。 - 条件检查务必比对
!== -1:切忌直接将indexOf结果放入if判定中,避免0下标被误判为假值。 - 跨类型与对象谨慎使用:
indexOf不发生隐式类型转换,且依赖内存引用比对。查找对象数组项时,果断选用findIndex。 - 识别 NaN 须转用其它方法:由于严格全等限制,涉及
NaN查找时,若需布尔值请用includes(),若需下标请用findIndex(Number.isNaN)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章