
深入解析 JavaScript 中判断数组是否包含某值的两种核心方法:Array.prototype.includes 与 Array.prototype.indexOf。从返回值类型、隐式转换陷阱、SameValueZero 比对算法、NaN 与稀疏数组处理、以及工程选型决策等维度全面对比。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS判断数组是否包含某值:includes与indexOf的区别
作者:代码拾荒
时间:2026-11-05
浏览:136
文章目录
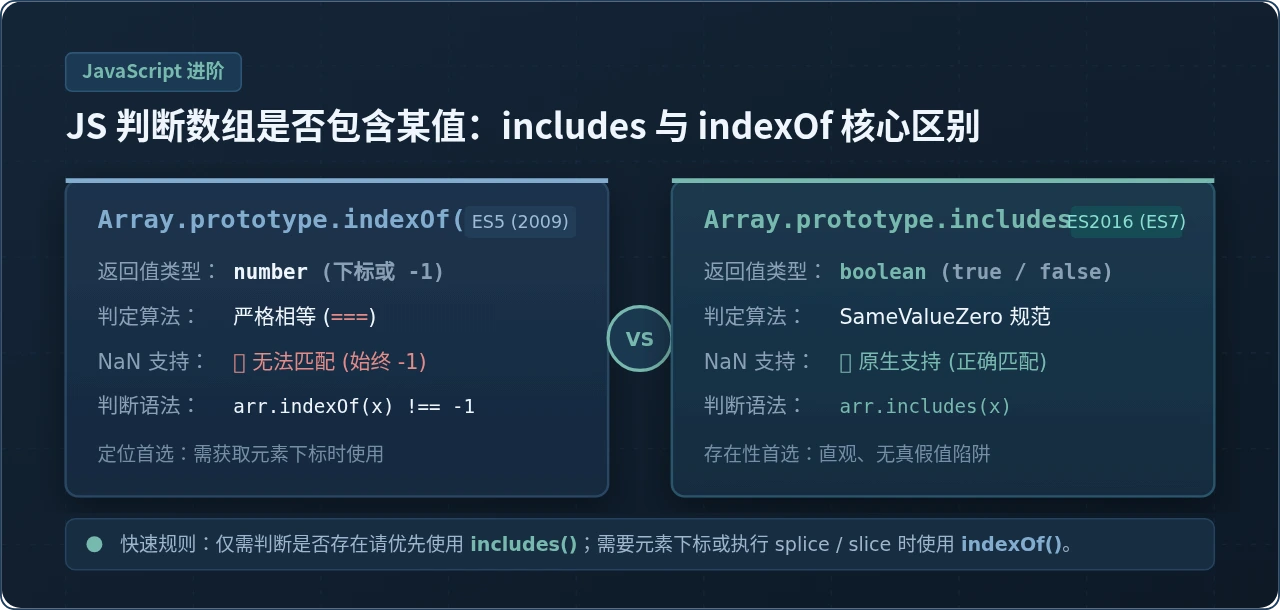
假设在一个后台权限管理或标签过滤模块中,系统维护着一组角色标识 const roles = ['admin', 'editor', 'viewer'];。当需要验证当前用户是否具有 'admin' 权限时,若开发者随手写出 if (roles.indexOf('admin')),系统往往会出现逻辑异常——因为 'admin' 恰好位于数组的第一个位置(索引 0),而在 JavaScript 的条件表达式中,数字 0 会被隐式转换为假值 false。为消除这类因返回值类型与语义脱节而造成的隐患,ECMAScript 在 ES2016(ES7)规范中正式引入了 Array.prototype.includes。
本文将围绕“判断数组是否包含某值”这一核心问题,系统拆解 includes 与 indexOf 在返回值设计、条件判断写法、比对算法(SameValueZero 与严格相等)、特殊值(如 NaN、稀疏数组空位)处理等维度的深层区别,并给出清晰明确的代码选型依据。
一、核心认知:两个方法的设计初衷与语法差异
虽然 indexOf 与 includes 都可以用于检测某个元素是否在数组内,但两者的 API 设计目的完全不同:indexOf 的目标是定位元素的具体下标,而 includes 的目标是断言元素的存在性。
// 方法基本签名
arr.indexOf(searchElement[, fromIndex])
arr.includes(searchElement[, fromIndex])两者的第一重差异直接体现在返回值类型上:
indexOf()返回元素在数组中首次出现的索引(0到arr.length - 1的整数)。若未找到,则返回-1。includes()直接返回一个布尔值(true或false),精准表达“包含”或“不包含”。
二、使用 indexOf 判断存在性的两大典型隐患
在 includes 普及之前,开发者只能依赖 indexOf 来做存在性检测。然而,这种依赖下标的方式在实际编码中极易诱发两类典型 Bug。
1. 索引 0 导致的假值陷阱
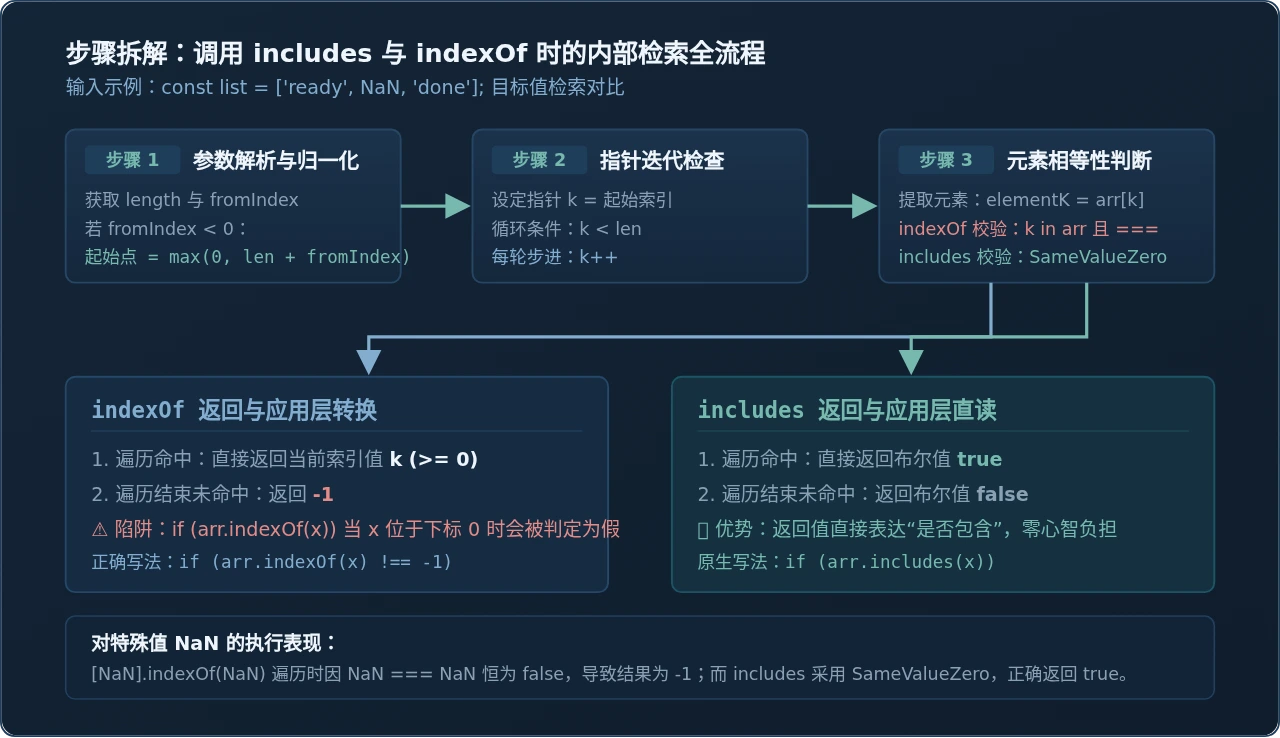
数字 0 在 JavaScript 中属于假值(falsy),而 -1 以及任意正整数属于真值(truthy)。直接将 indexOf 的结果放入条件分支中,会产生极其隐蔽的逻辑倒置:
const list = ['apple', 'banana', 'orange'];

// 错误示范:误将下标当成布尔值判断
if (list.indexOf('apple')) {
  console.log('找到了苹果');
} else {
  console.log('未找到苹果'); // 示例输出:实际会打印这行!因为 list.indexOf('apple') 为 0
}

// 错误示范 2:未命中时返回 -1
if (list.indexOf('grape')) {
  console.log('找到了葡萄'); // 示例输出:实际会打印这行!因为 -1 在 if 中是 truthy
}
⚠️ 注意规避写法错误
若必须使用 indexOf 判断元素是否存在,务必显式与 -1 比对:arr.indexOf(item) !== -1 或 arr.indexOf(item) > -1。早年部分项目使用按位非运算符 ~arr.indexOf(item),但代码可读性较差,现代开发中不推荐使用。
2. 无法识别特殊数值 NaN
在数据清洗、图表计算或解析用户输入的场景中,数组可能包含 NaN(Not-a-Number)。indexOf 底层采用严格相等(===)进行元素比对。根据 IEEE 754 浮点数规范,NaN === NaN 的结果恒为 false,导致 indexOf 永远无法查找到 NaN:
const numbers = [10, NaN, 20];

// 示例输出:indexOf 无法匹配 NaN
console.log(numbers.indexOf(NaN)); // 输出: -1

// 示例输出:includes 能正确识别 NaN
console.log(numbers.includes(NaN)); // 输出: true
三、底层算法对比:严格相等 (===) 与 SameValueZero
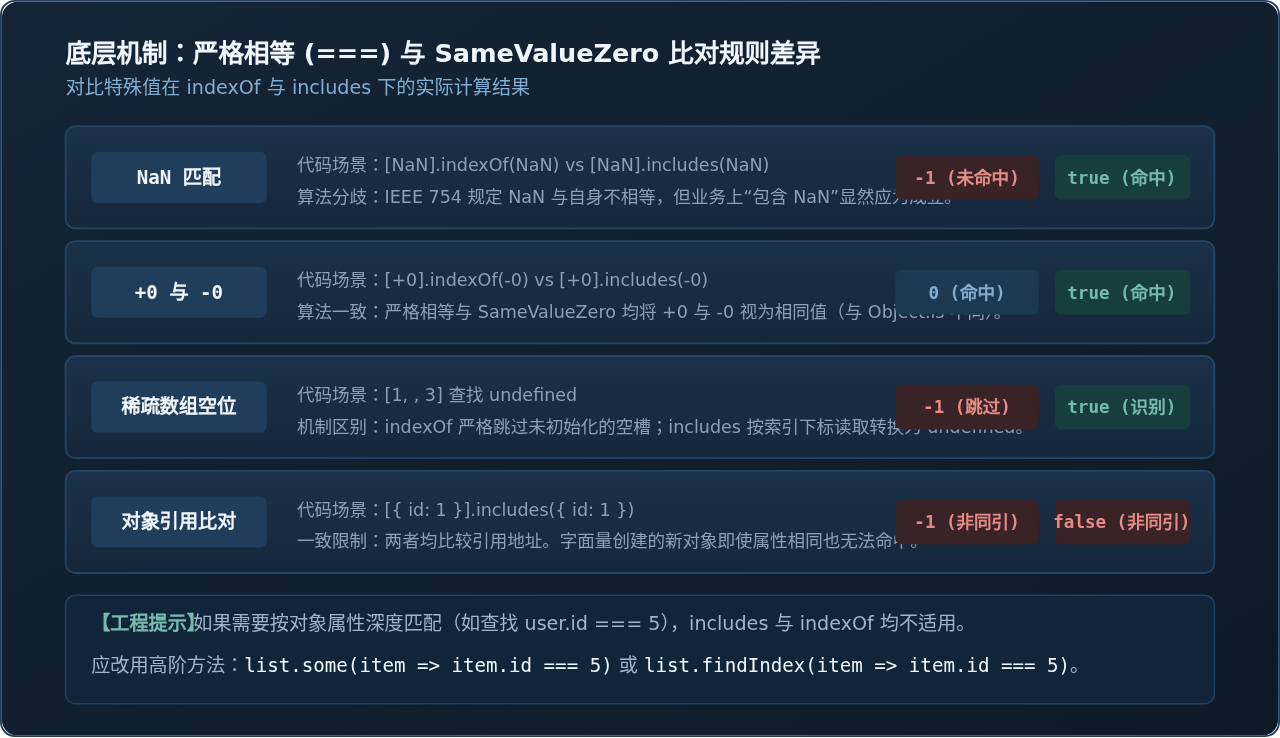
要透彻理解两者的差异,必须深入 ECMAScript 规范中对两者的比对算法定义。indexOf 采用的是 IsStrictlyEqual(即严格相等 ===),而 includes 采用的是 SameValueZero(零值相等算法)。
1. SameValueZero 规则解析
SameValueZero 算法的比较逻辑如下:
- 如果两个值的类型不同,返回
false。 - 如果两个值均为
Number类型:- 若两者都是
NaN,返回true。 - 若一个是
+0另一个是-0,返回true。 - 其余数值相同返回
true,不同返回false。
- 若两者都是
- 其余类型比较内存引用或基本类型值。
这意味着 includes 在处理数值时,既修复了 NaN 无法自反匹配的缺陷,又兼顾了日常开发中把 +0 与 -0 当作同一数值的习惯(与 Object.is 会区分 +0 和 -0 不同)。
2. 稀疏数组(Sparse Array)空槽处理差异
稀疏数组是指数组中存在未分配属性的“空洞”(例如 [1, , 3])。在检索 undefined 时,两者的表现截然不同:
const sparse = [1, , 3]; // 索引 1 处为空位(hole)

// indexOf 在循环时会检查索引属性是否存在(k in arr)
// 空位不属于自身属性,因此直接跳过,返回 -1
console.log(sparse.indexOf(undefined)); // 示例输出: -1

// includes 遍历时通过下标访问元素 arr[k],空位取值为 undefined
// 随后比对 SameValueZero(undefined, undefined) 命中,返回 true
console.log(sparse.includes(undefined)); // 示例输出: true
四、第二参数 fromIndex 的计算规则与边界
indexOf 与 includes 均接受可选的第二参数 fromIndex,表示从哪个数组下标开始向后搜索。默认值为 0。两者在处理负数和越界时的逻辑保持一致:
const tags = ['css', 'html', 'js', 'ts'];

// 1. 正数索引:从指定位置向后检索
console.log(tags.includes('css', 1)); // 示例输出: false (从下标 1 即 'html' 开始找)
console.log(tags.indexOf('js', 2));   // 示例输出: 2

// 2. 负数索引:倒数位置计算 (arr.length + fromIndex)
// 数组长度为 4,fromIndex 为 -2,起始下标 = 4 + (-2) = 2
console.log(tags.includes('html', -2)); // 示例输出: false ('html' 在索引 1,已错过)
console.log(tags.includes('ts', -2));   // 示例输出: true ('ts' 在索引 3,处于范围内)

// 3. 负数绝对值超过数组长度:重置为 0,检索整个数组
console.log(tags.includes('css', -100)); // 示例输出: true
五、工程实践:场景选型决策树与常见误区
在现代前端与 Node.js 开发中,面对不同的数组检索需求,应当建立清晰、统一的代码选型习惯。
1. 选用原则一览
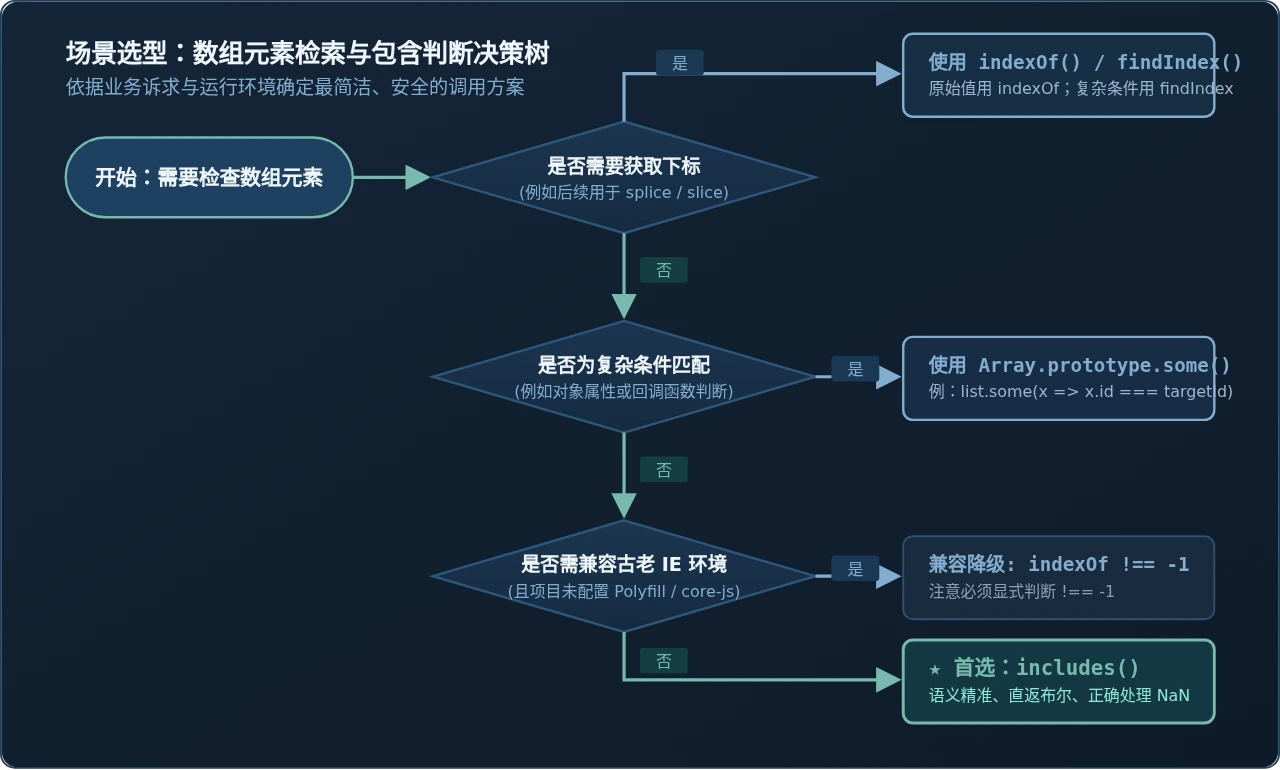
- 仅判断“是否存在”:首选
includes()。语义直接、返回布尔类型,避免0下标隐式转换风险,代码表现力最佳。 - 需要“元素下标”或执行后续切片/删除:使用
indexOf()。例如const idx = list.indexOf(id); if (idx !== -1) list.splice(idx, 1);。 - 包含复杂对象或需自定义匹配条件:使用
some()或findIndex()。
2. 高频踩坑:对象引用的查找
无论是 includes 还是 indexOf,在比对引用类型(Object、Array、Function 等)时,比较的都是内存引用地址,而非深层对象属性值:
const users = [{ id: 1, name: 'Alice' }, { id: 2, name: 'Bob' }];

// 常见错误:试图通过字面量对象判断
console.log(users.includes({ id: 1, name: 'Alice' })); // 示例输出: false
console.log(users.indexOf({ id: 1, name: 'Alice' }));  // 示例输出: -1

// 正确方案:对象数组判断存在性使用 some()
const hasUser = users.some(u => u.id === 1);
console.log(hasUser); // 示例输出: true

// 正确方案:对象数组获取下标使用 findIndex()
const userIdx = users.findIndex(u => u.id === 1);
console.log(userIdx); // 示例输出: 0
六、全维度特性总结
下表归纳了 includes 与 indexOf 在核心维度上的全部异同点,便于快速查阅与团队代码规范审查:
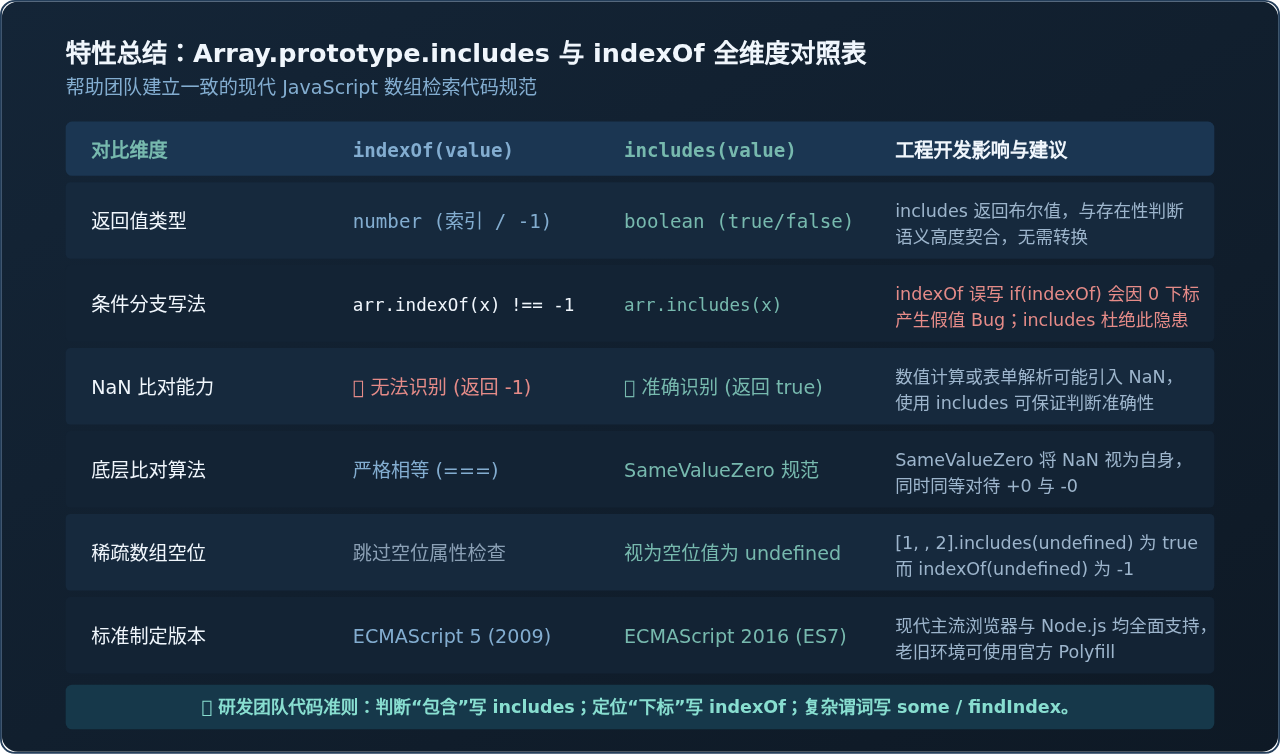
| 比较维度 | indexOf() | includes() | 实际影响与建议 |
|---|---|---|---|
| 标准规范 | ECMAScript 5 (2009) | ECMAScript 2016 (ES7) | 现代主流浏览器及 Node.js 均已全面原生支持 |
| 返回值类型 | number(下标索引或 -1) |
boolean(true 或 false) |
includes 专为存在性设计,语义更清晰 |
| 条件判断写法 | 必须写 arr.indexOf(x) !== -1 |
直接写 arr.includes(x) |
indexOf 易发生 0 下标隐式假值错误 |
| NaN 检索能力 | 不支持 (-1) | 支持 (true) | 数组可能包含非数值或计算异常时必须用 includes |
| 底层比对算法 | 严格相等(===) |
SameValueZero | SameValueZero 把 NaN 视作自身匹配 |
| 稀疏数组空槽 | 跳过空槽,查找 undefined 为 -1 |
空槽按 undefined 匹配,返回 true |
includes 在稀疏数组遍历时保持下标取值一致性 |
| 适用场景 | 需要利用下标做切片、替换或删除 | 单纯需要判断某项是否存在于列表中 | 职责分离,团队协作中统一选型可大幅降低认知成本 |
💡 现代 JavaScript 工程建议
在判断数组是否包含特定原始值时,统一以 Array.prototype.includes 作为第一选择;只有在后续逻辑确实需要使用下标进行 splice 或位置换算时,才显式调用 indexOf,并在判断时严格书写 !== -1。保持这一编码习惯,可以从根源上杜绝由于索引 0 假值转换以及 NaN 比对失效带来的潜在隐患。
© 本文采用原生 ES 规范解析,适用于现代 Web 及 Node.js 运行环境。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章