
本文详细介绍在 JavaScript 中利用正则表达式实现驼峰命名(camelCase)与连字符格式(kebab-case)双向互换的高效方案,涵盖基础实现、边界场景处理、原理流程图解及高性能工具函数封装。

当前位置:首页 > JavaScript 基础 > 正文
JS实现驼峰命名与连字符格式的正则互换替换
作者:代码拾荒
时间:2026-11-03
浏览:400
文章目录
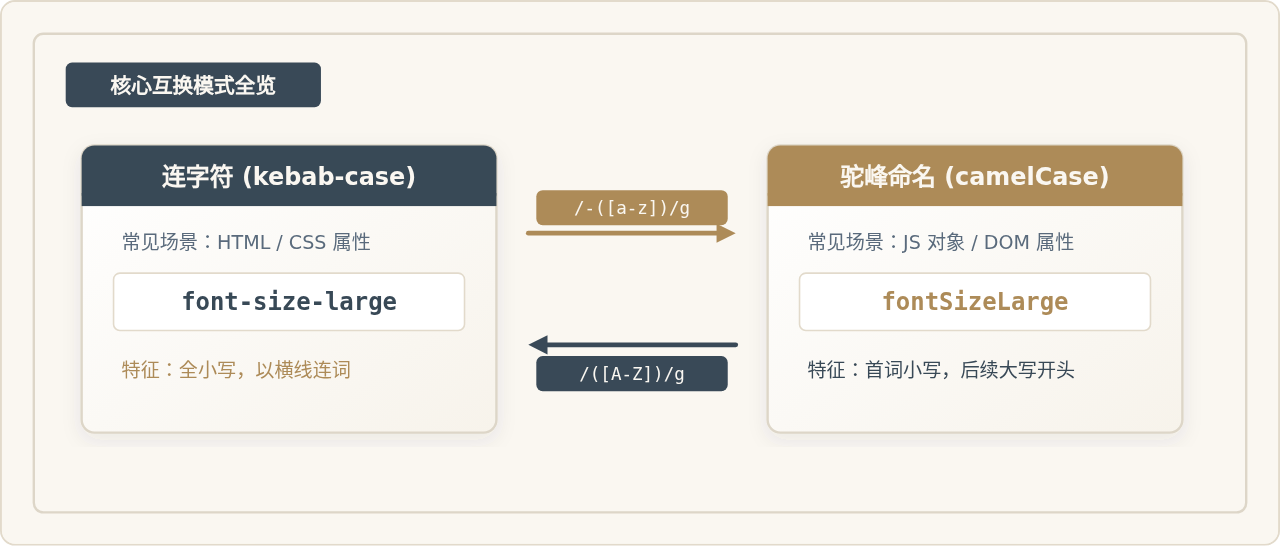
在 JavaScript 前端与全栈开发中,连字符格式(kebab-case)与驼峰命名(camelCase)的互换属于高频基础需求。两者的转换核心在于利用 String.prototype.replace() 配合捕获组正则表达式与替换回调函数,分别通过“消除连字符并将后随字母大写”和“匹配大写字母并在其前方插入连字符与小写化”来实现。
一、连字符转驼峰(kebab-case 转 camelCase)
连字符命名的特点是用中划线(-)作为词与词之间的分隔符。将其转换为小驼峰格式的目标是:消除连字符,并将紧随其后的首个英文字母转换为大写。
1. 核心正则与替换实现
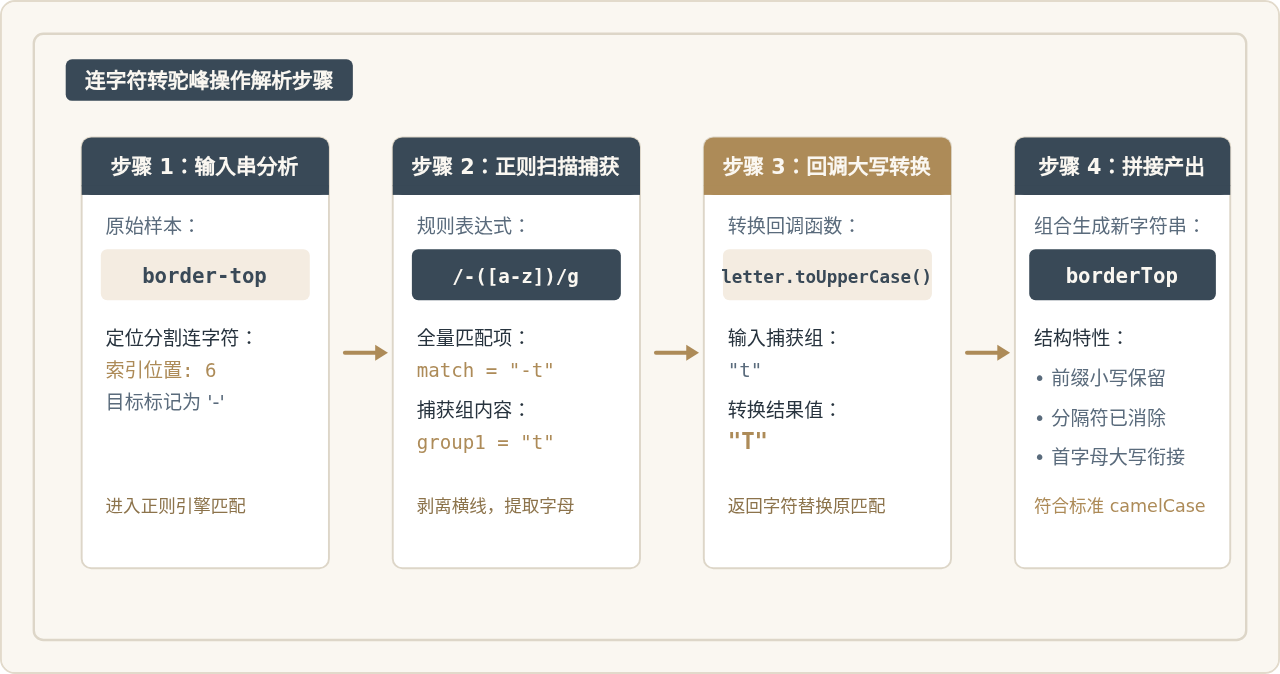
通过正则表达式 /-([a-z])/g 即可完成匹配。其中 - 匹配字面量短横线,([a-z]) 是一个捕获组,用于提取连字符后的第一个英文字母,全局修饰符 g 确保替换字符串中出现的全部目标。
/**
 * 连字符转驼峰命名
 * @param {string} str 输入的连字符字符串,如 "font-size"
 * @returns {string} 转换后的驼峰字符串,如 "fontSize"
 */
function kebabToCamel(str) {
  if (typeof str !== 'string' || !str) return '';
  return str.replace(/-([a-z])/g, (match, letter) => {
    return letter.toUpperCase();
  });
}

// 示例验证
console.log(kebabToCamel('background-color')); // 输出: "backgroundColor"
console.log(kebabToCamel('border-top-width'));   // 输出: "borderTopWidth"
console.log(kebabToCamel('user-profile-id'));    // 输出: "userProfileId"
在调用 replace 时,第二个参数传入回调函数。回调函数的第一个参数是完整匹配项(如 "-s"),第二个参数即捕获组匹配项(如 "s")。直接返回 letter.toUpperCase() 便同时完成了“剔除横线”与“转为大写”。
特殊场景考量:CSS 厂商前缀(如 -webkit-、-moz-)
在浏览器 CSS 样式对象中,-webkit-transform 对应的 DOM 属性往往是大驼峰 WebkitTransform,而 -ms-transform 则是小驼峰 msTransform。如果直接使用 str.replace(/-([a-z])/g, ...) 处理 -webkit-transform,开头的 -w 也会被转为大写,得到 WebkitTransform,这恰好满足大部分厂商属性规范;但若需要强行保证首字符小写,可在函数结尾附加首字符小写修正。
二、驼峰转连字符(camelCase 转 kebab-case)
驼峰命名转连字符格式的逻辑正好相反:找到所有大写字母,在其前方补上连字符(-),并将该字母转换为小写。
1. 基础正则实现
最直接的做法是匹配每一个大写字母 /[A-Z]/g:
/**
 * 基础驼峰转连字符
 * @param {string} str 输入的驼峰命名
 * @returns {string} 转换后的连字符格式
 */
function camelToKebab(str) {
  if (typeof str !== 'string' || !str) return '';
  return str.replace(/[A-Z]/g, match => `-${match.toLowerCase()}`);
}

// 示例
console.log(camelToKebab('fontSize'));       // "font-size"
console.log(camelToKebab('backgroundColor')); // "background-color"
2. 边界问题:首字母大写(PascalCase)导致的前导横线
上述基础正则存在一个典型缺陷:如果输入的是大驼峰(如 React 组件名 UserProfileHeader),字符串开头的大写字母也会被匹配,从而在最前面生成一个多余的连字符,变成 -user-profile-header。
解决该问题通常有两种思路:
- 正则排除行首:使用断言或捕获非首位的大写字母,如
/([a-z0-9])([A-Z])/g,替换为$1-$2,最后统一toLowerCase()。 - 后置消除首位短横:在整体替换完成后,通过
replace(/^-/, '')剔除行首连字符。
// 改进方案:正向处理小驼峰与大驼峰
function camelToKebabRobust(str) {
  if (typeof str !== 'string' || !str) return '';
  return str
    .replace(/([a-z0-9])([A-Z])/g, '$1-$2')
    .replace(/([A-Z])([A-Z][a-z])/g, '$1-$2') // 兼顾连续大写如 XMLHttp
    .toLowerCase();
}

console.log(camelToKebabRobust('UserProfileHeader')); // "user-profile-header" (无前导连字符)
console.log(camelToKebabRobust('XMLHTTPRequest'));    // "xml-http-request"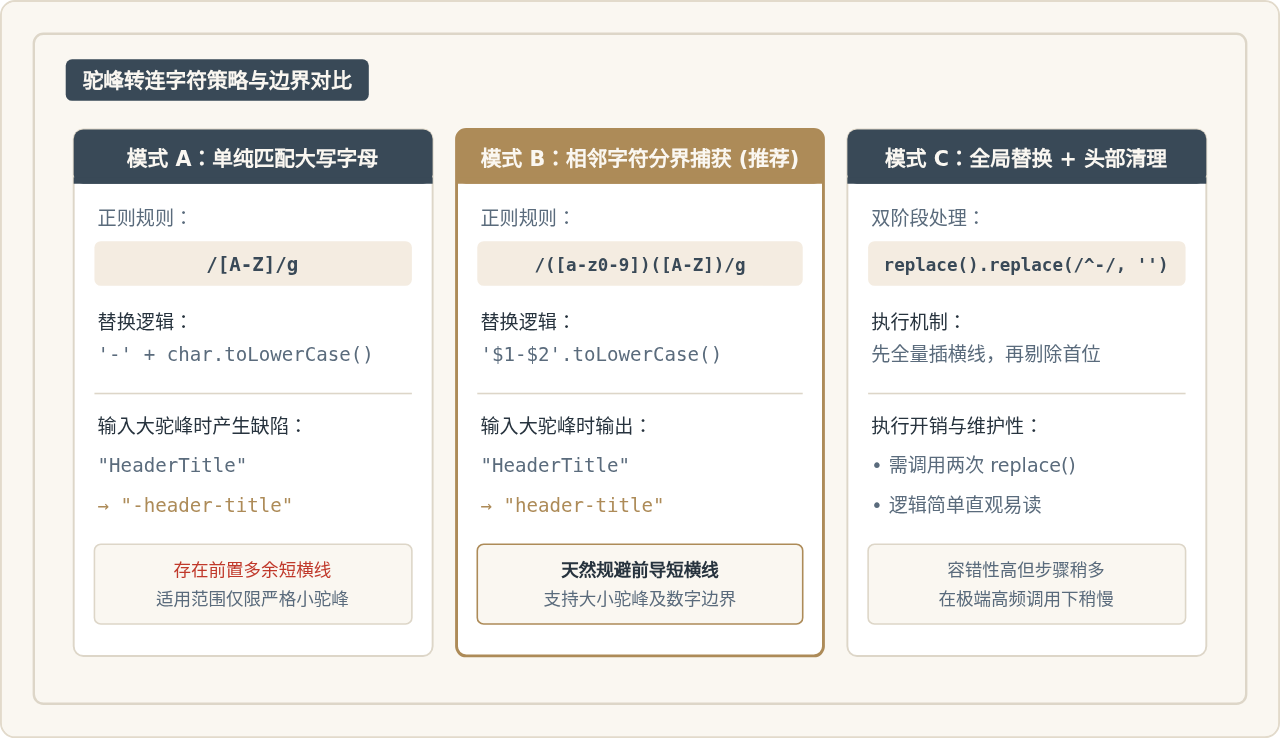
三、前端开发中的实际应用架构与场景
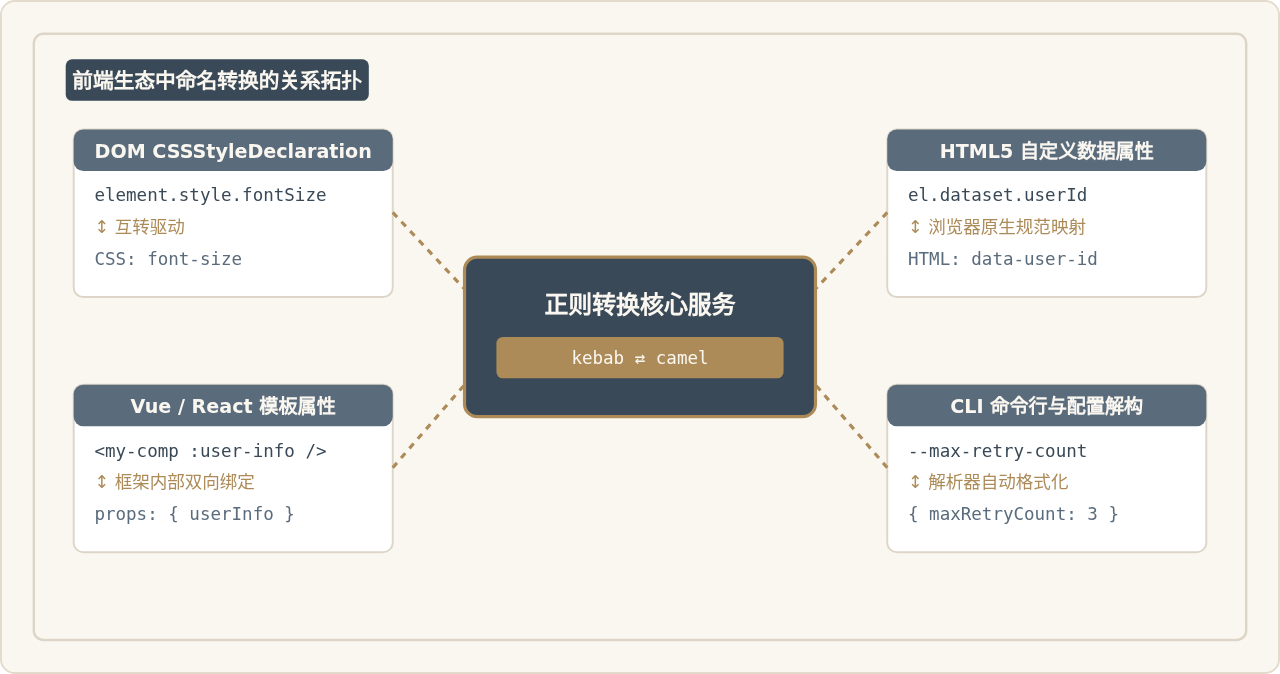
命名格式转换在前端工程中不仅是纯粹的字符串格式化工具,更是打通底层 DOM、样式引擎、MVVM 框架及网络通信的关键桥梁。
典型应用场景详解
- DOM 内联样式操作:在操作
HTMLElement.style时,CSS 属性background-color必须对应为style.backgroundColor。动态设置属性对象时,常需批量对键名做互换转换。 - HTML5 dataset 规范:浏览器将
data-page-index="1"原生映射到element.dataset.pageIndex。但在自定义虚拟 DOM 或无头测试框架中,需由代码手动执行解析。 - 组件库属性透传:在 Vue、Web Components 中,HTML 模板倾向于使用全小写连字符
max-upload-size,而组件逻辑层则接收驼峰命名的maxUploadSize属性。
四、通用工具函数封装与边界处理
在实际生产项目中,输入参数往往伴随连续连字符(如 foo--bar)、带数字的变量(如 item-1-count)或非字符串等异常。封装通用工具函数需兼顾安全性与性能。
/**
 * 通用命名格式转换工具对象
 */
const CaseConverter = {
  /**
   * 连字符转小驼峰
   * 兼容多重横线、首尾横线以及数字混排
   */
  toCamel(str) {
    if (typeof str !== 'string' || !str) return '';
    return str
      // 消除前导和后置横线
      .replace(/^-+|-+$/g, '')
      // 匹配连续横线加字符,转为首字母大写
      .replace(/-+([a-zA-Z0-9])/g, (_, char) => char.toUpperCase())
      // 确保整体首字母为小写
      .replace(/^[A-Z]/, first => first.toLowerCase());
  },

  /**
   * 驼峰转连字符
   * 兼容大小驼峰、连续缩写大写(如 XML)及数字边界
   */
  toKebab(str) {
    if (typeof str !== 'string' || !str) return '';
    return str
      // 阶段 1: 处理连续大写后接小写的情况,如 XMLHttp -> XML-Http
      .replace(/([A-Z]+)([A-Z][a-z])/g, '$1-$2')
      // 阶段 2: 处理小写/数字与大写的交界,如 item1Count -> item1-Count
      .replace(/([a-z0-9])([A-Z])/g, '$1-$2')
      // 阶段 3: 规避原有下划线或空格,并全小写化
      .replace(/[\s_]+/g, '-')
      .toLowerCase();
  }
};

// 完整边界用例测试
console.log(CaseConverter.toCamel('user-profile-id'));     // "userProfileId"
console.log(CaseConverter.toCamel('-webkit-border-radius'));// "webkitBorderRadius"
console.log(CaseConverter.toCamel('step--2--sub-item'));   // "step2SubItem"

console.log(CaseConverter.toKebab('userProfileId'));       // "user-profile-id"
console.log(CaseConverter.toKebab('UserProfileId'));       // "user-profile-id"
console.log(CaseConverter.toKebab('getHTTPResponseCode')); // "get-http-response-code"
console.log(CaseConverter.toKebab('item2TotalCount'));     // "item2-total-count"
性能优化建议:带缓存的转换机制
在处理虚拟 DOM 渲染树或批量解析大量节点样式时,高频调用正则替换会有一定的 CPU 开销。对于有限的属性名集合,可以通过简易闭包缓存(Memoization)大幅提升执行效率:
function createCachedConverter(converterFn) {
  const cache = Object.create(null);
  return function(str) {
    const hit = cache[str];
    return hit || (cache[str] = converterFn(str));
  };
}

const fastToCamel = createCachedConverter(CaseConverter.toCamel);
const fastToKebab = createCachedConverter(CaseConverter.toKebab);
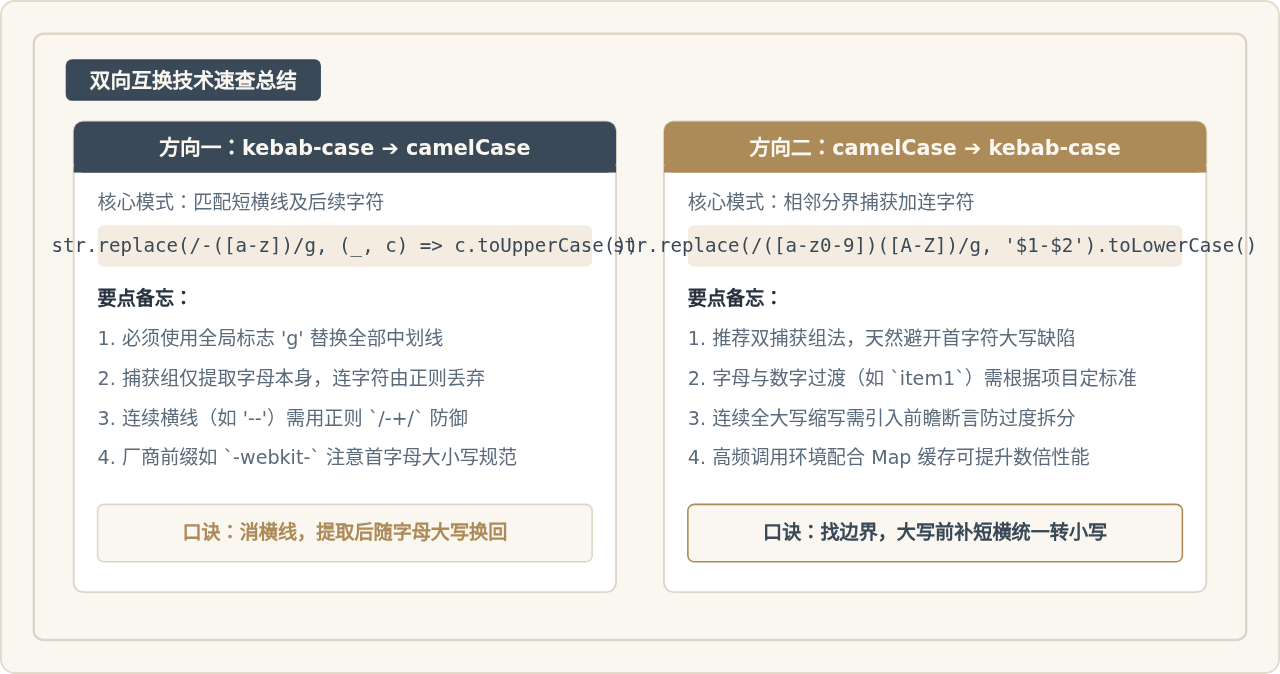
五、核心互换要点总结
下表归纳了双向转换的核心匹配规则与关键注意点:
| 转换方向 | 推荐正则表达式 | 替换模板 / 回调逻辑 | 主要边界防范 |
|---|---|---|---|
| kebab → camel | /-+([a-zA-Z0-9])/g |
(_, c) => c.toUpperCase() |
连续连字符;厂商前缀首字符处理;数字后缀 |
| camel → kebab | /([a-z0-9])([A-Z])/g |
'$1-$2'.toLowerCase() |
大驼峰前导连字符;连续缩写字母(如 HTTP/XML) |
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章