
在 JavaScript 中判断多维数组是否包含某个值,常用的解决方案包括 Array.prototype.flat() 扁平化检索、基于 some() 的短路递归函数,以及防栈溢出的显式栈迭代方案。本文详细分析各方案的实现步骤、性能差异及选型建议。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS怎么判断多维数组中是否包含某个值
作者:小括号
时间:2026-11-03
浏览:301
文章目录
JavaScript 权威技术实践
图 0:JavaScript 多维数组深度检索与穿透匹配概览
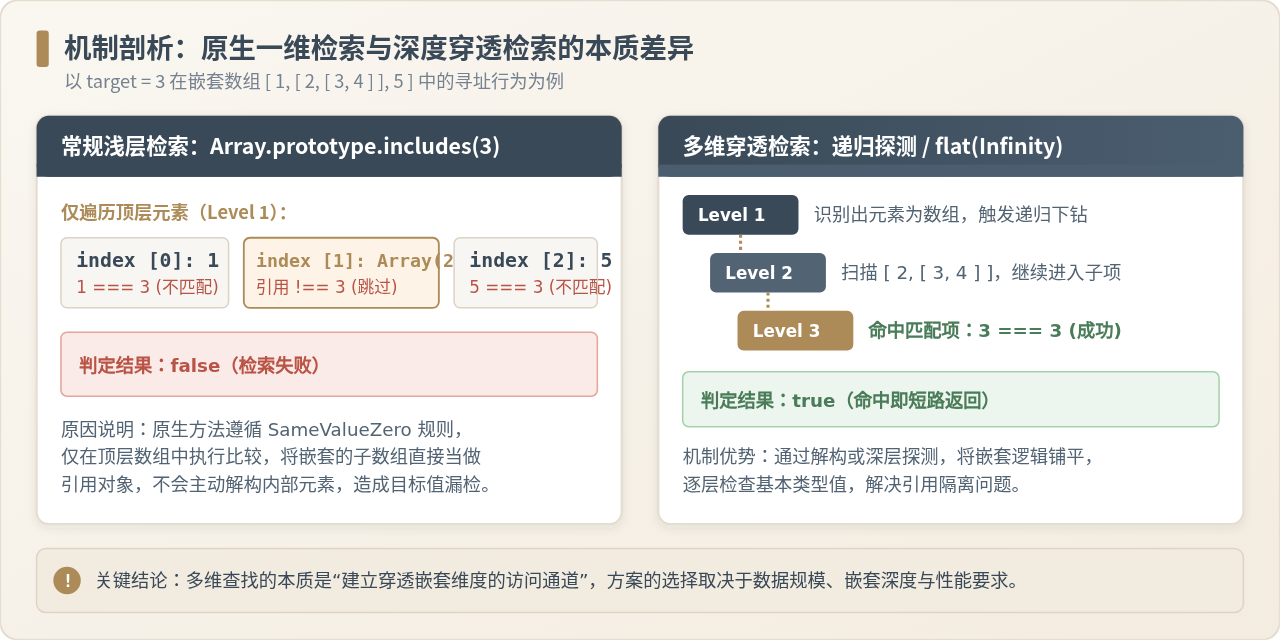
图 1:机制剖析:原生一维检索的引用隔离与深度穿透检索对比
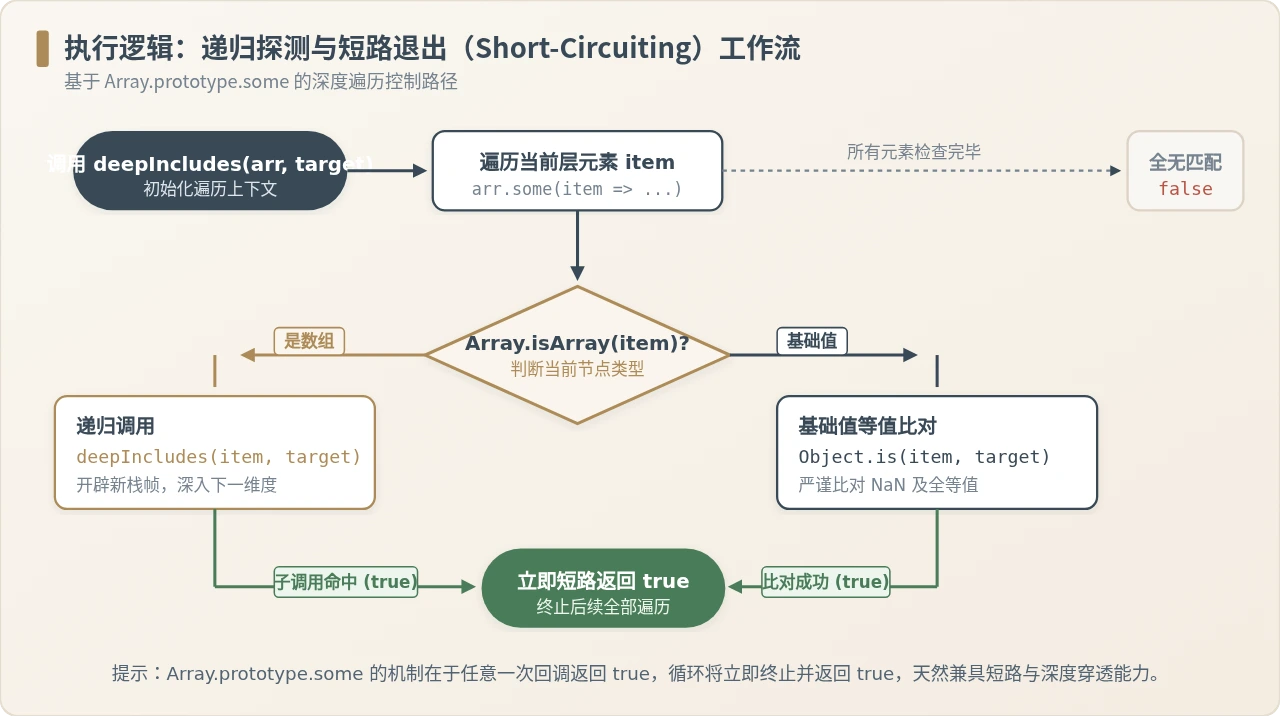
图 2:基于 Array.prototype.some 的递归短路判定工作流
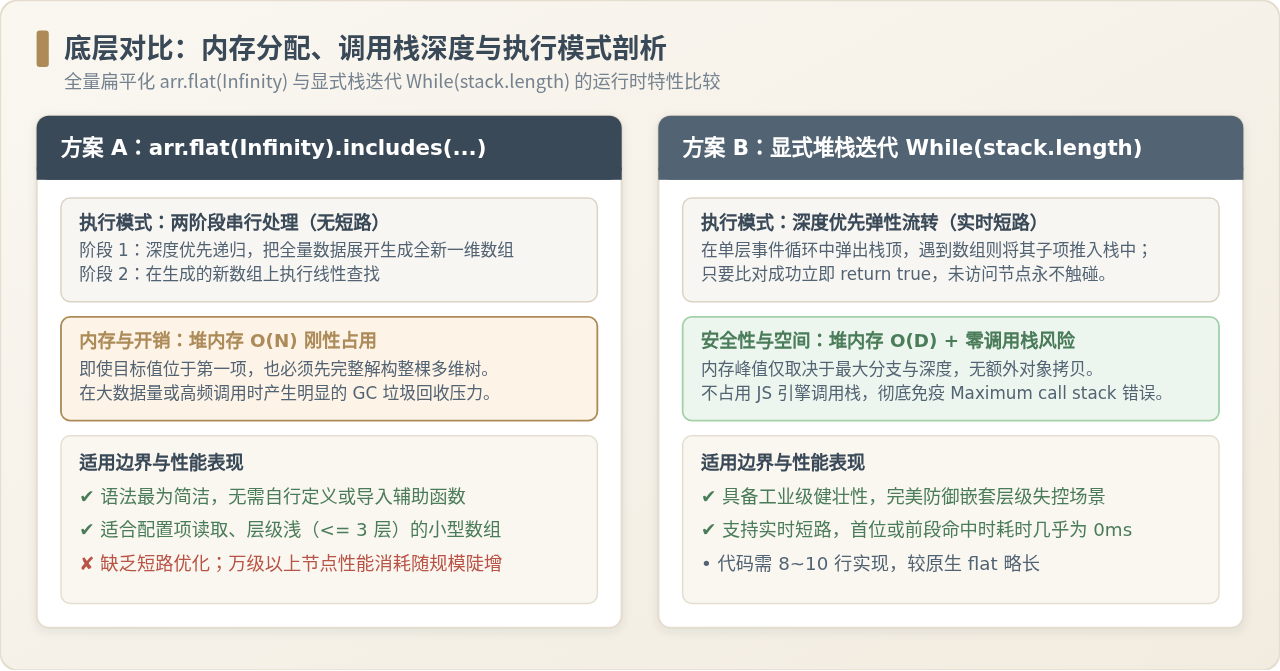
图 3:扁平化解构机制与显式栈迭代机制在内存及执行模式上的对比
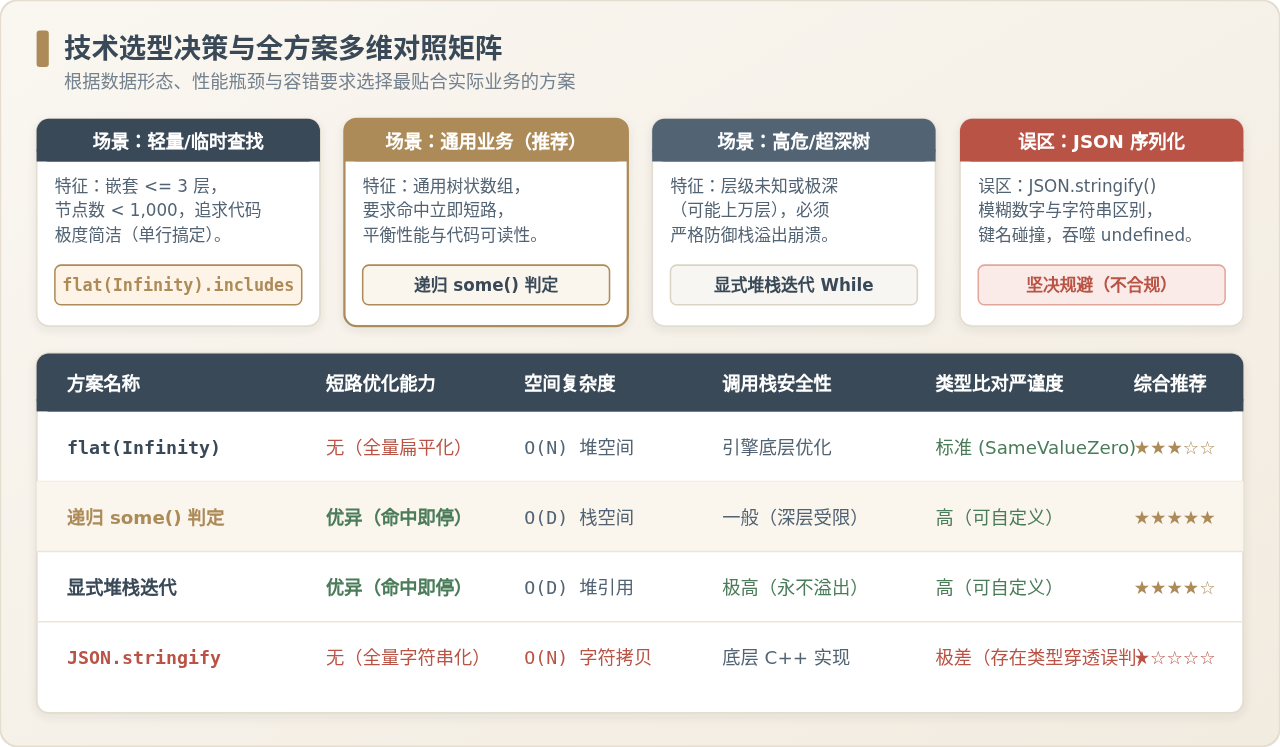
图 4:JavaScript 多维数组检索方案技术选型导图与综合对照矩阵
类型:现代前端算法与数据处理
阅读时长:约 8 分钟
运行环境:ECMAScript 2019+ / Node.js 12+ / 浏览器全环境
在 JavaScript 中判断多维数组是否包含某个目标值,最精简的现代语法是直接使用
arr.flat(Infinity).includes(target) 将数组完全扁平化后再作判断;而在处理大规模嵌套数据或关注运行时性能时,推荐使用基于 Array.prototype.some 的递归函数,它能在命中目标后立即短路退出(Short-circuiting),避免浪费算力;若面对层级未知或极深的数据结构,则应选用显式堆栈迭代方式以确保完全消除调用栈溢出风险。
一、为什么常规方法无法直接作用于多维数组?
在日常开发中,我们通常使用 Array.prototype.includes() 或 Array.prototype.indexOf() 判断数组是否包含某个元素。然而,这两个原生方法的设计定位是一维线性查找,其底层比较逻辑遵循 ECMAScript 的 SameValueZero 规范,只会在当前数组的顶层索引上执行逐项比对。
当遇到多维数组(例如 [1, [2, [3, 4]], 5])时,顶层的第二个元素在内存中存储的是一个指向子数组的对象引用(Reference)。如果执行 arr.includes(3),JS 引擎只会依次检验顶层:
const list = [1, [2, [3, 4]], 5];

// 顶层索引 0: 1 === 3 -> false
// 顶层索引 1: [2, [3, 4]] === 3 -> 引用类型与数值比对,永不相等 -> false
// 顶层索引 2: 5 === 3 -> false
console.log(list.includes(3)); // 输出: false
由于原生一维方法不会主动穿透层级进入子数组内部,导致即使数字 3 确实存在于深层,判定结果仍然为 false。要解决这一问题,核心在于建立一条“能够下钻或展开多维嵌套维度”的检索通道。
二、方法一:使用 flat(Infinity) 快速降维判断
ECMAScript 2019(ES10)引入了 Array.prototype.flat() 方法。传入参数 Infinity 时,该方法会递归提取多维数组中所有子数组的元素,将任意深度的嵌套结构解构为平铺的一维数组。在此基础上链式调用 includes(),即可实现单行语法搞定多维检索。
代码实现
/**
 * 基于 Array.prototype.flat 的快速多维包含判断
 * @param {Array} arr - 待检索的多维数组
 * @param {*} target - 目标值
 * @returns {boolean}
 */
function hasValueFlat(arr, target) {
  if (!Array.isArray(arr)) return false;
  return arr.flat(Infinity).includes(target);
}

// 示例验证
const matrix = [1, [2, [3, [4, "hello"]]], 5];
console.log(hasValueFlat(matrix, 3));       // 输出: true
console.log(hasValueFlat(matrix, "hello")); // 输出: true
console.log(hasValueFlat(matrix, 99));      // 输出: false
执行特性与局限性提醒
flat(Infinity) 本质上是全量重构机制。在执行 includes 之前,它必须完整遍历整棵多维树并在堆内存中分配一个全新的平铺数组。这意味着即便目标元素就位于数组的最前端(例如 [[3], ...上万个嵌套子项]),它也必须等待整个数组扁平化完毕,既无法享受短路退出的性能红利,又会在处理超大数组时产生额外的 GC 垃圾回收负担。
三、方法二:基于 Array.prototype.some 的递归短路查找(推荐实践)
为了避免全量展开数组带来的内存开销与时间浪费,最优的通用解法是编写一个具备短路退出(Short-circuiting)能力的递归函数。
在 JavaScript 数组的原型方法中,some() 具有极佳的控制流特性:一旦回调函数返回 true,some() 将立即中断后续所有元素的循环迭代,直接向上层抛出 true。结合递归调用,便能在树状嵌套结构中实现“发现即停止”的深度优先探索。
代码实现
/**
 * 基于递归与 some() 短路特性的深度检索函数
 * @param {Array} arr - 多维数组
 * @param {*} target - 目标值
 * @returns {boolean}
 */
function deepIncludes(arr, target) {
  if (!Array.isArray(arr)) return false;

  return arr.some(item => {
    // 若子项是数组,则递归下钻探查
    if (Array.isArray(item)) {
      return deepIncludes(item, target);
    }
    // 使用 Object.is 准确处理 NaN 与严格相等比对
    return Object.is(item, target);
  });
}

// 示例验证
const complexData = ["a", ["b", [NaN, [42]]], null];
console.log(deepIncludes(complexData, 42));  // 输出: true
console.log(deepIncludes(complexData, NaN)); // 输出: true (严格识别 NaN)
console.log(deepIncludes(complexData, 100)); // 输出: false
在上述实现中,使用 Object.is(item, target) 替代 === 是一个细致的防御性设计。因为在标准 JavaScript 中,NaN === NaN 会返回 false,导致含有 NaN 的多维数组查找失真,而 Object.is 能够严格匹配 NaN 与 +0/-0,语义与原生的 SameValueZero 保持高度一致。
四、方法三:显式堆栈迭代(防调用栈溢出安全方案)
递归方案虽然高效优雅,但在 JavaScript 运行时中依赖于引擎的主调用栈(Call Stack)。大多数浏览器环境和 Node.js 进程的调用栈深度限制在 10,000 层左右。
如果你的多维数组是由自动化解析脚本、层级爬虫或不可控外部数据生成的,并且嵌套层级可能极其深(例如链表式包装或异常深树),深层递归会触发 RangeError: Maximum call stack size exceeded 异常导致进程崩溃。为了在极端工况下保障系统的健壮性,我们可以使用显式模拟栈(Explicit Stack)与循环来实现深度优先搜索(DFS)。
代码实现
/**
 * 显式栈迭代方案:彻底杜绝调用栈溢出风险
 * @param {Array} rootArr - 待查多维数组
 * @param {*} target - 目标值
 * @returns {boolean}
 */
function deepIncludesIterative(rootArr, target) {
  if (!Array.isArray(rootArr)) return false;

  // 显式模拟执行栈
  const stack = [...rootArr];

  while (stack.length > 0) {
    const current = stack.pop();

    if (Array.isArray(current)) {
      // 遇到子数组时,将其元素解构压入显式栈中继续回溯
      for (let i = 0; i < current.length; i++) {
        stack.push(current[i]);
      }
    } else if (Object.is(current, target)) {
      // 命中目标,立即中断循环并返回
      return true;
    }
  }

  return false;
}

// 验证超深嵌套场景(构造 20,000 层嵌套的极限数组)
let deepArray = ["target_val"];
for (let i = 0; i < 20000; i++) {
  deepArray = [deepArray];
}

// 此时调用 deepIncludes(deepArray, "target_val") 会抛出栈溢出错误
// 显式栈方案则平稳运行,瞬间输出结果:
console.log(deepIncludesIterative(deepArray, "target_val")); // 输出: true
五、常见误区与深层对象检索扩展
1. 警惕误区:使用 JSON.stringify 判定包含
部分开发者试图走捷径,使用 JSON.stringify(arr).includes(target) 来做包含判定。这种写法存在极大的逻辑缺陷,在生产环境中严禁使用:
- 类型失真与伪匹配:如果数组内容为
[12, [34]],执行JSON.stringify(arr).includes("2")将返回true,因为数字12序列化后的字符串中包含了字符"2",造成严重的逻辑误判; - 对象键名冲突:若数组包含对象
[{ id: 100 }],查找"id"也会返回true,但实际数组只包含属性键名为 id 的对象,并不包含字符串"id"这一值; - 特殊值被静默丢弃:在 JSON 序列化规范中,
undefined、Symbol、函数值在数组中会被强制序列化为null,而在对象中则会被直接删除;且遇到循环引用时会直接抛出TypeError。
2. 扩展场景:多维数组中包含对象或自定义结构时的判断
如果在多维数组中需要判定的值不是基本类型(如数字、字符串),而是对象或需要满足某种业务条件(例如 id === 101 的用户信息),我们可以将查找逻辑扩展为接受谓词回调函数的 deepSome 通用检索器:
/**
 * 通用多维数组断言查找函数
 * @param {Array} arr - 多维数组
 * @param {Function} predicate - 条件断言函数
 * @returns {boolean}
 */
function deepSome(arr, predicate) {
  if (!Array.isArray(arr)) return false;
  return arr.some(item =>
    Array.isArray(item) ? deepSome(item, predicate) : predicate(item)
  );
}

// 业务对象数组检索示例
const userTree = [
  { id: 1, name: "Alice" },
  [
    { id: 2, name: "Bob" },
    [{ id: 3, name: "Charlie" }]
  ]
];

// 判断是否包含 id 为 3 的成员
const hasCharlie = deepSome(userTree, item => item && item.id === 3);
console.log(hasCharlie); // 输出: true
六、技术选型对照与总结建议
针对不同的业务环境、数据体量及开发诉求,选择最合适的实现策略能达到代码可读性与系统稳定性的最佳平衡。下表整理了本文介绍的三种主要方案的核心技术指标:
| 方案分类 | 核心原理 | 短路能力 | 空间复杂度 | 栈溢出风险 | 适用开发场景 |
|---|---|---|---|---|---|
| flat(Infinity) + includes | 原生两阶段扁平化 | 无短路 | O(N) 堆占用 | 无(引擎底层处理) | 小型配置数据、嵌套小于 3 层、脚本临时验证 |
| 递归 deepIncludes (some) | 递归 DFS + 条件短路 | 有(命中即停) | O(D) 栈占用 | 极端深层(>10,000)有风险 | 95% 的标准生产业务、常规树状组织结构 |
| 显式堆栈迭代 (While + Stack) | 堆内存自定义栈 DFS | 有(命中即停) | O(D) 堆引用 | 完全免疫 | 工业级 SDK、嵌套层级未知的数据分析、防爆栈防护 |
最终选型口诀
层级浅且随手写,flat 链式最省力;
常规业务求性能,递归 some 是首选;
层级极端不可信,显式堆栈保平安;
字符串化漏洞多,切忌偷懒用 JSON。
常规业务求性能,递归 some 是首选;
层级极端不可信,显式堆栈保平安;
字符串化漏洞多,切忌偷懒用 JSON。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章