

深入解析 Three.js 核心性能瓶颈,详细讲解静态几何体合并(BufferGeometryUtils)、动态海量物体实例化(InstancedMesh)与 GPU 纹理压缩(KTX2/Basis Universal)的具体实现步骤、代码范例、核心选型原则与调试验证方法。
Three.js 性能优化实战:几何体合并、实例化网格与纹理压缩
作者:霁月
时间:2026-11-03
浏览:158
文章目录
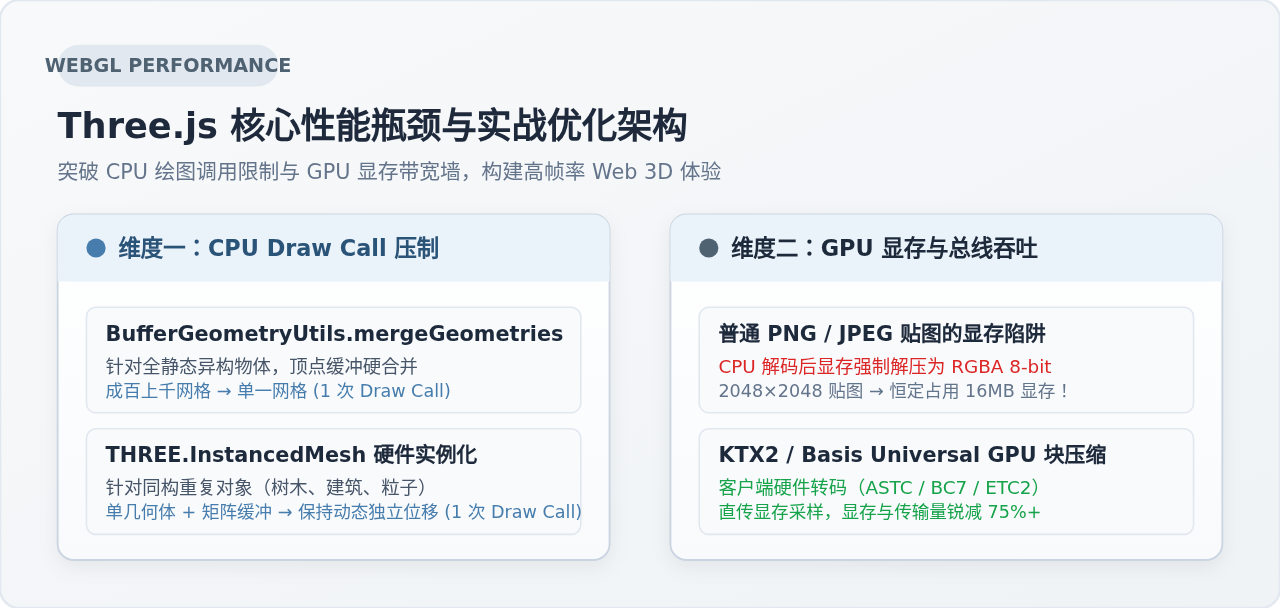
在 WebGL 与 Three.js 复杂三维场景开发中,掉帧与运行卡顿通常源自两处硬件瓶颈:一是 CPU 端因海量网格对象遍历、状态切换而导致的 Draw Call 严重超标;二是 GPU 端因未经压缩的高分辨率纹理造成的显存暴涨与显存总线带宽耗尽。针对这两个核心堵点,几何体合并(BufferGeometryUtils.mergeGeometries)、实例化网格(THREE.InstancedMesh)以及现代 GPU 纹理压缩(KTX2 / Basis Universal)提供了针对性的解法。本文直接围绕这三项核心技术的内部工作机理、实战编码步骤、适用边界与性能验证展开讲解,帮助开发者构建流畅且低内存占用的 Web 3D 应用。
一、WebGL 性能瓶颈剖析:Draw Call 与 GPU 显存
在浏览器的每一帧渲染循环中,Three.js 需要执行两个层面的工作:CPU 端计算与 GPU 端光栅化渲染。许多开发者遇到场景卡顿时,容易直觉性地认为是模型面数(顶点数)过多,但实际工程中,真正的帧率杀手往往集中在以下两点:
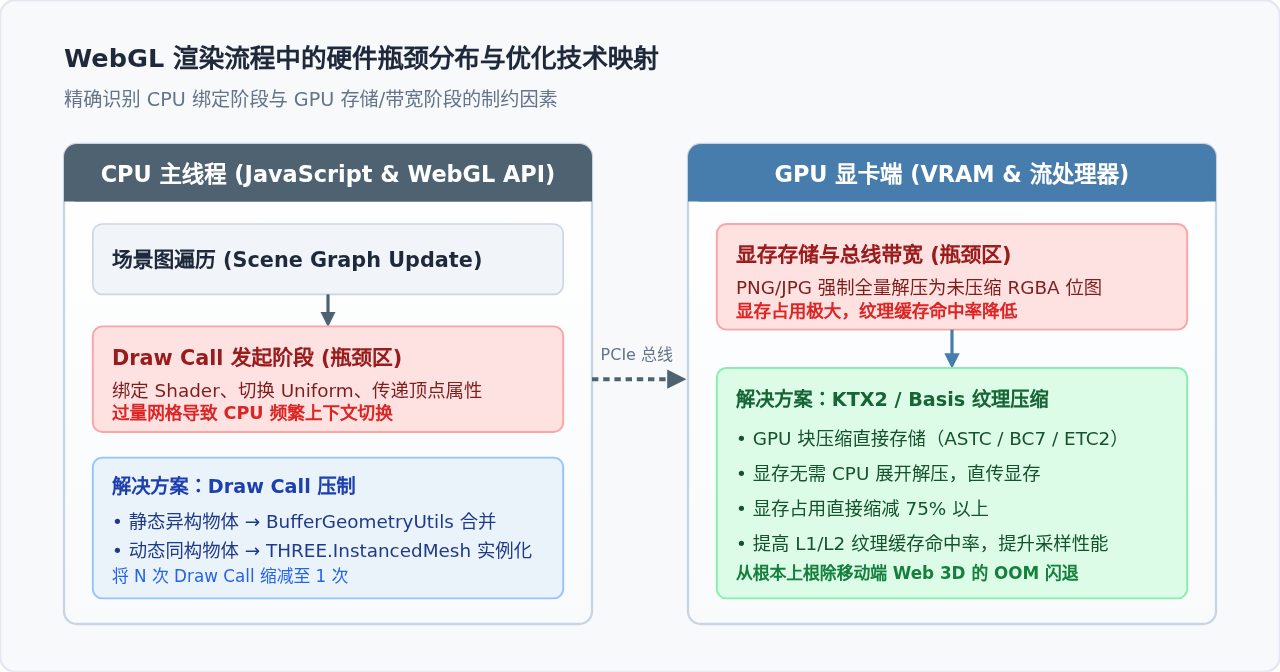
1. Draw Call(绘制调用)导致的 CPU 瓶颈:每个挂载在场景中的独立 THREE.Mesh,在提交到 WebGL 上下文时,通常需要触发至少一次绘图指令(如 gl.drawElements)。在发起调用前,CPU 主线程必须遍历场景树、计算世界变换矩阵、校验视锥体、切换着色器程序并绑定材质属性。当场景中存在 1000 个独立的网格对象时,CPU 每一帧都要重复 1000 次上下文切换。浏览器的单线程特性会导致 CPU 占用率拉满,渲染帧率跌破 30 FPS,而此时 GPU 的着色器计算单元往往处于饥饿等待状态。
2. 纹理未经压缩导致的显存爆炸与带宽瓶颈:许多开发者习惯将高分辨率的 PNG 或 JPG 直接赋值给材质的 map 属性。虽然 PNG 在磁盘和网络传输时体积较小(例如一张 2048×2048 的纹理经压缩后磁盘体积仅为 1.5MB),但 WebGL 无法直接从 PNG 的 Deflate 算法中随机采样。浏览器必须先在 CPU 内存中将其全量解压为未压缩的位图,再上传至 GPU 显存。一张 2048×2048 的 RGBA 8-bit 贴图在显存中占用的物理空间为:
显存占用 = 2048 × 2048 × 4 字节(RGBA) ≈ 16.78 MB(若开启 Mipmap 则为 22.37 MB)如果场景中包含 20 张此类贴图,显存占用即刻突破 400MB。在移动端浏览器或低配设备上,这不仅会直接引发页面卡顿,还极易触发系统 OOM(Out of Memory)导致浏览器标签页直接崩溃刷新。
二、静态几何体合并(BufferGeometryUtils.mergeGeometries)实战
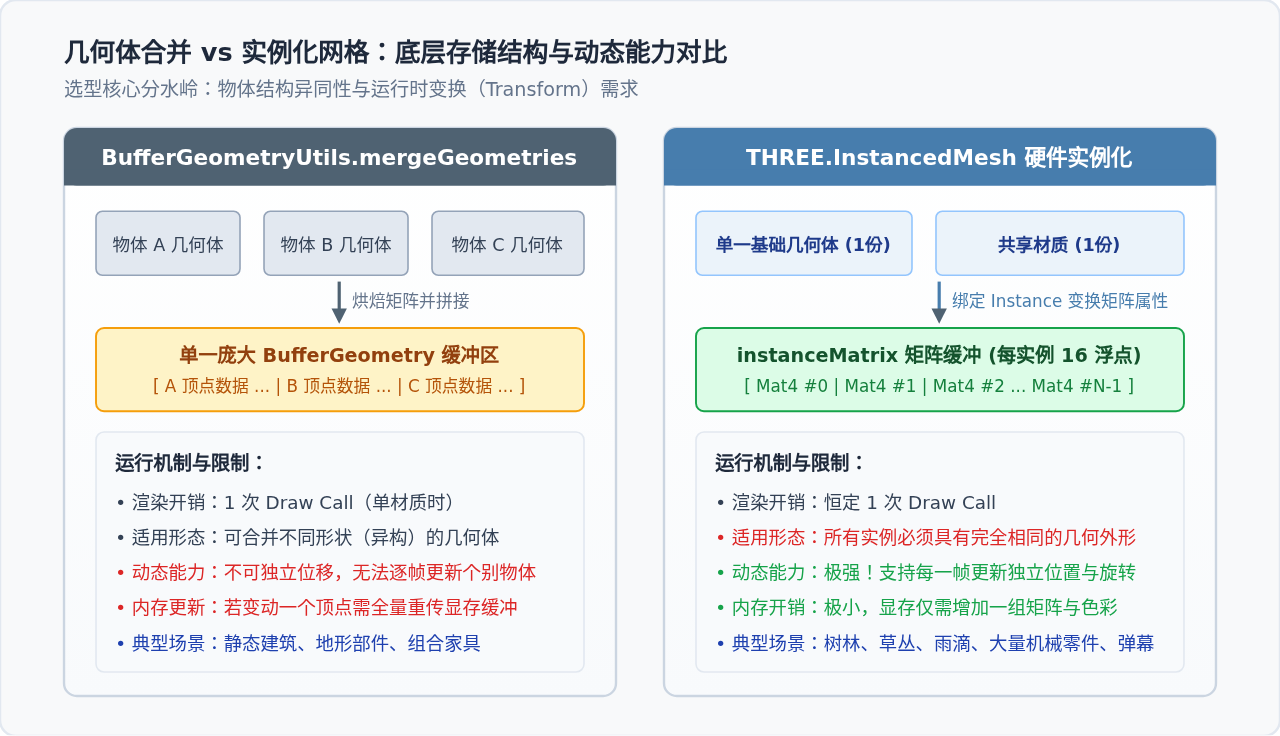
在数字孪生园区、三维大屏或室内全景等场景中,往往包含大量位置固定的静态构件,如数百张桌椅、路灯、管道和建筑物。如果每个构件都是独立的 Mesh,场景中将产生海量的 Draw Call。对于这些在运行时绝对不发生相对运动、不需要独立变动材质的物体,最佳方案是使用 BufferGeometryUtils.mergeGeometries 将它们合并为一个单一的 BufferGeometry。
1. 合并原理与核心步骤
几何体合并的底层逻辑是:提取所有子几何体的顶点属性数组(如 position、normal、uv 等 BufferAttribute),并按照全局空间中的相对位姿进行坐标变换转换,最终拼接成一个包含全部顶点数据的大型 TypedArray 缓冲。渲染时,GPU 只需要读取这一个缓冲区,用一次 gl.drawElements 便可完成全部物体的绘制。
具体实施步骤如下:
- 在合并之前,必须通过
geometry.applyMatrix4(mesh.matrix)将每个独立 Mesh 的局部变换矩阵预先“烘焙”到几何体顶点中,否则所有物体合并后都将重叠在世界原点。 - 确保待合并的所有几何体具有相同种类的顶点属性。若 A 几何体有顶点法线(normal)而 B 几何体缺失,合并函数将报错或丢失属性。
- 调用
BufferGeometryUtils.mergeGeometries(geometries, useGroups)执行合并。 - 创建合并后的 Mesh 并加入场景,显式释放原几何体的内存。
2. 完整实战代码
import * as THREE from 'three';
import * as BufferGeometryUtils from 'three/addons/utils/BufferGeometryUtils.js';

// 场景与材质初始化
const scene = new THREE.Scene();
const sharedMaterial = new THREE.MeshStandardMaterial({ color: 0x477DAD, roughness: 0.4 });

// 准备暂存数组
const geometriesToMerge = [];

// 模拟生成 500 个分布在不同位置的静态建筑构件
for (let i = 0; i < 500; i++) {
  const boxGeom = new THREE.BoxGeometry(2, Math.random() * 8 + 2, 2);

  // 计算该物体的独立位姿
  const dummyMesh = new THREE.Mesh(boxGeom, sharedMaterial);
  dummyMesh.position.set(
    (Math.random() - 0.5) * 100,
    boxGeom.parameters.height / 2,
    (Math.random() - 0.5) * 100
  );
  dummyMesh.rotation.y = Math.random() * Math.PI;
  dummyMesh.updateMatrix(); // 强制更新变换矩阵

  // 关键步骤:将变换矩阵直接应用到几何体顶点数据上
  boxGeom.applyMatrix4(dummyMesh.matrix);

  geometriesToMerge.push(boxGeom);
}

// 执行合并:第二个参数设为 false 表示共享单一材质(不创建材质组)
const mergedGeometry = BufferGeometryUtils.mergeGeometries(geometriesToMerge, false);

if (mergedGeometry) {
  // 生成合并后的唯一网格对象
  const mergedMesh = new THREE.Mesh(mergedGeometry, sharedMaterial);
  scene.add(mergedMesh);

  // 清理临时分配的各个子几何体显存
  geometriesToMerge.forEach((geom) => geom.dispose());
  geometriesToMerge.length = 0;
} else {
  console.error('几何体合并失败,请检查各几何体顶点属性是否一致');
}
注意项:多材质合并与材质组(Groups)
若待合并的模型必须使用不同材质,可以将 mergeGeometries(geometries, true) 的第二个参数设为 true。此时 Three.js 会在内部生成 geometry.groups,并在渲染时传入材质数组。需要警惕的是:使用多材质数组时,底层虽然合并为一个几何体,但每个材质组依然会产生一次 Draw Call。因此,多材质合并主要优化的是场景节点遍历开销,若想彻底压低 Draw Call,应尽可能在建模阶段将多张贴图烘焙合并为一张图集(Texture Atlas),共用同一套材质。
三、动态海量同构物体:实例化网格(InstancedMesh)实战
如果场景中的物体需要在每一帧各自旋转、平移,或者物体数量极大(如成千上万棵植被、成群的巡逻兵、粒子系统或三维图表),几何体合并就完全失效了。因为一旦合并,修改任何一个物体的位姿都需要重新上传全部顶点缓冲,性能开销不可接受。
此时的标准解法是 THREE.InstancedMesh(实例化网格)。它利用了现代 GPU 的硬件实例化能力(Hardware Instancing),只需提供一份几何体基础数据和一份材质,并在显存中维护一个针对每个实例的 4×4 变换矩阵缓冲(instanceMatrix),就能在 1 次 Draw Call 内同时绘制成千上万个拥有独立位置、姿态、缩放乃至独立颜色的物体。
1. InstancedMesh 核心开发步骤
在实际编码中,操作 InstancedMesh 的核心逻辑可以分为:创建实例化容器、构造虚拟对象(Object3D / Matrix4)辅助计算、逐个注入位姿矩阵、最后标记缓冲区更新。
import * as THREE from 'three';

const count = 5000; // 实例化 5000 个动态对象
const baseGeometry = new THREE.ConeGeometry(0.5, 2, 8); // 单个圆锥体
const material = new THREE.MeshStandardMaterial({ color: 0xFFFFFF });

// 1. 初始化 InstancedMesh,传入几何体、材质与总实例上限
const instancedMesh = new THREE.InstancedMesh(baseGeometry, material, count);
instancedMesh.instanceMatrix.setUsage(THREE.DynamicDrawUsage); // 声明为频繁更新

// 2. 使用一个临时的 dummy Object3D 帮助计算四元数和仿射变换矩阵
const dummy = new THREE.Object3D();
const color = new THREE.Color();

for (let i = 0; i < count; i++) {
  // 设置每个实例独立的位置、旋转、缩放
  dummy.position.set(
    (Math.random() - 0.5) * 120,
    Math.random() * 20,
    (Math.random() - 0.5) * 120
  );
  dummy.rotation.set(
    Math.random() * Math.PI,
    Math.random() * Math.PI,
    0
  );
  const scale = Math.random() * 0.8 + 0.2;
  dummy.scale.set(scale, scale, scale);

  dummy.updateMatrix(); // 更新局部矩阵

  // 3. 将矩阵写入实例索引 i
  instancedMesh.setMatrixAt(i, dummy.matrix);

  // 4. 设置独立颜色(可选)
  color.setHSL(i / count, 0.7, 0.5);
  instancedMesh.setColorAt(i, color);
}

// 5. 关键:首次设置完成后标记矩阵与颜色缓冲需要上传显存
instancedMesh.instanceMatrix.needsUpdate = true;
if (instancedMesh.instanceColor) {
  instancedMesh.instanceColor.needsUpdate = true;
}

scene.add(instancedMesh);
2. 运行时动态位移与性能要点
若需要在渲染循环(requestAnimationFrame)中使这 5000 个对象运动,只需要在循环内部重新计算 dummy 的位置并调用 instancedMesh.setMatrixAt(i, dummy.matrix),最后在循环外部执行一次 instancedMesh.instanceMatrix.needsUpdate = true; 即可。
视锥体剔除(Frustum Culling)避坑:Three.js 默认根据整个 InstancedMesh 的包围球(Bounding Sphere)执行剔除。如果实例分布跨度极大,或者实例在运动过程中飞出了初始计算的包围球范围,整个网格可能会在相机转动时突然闪烁消失。解决方法是:在全部实例位置初始化完成后,调用 instancedMesh.computeBoundingSphere() 重新计算实际包围球,或在视野覆盖极大且实例分散时显式设置 instancedMesh.frustumCulled = false。
四、显存终极瘦身:KTX2 与 Basis Universal 纹理压缩落地
解决了 Draw Call 之后,中大型项目的另一大死因是显存超标。许多开发者误以为压缩了 JPG 质量、缩小了 PNG 文件就是完成了纹理优化,但正如第一节所述,GPU 采样机制决定了只要图像未采用专用 GPU 块压缩格式,它进入显存后就会被彻底打回原形。
1. 为什么必须使用 KTX2 / Basis Universal?
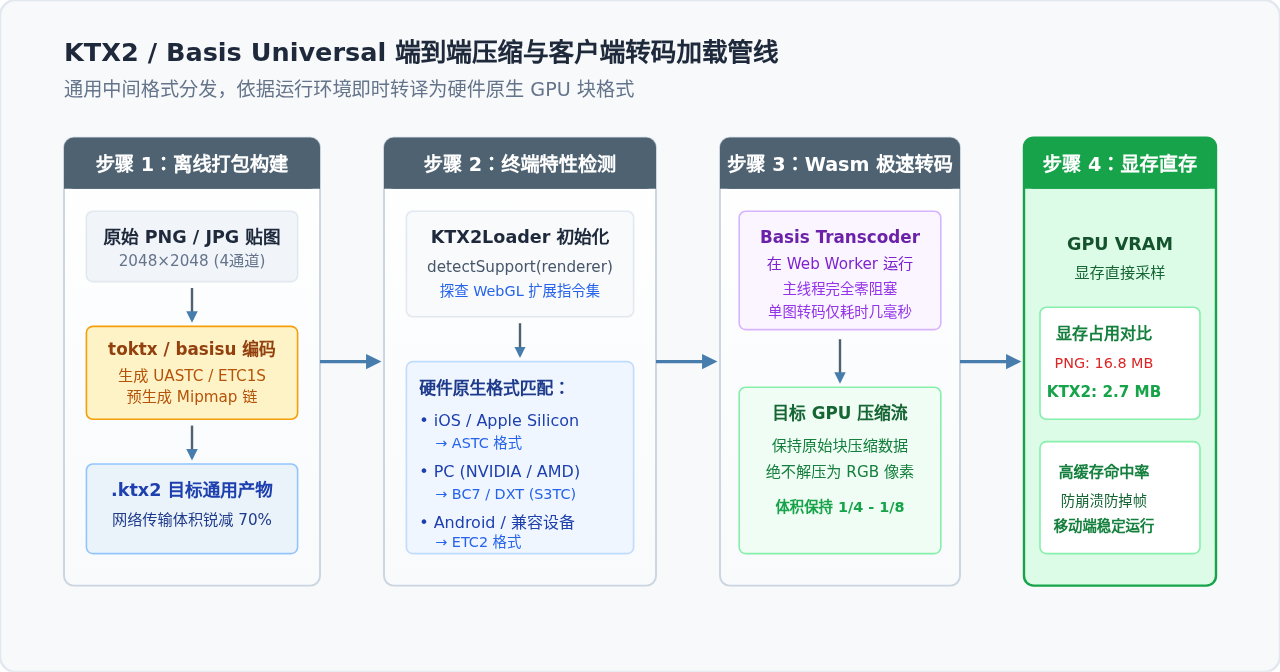
GPU 硬件原生支持专用的块压缩纹理格式(Block Compression),其核心特征是固定压缩比率且支持硬件级随机寻址。例如移动端普遍支持的 ASTC 格式、桌面端广泛支持的 BC7/DXT 格式,可以将纹理以 4×4 或 6×6 像素块为单位进行压缩,直接驻留在显存中,GPU 着色器在采样时即时由硬件解码。这样不仅显存占用直接降低 75% 到 85%,还能成倍提升显存缓存命中率。
然而,不同硬件平台的原生压缩格式高度割裂:iOS 和部分高通芯片支持 ASTC,Windows PC 支持 BC 系列,老款设备支持 ETC2。如果针对每种格式各打包一套资源,维护成本极其高昂。Basis Universal 与 KTX2 容器 的出现彻底终结了这一痛点:开发者只需在线下生成通用的 KTX2 文件,客户端通过 WebAssembly 转码器,可以在几毫秒内依据当前终端 GPU 的硬件特性,将其即时“转码”为设备原生支持的硬件格式,并且全过程绝不经过 CPU 展开为未压缩位图。
2. 离线制作 KTX2 资源
在工程发布阶段,推荐使用 Khronos 官方工具 toktx(包含在 KTX-Software 套件中)对贴图进行批量压缩转换。针对常见的 PBR 材质贴图,其压缩模式与命令推荐如下:
颜色贴图(BaseColor / Albedo,带 sRGB 空间与高保真度):
# 采用 UASTC 算法进行高质量压缩,并自动生成 Mipmap,保留 sRGB 元数据标记
toktx --t2 --uastc 2 --genmipmap --srgb texture_baseColor.ktx2 texture_baseColor.png
法线贴图与粗糙度金属度贴图(Normal / Roughness / Metallic,线性色彩空间):
# 法线和物理通道必须处于线性色彩空间,严禁添加 --srgb 标志
toktx --t2 --uastc 3 --genmipmap --linear texture_normal.ktx2 texture_normal.png
3. Three.js 中的加载与配置实战
在 Three.js 中使用 KTX2 贴图,必须配合 KTX2Loader。官方已经内置了基于 Web Worker 的 Basis 转码器,我们需要将官方库 three/examples/jsm/libs/basis/ 下的转码文件部署在静态资源目录中,供 Loader 异步加载调用:
import * as THREE from 'three';
import { KTX2Loader } from 'three/addons/loaders/KTX2Loader.js';

// 初始化渲染器
const renderer = new THREE.WebGLRenderer({ antialias: true });
renderer.setSize(window.innerWidth, window.innerHeight);
document.body.appendChild(renderer.domElement);

// 初始化 KTX2Loader
const ktx2Loader = new KTX2Loader();

// 1. 设置 WebAssembly 转码器静态文件路径(包含 basis_transcoder.js 和 basis_transcoder.wasm)
ktx2Loader.setTranscoderPath('/static/libs/basis/');

// 2. 关键:检测当前渲染器与 GPU 硬件对压缩纹理扩展(ASTC/BC7/ETC2)的支持度
ktx2Loader.detectSupport(renderer);

// 3. 加载 KTX2 压缩纹理
ktx2Loader.load(
  '/static/textures/building_diffuse.ktx2',
  (texture) => {
    // 颜色贴图必须显式声明色彩空间为 SRGB
    texture.colorSpace = THREE.SRGBColorSpace;
    texture.wrapS = THREE.RepeatWrapping;
    texture.wrapT = THREE.RepeatWrapping;

    // 赋值给材质
    const material = new THREE.MeshStandardMaterial({
      map: texture,
      roughness: 0.5
    });

    const mesh = new THREE.Mesh(new THREE.BoxGeometry(10, 10, 10), material);
    scene.add(mesh);
  },
  (progress) => {
    // 加载进度
  },
  (error) => {
    console.error('KTX2 纹理加载失败:', error);
  }
);
五、三大技术选型矩阵与性能验证实战
在实际工程中,这三项技术并不是互斥的,而是互为补充地应用在同一个三维工程的不同模块中。下表清晰列出了三者的选型维度、解决的痛点与限制条件:
| 优化技术 | 针对核心瓶颈 | 适用物体形态 | 运行时动态能力 | 显存 / 内存收益 | 工程限制与代价 |
|---|---|---|---|---|---|
| BufferGeometryUtils.mergeGeometries | CPU Draw Call 过载 | 完全静态的异构物体(形状各不相同) | 无动态能力(不可移动、旋转) | 小幅减少 JS 节点对象开销,显存总量基本不变 | 合并后丧失独立拾取(Raycast)与运动能力;要求属性一致 |
| THREE.InstancedMesh | CPU Draw Call 过载 | 海量重复的同构物体(几何外形一致) | 极强(每实例拥有独立的位姿、旋转、缩放) | 显存仅增加少量矩阵与颜色数组,性价比极高 | 物体外形与材质必须完全相同;视锥体剔除针对整组计算 |
| KTX2 / Basis 纹理压缩 | GPU 显存暴涨与总线带宽 | 全部材质贴图(BaseColor、Normal、Roughness 等) | 贴图本身静态,支持标准 UV 变换 | 显存与网络体积直降 70%~85%,防 OOM 崩溃 | 需要离线构建步骤;需要部署 Wasm 转码器脚本 |
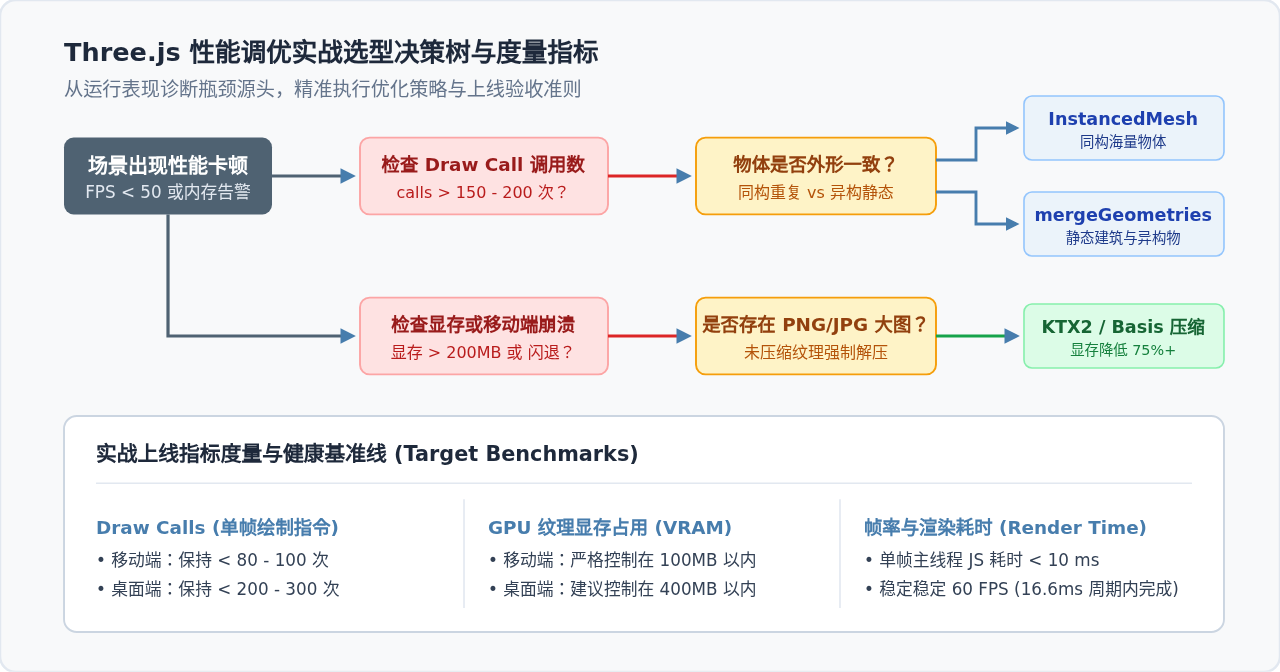
实时性能监测代码:确认优化生效
在优化实施前后,不要仅凭肉眼主观判断流畅度,应在代码中通过 renderer.info 打印底层实际渲染指标进行量化对比:
function logPerformanceMetrics(renderer) {
  const { render, memory } = renderer.info;
  console.table({
    'Draw Calls (当前帧)': render.calls,
    'Triangles (渲染三角面数)': render.triangles,
    'Lines (线段数)': render.lines,
    'Geometries 内存对象数': memory.geometries,
    'Textures 纹理对象数': memory.textures
  });
}

// 在动画循环或特定动作后调用查看
renderer.render(scene, camera);
logPerformanceMetrics(renderer);
当通过 BufferGeometryUtils.mergeGeometries 将 500 个静态构件合并后,你会观察到 render.calls 产生数百倍的断崖式下降;而在全量替换为 KTX2 纹理后,打开 Chrome 任务管理器(Shift + Esc)观察 GPU 进程内存(GPU Memory),将直观看到内存占用大幅下降,设备发热和移动端闪退问题得以彻底解决。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章