
深入解析JavaScript递归函数的底层执行模型与栈帧生命周期,系统讲解防御性终止条件的编写法则,剖析ES6尾调用优化(PTC)机制与现代引擎限制,并提供生产级蹦床函数与迭代重构方案。

当前位置:首页 > JavaScript 函数与作用域 > 正文
JavaScript递归函数编写指南:终止条件与尾调用优化
作者:青柠
时间:2026-11-03
浏览:549
文章目录
ECMAScript 核心机制与架构实战
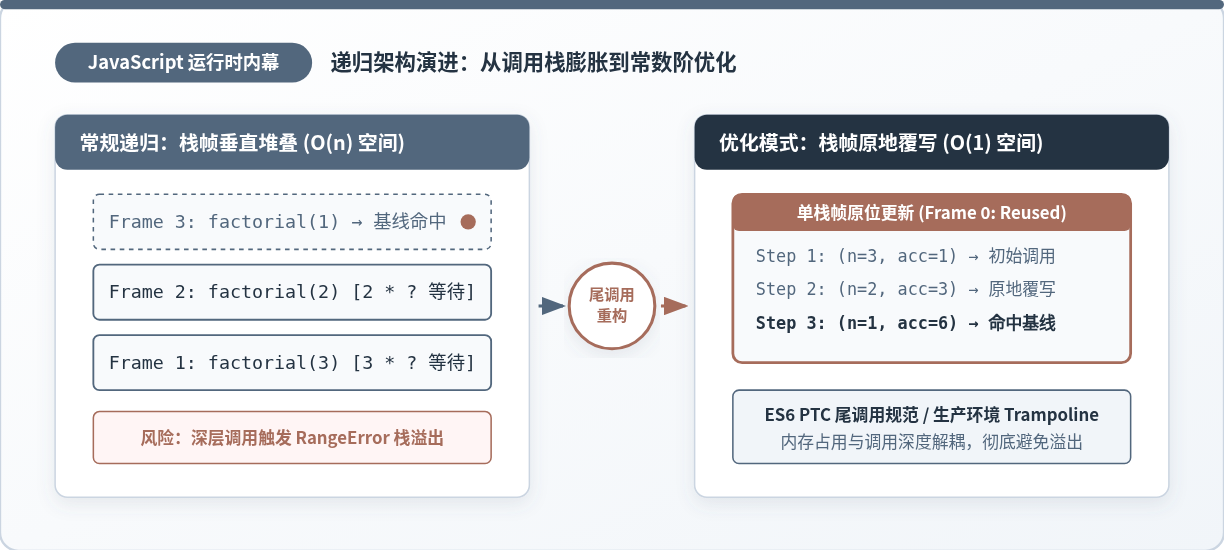
文章结构总览:从常规调用栈垂直膨胀到常数阶原位覆写
递归是函数通过直接或间接调用自身来分解子问题的编程范式。在 JavaScript 中编写健壮的递归函数,核心在于两项基本功:建立严谨且不可逾越的终止条件(Base Case),以及在深层计算场景下规避调用栈溢出(Stack Overflow)。本文从 V8 引擎执行栈模型切入,剖析递归压栈与回溯的实际过程,梳理防御性终止条件的编写法则,并详解尾调用优化(TCO)的规范要求、引擎支持现状以及工程中的替代方案(Trampoline 蹦床函数与迭代重写)。
一、递归在 JavaScript 调用栈中的执行模型
理解递归的第一步,必须直面 JavaScript 引擎底层的调用栈(Call Stack)。JavaScript 是一门单线程执行的语言,所有同步函数的调用、挂起与恢复,均依赖一个后进先出(LIFO)的执行上下文栈(Execution Context Stack)。
当我们调用一个函数时,引擎会为该函数分配一个栈帧(Stack Frame)。栈帧内部封装了当前函数的入参变量、局部变量、执行上下文环境以及函数执行完毕后需要返回的上一级内存指令地址(Return Address)。
阶乘函数执行生命周期的逐帧推导
我们以经典的阶乘计算 factorial(3) 为例,观察常规递归的代码与执行轨迹:
// 常规阶乘递归实现
function factorial(n) {
  // 步骤 1:基线终止条件
  if (n <= 1) {
    return 1;
  }
  // 步骤 2:递归深入与乘法运算挂起
  return n * factorial(n - 1);
}

factorial(3); // 计算结果:6
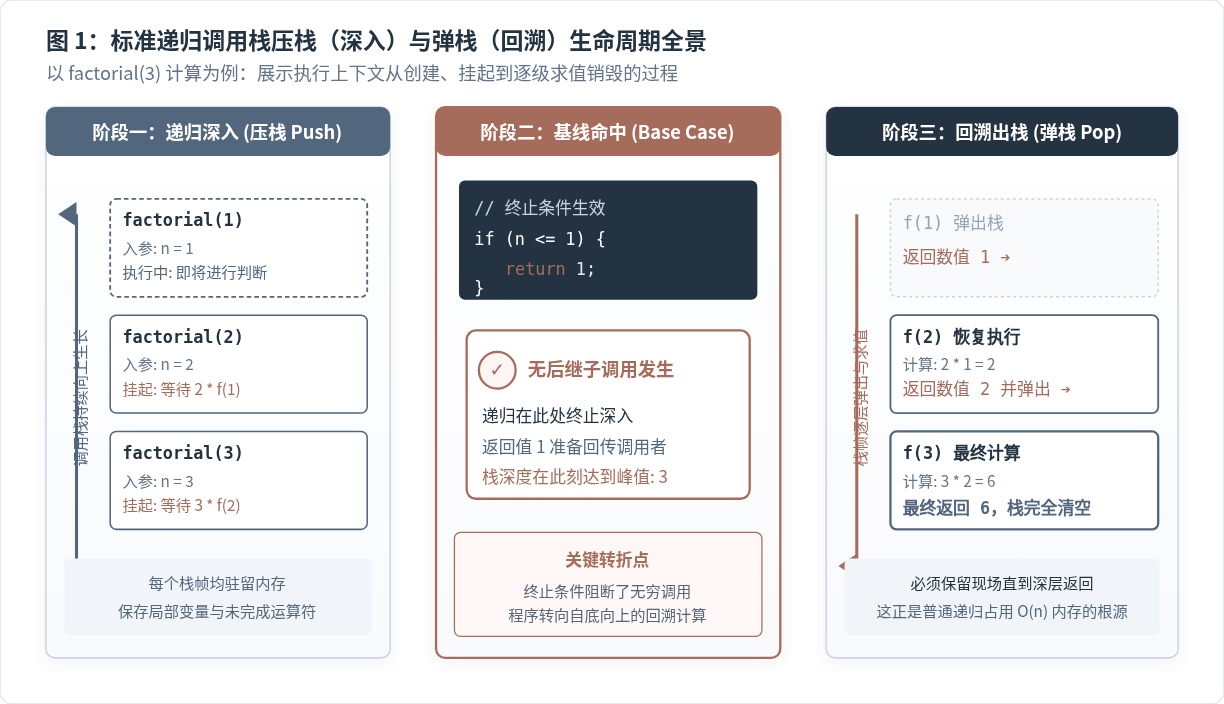
该函数的执行过程严格分为三个物理阶段:
-
阶段一:递归深入(压栈 Push):调用
factorial(3)时,Frame 1 入栈;执行至return 3 * factorial(2)时,因为乘法操作依赖factorial(2)的结果,当前帧无法释放,只能挂起保存在内存中。随后factorial(2)创建 Frame 2 压入栈顶,再次挂起等待factorial(1)。 -
阶段二:基线命中(Base Case Reached):调用
factorial(1)时,Frame 3 入栈。此时n <= 1为真,函数不再调用自身,直接返回常量1。此时调用栈深度达到峰值(3 层)。 -
阶段三:回溯出栈(弹栈 Pop & Return):Frame 3 返回
1并销毁出栈;挂起在栈顶的 Frame 2 恢复执行,计算2 * 1 = 2后返回并销毁;Frame 1 恢复执行,计算3 * 2 = 6后返回最终值,调用栈清空归零。
图 1:标准递归调用栈压栈(深入)与弹栈(回溯)生命周期全景
调用栈溢出的本质:RangeError: Maximum call stack size exceeded
在标准递归中,只要子函数尚未返回,所有上层父级栈帧就必须全部驻留内存。调用栈并非无限空间,各个浏览器和 Node.js 运行时的栈深度上限通常在 10,000 到 25,000 帧左右(取决于单帧局部变量大小与系统内存分配)。一旦递归未设终止条件或递归层级过深,栈空间耗尽时引擎便会直接抛出致命的 RangeError。
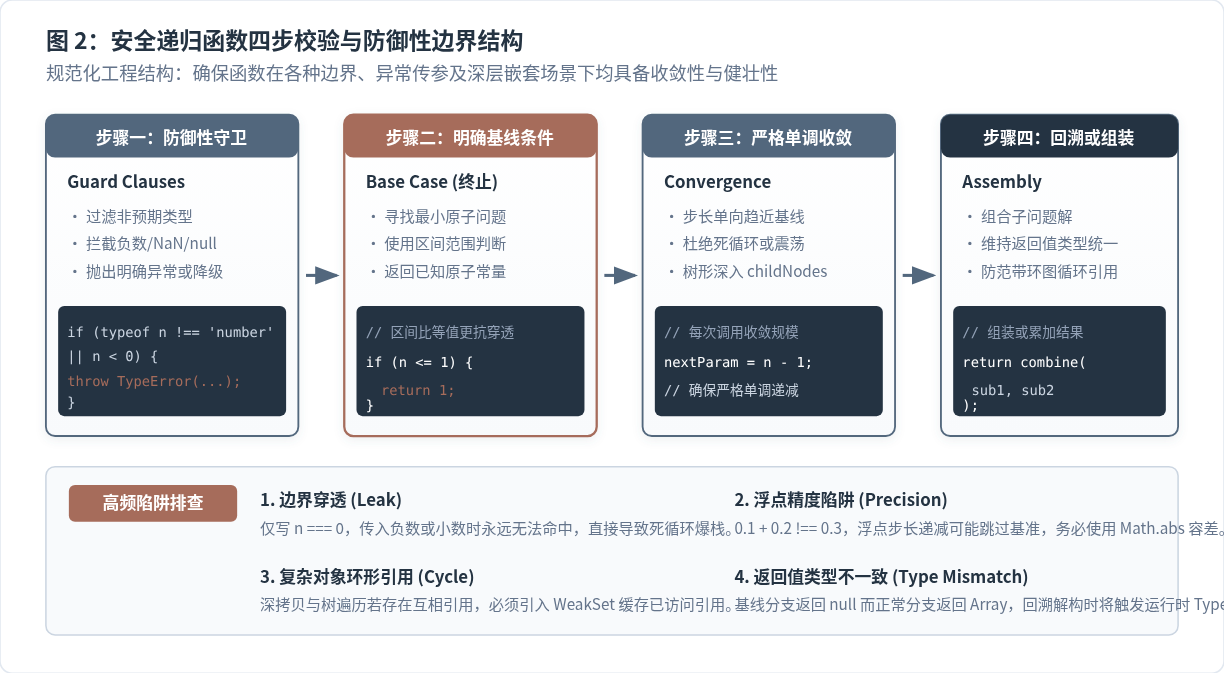
二、编写健壮终止条件(Base Case)的四个黄金法则
终止条件(基线条件)是递归函数的“安全气囊”。很多开发者往往只写了一个简单的等值判断,例如 if (n === 0) return 1;,但在复杂的真实工程环境中,这种脆弱的判断极易被非法输入击穿。
法则一:设置严格的防御性守卫(Guard Clause)
如果调用者传入负数 factorial(-5)、浮点数 factorial(2.5)、NaN 甚至字符串,每次步长减 1 的操作将永远“跳过” n === 0,导致程序毫无阻碍地走向无线递归直至程序崩溃。因此,防御性守卫必须前置于所有逻辑之前:
function robustFactorial(n) {
  // 1. 入参类型与合法性守卫:杜绝非法数据引发无限递归
  if (typeof n !== 'number' || Number.isNaN(n) || !Number.isInteger(n)) {
    throw new TypeError("参数必须为有效整数");
  }
  if (n < 0) {
    throw new RangeError("阶乘不支持负数运算");
  }

  // 2. 区间型基线条件:使用 <= 比单一 === 具备更强的抗穿透能力
  if (n <= 1) {
    return 1;
  }

  return n * robustFactorial(n - 1);
}
法则二:确保实参单调收敛(Monotonic Convergence)
每一次递归调用传入的参数,必须以确定的步长向基线条件严格靠拢。如果每次传递的参数在集合空间中发散或产生周期性震荡(例如交替正负变换而没有缩小绝对值),递归就无法收敛。
法则三:复杂树形与带环图结构的循环引用防御
在进行深拷贝(Deep Clone)、AST 抽象语法树遍历或 DOM 节点递归解析时,如果对象之间存在相互引用(循环引用),递归将陷入无休止的死循环。必须引入一个 WeakSet 或 WeakMap 追踪已访问节点的内存地址:
// 带循环引用防御的对象深拷贝递归示例
function safeDeepClone(target, visited = new WeakMap()) {
  // 基线条件 1:原始类型直接返回
  if (target === null || typeof target !== 'object') {
    return target;
  }

  // 基线条件 2:检测是否已遍历过该引用(拦截环形引用)
  if (visited.has(target)) {
    return visited.get(target);
  }

  const cloneTarget = Array.isArray(target) ? [] : {};
  visited.set(target, cloneTarget);

  // 子问题收敛推进
  for (const key of Reflect.ownKeys(target)) {
    cloneTarget[key] = safeDeepClone(target[key], visited);
  }

  return cloneTarget;
}
图 2:安全递归函数四步校验与防御性边界结构
三、什么是尾调用与尾调用优化(TCO)
在理解尾递归优化之前,需要明确一个严格的语言层概念——尾调用(Tail Call)。
尾调用的精确定义是:某个函数的最后一步操作,是直接返回另一个函数调用的执行结果。
尾调用与非尾调用的形式鉴别
以下几种常见的代码写法,很多初学者容易误以为是尾调用,但实际上破坏了尾调用特征:
// 示例 1:标准的尾调用(最后一步操作就是调用 g 并返回)
function case1() {
  return g(); // 正确
}

// 示例 2:非尾调用!因为调用完 g() 后,还需要执行加法计算
function case2() {
  return g() + 1; // 错误:有挂起的二元加法运算
}

// 示例 3:非尾调用!因为外层函数没有 return,执行完 g() 后还隐含 return undefined
function case3() {
  g(); // 错误:末尾存在隐式返回
}

// 示例 4:标准的尾调用(将计算好的最终表达式传给 g)
function case4(x) {
  return g(x * 2 + 1); // 正确:参数运算在发生调用之前完成
}
尾调用优化(Tail Call Optimization, TCO)的运行机理
当一个函数的最后一步是尾调用时,外层函数在发起调用之后已经没有任何剩余的代码需要执行,外层栈帧中保存的局部变量、作用域链和计算状态已经失去了继续存在的价值。
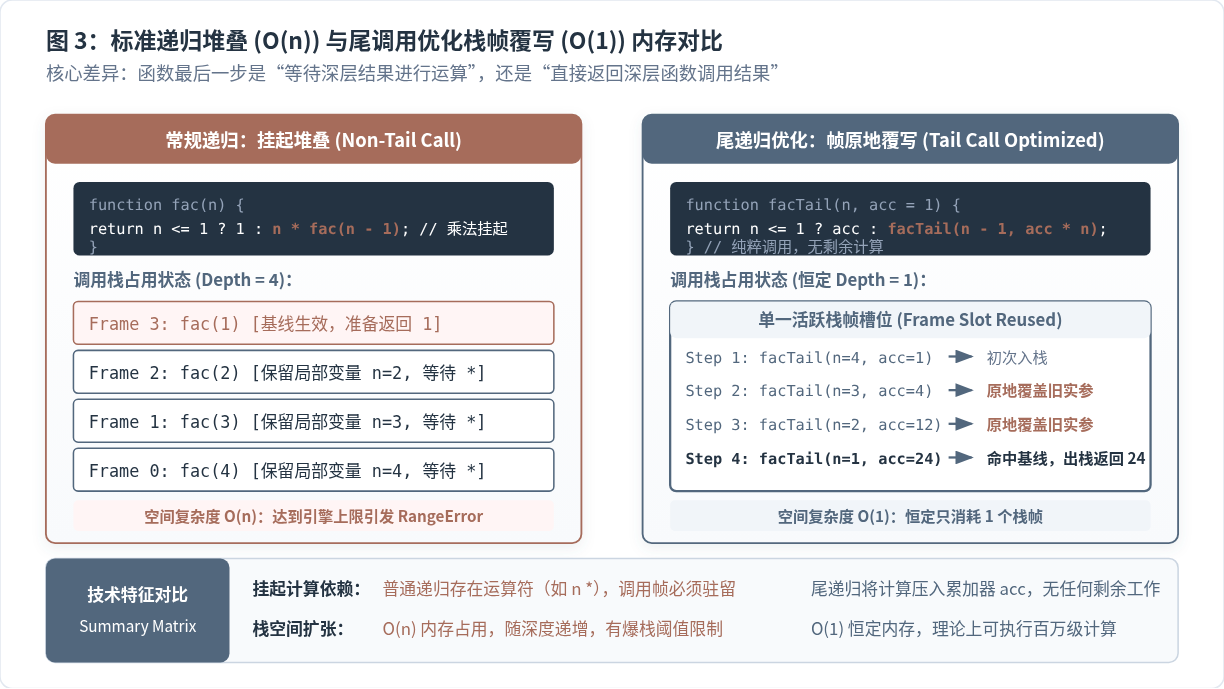
在支持尾调用优化的引擎中,引擎不会为被调用的函数开辟新的栈帧堆叠在上方,而是直接用被调用函数的栈帧覆盖(Overwrite)当前函数的栈帧,或者在同一栈帧槽位内就地更新参数。
这样一来,无论函数自我调用了 10 次、1,000 次还是 1,000,000 次,在物理调用栈上自始至终只占据唯一一个活动栈帧。空间复杂度从传统递归的 O(n) 彻底降为 O(1)!
图 3:标准递归堆叠 (O(n)) 与尾调用优化栈帧覆写 (O(1)) 内存对比
如何将传统递归重构成尾递归:累加器模式(Accumulator)
要将一个递归函数改为尾递归,核心思路是:把原本留给回溯阶段执行的计算,提前在深入阶段计算完毕,并通过参数(累加器 accumulator)逐层向下传递。
// 传统递归:乘法挂起在栈帧回溯中
function factorialStandard(n) {
  if (n <= 1) return 1;
  return n * factorialStandard(n - 1); // 非尾调用
}

// 尾递归改造:引入累加器 acc 保存中间结果
function factorialTail(n, acc = 1) {
  if (n <= 1) return acc; // 命中基线时,累加器中已经存放了最终答案
  // 关键点:直接返回调用结果,乘法运算作为实参传入,无任何挂起
  return factorialTail(n - 1, acc * n);
}
四、ECMAScript 规范要求与现代 JavaScript 引擎现状
许多开发者在了解尾递归优化后,便尝试在 Node.js 或 Chrome 浏览器控制台中执行 factorialTail(500000, 1),结果却震惊地发现依然抛出了 RangeError: Maximum call stack size exceeded。这背后的原因是什么?
ES6 规范中的严格条件(Proper Tail Calls, PTC)
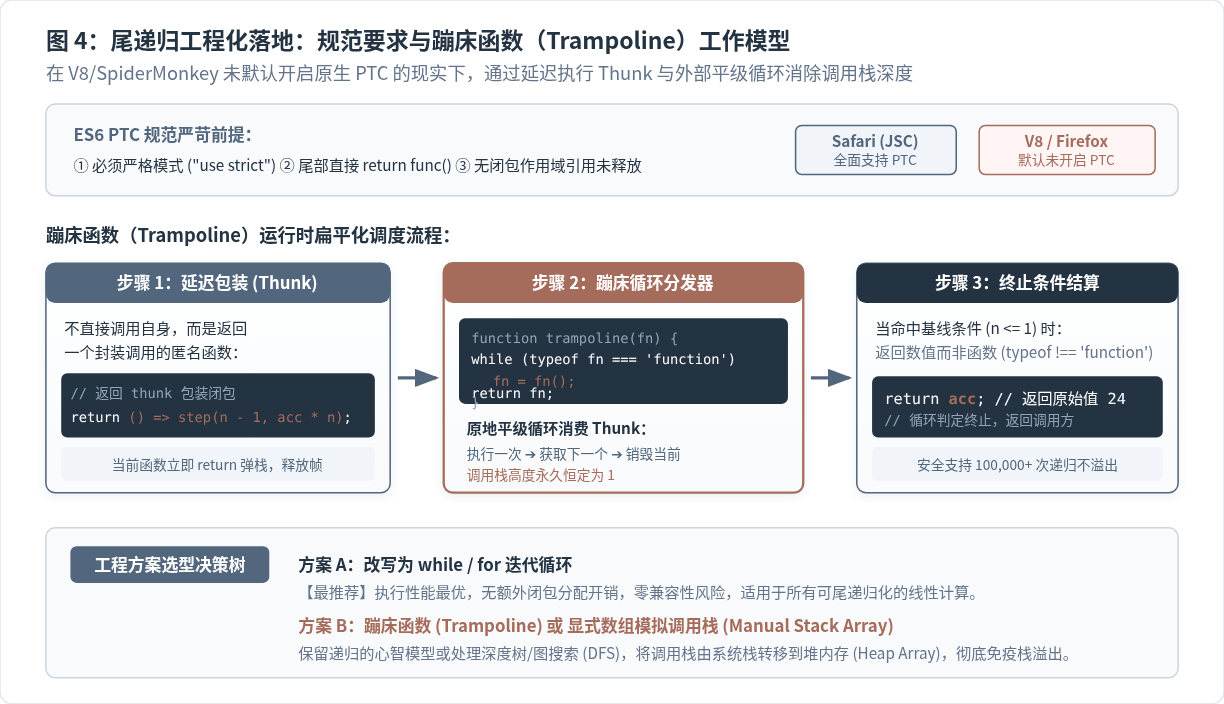
ECMAScript 2015 (ES6) 在标准规范中明确写入了 Proper Tail Calls(尾调用优化)。然而,规范附带了三个极其严苛的前提条件:
- 必须处于严格模式(
"use strict"):在非严格模式下,JavaScript 函数对象拥有func.arguments和func.caller这两个旧式反射属性,允许程序向上窥探调用者的栈帧。如果优化掉中间栈帧,这些属性的行为将被彻底破坏。 - 尾调用必须直接作为返回值:必须明确为
return expr结构。 - 不能引用外层函数的活动闭包:如果尾调用的函数内部捕获并保持了外层函数的词法环境,当前栈帧无法安全释放。
各大引擎对 PTC 的实现分歧
| JavaScript 引擎 | 代表宿主环境 | 原生 PTC 支持现状 | 底层考量与设计分歧 |
|---|---|---|---|
| JavaScriptCore (JSC) | Safari / WebKit 全线 | 完全支持 | 严格遵守 ES6 规范标准,在字节码层实现了帧重写与栈收缩。 |
| V8 | Chrome, Edge, Node.js | 默认关闭 |
1. 调用栈追踪失效:栈帧覆写会导致 Error.stack 丢失中间层级,增加线上故障排查难度;2. 开发者社区曾提议显式语法(如 return continue expr),但未达成委员会共识。
|
| SpiderMonkey | Firefox 浏览器 | 默认关闭 | 基于与 V8 类似的调试可用性、堆栈信息完整度及性能边界权衡,暂未默认开启。 |
工程结论
在当下的跨端开发与服务端 Node.js 体系中,我们不能寄希望于运行时环境提供原生的 PTC 优化。一旦算法的递归深度突破一万层,必须在应用层采用经过工程验证的替代方案。
五、生产环境下的尾递归降级与工程替代方案
在不能依赖原生尾调用优化的现实下,如何让深层递归逻辑安全高效地运行?业界存在两种标准解法:迭代转换(Looping)与蹦床函数(Trampoline Pattern)。
方案一:迭代循环重写(性能最高,首选方案)
所有可以被改写为尾递归的逻辑,本质上都可以等价地转化为一个 while 或 for 循环。尾递归的各个参数,自然对应循环体中的状态更新:
// 迭代转换:使用 while 循环消除所有函数调用开销
function factorialIterative(n) {
  if (n <= 1) return 1;

  let acc = 1;
  let current = n;

  while (current > 1) {
    acc *= current;
    current--;
  }

  return acc;
}

// 轻松支持百万次计算,调用栈高度始终为 0,零额外内存分配
factorialIterative(1000000);
方案二:蹦床函数(Trampoline Pattern)
如果不希望把优雅的递归思维完全拆解为带有变量变异(Mutation)的迭代结构,或者在处理复杂树遍历调度时希望保留函数式风格,蹦床函数(Trampoline)是最经典的工程模式。
蹦床原理:
- 尾递归函数在每一次执行时,不再直接调用自身,而是返回一个包装了下一次调用的延迟函数(Thunk)。
- 当前函数执行完毕立即
return并销毁其栈帧。 - 一个外部调度器(蹦床循环)接管该 Thunk,在一个平级的
while循环中不断执行这个 Thunk,直到它返回一个不是函数的终值。
// 1. 通用蹦床函数调度器
function trampoline(fn) {
  return function (...args) {
    let result = fn(...args);
    // 只要返回的是可调用的函数对象,就在循环中平级求值
    while (typeof result === 'function') {
      result = result();
    }
    return result;
  };
}

// 2. 使用 Thunk 包装尾递归步骤
function fibStep(n, a = 0n, b = 1n) {
  if (n === 0) return a;
  if (n === 1) return b;
  // 关键点:返回一个匿名函数包裹下一次执行,当前函数立刻出栈
  return () => fibStep(n - 1, b, a + b);
}

// 3. 组装为抗栈溢出的安全函数
const safeFib = trampoline(fibStep);

// 即使递归 100,000 次,栈深度恒定为 1,完美运行
console.log(safeFib(100000));
图 4:尾递归工程化落地:规范要求与蹦床函数(Trampoline)工作模型
六、递归函数实战编码检查清单
在代码评审或编写涉及深层嵌套结构的业务逻辑时,建议按以下清单进行逐项核验:
-
基线覆盖度验证:是否存在某种入参分支(如负数、边界极大值、
undefined),会导致逻辑绕过基线条件? - 步长收敛性判定:传给下一次调用的实参,是否确保在每一步中都单向逼近终止边界?步长是否存在由于浮点精度损失而无法精确匹配的可能?
-
深度预估与选型:业务数据预期的最大递归层级是多少?若在极端情况下可能超过 1,000 层,坚决避免使用标准递归,应改用
while循环、显式数组堆栈或蹦床模式。 -
返回值语义一致:基线返回分支与递归合并分支的返回值类型是否绝对统一,避免上层解构抛出
TypeError。 -
引用环检测:针对图、树、深拷贝等复合对象递归,是否已装配
WeakSet/WeakMap防御死循环?
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章