
深入讲解JavaScript DOM操作的核心方法,包括如何精准获取页面元素(getElementById、querySelector)、如何安全高效修改文本与HTML结构、修改表单值与CSS类名,并结合完整实战案例与避坑指南,帮助初学者扎实掌握页面动态交互技能。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JavaScript DOM操作实战:怎么获取元素与修改页面内容
作者:流萤
时间:2026-11-03
浏览:231
文章目录
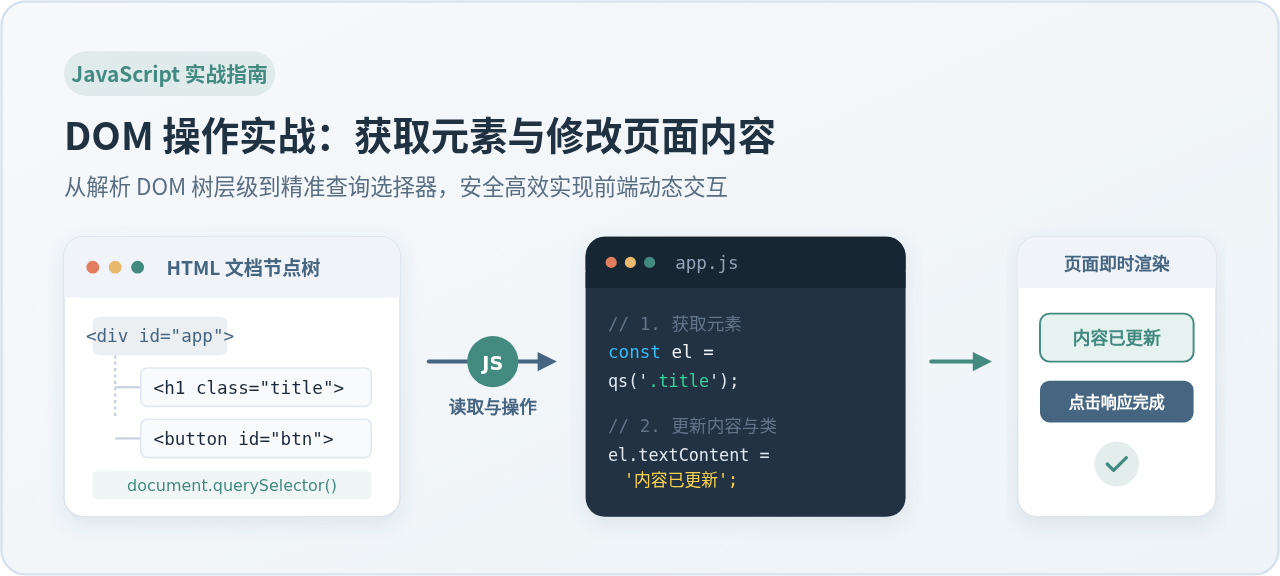
网页中的所有即时交互——例如点击按钮展开抽屉、表单校验即时提示、异步拉取数据后更新列表——底层都建立在 JavaScript 对 DOM(文档对象模型)的操作之上。要完成这些交互,核心逻辑归纳起来只有两步:第一步是通过程序准确获取页面中的目标元素,第二步是安全地读取或改变该元素的内容与属性。本文将通过实战代码、方法对比与典型避坑流程,直接讲解这两项关键技能的具体操作。
一、DOM 树与节点:浏览器是如何组织网页的
当浏览器加载 HTML 代码时,并不会直接把文本作为简单的纯文本文件来处理,而是会在内存中构建一棵由对象构成的树状模型,即 DOM(Document Object Model,文档对象模型)。每个 HTML 标签、标签内的文字以及标签上的属性,在内存中都被映射成特定类型的“节点(Node)”。
在这棵树的最顶层是全局的 document 对象,它代表当前打开的整个网页文档,也是 JavaScript 访问页面所有内容的入口根节点。从根节点往下延伸,依次是 <html> 根元素、<head>、<body>,再到开发者编写的段落、标题、按钮等子元素。
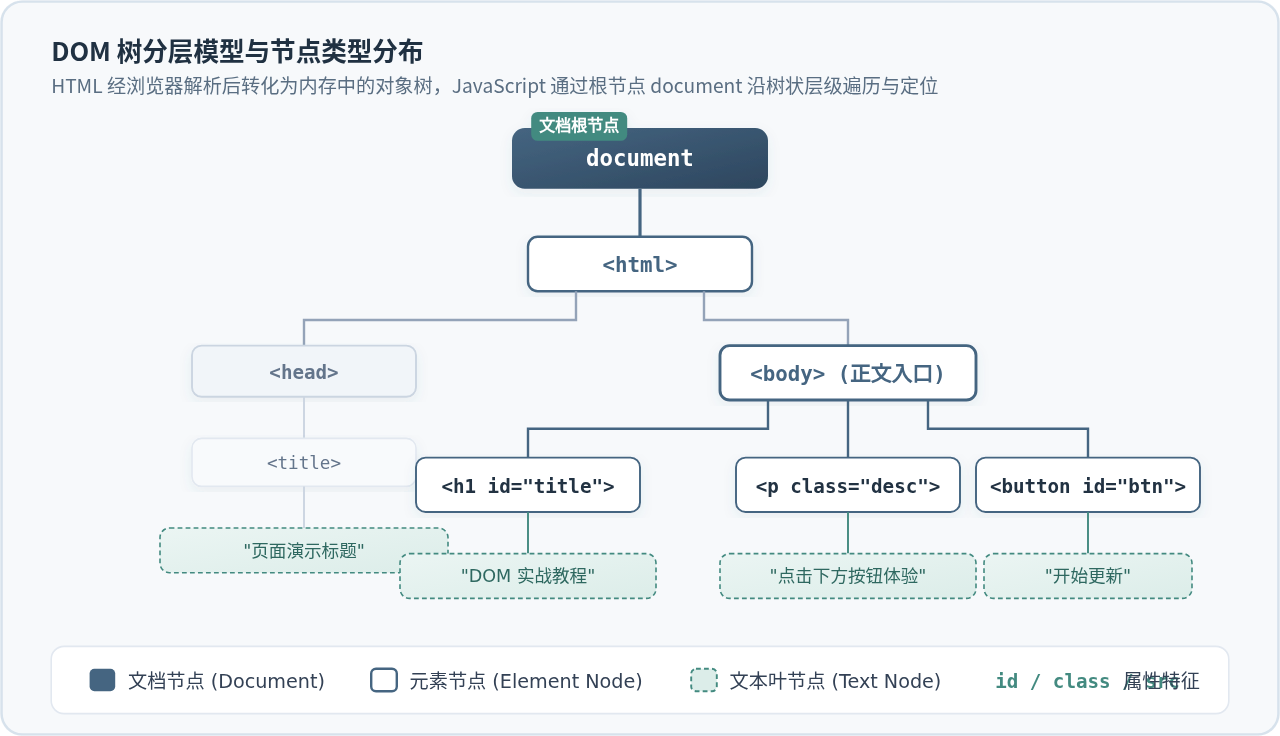
理解这种父子、兄弟的树状嵌套关系非常重要。我们在屏幕上看到的文字(如按钮上的“提交”),在底层实际上是挂载在元素节点下方的“文本节点(Text Node)”;而元素的 id、class 或 href 则是该元素所拥有的属性。JavaScript 对界面的修改,本质上就是对这棵内存树上的节点属性进行重新赋值或增删替换,浏览器监听到树结构变动后,会自动重新计算样式并重绘页面。
二、怎么获取页面元素:常用 API 与最佳选用策略
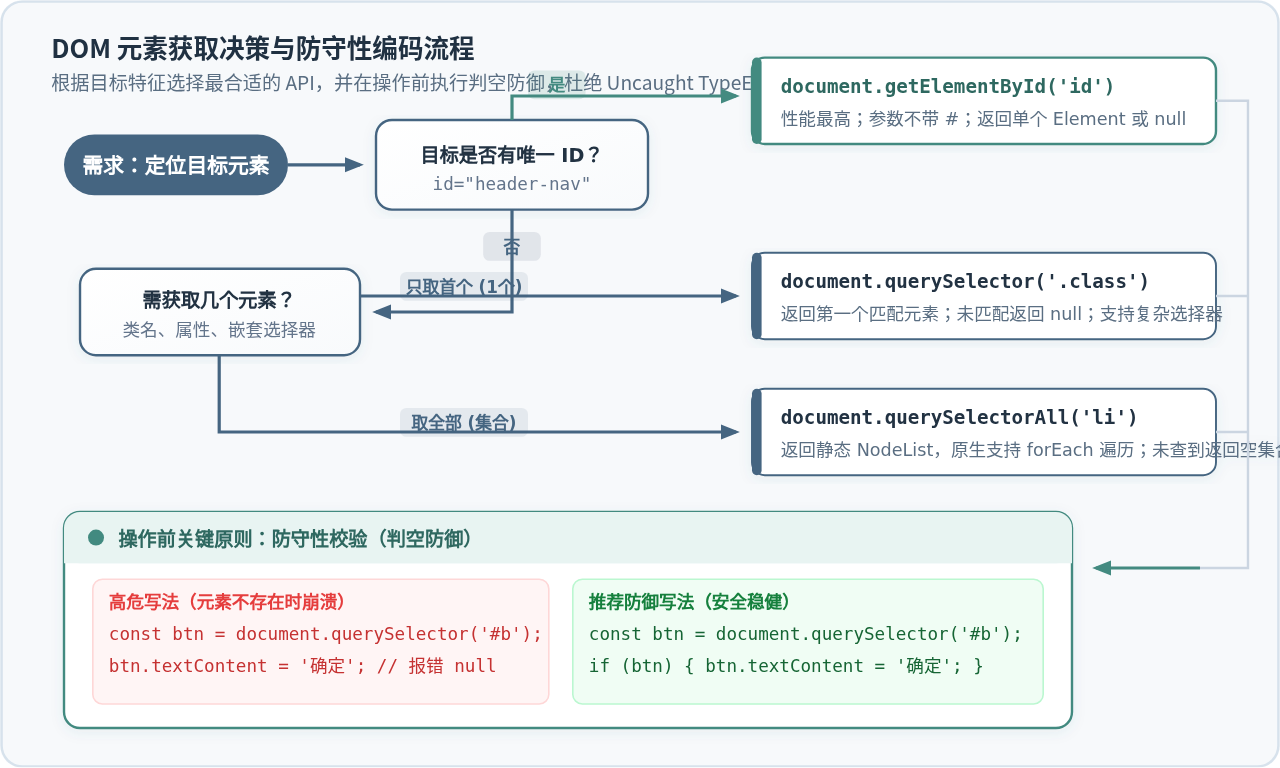
想要修改某个元素,前提是必须先在 DOM 树中拿到指向它的引用。在现代 JavaScript 开发中,最常用的获取方法主要包括针对唯一 ID 的精准获取,以及基于 CSS 选择器的通用查询。
1. 通过唯一 ID 精准获取:document.getElementById()
如果目标 HTML 元素拥有唯一的 id 属性,直接使用 document.getElementById() 是最直接且执行效率最高的方式。
<!-- HTML 结构 -->
<h1 id="main-title">原始标题</h1>

// JavaScript 获取
const titleElement = document.getElementById('main-title');
console.log(titleElement); // 输出对应的 <h1> 元素对象
使用提示
getElementById 的参数是纯字符串 ID 名,不需要加 CSS 选择器的 # 前缀。如果页面上不存在该 ID 的元素,此方法会安全地返回 null。
2. 通过 CSS 选择器获取单个元素:document.querySelector()
当你需要按类名、属性或更复杂的层级关系查找元素,且只需要获取满足条件的第一个元素时,推荐使用 document.querySelector()。它的参数写法与 CSS 选择器完全一致。
<!-- HTML 结构 -->
<div class="card active">
  <p class="desc">卡片描述信息</p>
</div>

// JavaScript 获取
const activeCard = document.querySelector('.card.active');
const descText = document.querySelector('.card .desc');
3. 通过 CSS 选择器获取所有匹配元素:document.querySelectorAll()
如果需要获取一组同类元素(如导航栏中所有的链接、列表里所有的 <li>),应使用 document.querySelectorAll()。它会返回一个包含所有匹配节点的静态 NodeList 集合。
<!-- HTML 结构 -->
<ul id="tag-list">
  <li>JavaScript</li>
  <li>DOM 操作</li>
  <li>前端实战</li>
</ul>

// JavaScript 获取并循环遍历
const tagItems = document.querySelectorAll('#tag-list li');

// NodeList 支持直接使用 forEach 遍历
tagItems.forEach((item, index) => {
  console.log(`第 ${index + 1} 项内容:`, item.textContent);
});
容易忽视的报错:Cannot read properties of null
初学者最常遇到的 JavaScript 报错之一是:
Uncaught TypeError: Cannot read properties of null (reading 'textContent')。其根本原因就是通过 getElementById 或 querySelector 查找元素时,拼写错误或选择器未匹配到任何节点,方法返回了 null。紧接着对 null 读取属性就会引发脚本抛错中断。因此,在访问元素前加入 if (!elem) return; 或使用可选链 elem?.textContent 是至关重要的防守习惯。
三、怎么修改页面内容与属性:文本、结构、表单与样式
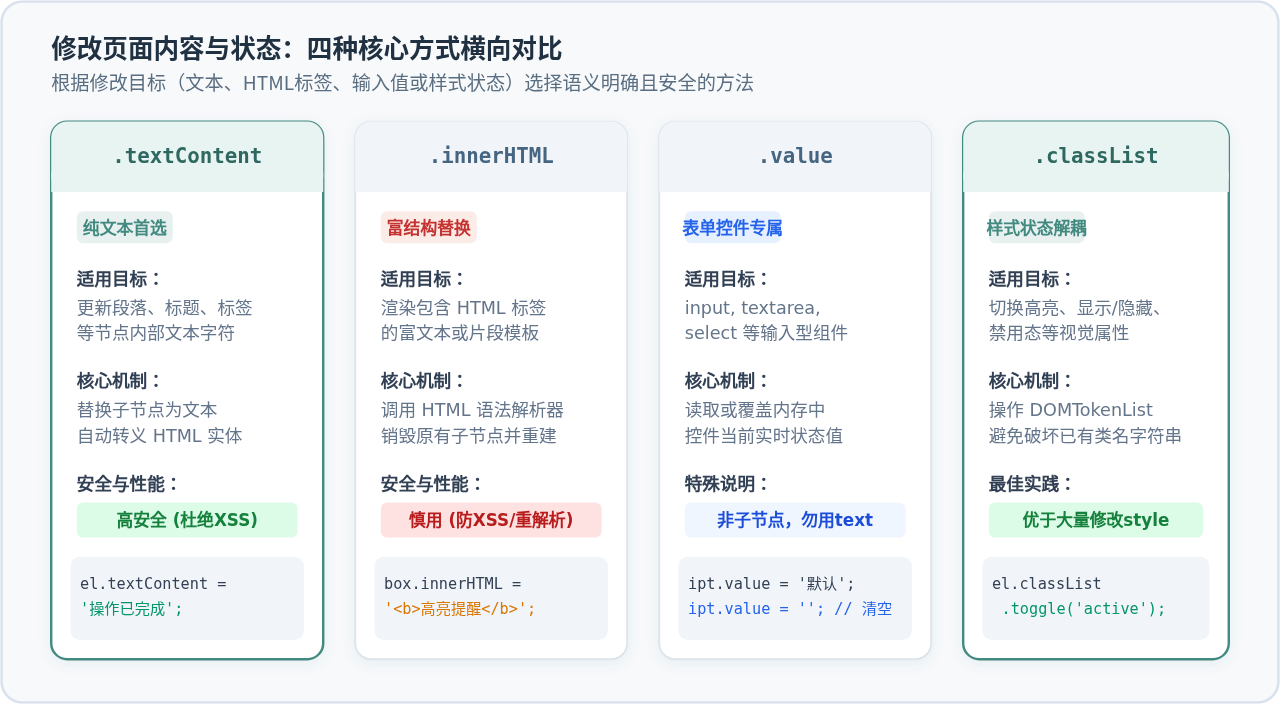
成功获取到元素节点后,接下来的核心任务是根据业务逻辑改变界面的呈现。修改的内容可以分为四大维度:纯文本、HTML结构、表单值以及类名与属性。
1. 修改纯文本:优先选用 textContent
如果你的需求只是改变标签内部的字,例如更改按钮文案、修改标题文字或显示计算结果,首选且应当始终优先使用 textContent。
const statusNotice = document.querySelector('#status-notice');
if (statusNotice) {
  // 安全修改文本内容,不会解析传入的 HTML 字符
  statusNotice.textContent = '数据已成功同步至服务器';
}
与历史遗留的 innerText 相比,textContent 的优势十分明显:textContent 返回和设置所有文本(包含隐藏元素的文本),且不会触发浏览器的重排计算(Layout Reflow),性能明显更高;更关键的是,它会对任何传入的内容当作普通纯文本处理,天然规避了 XSS 跨站脚本注入风险。
2. 修改 HTML 结构:谨慎使用 innerHTML
当你确实需要向容器内部插入富文本标签(如 <strong>、<span>)或重构一段嵌套结构时,可以使用 innerHTML。
const messageBox = document.querySelector('.message-box');
if (messageBox) {
  // 替换为包含 HTML 标签的结构
  messageBox.innerHTML = '<span class="badge">提醒</span><strong>请尽快保存草稿</strong>';
}
安全红线:防范 XSS 漏洞
绝不要将未经转义过滤的用户输入(如来自输入框的值、URL参数或用户发表的评论)直接通过
innerHTML 赋值。如果输入中包含 <img src="x" onerror="alert(1)">,恶意脚本将会直接在访问者浏览器中执行。展示用户内容时必须使用 textContent。
3. 读取与修改表单控件值:使用 .value
文本输入框(<input>)、多行文本域(<textarea>)以及下拉选择框(<select>)的内容并不属于元素的内部子节点,因此不能通过 textContent 来读取或修改,而必须通过 .value 属性进行操作。
const usernameInput = document.querySelector('#username');
if (usernameInput) {
  // 1. 读取用户当前输入的内容
  const currentVal = usernameInput.value.trim();

  // 2. 修改/重置输入框的内容
  usernameInput.value = ''; // 清空输入框
}
4. 修改类名与外观样式:使用 classList
在实际项目中,直接在 JS 里修改 element.style.color = 'red' 往往会导致样式与逻辑混杂,难以维护。最佳实践是在 CSS 文件中预定义好状态类,然后在 JavaScript 中通过 classList 进行增删或切换。
| 方法 | 示例代码 | 作用说明 |
|---|---|---|
classList.add() |
elem.classList.add('is-active') |
向元素添加一个或多个类名,若已存在则忽略 |
classList.remove() |
elem.classList.remove('loading') |
从元素中移除指定类名,若不存在不报错 |
classList.toggle() |
elem.classList.toggle('collapsed') |
切换类名:存在则移除,不存在则添加 |
classList.contains() |
if (elem.classList.contains('open')) |
判断元素是否包含指定类名,返回布尔值 |
四、完整实战:待办清单动态添加与内容修改
下面我们通过一个直观的“待办任务清单”微应用,将“获取元素”、“读取表单输入”、“创建与挂载节点”、“修改文本与切换状态”串联成完整的开发闭环。
1. HTML 与基础样式结构
<!-- 容器组件结构 -->
<div class="todo-widget">
  <h3>待办任务管理 (<span id="task-count">0</span>)</h3>

  <div class="input-group">
    <input type="text" id="todo-input" placeholder="请输入待办事项..." />
    <button type="button" id="add-btn">添加任务</button>
  </div>

  <ul id="todo-list"></ul>
</div>
2. JavaScript 实现逻辑
// 等待页面 DOM 完全加载后执行
document.addEventListener('DOMContentLoaded', () => {
  // 步骤 1:精确获取各个目标元素
  const todoInput = document.getElementById('todo-input');
  const addBtn = document.getElementById('add-btn');
  const todoList = document.getElementById('todo-list');
  const taskCount = document.getElementById('task-count');

  // 防守性验证:确保核心节点均存在
  if (!todoInput || !addBtn || !todoList || !taskCount) return;

  // 辅助函数:更新统计数量
  function updateCount() {
    const total = todoList.querySelectorAll('li').length;
    taskCount.textContent = total;
  }

  // 步骤 2:监听按钮点击事件
  addBtn.addEventListener('click', () => {
    // 读取并清理用户输入
    const text = todoInput.value.trim();
    if (text === '') {
      alert('请输入任务内容!');
      return;
    }

    // 步骤 3:动态创建 li 元素并赋予纯文本
    const li = document.createElement('li');
    li.textContent = text; // 确保用户输入以纯文本安全渲染

    // 点击任务项可切换完成划线状态
    li.addEventListener('click', () => {
      li.classList.toggle('completed');
    });

    // 挂载到列表中
    todoList.appendChild(li);

    // 步骤 4:清空输入框并更新计数
    todoInput.value = '';
    updateCount();
  });
});
在这个案例中,各个操作环环相扣:首先使用 getElementById 在容器就绪后拿到输入框、按钮和列表容器;点击时通过 todoInput.value 读取文本,通过 createElement 产生新的节点,使用 textContent 填充安全内容,最后通过 appendChild 挂载并用 classList.toggle 管理交互状态。每个步骤职责分明,逻辑直观。
五、核心总结与避坑全景指南
在实际业务开发中,代码之所以出现偶发性 Bug 或性能瓶颈,往往是因为忽略了脚本生命周期、集合特性或安全规范。遵循以下四阶段原则,可以有效避免大多数 DOM 操作陷阱:
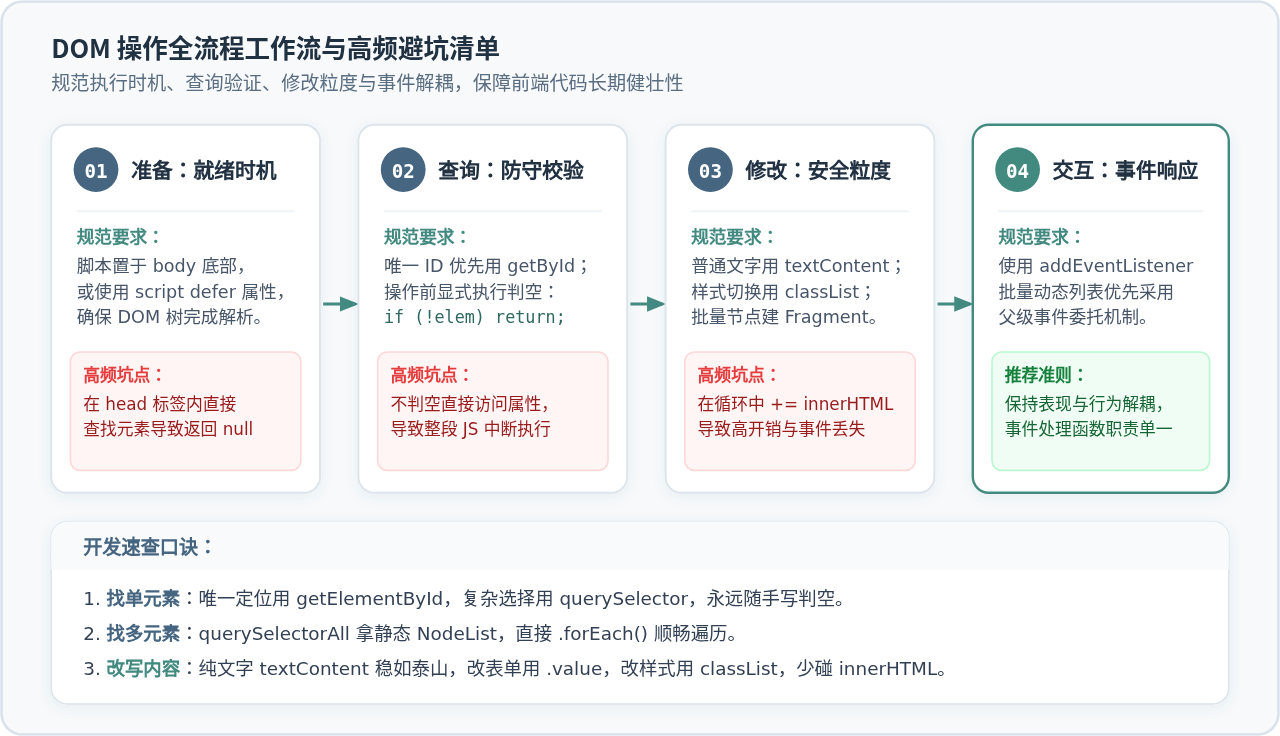
-
注意脚本的加载时机:如果
<script>放在<head>标签中且没有加defer属性,浏览器执行到 JS 时页面下方的 HTML 尚未被解析,调用querySelector就会拿到null。建议将脚本置于</body>标签闭合前,或使用<script defer src="...">。 -
杜绝循环中频繁拼接
innerHTML:在for循环中写list.innerHTML += '<li>...</li>'会在每次循环时都销毁已有的全部子节点并重新解析渲染,不仅性能极差,还会丢失子节点上已绑定的事件监听器。大批量更新时应使用document.createDocumentFragment()或先在内存中构建好 HTML 字符串后一次性赋值。 -
区分 NodeList 与 HTMLCollection:
querySelectorAll返回的 NodeList 是静态快照(后续添加新元素不会自动更新),原生支持.forEach();而旧 API 如getElementsByTagName返回的是动态的 HTMLCollection,没有.forEach()方法且随 DOM 变动实时变化,在循环中修改 DOM 时极易引发死循环。现代开发中优先选用querySelectorAll。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章