

针对JavaScript在前端或与后端联调中出现的中文加密乱码、解密报错或解密失败问题,深入分析字符编码机制与密码学参数对齐策略,提供标准化排查步骤与完整可运行代码。
JS加密后的数据中文乱码或解密失败怎么解决
作者:性能诊所
时间:2026-11-03
浏览:436
文章目录
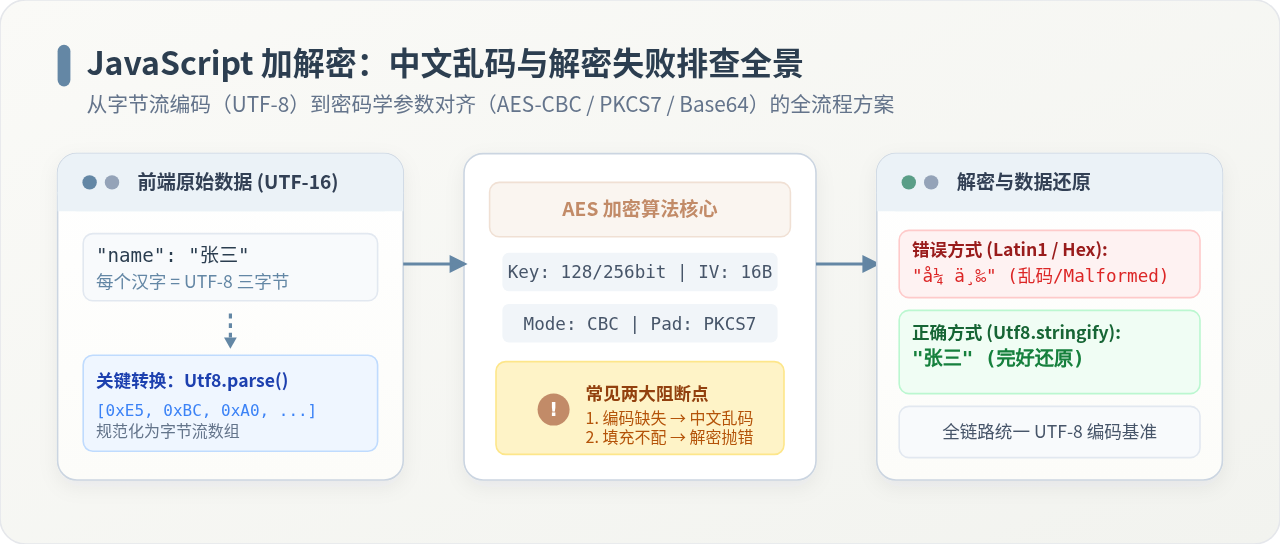
缩略图:JavaScript 加解密中的中文字符转换与密码学要素全景
在 JavaScript 前端加密或前后端对接场景中,包含中文的数据在解密后出现乱码或直接解密失败,根源通常集中在两个环节:一是中文字符在内存中的 UTF-16 表示与底层加密算法所需的字节流之间发生了字符集映射偏差(例如被默认降级为单字节 Latin1 处理);二是加解密两端在工作模式、填充规则、密钥/向量字节长度或网络传输转义上存在不一致。解决此问题的核心路径是建立严格的“全链路 UTF-8 字节编码基准”,并对齐加解密四要素(算法、模式、填充、密钥/IV)。
一、定位问题:区分解密报错与解密后乱码
遇到数据无法正确恢复时,不能盲目更换加密库或调整密钥。排查的第一步是观察控制台日志与运行表现,将故障准确归类为以下两种本质不同的表象:
| 故障表象 | 控制台常见报错日志 | 本质定界与首要排查方向 |
|---|---|---|
| 表现 A:解密直接报错中断 |
Malformed UTF-8 dataBadPaddingException: Given final block not properly paddedInvalid key length
|
密文损坏、填充模式不匹配(如 PKCS7 vs ZeroPadding)、网络传输中 Base64 符号被篡改(如 + 变为空格),或者密钥/IV 长度不符。 |
| 表现 B:解密未报错但中文为乱码 |
"ä½ å¥½" (双字节乱码)"?" (替换符乱码)"e4bda0e5a5bd" (Hex未还原)
|
密文已经成功解密为原始字节流,但在“字节流转回字符串”阶段使用了错误的字符编码格式(如误用 Latin1 或默认 Hex 格式输出)。 |
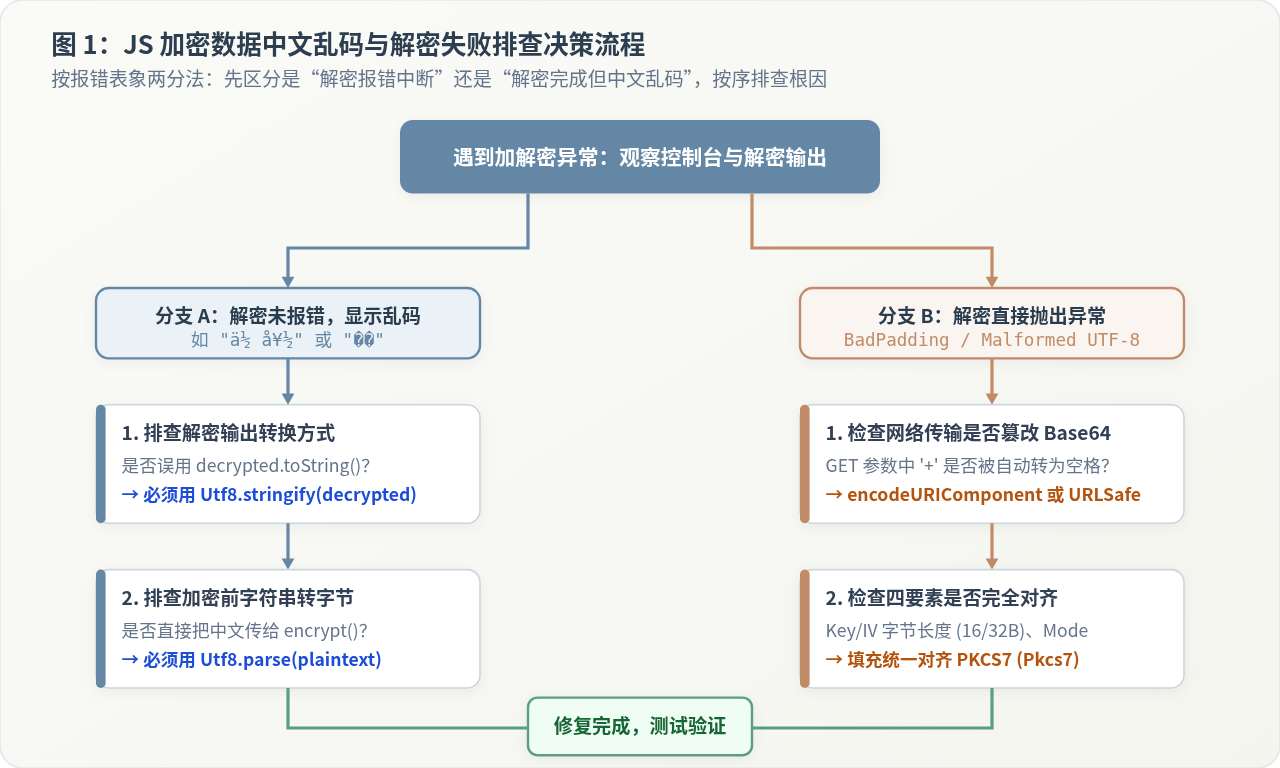
图 1:JS 加密数据中文乱码与解密失败排查决策流程
二、中文乱码的根因剖析与标准修复
在 JavaScript 中,英文字符在 ASCII 编码下只占 1 个字节,即使没有显式指定字符集,许多加密库默认以单字节(如 ISO-8859-1 / Latin1)处理英文字符也不会暴露出问题。这种现象容易让人产生“加密逻辑已经写对”的错觉。
然而,现代中文字符在 UTF-8 编码规范下通常占据 3 个字节(部分生僻字甚至占 4 个字节)。在 JavaScript 运行环境中,字符串在内存中是以 UTF-16 形式存储的。以常用加密库 CryptoJS 为例,加密函数底层仅接受代表字节数组的 WordArray 对象。
乱码产生的底层机制
如果直接将包含中文的字符串传入加密函数,或者在解密之后直接调用 decryptedData.toString() 而未传入编码参数,系统会使用其内置的默认编码器(通常是 Hex 或 Latin1)。一旦 3 字节的 UTF-8 序列被单字节解析,高位字节被截断或错位重组,最终还原出来的就是诸如 ä½ å¥½ 形式的经典乱码。
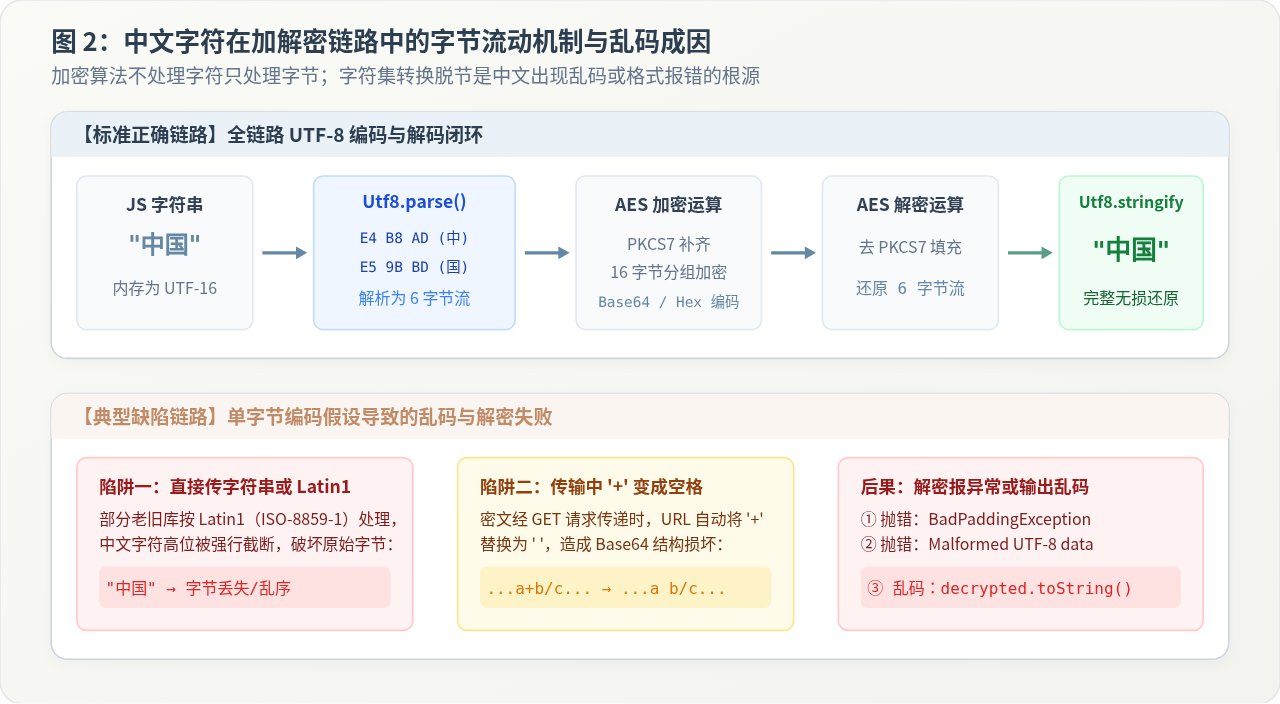
图 2:中文字符在加解密链路中的字节流动机制与乱码成因
标准修复策略:显式指定 UTF-8 编解码器
修复中文乱码的根本措施,是在加密前强制通过 UTF-8 将文本解析为字节序列,并在解密完成后强制通过 UTF-8 将字节序列解析为文本。
以 CryptoJS 为例,正确的操作方式如下:
// 1. 加密阶段:必须使用 CryptoJS.enc.Utf8.parse 将明文字符串转为字节数组
const rawText = "用户信息:张三,地址:北京市朝阳区";
const textBytes = CryptoJS.enc.Utf8.parse(rawText);

// 密钥与 IV 同样必须明确以 Utf8 解析
const key = CryptoJS.enc.Utf8.parse("1234567890123456"); // 16字节 AES-128
const iv = CryptoJS.enc.Utf8.parse("abcdef0123456789");  // 16字节 IV

const encrypted = CryptoJS.AES.encrypt(textBytes, key, {
  iv: iv,
  mode: CryptoJS.mode.CBC,
  padding: CryptoJS.pad.Pkcs7
});
const cipherTextBase64 = encrypted.toString(); // 密文输出为 Base64 字符串

// 2. 解密阶段:解密后得到 WordArray 字节数组
const decrypted = CryptoJS.AES.decrypt(cipherTextBase64, key, {
  iv: iv,
  mode: CryptoJS.mode.CBC,
  padding: CryptoJS.pad.Pkcs7
});

// 错误做法:直接调用 decrypted.toString(),默认输出为 Hex 字符串或 Latin1
// 正确做法:显式指定以 UTF-8 格式恢复中文字符串
const resultText = CryptoJS.enc.Utf8.stringify(decrypted);
console.log(resultText); // 正确输出:"用户信息:张三,地址:北京市朝阳区"
如果是使用现代浏览器原生的 Web Crypto API,则应借助浏览器原生的 TextEncoder 与 TextDecoder API,它们天生基于 UTF-8 规范:
// 原生 Web Crypto API 处理中文字符流
const encoder = new TextEncoder(); // 默认且仅支持 UTF-8
const decoder = new TextDecoder("utf-8");

const rawBytes = encoder.encode("包含中文的测试数据");
// ... 执行 crypto.subtle.encrypt / decrypt ...
const recoveredText = decoder.decode(decryptedBuffer);
三、解密失败与报错的核心原因排查
如果程序并未输出乱码,而是直接抛出 Malformed UTF-8 data 或后端的 BadPaddingException,说明数据在解密数学计算阶段或去填充阶段就已经受损。需按以下三个步骤逐一排查:
1. 网络传输破坏了 Base64 密文字符
Base64 编码的密文字符集包含 +、/ 和 =。如果前端通过 HTTP GET 请求的 URL Query 参数传输密文,或者在未经处理的表单中传递,URL 规范会将 + 字符视为空格。服务端在接收到被替换成空格的密文字符串后解码,密文字节发生位移损坏,解密算法无法正确识别尾部填充块,直接触发 BadPaddingException。
修复方式:
- 对于 URL 传输,前端必须使用
encodeURIComponent(cipherTextBase64)对密文转义,或改用 Base64 URL Safe 规范(将+替换为-,/替换为_,并去掉尾部=)。 - 对于较长的数据或敏感报文,优先采用 HTTP POST 请求体以 JSON 格式传输,避免 URL 编码层面的静默篡改。
2. 前后端填充模式(Padding)未对齐
对称加密算法(如 AES)按固定分组大小(16 字节)进行加密。当明文字节数不是 16 的整数倍时,需要填充对齐:
- PKCS7 (PKCS5):标准填充模式。在缺 $N$ 个字节时补 $N$ 个数值为 $N$ 的字节。在 Java 中写作
AES/CBC/PKCS5Padding,在 CryptoJS 中写作CryptoJS.pad.Pkcs7,两者完全等价兼容。 - ZeroPadding:用 0x00 字节补齐。切忌在中文场景使用该模式!因为某些中文字符转为 UTF-8 或 UTF-16 后的末尾字节可能恰好是 0x00,在解密去填充时会被算法当作填充字节误删,造成数据截断或解密破坏。
3. Key 与 IV 字节长度不符合密码学标准
AES 算法严格要求 Key 的有效字节长度必须是 16 字节(AES-128)、24 字节(AES-192)或 32 字节(AES-256),CBC 模式下的 IV 向量必须恰好是 16 字节。初学者容易直接传入一个普通的 JavaScript 字符串作为 Key。不同语言对“超长截断”或“不足补位”的处理策略不同,例如部分后端库自动用 MD5 哈希补足 16 字节,而 CryptoJS 则直接报错或按特定规则填充,导致两端计算出的真实密钥字节不同,解密失败。
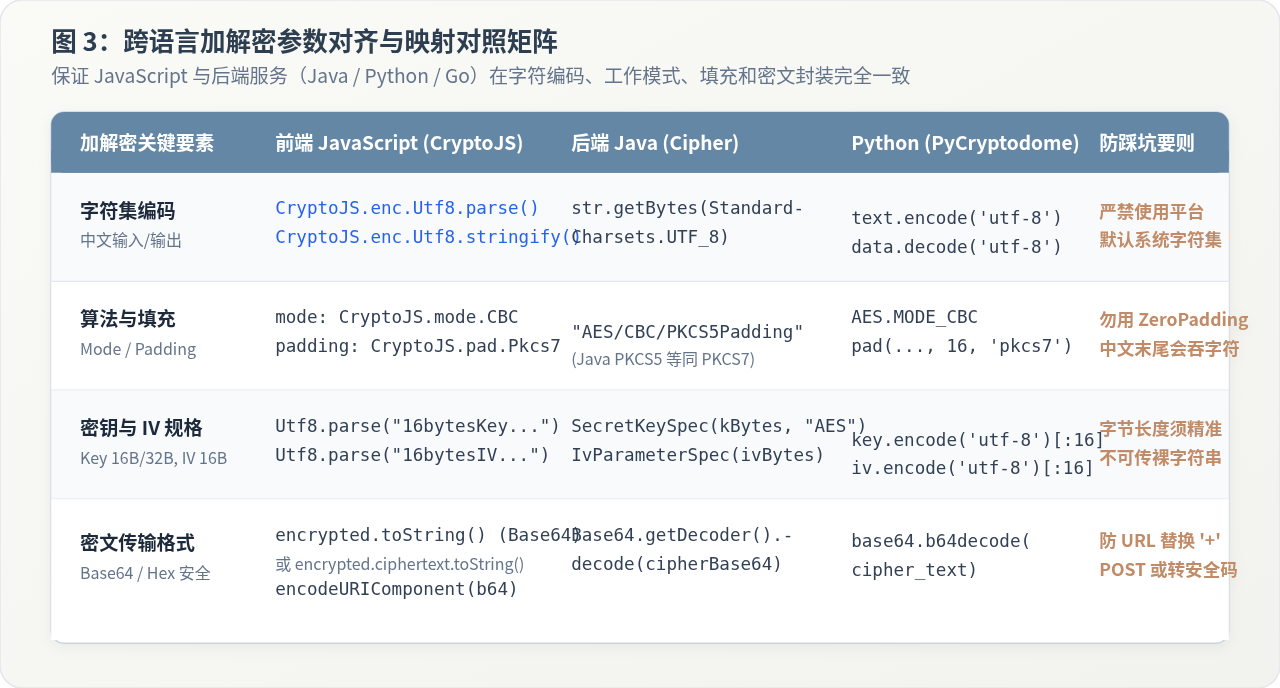
图 3:跨语言加解密参数对齐与映射对照矩阵
四、前后端协同标准化代码示例
为了让排查和解决具有确定性,以下提供一组经过生产验证的标准实现方案,涵盖前端 JavaScript 与后端主流环境(以 Java 与 Node.js 为例)的对称互通。
前端 JavaScript 标准模块封装
// cryptoUtils.js
import CryptoJS from "crypto-js";

// 规范配置:AES-128-CBC,PKCS7 填充
const AES_KEY_STR = "A1B2C3D4E5F67890"; // 务必保证 16 字符(16字节)
const AES_IV_STR  = "1234567890ABCDEF"; // 务必保证 16 字符(16字节)

const key = CryptoJS.enc.Utf8.parse(AES_KEY_STR);
const iv  = CryptoJS.enc.Utf8.parse(AES_IV_STR);

export function encryptData(plainText) {
  if (plainText === null || plainText === undefined) return "";
  const srcBytes = CryptoJS.enc.Utf8.parse(String(plainText));
  const encrypted = CryptoJS.AES.encrypt(srcBytes, key, {
    iv: iv,
    mode: CryptoJS.mode.CBC,
    padding: CryptoJS.pad.Pkcs7
  });
  // 返回安全的 Base64 字符串
  return encrypted.toString();
}

export function decryptData(cipherTextBase64) {
  if (!cipherTextBase64) return "";
  // 预处理:防止 URL 传输中 '+' 被还原为空格引起的解密损坏
  const cleanCipher = cipherTextBase64.replace(/ /g, "+");
  const decrypted = CryptoJS.AES.decrypt(cleanCipher, key, {
    iv: iv,
    mode: CryptoJS.mode.CBC,
    padding: CryptoJS.pad.Pkcs7
  });
  // 必须以 UTF-8 输出解析,杜绝中文乱码
  return CryptoJS.enc.Utf8.stringify(decrypted);
}
后端 Java 标准解密配合实现
后端 Java 接收到前端加密的 Base64 密文时,必须指定 StandardCharsets.UTF_8,严禁依赖服务器默认字符集:
import javax.crypto.Cipher;
import javax.crypto.spec.IvParameterSpec;
import javax.crypto.spec.SecretKeySpec;
import java.nio.charset.StandardCharsets;
import java.util.Base64;

public class AesDecryptService {
    private static final String KEY = "A1B2C3D4E5F67890";
    private static final String IV  = "1234567890ABCDEF";

    public static String decrypt(String cipherTextBase64) throws Exception {
        // 1. 密文字符防错与 Base64 解码
        String safeBase64 = cipherTextBase64.replace(" ", "+");
        byte[] cipherBytes = Base64.getDecoder().decode(safeBase64);

        // 2. 构造密钥与偏移量(明确 UTF-8 字节)
        SecretKeySpec keySpec = new SecretKeySpec(KEY.getBytes(StandardCharsets.UTF_8), "AES");
        IvParameterSpec ivSpec = new IvParameterSpec(IV.getBytes(StandardCharsets.UTF_8));

        // 3. 执行解密:AES/CBC/PKCS5Padding 完全兼容前端 PKCS7
        Cipher cipher = Cipher.getInstance("AES/CBC/PKCS5Padding");
        cipher.init(Cipher.DECRYPT_MODE, keySpec, ivSpec);
        byte[] plainBytes = cipher.doFinal(cipherBytes);

        // 4. 明文字节转为中文字符串:显式声明 UTF-8
        return new String(plainBytes, StandardCharsets.UTF_8);
    }
}
五、如何验证问题已彻底解决
修改代码后,需通过具有代表性的边界用例来验证加解密鲁棒性,不能仅凭一两个简单英文字符测试。建议使用以下包含多重边界特征的测试字符串:
const testCases = [
  "单一汉字测试:中",                                    // 验证不足 16 字节的单字填充
  "中英符号混合:Hello, 世界!【2026年@特调测试】",          // 验证全角/半角标点及 UTF-8 字节混合
  "特殊生僻字与Emoji:𠮷野家,祝你☕生活愉快✨",             // 验证 4 字节高阶 Unicode 字符集
  "长文本分块边界:这是一段刚好用于跨越多个16字节AES数据块长度的中文字符串验证。" // 验证块分割边界
];

testCases.forEach((text, idx) => {
  const encrypted = encryptData(text);
  const decrypted = decryptData(encrypted);
  const isMatch = (text === decrypted);
  console.log(`用例 ${idx + 1} [${isMatch ? "通过" : "失败"}]:`, decrypted);
});
当以上四个用例全部无报错、输出内容与原始明文完全一致时,即可确认加解密链路中的字符集转换与密码学要素已完全正确配置。
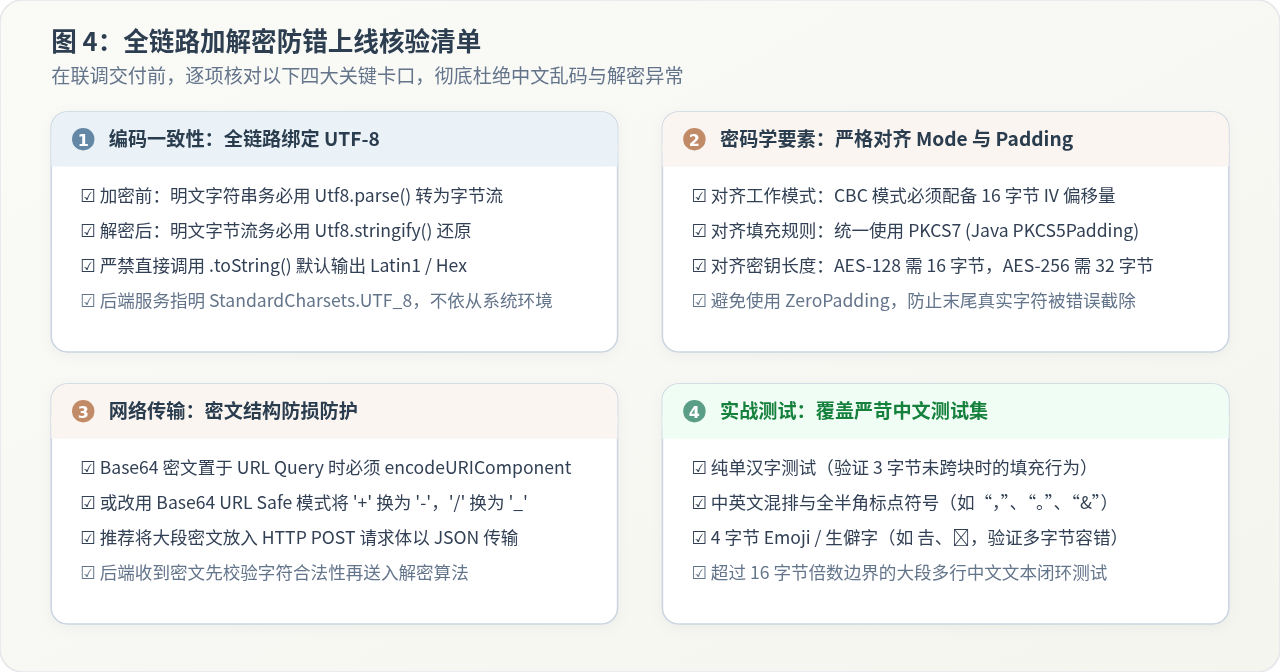
图 4:全链路加解密防错上线核验清单
六、常见疑问与排查小结
Q1:为什么在本地 Node.js 运行正常,发到浏览器中就报错?
Node.js 环境拥有原生的 Buffer 对象,很多开发者在 Node.js 中使用 Buffer.from(str, 'utf-8') 处理中文,而在浏览器端由于缺少全局 Buffer,直接使用了未经转码的字符串传参,导致字符集回退到 ASCII/Latin1。在前端代码中应统一采用 CryptoJS.enc.Utf8.parse 或 TextEncoder。
Q2:解密时偶发报 Malformed UTF-8 data 是什么原因?
如果在大部分情况下解密成功,只有特定用户或长文本偶尔报错,通常是由于 URL 传输中密文的 + 偶尔被转为空格,或者网络层发生了分片截断。检查传输链路中的转义处理即可根治。
Q3:能否直接使用 ECB 模式免去配置 IV 的麻烦?
ECB 模式虽然不需要 IV,但相同明文块会生成相同密文块,存在严重的模式泄露安全缺陷,且不能解决中文编码导致的乱码问题。工程实践中建议始终采用 CBC 或更现代的 GCM 模式,并规范配置 16 字节 IV。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章