

本文详细讲解在现代JavaScript中如何使用URLSearchParams接口快速获取、解析与遍历浏览器地址栏中的URL查询参数,涵盖核心用法、常见边界场景与注意事项。
JS使用URLSearchParams快速获取地址栏参数
作者:微光
时间:2026-11-03
浏览:320
文章目录
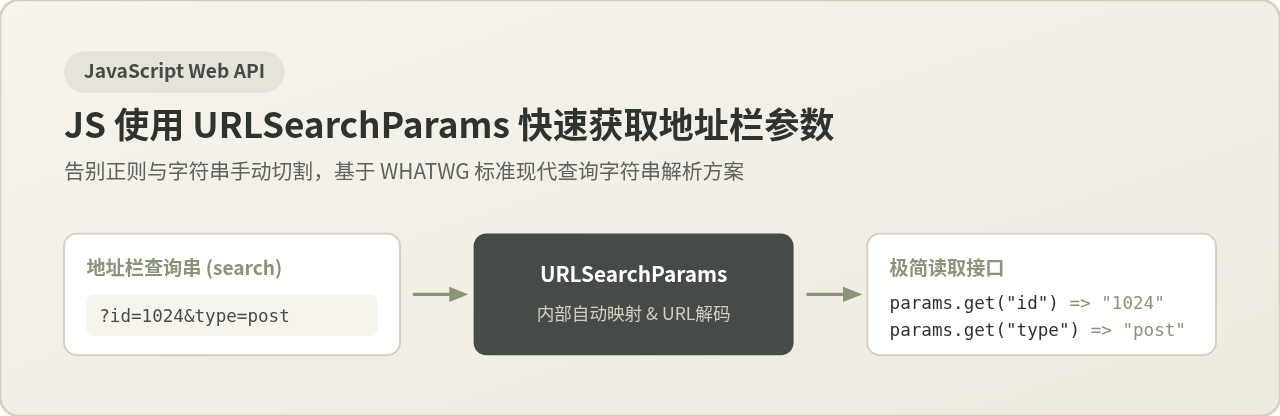
在前端开发中,读取当前页面 URL 地址栏携带的查询参数是极常见的业务需求。在现代 JavaScript 环境下,获取地址栏参数的最优方案是直接使用浏览器原生的 URLSearchParams 接口:只需传入 window.location.search,即可一行代码实例化解析对象并通过 .get('key') 精准读取对应参数。它原生具备自动解码 UTF-8 字符及处理多值参数的能力,彻底避免了以往手写正则表达式或多层 split 切割字符串时的代码繁冗与边界漏洞。
一、快速上手:两行代码读取参数
在传统 JavaScript 开发中,开发者常常需要编写冗长的辅助函数来提取问号后面的键值对。而利用 Web 标准提供的 URLSearchParams,整个获取流程被缩减为极简的标准调用。
假设当前浏览器的完整地址栏如下:
https://www.example.com/article?id=1024&category=frontend&tag=js
在页面脚本中,获取 id 和 category 参数的完整代码如下:
// 1. 从当前窗口读取查询字符串并实例化
const searchParams = new URLSearchParams(window.location.search);

// 2. 使用 get 方法按键名读取参数值
const articleId = searchParams.get('id');             // "1024"
const category = searchParams.get('category');       // "frontend"
const nonExistent = searchParams.get('notFound');   // null (不存在时返回 null)

console.log(articleId, category, nonExistent);
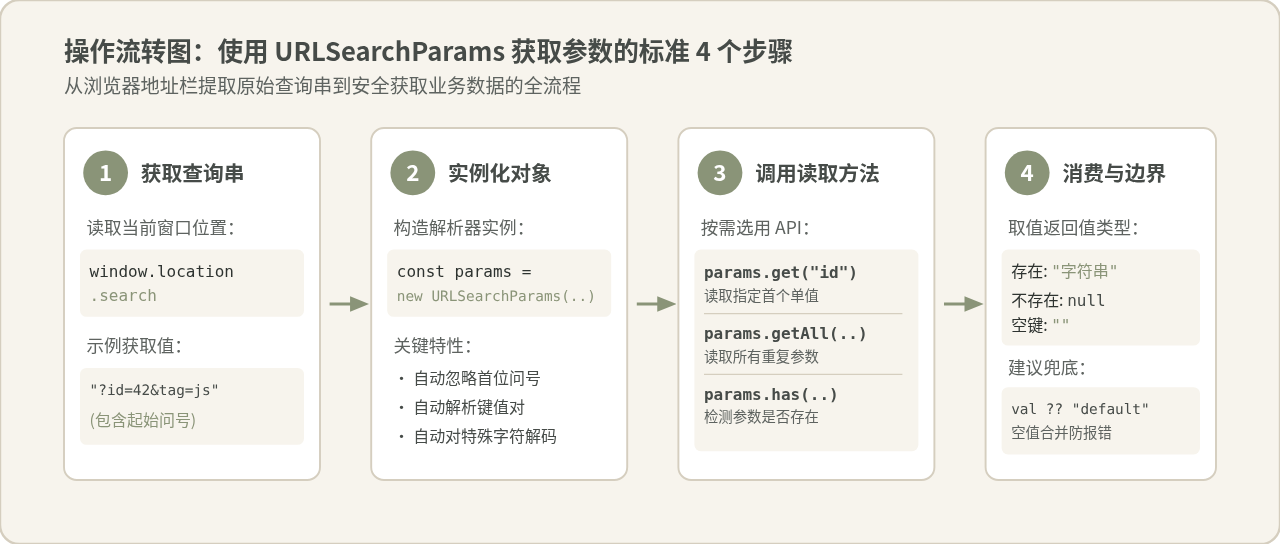
在这段代码中,window.location.search 获取到的是以问号开头的原始字符串 "?id=1024&category=frontend&tag=js"。URLSearchParams 构造函数在接收该字符串时,会自动检测并剔除最前面的 ? 号,并将后面的键值按 & 分隔符切分,存入内部结构中。
二、核心方法与常见操作场景
URLSearchParams 不仅支持基础的单一取值,还针对各种常见的 URL 传参场景提供了完备的原生方法。
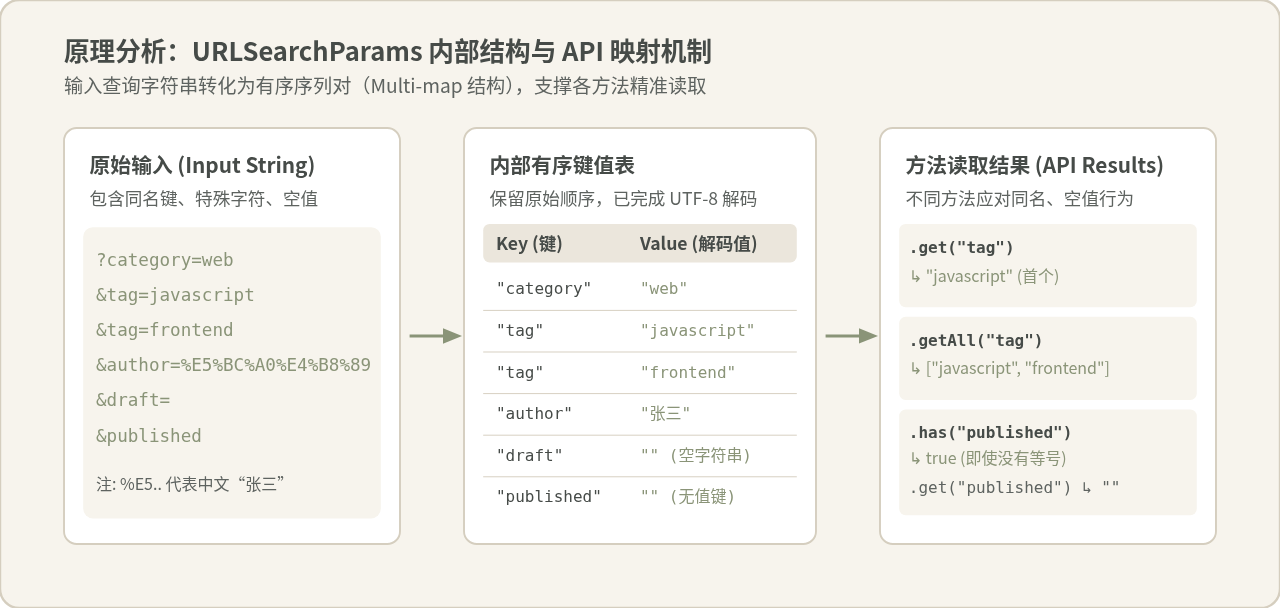
1. 获取重复同名参数:get() 与 getAll() 的区别
在复选筛选或标签列表中,URL 中常常会包含多个同名键,例如:
https://www.example.com/search?tag=javascript&tag=css&tag=html
此时如果调用 .get('tag'),它只会返回匹配到的第一个值 "javascript"。若需要完整获取所有同名项,应改用 .getAll('tag'):
const params = new URLSearchParams(window.location.search);

// get 只返回首个匹配项
console.log(params.get('tag'));      // "javascript"

// getAll 返回包含所有匹配项的数组
console.log(params.getAll('tag'));   // ["javascript", "css", "html"]

// 若参数不存在,getAll 返回空数组 []
console.log(params.getAll('author')); // []
2. 检查参数是否存在:has() 方法
在很多场景下,某些参数仅作为布尔开关存在(如 ?debug 或 ?preview=true),我们只需要确认地址栏是否携带了该标识:
const params = new URLSearchParams(window.location.search);

if (params.has('debug')) {
  console.log('处于调试模式,开启详细日志');
}
3. 遍历所有参数与一键转为普通 JavaScript 对象
URLSearchParams 实现了可迭代协议(Iterable),因此可以直接配合 for...of 循环遍历所有键值对。若业务需要将所有参数整体组装成一个普通的 JavaScript Object 发送给后端接口,可直接配合现代标准方法 Object.fromEntries():
const params = new URLSearchParams(window.location.search);

// 方式一:遍历每一对键值
for (const [key, value] of params) {
  console.log(`${key}: ${value}`);
}

// 方式二:一键转为普通的纯对象 (Object)
const queryObj = Object.fromEntries(params);
console.log(queryObj);
// 输出示例: { id: "1024", category: "frontend" }
注意:Object.fromEntries 处理重复键的行为
当 URL 中包含多个同名键(如 ?tag=js&tag=vue)时,Object.fromEntries() 会遵循后覆盖前的规则,最终对象中只保留最后一个键值 { tag: "vue" }。如果有收集多值数组的诉求,建议使用 params.forEach 或 for...of 手动归集。
三、深层辨析:为什么以往的“手写正则 / split”方案不再推荐?
在很多早期教程或旧项目中,经常能看到利用正则表达式或 split('&') 自行解析 URL 参数的函数。我们来看看这种传统说法的合理性与局限性。
1. 传统手写方案看似合理的原因
在过去,使用手写解析代码的核心原因在于历史浏览器兼容性。在 Internet Explorer(IE)仍占有一席之地的年代,URLSearchParams 规范尚未普及,开发者为了兼容低版本环境,只能通过字符串分割或者正则表达式来满足参数读取需求。
2. 为什么在现代开发中需要修正这一做法?
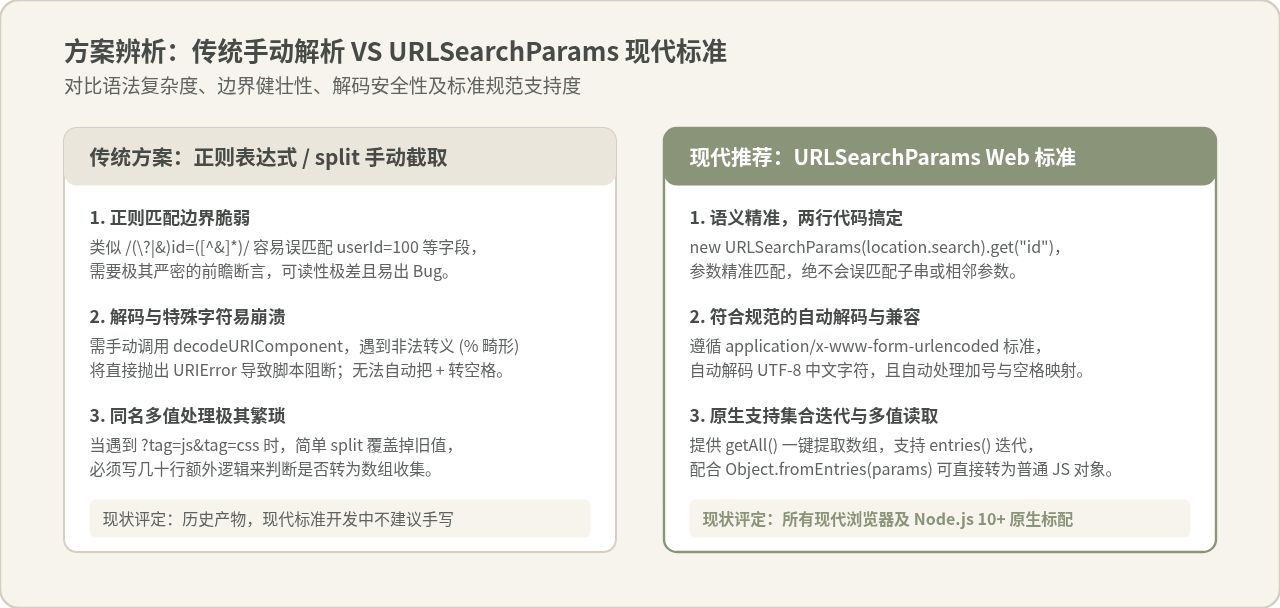
手写解析往往在处理边缘情况时显得非常脆弱,容易引入难以察觉的隐患:
-
正则匹配的边界漏洞:不少手写正则写为
/(\?|&)id=([^&]*)/。当访问地址为?userid=123&sid=456时,该正则可能会错误捕获到userid或sid,必须书写复杂的断言或分隔符判断才能保证严谨。 -
URL 解码抛错风险:手写方案必须手动执行
decodeURIComponent。若用户在地址栏粘贴了不合规的编码序列(例如单个孤立的%),decodeURIComponent会直接抛出未捕获的URIError,导致整个前端脚本崩溃。而URLSearchParams内部有规范的容错机制。 -
特殊符号(+号与空格)的处理差异:在标准查询字符串规范(
application/x-www-form-urlencoded)中,加号+通常被用来表示空格。手写的decodeURIComponent并不会把+替换为空格,导致读取带有空格的查询词时产生数据失真;而URLSearchParams会自动将+解码为标准空格。
四、实际开发中的 3 个常见陷阱与解决方案
尽管 URLSearchParams 非常便捷,但在实际业务开发中,依然有几个与前端工程架构密切相关的细节需要特别注意。
陷阱 1:单页应用(SPA)Hash 路由模式下的参数读取为空
很多基于 Vue Router 或 React Router 的系统会使用 Hash 模式,此时地址栏格式如下:
https://www.example.com/#/user/detail?userId=888&role=admin
在这种情况下直接使用 window.location.search,会发现得到的是一个空字符串 ""。这是因为在浏览器的标准 URL 组成中,# 号之后的内容全部归属于 window.location.hash,而 window.location.search 只会截取 # 号之前的那段 ?query。
解决方案:直接提取 location.hash 中的问号部分传给 URLSearchParams:
// 正确提取 Hash 路由中的查询参数
const hashQuery = window.location.hash.split('?')[1] || '';
const hashParams = new URLSearchParams(hashQuery);

console.log(hashParams.get('userId')); // "888"
陷阱 2:参数不存在、空参数值与布尔值的返回值辨析
在处理参数返回值时,许多初学者容易对 null 与空字符串产生混淆:
| URL 形式 | 代码调用 | 返回值 | 说明 |
|---|---|---|---|
?name=alice |
params.get('name') |
"alice" |
正常读取到字符串 |
?name= |
params.get('name') |
"" (空字符串) |
键存在但值为空,返回空字符串 |
?isVip |
params.get('isVip') |
"" (空字符串) |
单键无等号,不会返回 true,而是空字符串 |
| (未传递 age) | params.get('age') |
null |
键不存在,严格返回 null |
在编写防御性代码时,推荐使用空值合并操作符(??)赋予安全的默认值:
// 当未传递 page 参数时,默认取 "1"
const currentPage = params.get('page') ?? '1';
陷阱 3:数值与布尔类型的显式转换
URLSearchParams 返回的所有结果(除未命中返回 null 外)一律为 string 字符串类型。当需要进行数值计算或布尔判断时,必须进行显式类型转换,避免发生字符串拼接错误:
const params = new URLSearchParams(window.location.search);

// 错误示例: "10" + 1 变成 "101"
// const total = params.get('count') + 1;

// 正确做法: 转换为数值类型
const count = Number(params.get('count') || 0);
const isEnabled = params.get('enable') === 'true';
五、总结与使用决策速查
URLSearchParams 是现代 JavaScript 处理 URL 参数的标配方案。它标准化了 URL 参数的解析、序列化与解码,已被包括 Chrome、Firefox、Safari、Edge 在内的所有主流浏览器以及 Node.js 10+ 原生全面支持。
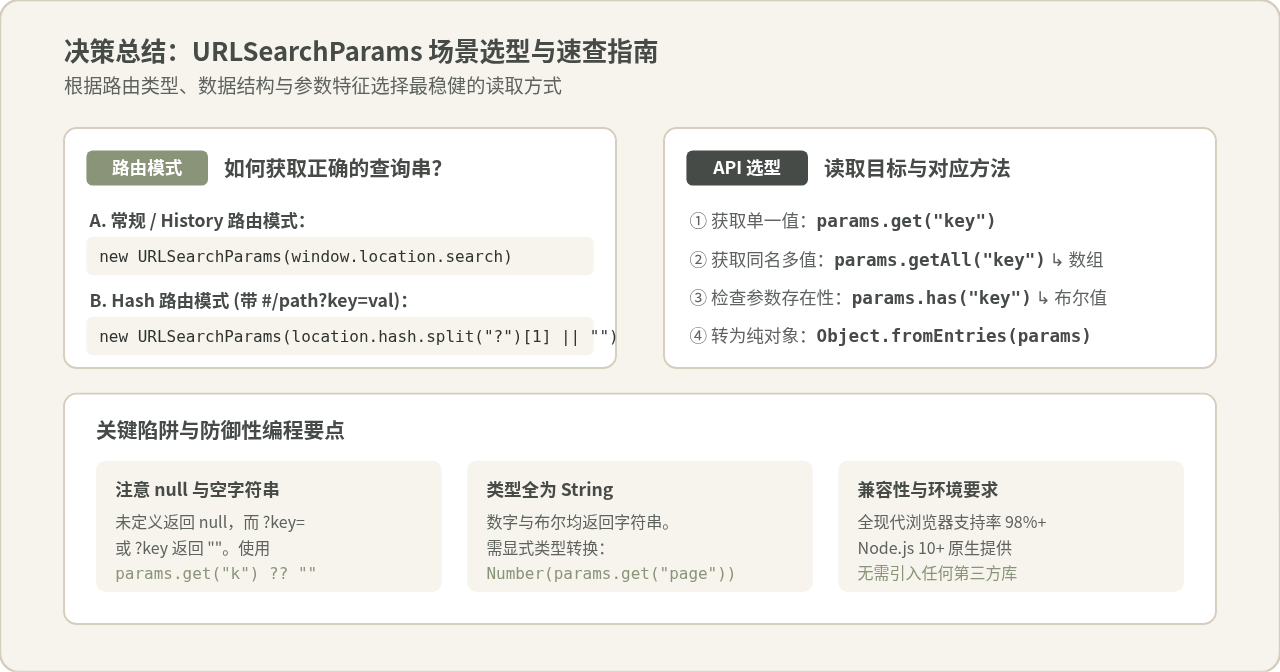
在日常开发中,只要记住以下三条核心准则即可快速解决所有地址栏参数需求:
- 常规页面读取:直接用
new URLSearchParams(window.location.search).get('key'); - SPA Hash 模式读取:对
location.hash做问号拆分后再交由URLSearchParams; - 消费参数前:使用
??设置默认值,并根据业务需要显式转为 Number 或 Boolean。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章