

深入解析 JavaScript 中获取 DOM 元素的核心 API:document.getElementById 与 querySelector 的区别、底层运行机制、参数规范、作用域限制及实战选型指南。
JS获取DOM元素:querySelector与getElementById的区别及用法
作者:沉舟
时间:2026-11-03
浏览:392
文章目录
在原生 JavaScript 的 DOM 编程中,document.getElementById 与 document.querySelector 是检索页面元素最基础且核心的两个接口。简要而言:getElementById 是专为查找 HTML 标签唯一 id 属性设计的专用方法,依托浏览器内部散列表进行直接寻址,速度极快但仅限于 document 全局调用;而 querySelector 则是基于 W3C Selectors API 规范实现的通用匹配引擎,接收完整的 CSS 选择器语法,能够处理类名、属性、嵌套层级及伪类筛选,并原生支持在任意元素子树内进行局部检索。理解两者的语法规则、调用作用域与底层执行机制,是写出兼具高性能与高可维护性前端代码的前提。
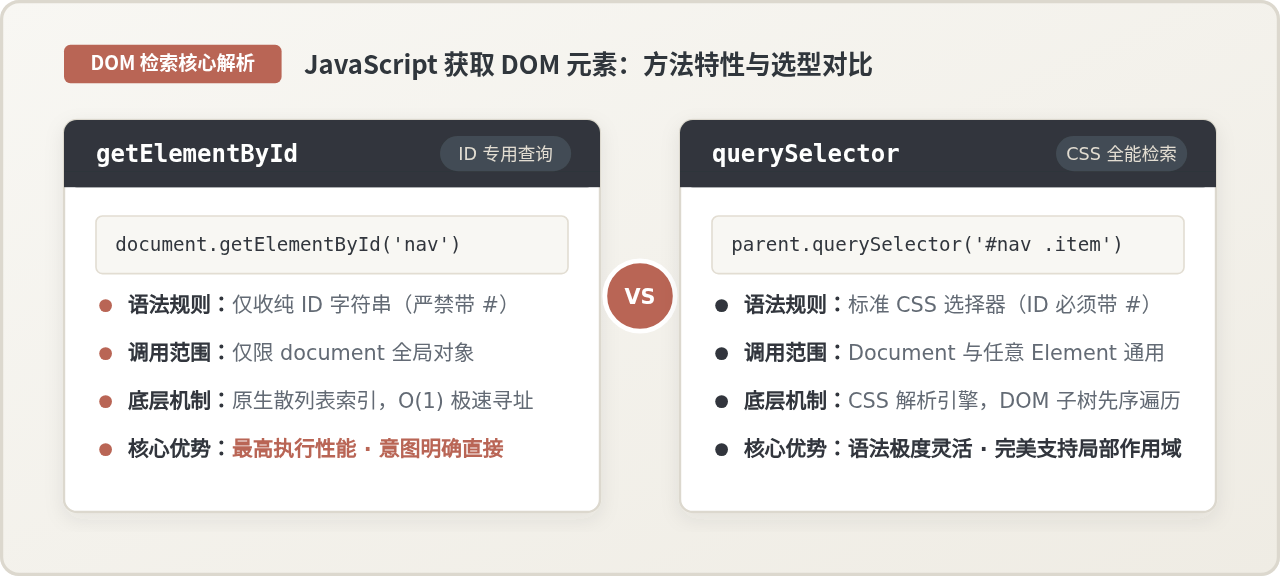
一、基础语法与调用规则
在 DOM 标准规范中,这两个方法位于不同的接口层次上。弄清楚它们的参数格式要求与调用宿主,可以避免很多初学者常犯的低级语法错误与运行时异常。
1. document.getElementById 的调用规范
getElementById 严格接收一个字符串参数,该参数为目标元素在 HTML 标签上所声明的 id 属性值。注意:参数中绝对不要添加 # 号前缀。该方法直接查询文档内部的全局 ID 映射表,如果找到匹配的元素则返回该 HTMLElement 对象;若不存在对应 ID,则返回 null。
// 示例 HTML:<nav id="main-nav" class="navbar">...</nav>

// 正确写法:仅传入纯 ID 字符串
const nav = document.getElementById('main-nav');
console.log(nav); // 输出:<nav id="main-nav" class="navbar">

// 常见错误写法:添加了 # 前缀
const wrongNav = document.getElementById('#main-nav');
console.log(wrongNav); // 输出:null(浏览器会寻找 id="#main-nav" 的节点)
2. querySelector 的调用规范
querySelector 接收一个合法的 CSS 选择器字符串。这意味着如果要按 ID 查询,必须显式携带 # 前缀;按类名查询必须携带 . 前缀;同时支持属性选择器、子代选择器等复杂规则。该方法会根据文档树的先序深度优先遍历顺序,返回第一个与选择器匹配的 Element 节点;若无任何节点匹配,同样返回 null。
// 示例 HTML:<button id="submit-btn" class="btn primary" data-action="save">保存</button>

// 1. 通过 ID 选择器检索(必须加 #)
const btnById = document.querySelector('#submit-btn');

// 2. 通过复合类名与属性选择器检索
const btnByAttr = document.querySelector('.btn.primary[data-action="save"]');

// 3. 错误写法:按 ID 查询却漏掉了 # 前缀
const wrongBtn = document.querySelector('submit-btn');
console.log(wrongBtn); // 输出:null(浏览器将其解析为自定义标签 <submit-btn>)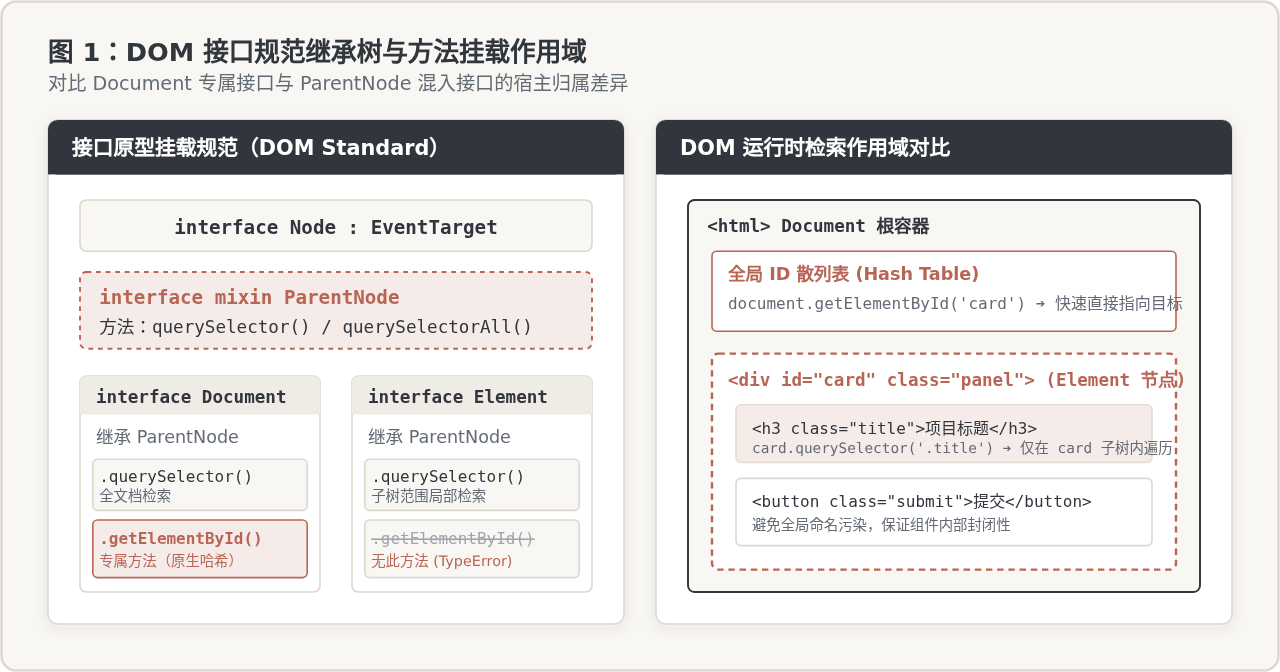
二、深入剖析:两者的六大核心差异
很多开发者在日常编写代码时容易把它们当作简单的“替代品”,但从 DOM 规范、底层数据结构以及运行时表现来看,它们在以下六个维度存在本质差异。
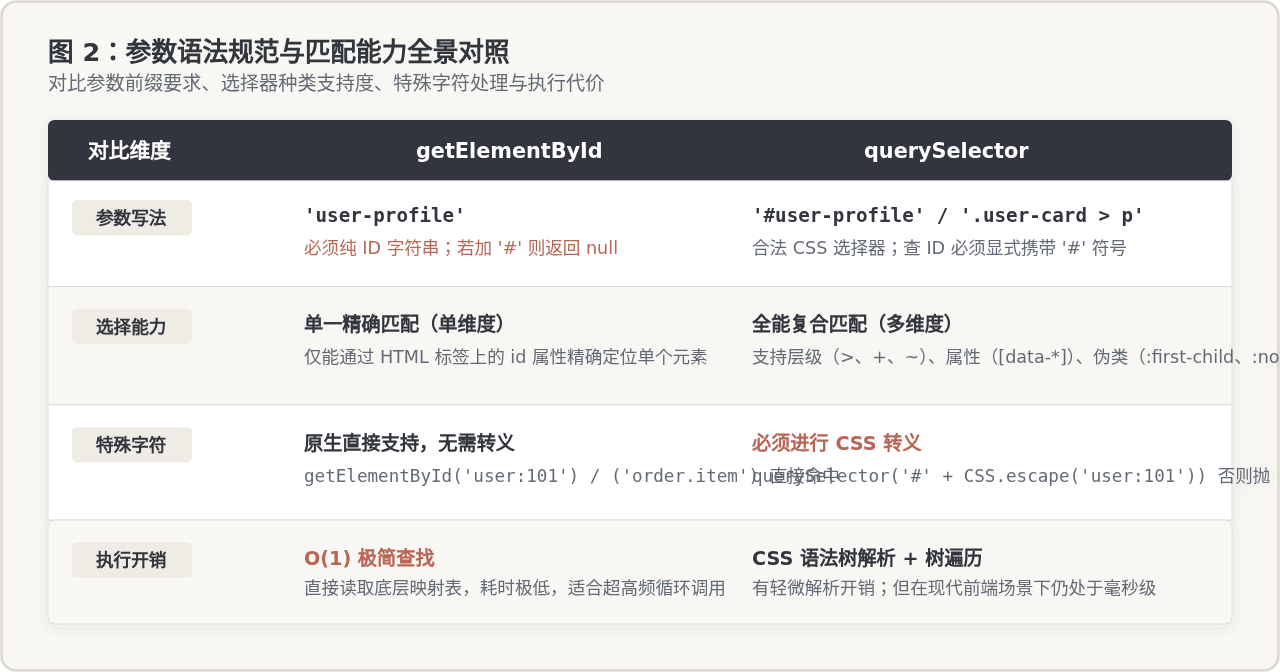
1. 参数语法与前缀机制
getElementById 只认“纯字面属性值”,它不需要也不识别 CSS 选择器语法。传入 'header' 就是找 id="header"。反之,querySelector 接收的是完整的 CSS 选择器,必须严格遵循 CSS 词法规则。如果混淆了两者的入参规范,例如在 getElementById 中带上了 #,或者在 querySelector 中遗漏了 # 或 .,会导致静默返回 null,成为难以排查的排错痛点。
2. 调用上下文宿主与局部作用域
从 DOM 接口标准来看:
getElementById定义在Document接口和DocumentFragment上,没有挂载在Element.prototype上。如果尝试对某个具体元素调用cardElement.getElementById('sub-id'),JavaScript 引擎会立即抛出TypeError: cardElement.getElementById is not a function。querySelector继承自ParentNode混入接口,同时在Document、DocumentFragment以及Element上实现。这意味着你可以在任意已获取的父级元素上直接调用parentElement.querySelector('.child'),将搜索范围严格收窄在当前元素的子树内部。
3. 底层匹配机制与执行性能
在现代浏览器的 C++ 内核实现中,当 HTML 解析器构建 DOM 树时,会同步维护一张文档级的 ID 散列表(Hash Map)。调用 getElementById 时,引擎直接通过散列键快速读取节点内存指针,时间复杂度为接近常数级的 O(1)。
相比之下,querySelector 需要启动 CSS 选择器解析引擎。引擎首先将传入的字符串词法切片并构建匹配规则树,然后对 DOM 树进行遍历比对。虽然现代浏览器对简单 ID 选择器(如 #header)内部做了快路径优化,但整体调用链依然包含了语法校验与引擎解析环节。在极高频的动画帧循环(如 requestAnimationFrame)或包含数万个节点的超大 DOM 树中,getElementById 的性能优势依然十分明确。
4. 选择能力的广度与灵活性
getElementById 仅能胜任单一维度的精确查找。而 querySelector 拥有 CSS 体系的完整表达力:
- 层级关联检索:例如
document.querySelector('#user-list > li:first-child .user-name'),可以精准直达嵌套节点,而无需逐层遍历。 - 状态与伪类过滤:例如
document.querySelector('input[type="checkbox"]:checked')或document.querySelector('.tab-pane:not(.hidden)'),能够直接捕获符合当前交互状态的元素。 - 属性匹配:支持
[data-role="admin"]、[href^="https://"]等前缀、后缀和模糊包含匹配。
5. 特殊字符与转义要求
当元素的 ID 含有 CSS 保留字符(如冒号 :、句点 .、斜杠 / 或以数字开头)时,两者的表现截然不同:
// 示例 HTML:<div id="user:profile.current">用户信息</div>

// getElementById 原生支持任意合法 HTML ID 属性字符串,无需转义
const el1 = document.getElementById('user:profile.current'); // 成功命中

// querySelector 会将 ':' 解析为伪类,'.' 解析为类名,导致语法解析失败抛出异常!
// 错误写法:
// const el2 = document.querySelector('#user:profile.current');
// 报错:DOMException: Failed to execute 'querySelector': '#user:profile.current' is not a valid selector.

// 正确写法:使用 CSS.escape() 进行标准转义
const safeSelector = '#' + CSS.escape('user:profile.current');
const el2 = document.querySelector(safeSelector); // 成功命中
6. 复数查询 API 的延伸区别
在需要获取多个元素的场景下,两者的延伸方法也体现了不同设计哲学:
- 与
getElementById对应的传统方法(如getElementsByClassName、getElementsByTagName)返回的是动态的HTMLCollection,DOM 树后续发生增删节点时,集合内容会实时自动联动更新。 - 与
querySelector对应的querySelectorAll返回的是静态的快照NodeList,获取之后哪怕文档发生变更,已抓取的 NodeList 长度与内容保持不变,并且原生支持.forEach()迭代。
三、实战操作步骤与规范代码模板
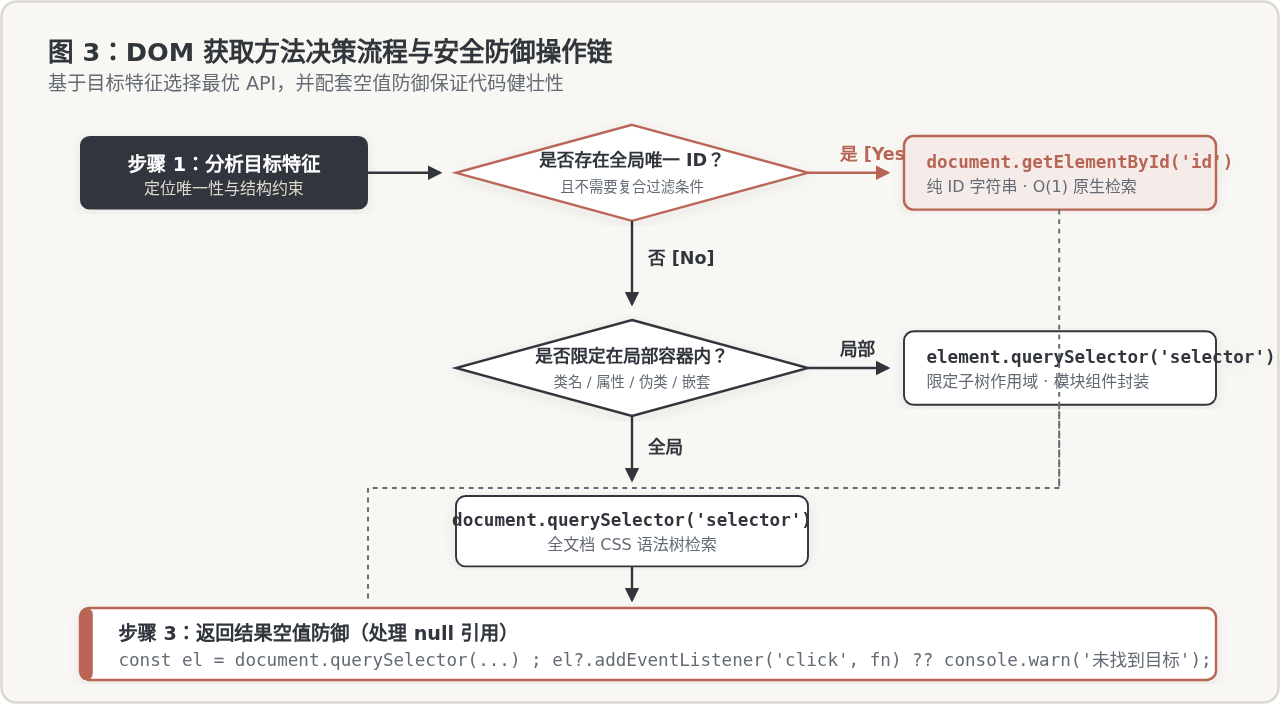
在实际项目开发中,选择合适的 API 应当遵循一套结构化的决策流程。以下是推荐的四个标准步骤:
标准化决策路径
第一步:分析目标定位特征。确认目标元素是否具备全局唯一的 ID,还是需要依赖上下文容器、CSS 类名或动态属性定位。
第二步:选择最优匹配方法。若有确定 ID 且只做全文档定位,选 getElementById;若在组件容器内局部查找或依赖复合条件,选 element.querySelector。
第三步:加入空值安全防御。处理未匹配到节点时的 null 结果,阻断潜在的代码崩溃。
第四步:确认 DOM 挂载时机。确保在 DOM 树完全就绪后执行获取逻辑。
完整规范操作示例
以下代码演示了在一个经典的表单卡片组件中,如何结合使用这两种方法完成精确、健壮的元素获取与交互绑定:
<!-- 页面结构示例 -->
<div id="checkout-panel" class="panel-box">
  <h3 class="panel-title">结算中心</h3>
  <form class="pay-form">
    <label>
      <input type="radio" name="payment" value="alipay" checked> 支付宝
    </label>
    <label>
      <input type="radio" name="payment" value="wechat"> 微信支付
    </label>
    <button type="button" class="btn submit-btn">确认支付</button>
  </form>
</div>

<script>
// 确保 DOM 结构已加载就绪
document.addEventListener('DOMContentLoaded', () => {
  // 步骤 1 & 2:全局快速抓取容器节点(推荐使用 getElementById,意图直观且速度最快)
  const checkoutPanel = document.getElementById('checkout-panel');

  // 步骤 3:进行空值防御校验
  if (!checkoutPanel) {
    console.warn('未能在页面中找到结算面板容器 #checkout-panel');
    return;
  }

  // 局部检索:在 checkoutPanel 子树内检索表单内的选中项与提交按钮
  // 此时使用 querySelector 能够完美发挥局部作用域与复合选择器的威力
  const checkedRadio = checkoutPanel.querySelector('input[name="payment"]:checked');
  const submitButton = checkoutPanel.querySelector('.submit-btn');

  // 使用可选链(Optional Chaining)安全读取属性
  console.log('当前默认支付方式:', checkedRadio?.value ?? '未选择');

  // 安全绑定点击事件
  submitButton?.addEventListener('click', () => {
    // 重新获取最新的选中状态
    const currentPay = checkoutPanel.querySelector('input[name="payment"]:checked')?.value;
    alert(`准备提交支付,选择的渠道为: ${currentPay}`);
  });
});
</script>
四、常见误区与排坑指南
在实际维护代码或审查 PR 时,以下几类高频误区尤为普遍,开发者需要引起足够重视:
1. 在 getElementById 参数中误加 '#'
这是从 jQuery 转向原生 JS 或同时混用 querySelector 时最容易出现的笔误。document.getElementById('#title') 会让浏览器去查找 <div id="#title">,结果必然是 null。如果后续直接链式调用 .innerText,就会直接触发运行时异常 TypeError: Cannot read properties of null。
2. 误在 Element 节点上调用 getElementById
有些开发者希望缩小检索范围,写出类似 const card = document.querySelector('.card'); const btn = card.getElementById('btn'); 的代码。前文已详细分析,Element 接口没有此方法,正确写法是在 card 上调用 card.querySelector('#btn') 或直接依赖全局 document.getElementById('btn')。
3. HTML 中出现重复 ID 时的行为不确定性
根据 HTML 规范,一个页面中各元素的 id 必须是全局唯一的。如果在模板复用中不慎渲染了重复的 id:
getElementById会严格按照文档树顺序返回它在树中遇到的第一个匹配元素;querySelector('#id')同样按先序遍历返回第一个;- 这种写法不仅破坏了 HTML 规范校验,还可能导致本想操作第二个卡片中的元素,实际却修改了第一个卡片,造成严重的业务逻辑串号 Bug。
4. 动态拼接选择器时未进行转义
当元素的 ID 是由后端数据动态生成时(例如数据库 ID 包含符号,如 row-12:5),如果直接拼接成 document.querySelector(`#row-${id}`),会导致 CSS 选择器引擎解析失败并抛出 DOMException。对于无法保证纯字母数字的动态 ID,务必优先使用 document.getElementById(rawId),或者使用 CSS.escape(rawId) 过滤。
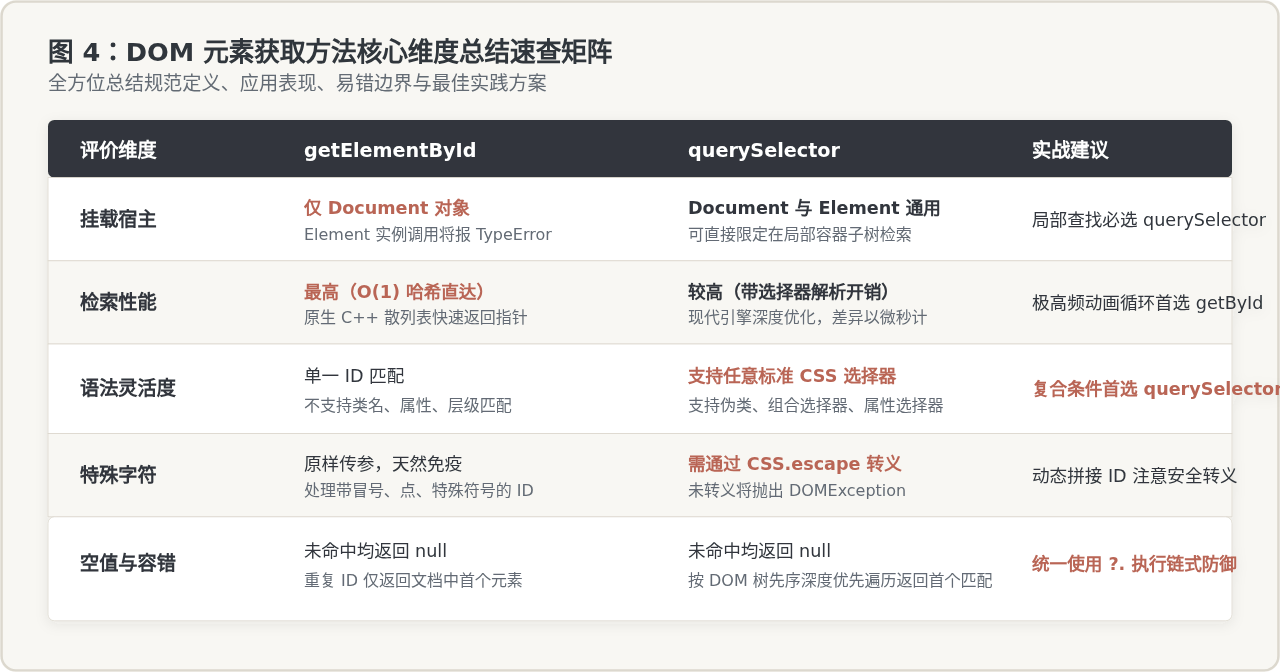
五、综合总结与选型速查表
为了帮助读者在日常编码时能够快速做出符合工程规范的选择,下表对这两种方法的各项关键指标进行了汇总对比:
| 特性指标 | document.getElementById | ParentNode.prototype.querySelector |
|---|---|---|
| 调用宿主 | 仅 document 与 DocumentFragment |
document、element、DocumentFragment 通用 |
| 参数规范 | 纯 ID 字符串(禁止 # 前缀) |
合法 CSS 选择器(ID 必须带 #,类名带 .) |
| 匹配范围 | 仅通过标签上的 id 属性单点匹配 |
标签、类名、属性、伪类、嵌套关系等全能匹配 |
| 局部检索支持 | 不支持(只能全局检索) | 原生支持(可在指定父级元素内执行局部查询) |
| 底层匹配效率 | 内部哈希表 O(1) 极速寻址 |
CSS 选择器解析树匹配,有轻微解析开销 |
| 特殊字符容错 | 原生支持特殊字符,无需转义 | 包含冒号、点等符号时必须使用 CSS.escape() |
| 未命中返回值 | null |
null |
| 最佳适用场景 | 全局唯一骨架容器、极高频循环读取、模态框挂载点 | 组件内部封装查找、复杂状态筛选、按层级或属性提取 |
核心选型准则:如果你的目标元素拥有确定的全局唯一 ID,且检索逻辑不依赖局部层级或动态属性状态,应当优先使用 document.getElementById,代码意图直观且执行性能最高;而在现代组件化开发中,如果需要将查找范围隔离在当前组件节点内部,或者需要依据类名、属性以及 :checked 等交互状态筛选元素,querySelector 则是更加灵活且符合现代前端规范的必然选择。在编写具体逻辑时,时刻配合可选链操作符 ?. 进行空值防御,才能确保 DOM 操作既高效又稳定。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章