
深入对比JavaScript中forEach与map方法的核心机制、数据流动、返回值差异与性能表现。通过具体的实战代码、选型决策树和工程反模式分析,指导开发者在面对数组遍历与转换时做出准确选择。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组forEach和map方法该怎么选择?
作者:闭包旅人
时间:2026-11-03
浏览:592
文章目录
JavaScript 标准库核心方法解析
主题:数组高阶迭代方法选型
标准规范:ECMAScript Array Specification
阅读时长:约 6 分钟
核心答案:选择
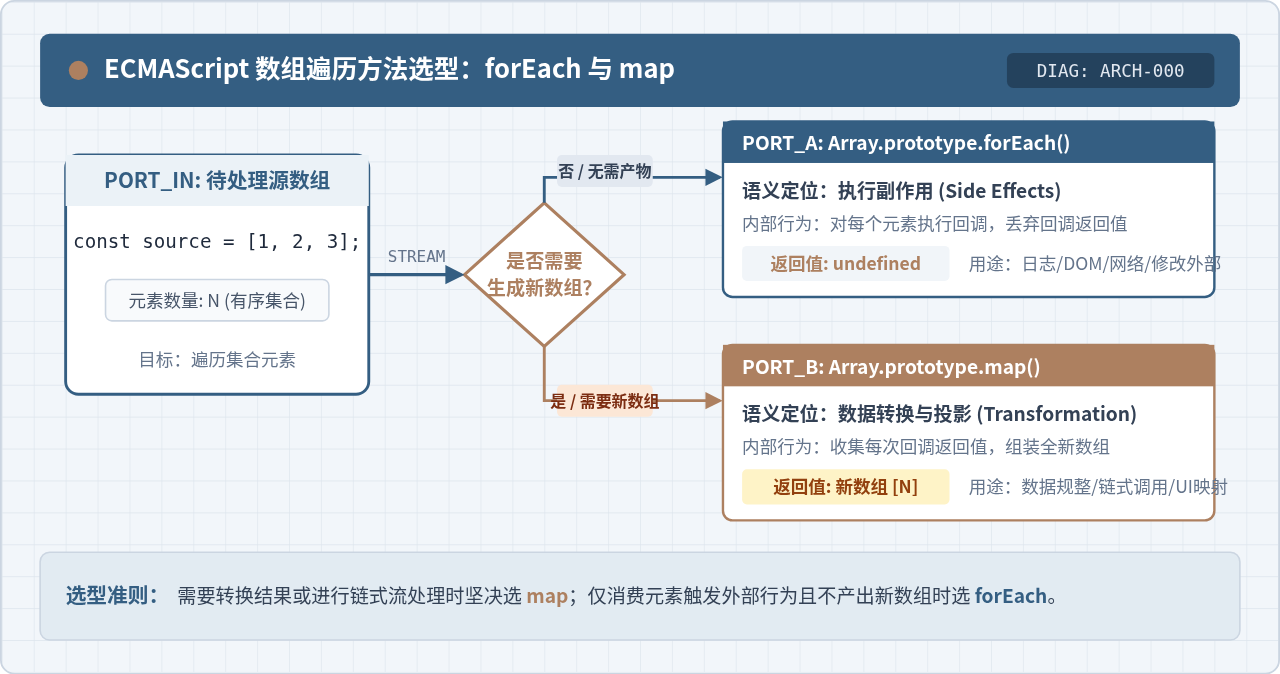
forEach 还是 map,核心依据在于是否需要基于原元素生成等长的新数组以及是否需要执行外部副作用。若遍历的唯一目的是在外部产生动作(如修改 DOM、打印日志、发起网络请求、更新外部状态)且不需要返回值,应当选择 forEach;若目标是将集合中的每个元素映射为一个新值,并收集为等长的新数组,同时保持原数组不变,必须选择 map。
一、底层数据流动与机制对比
很多初学者会把 forEach 和 map 简单理解为“都是遍历数组的循环语法糖”,但从底层执行模型和语义规范来看,两者存在根本性的架构差异:
1. Array.prototype.forEach 的执行模型
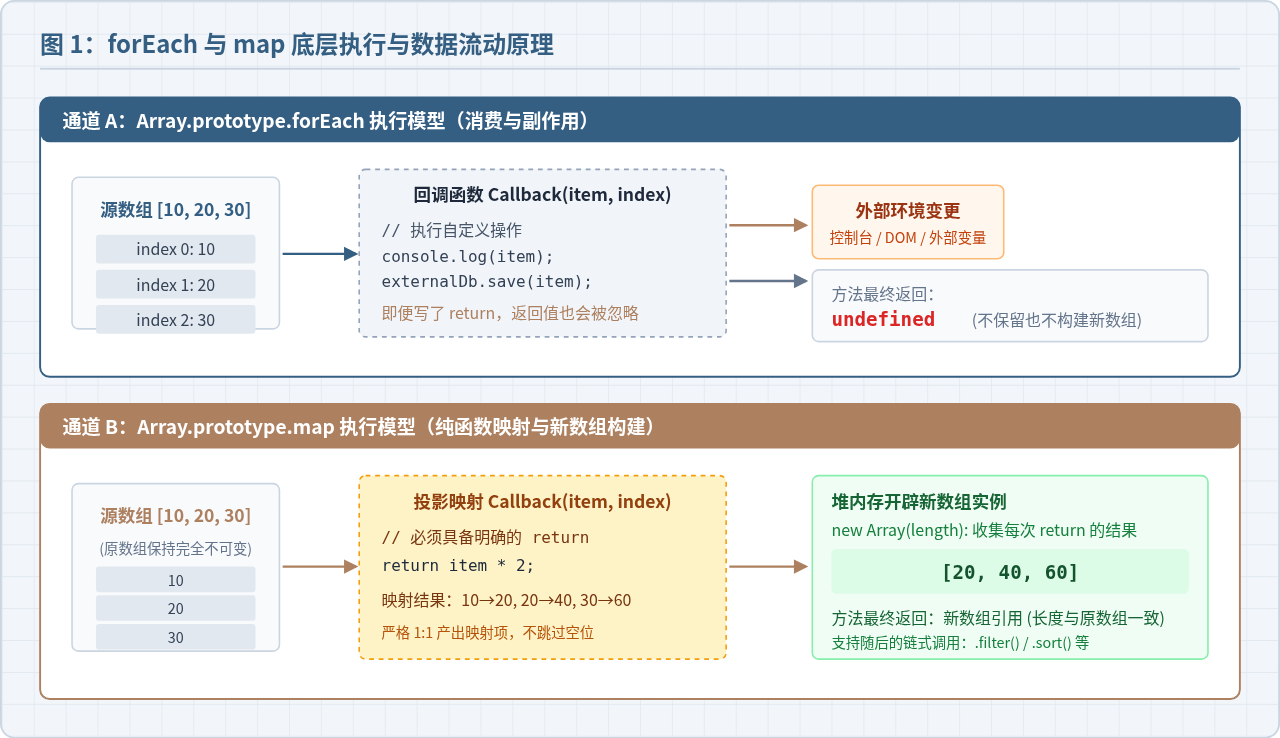
forEach 的官方语义是“对数组的每个元素执行一次提供的函数”。它的主要特征是无返回值(严格返回 undefined),并且它不会保留回调函数的任何计算结果。
在底层引擎执行时,forEach 会按索引顺序调用回调函数 callbackFn(currentValue, index, array)。回调函数内部即使写了 return value;,该返回值也会在内部被静默丢弃。因此,forEach 的设计初衷纯粹是作为一个“终端消费者”(Sink),用于触发外部环境的副作用。
2. Array.prototype.map 的执行模型
map 的官方语义是“创建一个新数组,这个新数组由原数组中的每个元素都调用一次提供的函数后的返回值组成”。
在底层引擎执行时,map 会在堆内存中新开辟一个与原数组长度相同的连续内存空间 new Array(length)。每次循环迭代时,它执行回调并将回调显式 return 的值按对应索引放入新数组中,最后将这个全新数组的引用返回给调用方。整个过程中,原数组的结构与元素不会受到任何修改(即保持不可变性)。
二、选型推导步骤与判断决策
在实际编码中,你可以通过以下四个层层递进的步骤来做出一锤定音的选择:
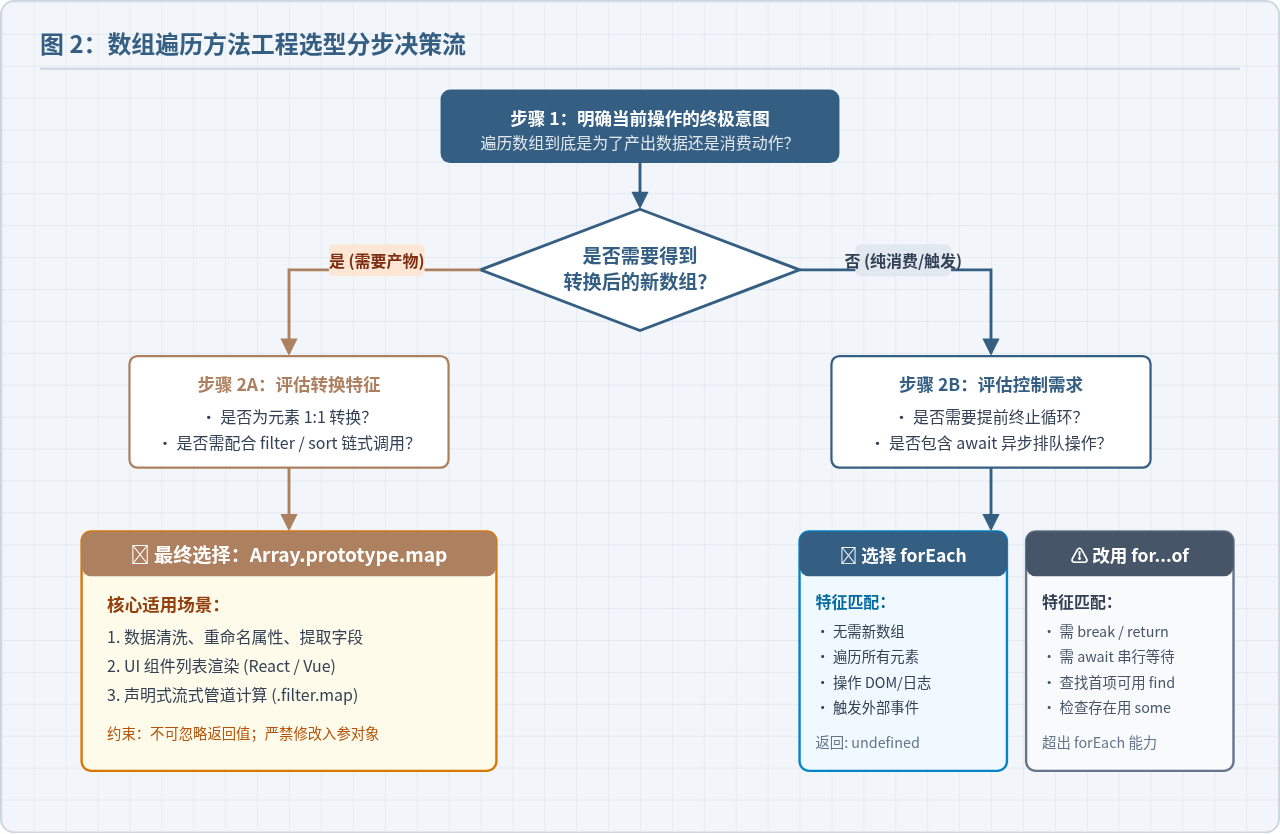
第 1 步:检查是否需要产物数组(New Collection)
询问自己:“执行完这趟遍历后,我是否需要把每个元素加工后的结果收集起来继续使用?”
- 需要:毫不犹豫进入
map候选流程。例如将用户 ID 数组转换为对象数组、将浮点数保留两位小数、或者在 React 组件中将数据渲染为 JSX 列表。 - 不需要:进入第 2 步,考虑
forEach或其他循环语法。
第 2 步:检查是否要参与方法链式调用(Method Chaining)
现代前端工程非常强调声明式流处理(Pipeline)。若当前操作需要紧随 .filter() 之后,或者其产物还需要继续交给 .sort()、.slice()、.reduce() 处理,必须使用 map。因为 forEach 返回的是 undefined,一旦链入会直接导致后续方法调用报错。
第 3 步:检查是否只是为了执行纯粹的副作用(Side Effects)
如果你的代码不需要生成新数组,而是要:
- 向控制台或日志系统记录输出;
- 逐项向服务端发送埋点统计;
- 操作已有 DOM 节点的属性或挂载子节点;
- 修改一个已有的全局缓存或外部 Map 结构。
此时,选择 forEach 能够最直接、最清晰地向其他维护者传达“这里只在执行动作,没有返回数据”的语义。
第 4 步:检查是否需要提前跳出循环或处理 async/await
注意两者的共同边界:forEach 和 map 都不支持在循环中通过 break、continue 提前终止遍历。在它们的回调中写 return 只相当于普通函数的单次提前返回,后续索引仍会继续执行。如果业务逻辑需要在遇到满足条件的某一项时立刻停止循环,或者需要按顺序串行执行 await 异步任务,应该跳出这两个方法,选用原生的 for...of 循环,或选用更贴合意图的 find、some、every 方法。
三、典型场景与实战代码比对
场景 1:数据清洗与字段提取(标准选用 map)
需求:后端返回了一组员工数据,前端界面只展示姓名列表,需要提取所有员工的姓名。
// 原始数据源
const employees = [
  { id: 101, name: "张伟", department: "研发" },
  { id: 102, name: "李娜", department: "设计" },
  { id: 103, name: "王强", department: "测试" }
];

// ✅ 优雅推荐:使用 map,一行代码完成纯映射
const names = employees.map(emp => emp.name);
// 结果输出:["张伟", "李娜", "王强"]

// ❌ 繁琐反例:使用 forEach 配合外部累加数组
const redundantNames = [];
employees.forEach(emp => {
  redundantNames.push(emp.name);
});解析:使用 forEach 时,必须额外声明一个可变的 redundantNames 临时变量并通过 .push() 手动注入,不仅代码冗长,还破坏了函数式编程的不可变性原则。而 map 直接产出不可变结果,语义一目了然。
场景 2:外部事件触发与统计消费(标准选用 forEach)
需求:用户提交表单后,遍历校验错误数组,并将每一个错误信息展示在界面对应的通知框中,同时向远程监控上报。
const validationErrors = [
  { field: "username", message: "用户名不能为空" },
  { field: "password", message: "密码长度不能小于8位" }
];

// ✅ 标准推荐:使用 forEach 执行外部通知和上报
validationErrors.forEach(err => {
  toast.showError(`[${err.field}] ${err.message}`);
  telemetry.reportError(err.field, err.message);
});解析:此处的目标是消费错误列表并触发界面的 Toast 与日志上报,不需要也不期望得到任何产物集合。选用 forEach 语义准确,不会产生闲置的数组垃圾。
场景 3:流水线链式数据处理(管道连贯性对比)
需求:从商品列表中筛选出有库存的商品,计算含税总价,并按价格降序排列。
const products = [
  { id: 1, title: "机械键盘", price: 400, inStock: true },
  { id: 2, title: "无线鼠标", price: 120, inStock: false },
  { id: 3, title: "4K显示器", price: 1800, inStock: true }
];

// ✅ map 保持管道连续
const formattedPrices = products
  .filter(item => item.inStock)
  .map(item => ({
    title: item.title,
    totalPrice: item.price * 1.13
  }))
  .sort((a, b) => b.totalPrice - a.totalPrice);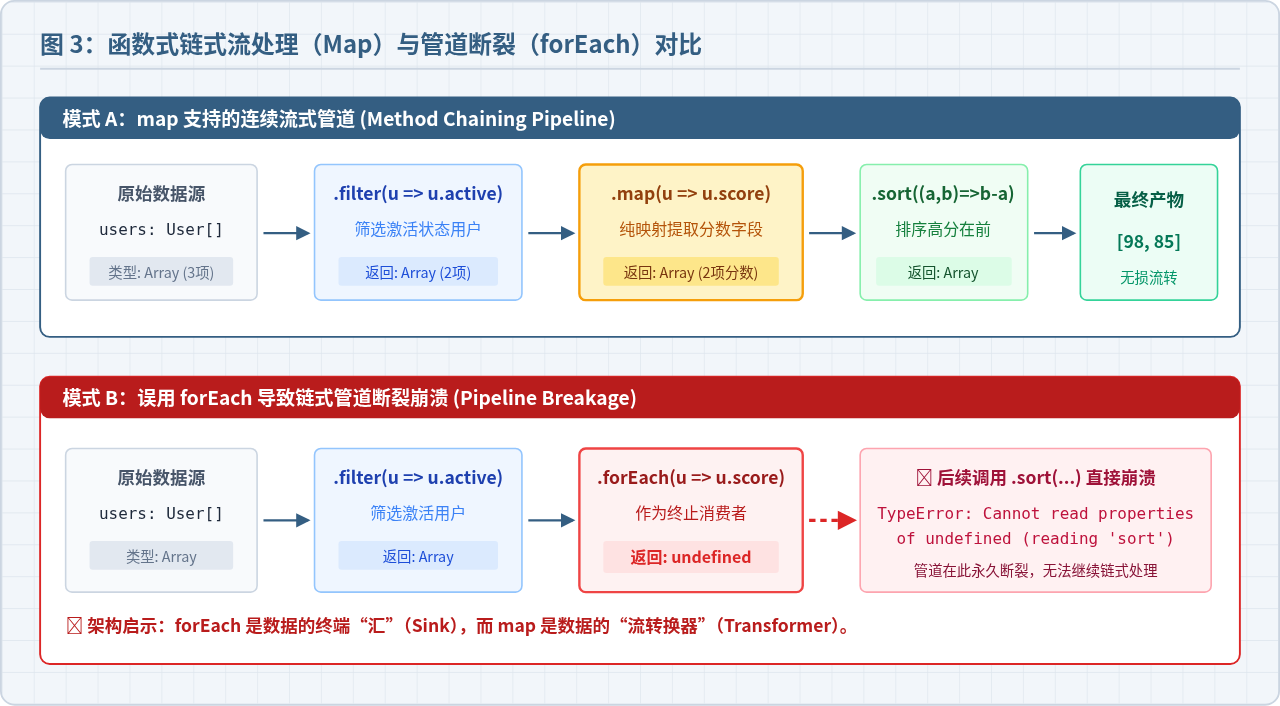
四、工程避坑指南:四种常见反模式
⚠️ 反模式 1:使用 map 充当普通循环,丢弃其返回值
错误代码:
users.map(u => { saveToDatabase(u); }); // 未接收返回值
危害分析:JavaScript 引擎会为了满足 map 规范在堆内存中完整分配一个与 users 等长的全新数组空间,收集每个元素返回的 undefined,形成类似 [undefined, undefined, ...] 的临时数组。由于没有变量引用它,该数组会立即变成内存垃圾等待 V8 垃圾回收(GC)。在大数据量或高频调用的场景下,这会引发明显的内存抖动与 GC 停顿。纯遍历请务必使用 forEach。
⚠️ 反模式 2:在 map 回调中就地修改原对象属性
错误代码:
const result = users.map(u => { u.score = u.score + 10; return u; });
危害分析:map 虽然返回了一个新数组,但新数组中存放的对象依然是指向原对象的内存指针!这不仅污染了原数组引用的对象数据,还失去了不可变数据的优势。在 React / Redux / Vue3 等依赖对象引用比对来触发视图更新的状态框架中,这种隐式突变会导致组件无法感知数据变化,从而引发极其难以排查的 UI 不刷新 Bug。正确做法是返回解构后的新对象:return { ...u, score: u.score + 10 };。
⚠️ 反模式 3:在 forEach 或 map 中试图通过 return 跳出整个循环
错误代码:
items.forEach(item => { if (item.id === targetId) return; process(item); });
危害分析:许多开发者误以为这里的 return 会像常规 for 循环中的 break 一样中止整个循环。实际上,forEach 的参数是一个独立的回调函数,return 仅仅是结束了当前这一次回调函数的执行(相当于 continue),引擎随后依然会继续遍历并执行剩余的元素。如果需要一旦找到目标就立刻终止后续执行,应改用 for (const item of items) { if (...) break; } 或 items.some()。
⚠️ 反模式 4:在 map 中直接传递 async 函数且未搭配 Promise.all
错误代码:
const data = list.map(async item => await fetchDetails(item));
危害分析:带有 async 关键字的函数在 JavaScript 中始终同步返回一个 Promise 对象。因此,list.map(async ...) 返回的绝不是包含真实数据的数组,而是一个包含多个处于 Pending 状态的 Promise 数组:[Promise, Promise, ...]。后续代码直接读取 data[0].id 会得到 undefined 甚至抛出异常。如果需要并发处理异步映射,必须使用 await Promise.all(list.map(async ...)) 包裹。
五、全维度特性对比与速查矩阵
为了在日常架构评审与代码审查中快速核对,下表系统整理了 forEach 与 map 在各个关键技术维度的对照矩阵:
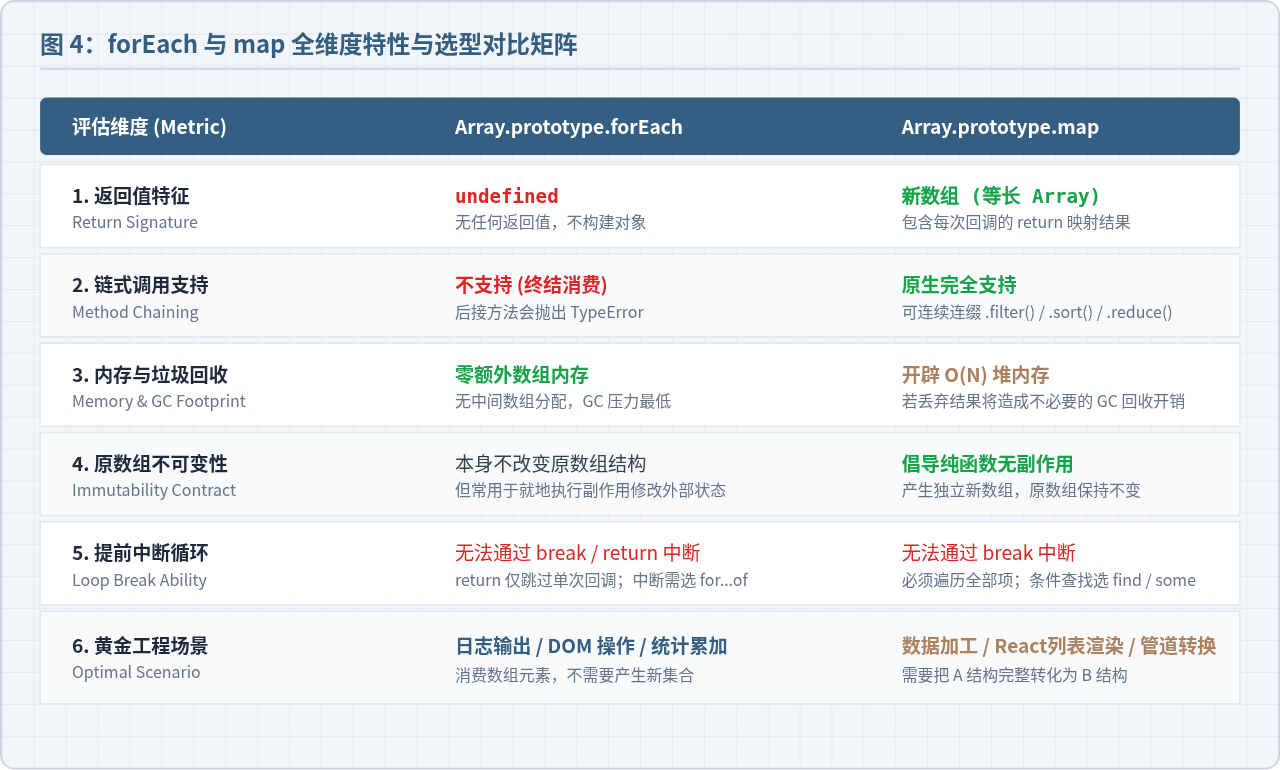
| 对比指标 | Array.prototype.forEach | Array.prototype.map |
|---|---|---|
| 返回值 | 严格返回 undefined |
返回一个等长的新数组实例 |
| 设计意图 | 终端消费,执行副作用(修改外部状态/DOM/日志) | 无副作用的纯映射转换(数据投影/格式重构) |
| 链式调用 | 不支持(调用后会打断链式管道) | 天然支持(可紧随 .filter()、.sort() 等) |
| 内存与 GC 表现 | 零额外数组开销,性能高,GC 压力最低 | 分配新数组堆内存;若结果被丢弃则造成内存浪费 |
| 原数组保护 | 通常通过闭包或参数直接操作外部/原对象 | 推荐配合纯函数使用,不改变输入,实现数据不可变 |
| 循环控制 | 无法 break;return 仅跳过单步 |
无法 break;必须为每一项返回映射值 |
| 稀疏数组处理 | 自动跳过空位(empty slots),不执行回调 | 跳过空位计算,但会在新数组中保留对应空位 |
| 典型使用场景 |
• 遍历数据并打印控制台日志 • 逐项向 DOM 节点添加子元素或绑定监听 • 触发上报埋点与全局事件派发 |
• 从服务端数据中提取特定字段构成列表 • React / Vue 模板中将数组映射为组件列表 • 数据流清洗流水线(结合 filter / sort) |
六、工程总结
在日常 JavaScript 与 TypeScript 开发中,选择 forEach 还是 map 并不是一个个人编码风格的偏好问题,而是关于代码意图传达(Intent Communication)与内存资源效率的工程决策:
- 如果你需要结果:哪怕只是可能需要,只要目标是产出数据,坚决使用
map。它保持了数据的纯粹与不可变性,并赋予了代码流式处理的能力。 - 如果你不要结果:只是借用循环遍历来触发一系列外部动作,坚决使用
forEach。它明确告知阅读代码的人“此处为终点消费”,同时避免了不必要的堆内存分配与垃圾回收损耗。 - 如果需要提前退出或处理复杂的异步排队:不要勉强使用这两个高阶迭代器,果断退回至功能最完备的
for...of循环或选择语义更精准的find、some。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章