
深入解析JavaScript解构赋值中的常见报错原因,包括Cannot destructure property of undefined/null、is not iterable及语法歧义,并提供防御式编程规范与ES6兼容性降级解决方案。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript解构赋值常见报错原因及ES6兼容性说明
作者:异步漫步
时间:2026-11-03
浏览:245
文章目录
解构赋值(Destructuring Assignment)是 ECMAScript 2015 (ES6) 引入的标志性语法特性,旨在用清晰简洁的模式从对象或数组中提取属性并快速绑定到独立变量。然而,在日常开发与生产部署中,由于右侧数据源偶发为
null / undefined、对非迭代实体误用数组解构、赋值圆括号语法歧义,以及默认值触发边界认知模糊,常常引发阻断整个应用的运行时异常。本文直入主题,详细拆解各类解构报错的核心机制、排查步骤与防御规范,并系统说明该语法的各宿主环境兼容性与工程化转译降级方案。
一、解构赋值底层运行机制与异常阻断原理
要彻底杜绝解构报错,首先需要明确 JavaScript 引擎在执行解构时所遵循的 ECMAScript 规范。对象解构与数组解构在底层依赖完全不同的内部操作协议,理解这两套协议是避免报错的关键。
在对象解构过程中,引擎首先对赋值右侧的操作数执行内部抽象操作 ToObject(value)。根据 ECMAScript 规范,如果该操作数是 null 或 undefined,ToObject 无法将其装箱为对象,会立即抛出 TypeError。若操作数通过了检查(如普通对象、函数或基元包装对象),引擎便调用内部方法 [[Get]](key, receiver) 依次提取对应键名的数据。
在数组解构过程中,引擎采用的是完全不同的迭代协议(Iteration Protocols)。引擎不会执行键名查找,而是通过检查目标右侧数据是否具备 [Symbol.iterator] 属性来获取迭代器实例,随后连续调用迭代器的 next() 方法提取元素。如果右侧对象没有实现迭代器协议(例如普通数字、布尔值或普通 Plain Object),引擎将直接抛出不可迭代异常。
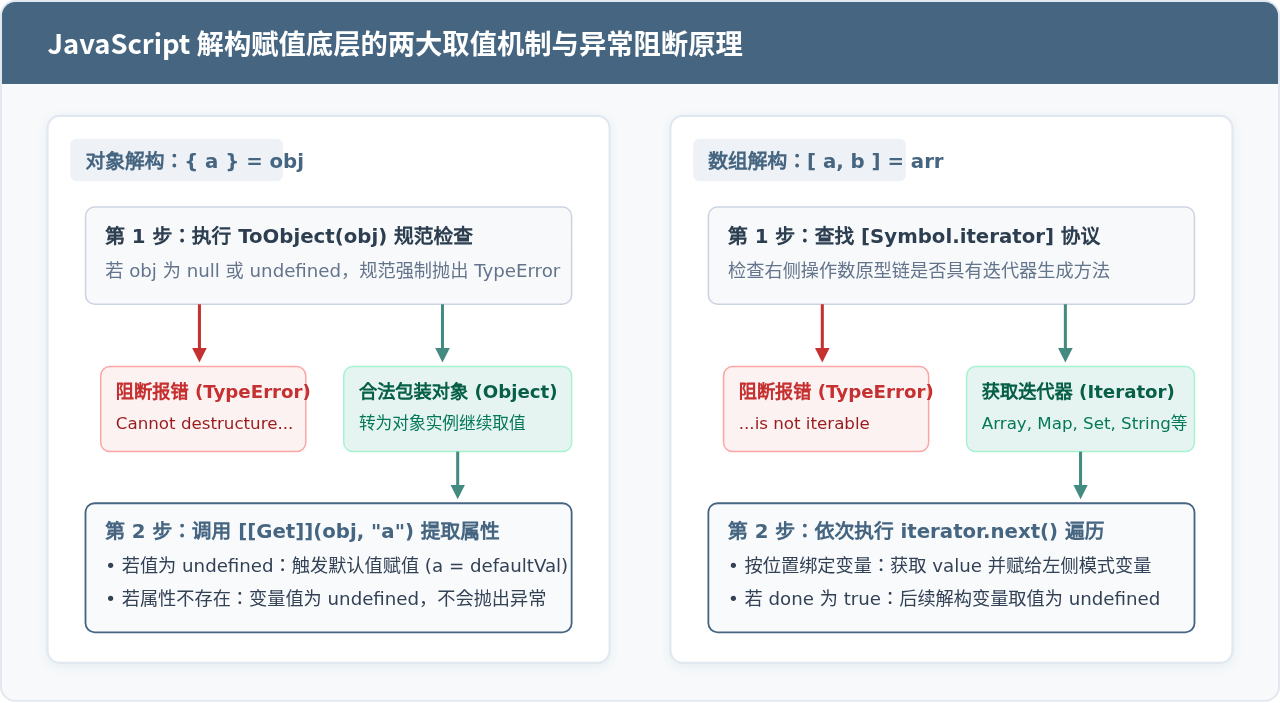
图 1:JavaScript 对象解构(ToObject机制)与数组解构(迭代协议)底层执行与报错阻断流
二、生产高频解构报错原因剖析与复现排查
1. TypeError: Cannot destructure property 'x' of 'undefined' or 'null'
这是前端与 Node.js 服务端最常见的运行时报错之一。它通常发生在异步数据请求尚未返回(仍处于初始状态 undefined),或者后端接口在数据缺失时返回了 null,而前端直接在顶层或嵌套层级执行了解构操作。
// ❌ 报错场景 1:异步数据未就绪或接口返回空对象
const fetchUserProfile = () => undefined;
const { id, username } = fetchUserProfile();
// Uncaught TypeError: Cannot destructure property 'id' of 'fetchUserProfile(...)' as it is undefined.

// ❌ 报错场景 2:深度嵌套路径断裂
const response = { status: 200, data: null };
const { data: { list, total } } = response;
// Uncaught TypeError: Cannot destructure property 'list' of 'response.data' as it is null.
原因解释:虽然外层 response 是一个合法对象,能够成功提取 data 属性,但在对内层 { list, total } 继续解构时,右侧表达式实际上变成了 { list, total } = null。此时引擎对 null 执行 ToObject(null) 检查失败,当场阻断抛错。
2. TypeError: (intermediate value) is not iterable
开发者有时误将数组解构符号 [ ] 用于普通非迭代对象,或者将可能返回空值的函数返回值进行数组解构。
// ❌ 报错场景 1:对普通对象误用数组解构
const config = { host: "localhost", port: 8080 };
const [host, port] = config;
// Uncaught TypeError: config is not iterable

// ❌ 报错场景 2:对 null 或 undefined 执行数组解构
function getCoordinates() {
  return null; // 异常分支或未查询到坐标
}
const [x, y] = getCoordinates();
// Uncaught TypeError: getCoordinates(...) is not iterable
原因解释:数组解构强制要求右侧值符合可迭代对象协议(包含 Symbol.iterator 方法),普通 JavaScript 对象虽然有键值对,但原型链上默认没有迭代器实现。面对非迭代值,解释器在执行 GetIterator() 时失败并抛错。
3. SyntaxError: Unexpected token '=' 或 Invalid left-hand side in assignment
解构赋值不仅可以在声明变量时(const / let)使用,也可以对已经声明过的现有变量重新赋值。但在赋值语句中若省略了括号,将直接触发语法解析错误。
// ❌ 语法错误:已有变量解构重赋值未加括号
let title, version;
{ title, version } = { title: "Engine", version: "1.0" };
// Uncaught SyntaxError: Unexpected token '='

// ✓ 正确写法:使用外层圆括号明确表达式语义
({ title, version } = { title: "Engine", version: "1.0" });
原因解释:JavaScript 语法分析器在行首遇到大括号 { 时,会优先将其解析为代码块(Block)而非对象字面量。代码块中出现 title, version 并不合法,紧接着出现的赋值号 = 更使语法树构建崩溃。将其用 ( ... ) 包裹后,语法分析器才会将其正确视作赋值表达式。
4. 默认值与假值(falsy vs undefined)的混淆陷阱
解构赋值允许指定默认值,例如 const { timeout = 3000 } = options;。但许多开发者忽略了默认值的生效条件是严格等于 undefined(=== undefined)。
const options = { timeout: null, retries: 0 };

// timeout 传入了 null,由于 null !== undefined,默认值 5000 不会触发!
const { timeout = 5000, retries = 3 } = options;

console.log(timeout); // 输出 null(未触发默认值,若后续做数值计算可能再次引发错误)
console.log(retries); // 输出 0(0 是假值但不是 undefined,保留原有数值 0)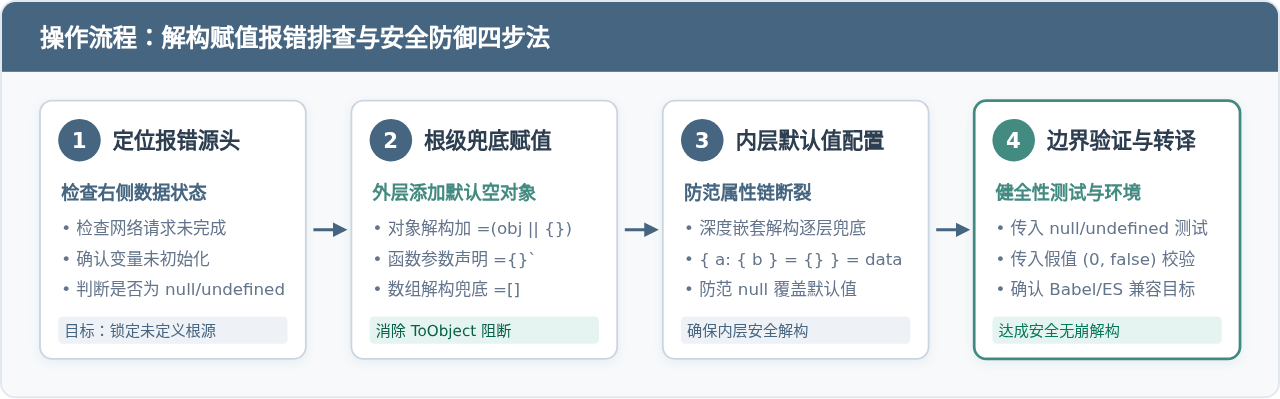
图 2:解构赋值报错排查与安全防御四步操作流程
三、解构报错排查与安全防御操作指南
在实际工程开发中,推荐按照以下四个明确步骤排查已有报错并建立防御式解构代码规范:
-
步骤一:定位报错根源与变量生命周期
打开浏览器 DevTools 或 Node.js 崩溃堆栈,定位具体的解构代码行。检查右侧表达式的值在运行时是否可能由于网络延迟、条件判断漏网或异步顺序错位而为null或undefined。 -
步骤二:为根对象添加兜底赋值(Fallback Object)
对外部传入或动态解析的数据对象,在解构右侧添加|| {}或默认空对象。对于数组,添加|| []。// 安全的单层解构:永远不会因 response 为空抛出 TypeError const { code, data } = response || {}; const [firstItem] = list || []; -
步骤三:深度嵌套逐级解构与安全默认值配置
如果需要跨多层解构内部属性,每一层中间节点都必须具备空对象兜底,避免链条中断。// 安全的深层解构写法 const { user: { profile: { avatar = "/default.png" } = {} } = {} } = response || {}; -
步骤四:函数参数解构采用双重默认值(Dual-layer Defaulting)
函数接收解构参数时,如果不传参调用fn(),参数默认为undefined会立即崩溃。必须在参数末尾指定= {}。// 双重默认值:既防范属性缺失,又防范不传参调用 function setupWatcher({ interval = 1000, immediate = false } = {}) { console.log(`Interval: ${interval}, Immediate: ${immediate}`); } setupWatcher(); // 正常运行,输出: Interval: 1000, Immediate: false
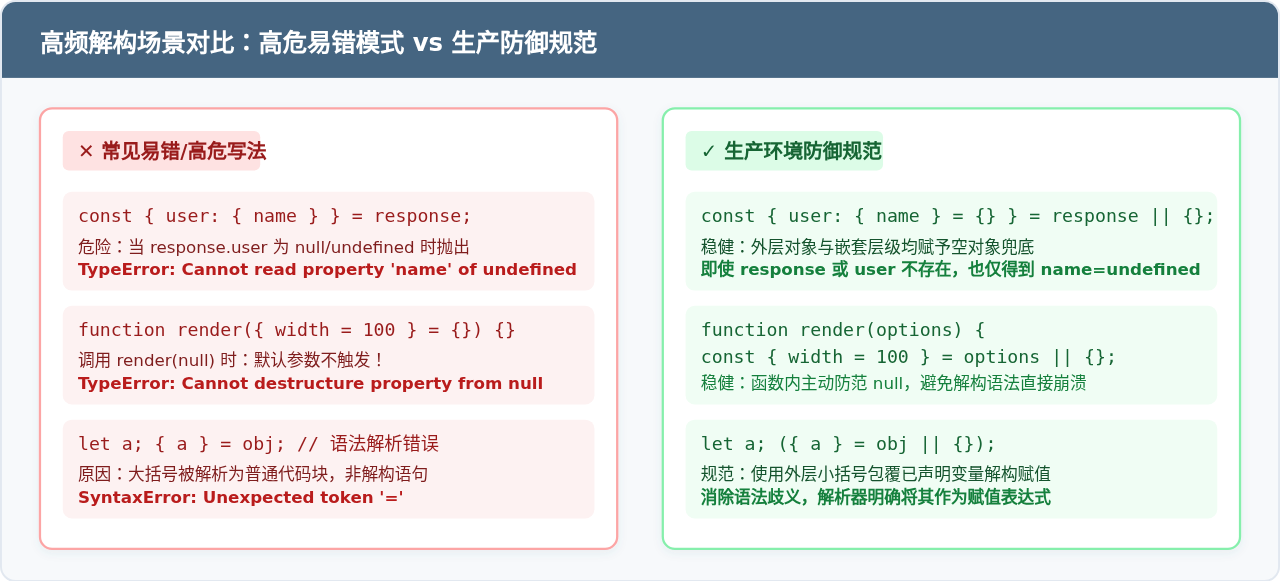
图 3:高危解构模式与生产环境安全防御代码对照
四、ES6 解构赋值兼容性说明与构建降级策略
1. 现代浏览器与运行环境原生支持现状
解构赋值于 2015 年 6 月随 ECMAScript 2015 (ES6) 正式定稿。经过多年演进,各大现代浏览器及 Node.js 运行时早已全面原生支持对象与数组解构语法,支持率超过 98%。
| 运行环境 / 宿主内核 | 首个支持版本 | 支持发布时间 | 原生执行状态 |
|---|---|---|---|
| Google Chrome | Chrome 49+ | 2016 年 3 月 | 完全原生支持,JIT 引擎深度优化 |
| Mozilla Firefox | Firefox 41+ | 2015 年 9 月 | 完全原生支持 |
| Apple Safari / WebKit | Safari 10+ / iOS 10+ | 2016 年 9 月 | 完全原生支持 |
| Microsoft Edge | Edge 14+ (EdgeHTML) / 79+ (Chromium) | 2016 年 8 月 | 完全原生支持 |
| Node.js | Node.js 6.0.0+ | 2016 年 4 月 | 完全原生支持(现行 LTS 版本无任何限制) |
| Internet Explorer (IE 11) | 不支持 (Never) | — | 不支持,必须依靠 Babel 编译器降级为 ES5 |
2. 面向旧版环境的 Babel 编译降级实现
在需要兼容 IE 11 或某些低版本 WebView、嵌入式设备宿主环境时,工程化构建体系(如 Webpack、Vite、Rollup)通常借由 Babel 的官方转换插件 @babel/plugin-transform-destructuring 将解构语法转译为 ES5 兼容代码。
对象解构的 ES5 降级产物: Babel 会生成一个带有临时变量的赋值语句。例如:
// 源码输入
const { a, b = 2 } = source;

// Babel 编译转译后的 ES5 代码
var _source = source,
    a = _source.a,
    _source$b = _source.b,
    b = _source$b === void 0 ? 2 : _source$b;
可以看到,ES5 产物使用 void 0 精确匹配 undefined 来决定是否赋默认值,这也解释了为何在原生 ES6 中 null 不会触发默认值。
数组解构的降级与 Symbol.iterator 依赖:
由于 ES6 数组解构基于可迭代协议,Babel 默认会引入辅助函数 _slicedToArray 来通过迭代器逐个抽取数组项:
// 源码输入
const [x, y] = list;

// Babel 默认标准模式编译
var _slicedToArray = function (arr, i) {
  // 内部尝试从 arr[Symbol.iterator]() 迭代
};
var _list = _slicedToArray(list, 2),
    x = _list[0],
    y = _list[1];
⚠️ 关键兼容注意事项:如果目标运行环境完全不支持 ES6 的
Symbol(如 IE 11 未引入 core-js polyfill),标准的 _slicedToArray 可能会在运行时抛出 Symbol is not defined 错误。针对该情况,可在 Babel 配置中开启 loose: true 宽松模式,Babel 将不再使用迭代器协议,而是直接将数组解构编译为传统的索引访问(list[0]、list[1])。
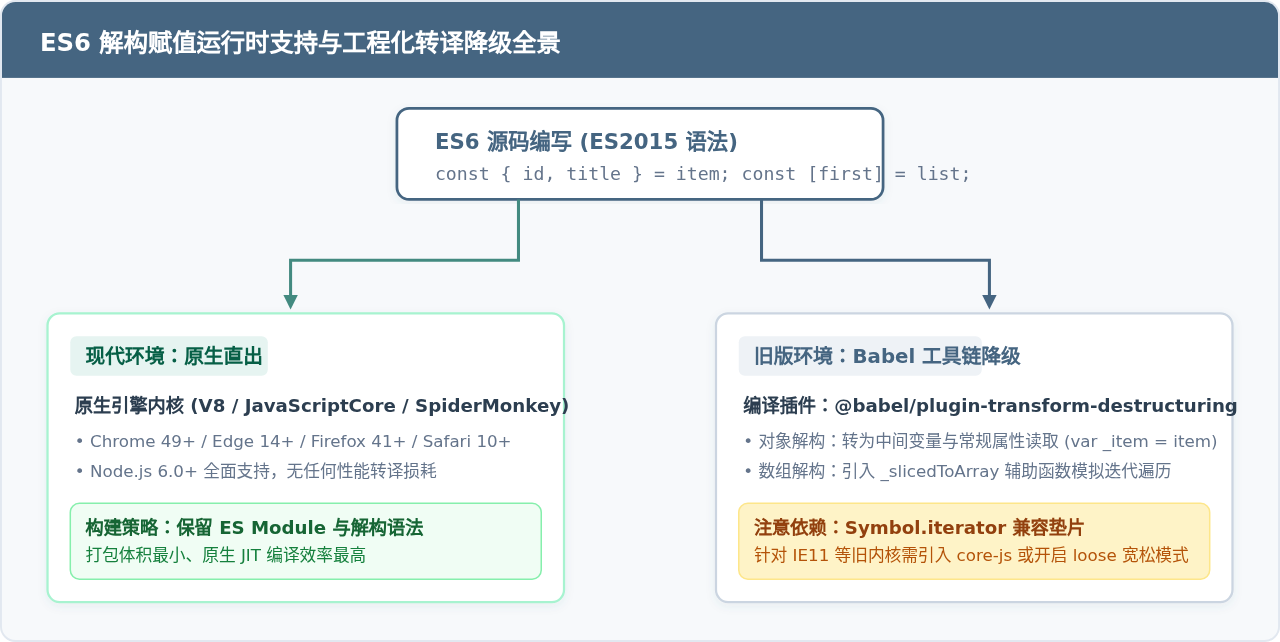
图 4:ES6 解构赋值运行时支持与工程化转译降级全景架构
五、解构编码安全自查清单
- 先兜底,后解构:凡是可能为异步响应、函数返回值或外部参数的数据源,始终保持
(data || {})的兜底习惯。 - 不跨级盲目深入:面对多层复杂嵌套数据,优先配置层级默认值,或结合可选链(
data?.sub?.prop)读取,避免一次性深度强解构。 - 明确参数双层默认值:编写包含解构参数的公共函数时,始终声明外层
= {},杜绝无参调用导致程序崩溃。 - 构建目标明确化:在
browserslist中根据业务定位准确配置现代浏览器或旧版目标,合理配置 Babel 的松散模式与 polyfill 依赖。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章